 AIREITER
Pour les files de tâches courantes dans Devin, SWE-2 Flash semble être le choix par défaut : 200 tokens par seconde pour un cinquième du coût de SWE-2. Mais dès qu’un travail ressemble à ceux de Terminal-Bench 4.0, la hiérarchie change : SWE-2 Flash plafonne à 20,0 %, contre 27,3 % pour SWE-2 et plus de 40 % pour les meilleurs modèles.
Verdict : Flash pour le volume, SWE-2 pour les 10 % les plus difficiles
SWE-2 Flash mérite sa place de modèle par défaut pour les tâches d’ingénierie nombreuses et peu ambiguës dans Devin. En échange de quelques points perdus sur certains benchmarks, il offre une génération 3 fois plus rapide et un coût par tâche nettement inférieur.
| Type de tâche | Modèle recommandé | Pourquoi |
|---|---|---|
| Automatisations, revues de code, petites fonctionnalités, mises à jour de documentation | SWE-2 Flash | Cognition destine SWE-2 Flash au travail quotidien ; la vitesse compte davantage qu’une planification approfondie |
| Refactorisations importantes, dépôts inconnus, tâches terminal proches de Terminal-Bench-4.0 | SWE-2 | SWE-2 devance SWE-2 Flash de 27,3 % à 20,0 % sur Terminal-Bench 4.0 et de 73,0 % à 60,1 % sur DeepSWE 1.1 |
| Travail sensible sur le plan de la sécurité ou déploiement sur site | Attendre | Les poids de SWE-2 Flash ne sont pas publics ; Cognition promet seulement un futur programme de partage sécurisé |
L’accès gratuit dans Devin Desktop et CLI jusqu’au 30 novembre 2026 rend l’expérimentation peu coûteuse. Lancez vos nouvelles files de tâches courantes avec SWE-2 Flash, puis mesurez le travail à refaire avant de vous engager.
Ce qu’est réellement SWE-2 Flash : Inkling-Small complété par un mid-training
SWE-2 Flash est le modèle de génération de code rapide de Cognition, construit à partir d’Inkling-Small de Thinking Machines. Il associe une base mixture-of-experts de 276B paramètres au total, dont 12B actifs, à une nouvelle phase de mid-training menée par Cognition avant l’apprentissage par renforcement.
Pour cette phase intermédiaire, Cognition a sélectionné les mélanges de données à partir de courbes d’efficacité en tokens, puis entraîné le modèle sur quelques milliers de milliards de tokens en trois étapes, en gardant les données les plus rares pour la fin. La loss sur les données hors entraînement a diminué selon une progression log-linéaire stable. L’apprentissage par renforcement qui a suivi, mené sur des tâches auditées, a fait passer Terminal-Bench 4.0 de 0,9 % à 20,0 % et FrontierCode 2.0 de 3,2 % à 24,0 %, selon la publication de Cognition du 4 novembre 2026. Cognition annonce également 200 tokens par seconde pour SWE-2 Flash, contre 60 tokens par seconde pour SWE-2.
« Cognition vient de sortir SWE-2 Flash ! Un modèle Flash de 276B paramètres au total, dont 12B actifs. Je ne pensais pas voir un modèle Flash pour SWE-2 ; je suis surpris, mais agréablement. Les résultats sur les benchmarks sont très bons : il n’est pas si loin du modèle SWE-2 de 2,8T. » — @ItsmeAjayKV, première réaction d’un utilisateur réel
Les benchmarks ne racontent pas tous la même histoire
Les résultats de SWE-2 Flash varient nettement selon les suites de tests. Le modèle se montre solide sur les tâches logicielles structurées, mais sensiblement moins convaincant dès qu’il faut travailler de manière ouverte dans un terminal. Une moyenne globale serait donc trompeuse.
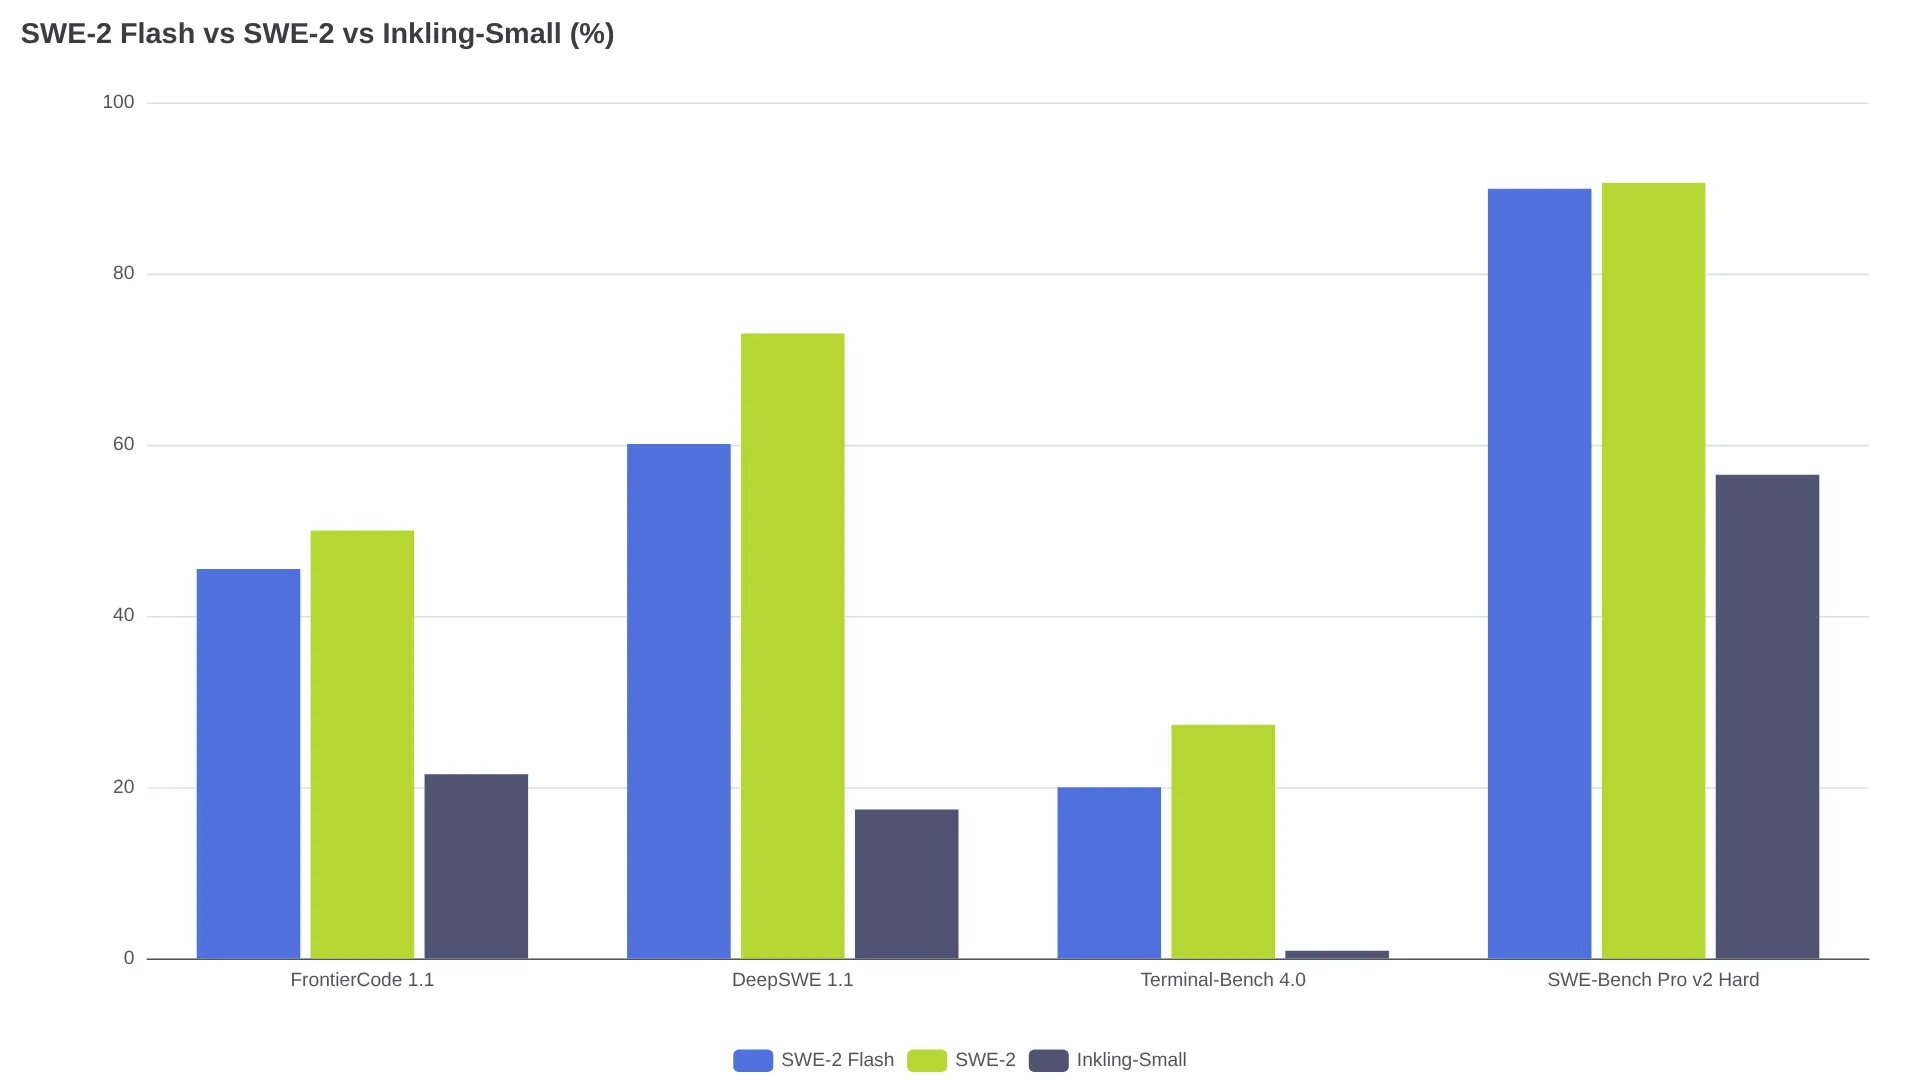
| Benchmark | SWE-2 Flash | SWE-2 (2.8T-A104B) | Inkling-Small | Meilleur résultat du tableau de Cognition |
|---|---|---|---|---|
| FrontierCode 1.1 Main | 45,5 % | 50,0 % | 21,5 % | 50,0 % SWE-2 |
| FrontierCode 2.0 | 24,0 % | 23,8 % | 3,2 % | 27,7 % Claude Haiku 5.5 |
| DeepSWE 1.1 | 60,1 % | 73,0 % | 17,4 % | 77,0 % DeepSeek V4.1 Flash |
| Terminal-Bench 2.1 | 89,2 % | 92,8 % | 64,7 % | 94,4 % Claude Haiku 5.5 |
| Terminal-Bench 4.0 | 20,0 % | 27,3 % | 0,9 % | 42,3 % DeepSeek V4.1 Flash |
| SWE-Bench Pro v2 Hard | 89,9 % | 90,6 % | 56,5 % | 90,6 % SWE-2 |
| SWE-Atlas QA | 50,0 % | 56,3 % | 27,4 % | 71,0 % DeepSeek V4.1 Flash |
| ExploitBench | 34,8 % | 36,1 % | 11,3 % | 44,7 % GPT-6 Luna |
Le gain a ses limites. Sur FrontierCode 1.1 Main, SWE-2 Flash fait plus que doubler le score d’Inkling-Small (45,5 % contre 21,5 %). Sur SWE-Bench Pro v2 Hard, il passe de 56,5 % à 89,9 %, presque au niveau de SWE-2, à 90,6 %.
Flash ne corrige pas les points faibles de SWE-2. Il ne faut pas extrapoler les bons résultats de SWE-Bench Pro aux longues sessions dans un terminal : GLM 5.3 Flash atteint 41,8 % sur Terminal-Bench 4.0 dans le même tableau.
La promesse face aux modèles ouverts doit être nuancée. SWE-2 Flash dépasse Muse Spark Open sur la plupart des lignes (60,1 % contre 60,0 % sur DeepSWE 1.1, 24,0 % contre 6,2 % sur FrontierCode 2.0). En revanche, DeepSeek V4.1 Flash et GLM 5.3 Flash le devancent sur Terminal-Bench 4.0, SWE-Atlas QA et DeepSWE 1.1. Tous ces chiffres sont fournis par les éditeurs, chaque modèle étant évalué dans sa configuration la plus performante, avec des harnesses qui diffèrent d’un fournisseur à l’autre.
Que signifie un prix divisé par cinq sans grille tarifaire ?
Il n’existe pas de tarif par token, puisque le modèle n’est pas proposé via un endpoint autonome. Le seul indicateur disponible est le ratio de coût par tâche communiqué par Cognition : un rollout SWE-2 Flash coûterait un cinquième d’un rollout SWE-2, en incluant le modèle, le harness et l’infrastructure de service.
Ce ratio donne une direction, mais il reste incomplet. Cognition n’a jamais publié non plus le coût par tâche de SWE-2 ; la décomposition des coûts de SWE-2 par OrcaRouter ne pouvait citer que Fable 5.1, à 3,28 $ par tâche FrontierCode en effort moyen et 12,83 $ au niveau maximal, comme points de référence. Les formules Devin mentionnées sur cette page étaient Free à 0 $, Pro à 20 $ par mois, Max à 200 $ par mois et Teams à 80 $ plus 40 $ par siège : une facturation par abonnement, pas par token consommé. Un coût par tâche divisé par cinq ne se traduit donc pas automatiquement par une facture Devin réduite.
En pratique, la période gratuite jusqu’au 30 novembre 2026 dans Devin Desktop et CLI, ouverte aux utilisateurs Pro, Max et Teams, est le moyen le moins cher de mesurer la consommation réelle. Suivez le nombre de tâches terminées chaque semaine et le taux de reprise, pas le nombre de tokens. Si SWE-2 Flash termine les tickets courants en un seul passage à 200 tok/s, l’économie réelle peut dépasser la promesse de 1/5 ; s’il faut escalader régulièrement vers SWE-2, elle disparaît.
Qui peut l’utiliser ? Un accès réservé à Devin et un programme de poids qui ne constitue pas de l’open weights
La disponibilité de SWE-2 Flash reste aujourd’hui très limitée. Cognition indique qu’il est accessible via Devin Desktop et Devin CLI.
Il n’existe ni identifiant d’API public, ni poids disponibles sur Hugging Face, ni possibilité d’auto-hébergement. Cognition présente cette restriction comme une mesure de gestion du risque cyber : l’entraînement de SWE-2 Flash a ciblé volontairement les tâches de cybersécurité, faisant passer son score sur ExploitBench de 11,3 % à 34,8 %, et cette capacité pourrait aussi servir à des attaquants. La solution envisagée consiste à partager les poids de manière sécurisée avec des partenaires industriels et des laboratoires de recherche de confiance ; les détails doivent être annoncés dans quelques semaines. Il faut donc y voir un projet d’accès contrôlé, pas un engagement en faveur de poids ouverts.
En dehors de Devin, il est impossible d’évaluer directement SWE-2 Flash aujourd’hui : aucun endpoint public ni chemin d’auto-hébergement n’est disponible.
Flash ou SWE-2 ? Une règle de routage à l’échelle de la tâche
Le volume va à SWE-2 Flash ; l’ambiguïté va à SWE-2.
Commencez par SWE-2 Flash pour les automatisations, les mises à jour de dépendances, l’ajout de tests, les réponses aux remarques de revue, les petites fonctionnalités avec des critères d’acceptation clairs et les mises à jour de documentation. Ces tâches correspondent aux suites où SWE-2 Flash reste à quelques points de SWE-2 : 24,0 % contre 23,8 % sur FrontierCode 2.0 et 89,9 % contre 90,6 % sur SWE-Bench Pro v2 Hard.
Passez à SWE-2 lorsque la tâche demande une planification sur plusieurs fichiers, de longues séquences dans le terminal ou un raisonnement proche de l’exploitation de failles. Les écarts deviennent alors significatifs : 12,9 points sur DeepSWE 1.1, 6,3 points sur SWE-Atlas QA et 7,3 points sur Terminal-Bench 4.0. La revue de SWE-2 par HamiRev décrit un modèle optimisé pour effectuer moins d’étapes et modifier le code plus tôt que SWE-1.7, avec une préférence pour les tâches courtes que SWE-2 Flash pousse encore plus loin.
Lancez chaque ticket sur SWE-2 Flash avec une limite de deux boucles, puis transférez à SWE-2 le travail qui bloque. Faites le bilan après la période gratuite de novembre, lorsque les dépenses réelles dans Devin remplaceront le ratio de 1/5. Le principal point en suspens reste la transparence : le programme de partage sécurisé des poids pourrait ouvrir la voie au déploiement privé, mais les équipes soumises à des contraintes réglementaires ne peuvent pas encore planifier autour de SWE-2 Flash tant que ses conditions ne sont pas connues.
FAQ sur SWE-2 Flash
SWE-2 Flash est-il disponible via une API ?
Non, il n’existe pas d’API autonome pour SWE-2 Flash. L’accès passe par Devin Desktop et Devin CLI, gratuitement pour les offres Pro, Max et Teams jusqu’au 30 novembre 2026.
SWE-2 Flash est-il proposé avec des poids ouverts ?
Non. Cognition invoque le risque cyber et promet uniquement un futur programme de partage sécurisé pour certains partenaires et laboratoires de recherche.
Comment SWE-2 Flash se compare-t-il à SWE-2 ?
SWE-2 Flash atteint 200 tok/s contre 60 tok/s et coûte un cinquième du prix selon le calcul du coût par tâche de Cognition. SWE-2 reste toutefois devant sur DeepSWE 1.1 (73,0 % contre 60,1 %) et Terminal-Bench 4.0 (27,3 % contre 20,0 %).
Quelle est la fenêtre de contexte de SWE-2 Flash ?
Cognition n’a publié aucune spécification concernant la fenêtre de contexte, la longueur maximale des sorties ou les modalités prises en charge par SWE-2 Flash. Ne supposez pas que le modèle reprend les limites d’Inkling-Small.
Que se passera-t-il après la période gratuite du 30 novembre ?
Cognition n’a pas indiqué comment SWE-2 Flash sera facturé après la promotion. Il faut s’attendre à une consommation incluse dans les abonnements Devin plutôt qu’à un tarif séparé par token.