 AIREITER
Hyra 2.0 ne cherche pas simplement à répondre à une question scientifique avant de passer à la suivante. Le système de Tencent vise à produire des modèles, outils et workflows réutilisables, capables de servir à d’autres projets. Sa limite majeure est aussi très nette : l’agent reste interne à Tencent, tandis qu’une sélection de ses résultats est rendue publique.
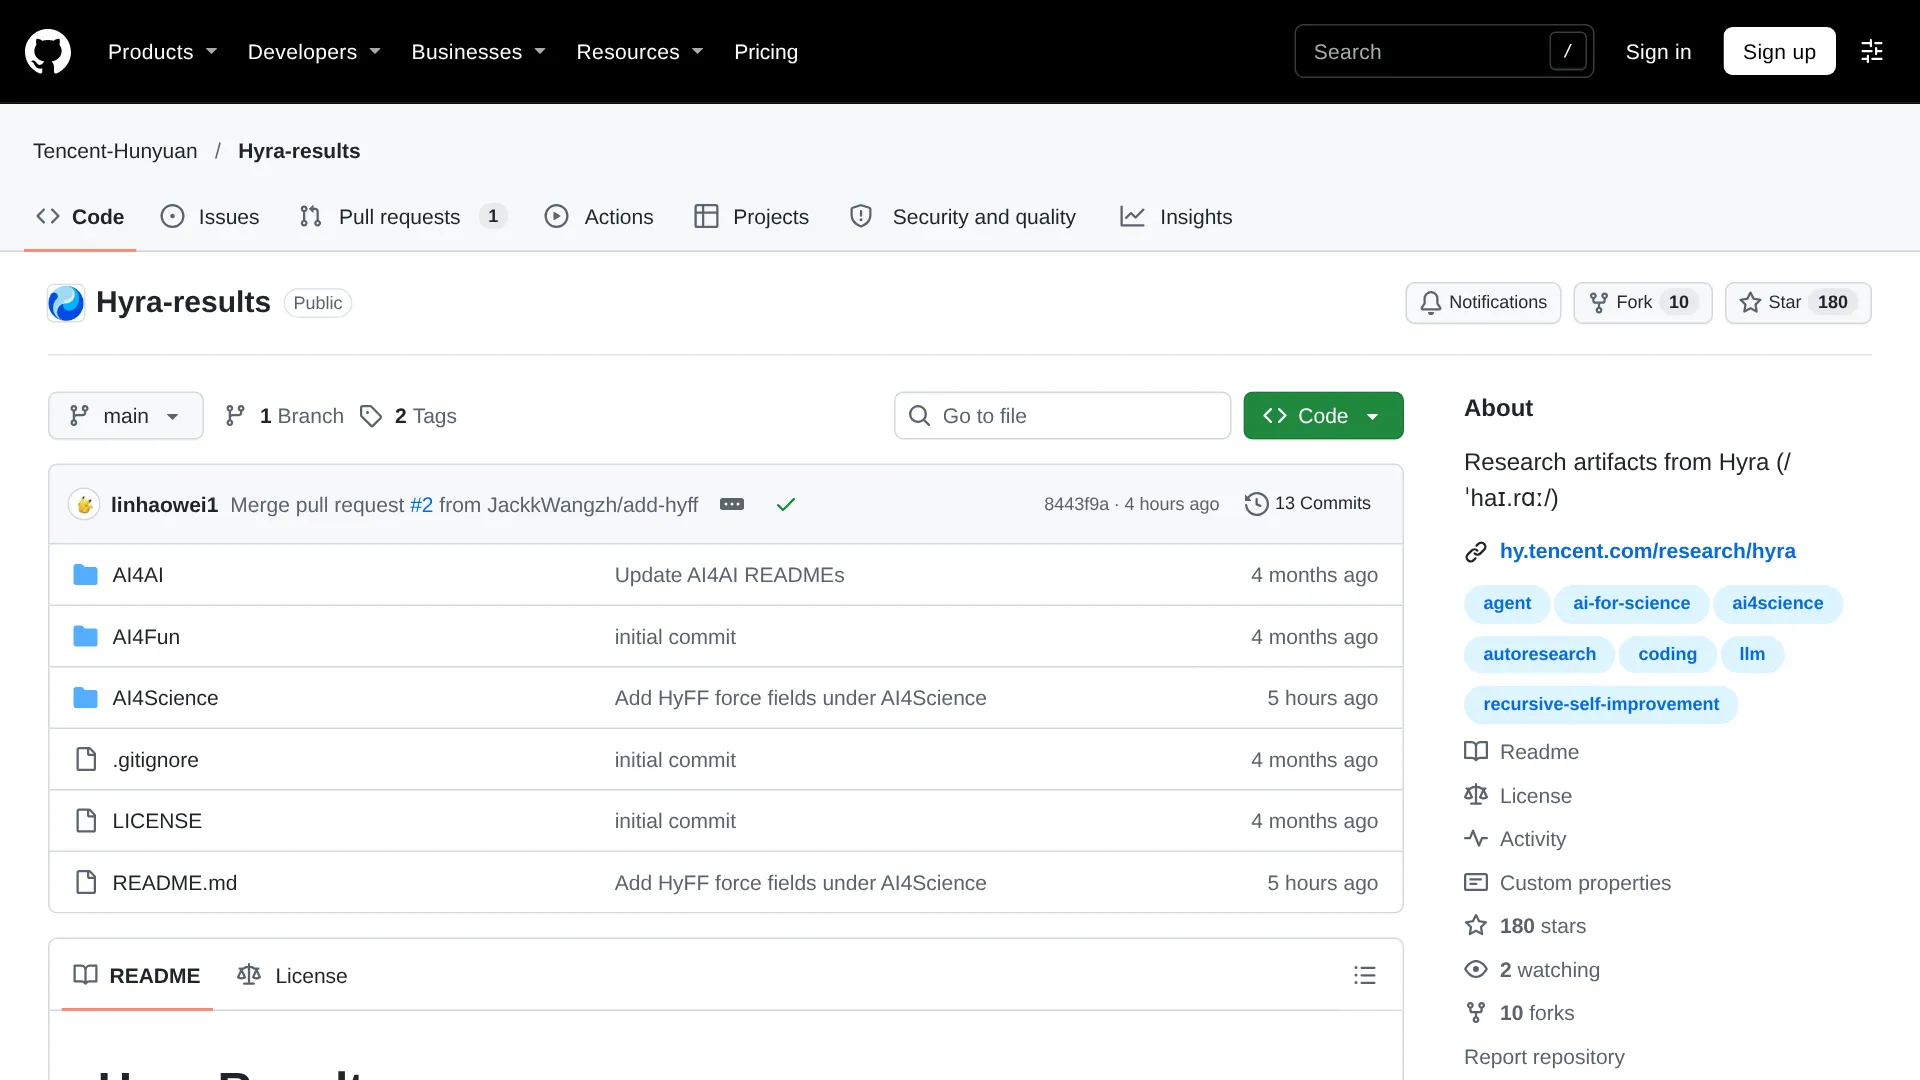
Le dépôt Hyra-results distingue clairement les artefacts téléchargeables des annonces sans livrable public. C’est cette frontière qui structure le reste de ce guide.
Hyra 2.0 : un laboratoire d’agents, pas un chatbot
Hyra 2.0, pour Hunyuan Research Agent 2.0, est le système hiérarchique de Tencent Hunyuan conçu pour automatiser des travaux de recherche scientifique et d’ingénierie. Tencent le présente comme une infrastructure capable de développer des modèles scientifiques réutilisables, des pipelines de validation et des workflows à plusieurs étapes, et non comme un nouveau modèle conversationnel Hunyuan généraliste.
Dans son annonce officielle sur X, datée du 2 novembre 2026, Tencent décrit Hyra 2.0 comme « the next evolution of Hunyuan Research Agent », passant de la résolution de problèmes à la création « de tools, models and workflows » réutilisables. Le dépôt public Hyra-results rassemble des résultats et certains modèles entraînés, mais pas le système complet d’orchestration. Ni l’annonce ni le dépôt ne proposent de démo publique, de paquet d’installation, d’API, de tarif ou de quota. Il faut donc voir Hyra 2.0 comme le laboratoire ; les modèles de protéines HyInv et HyPLM-Flash publiés sont quelques-uns des spécimens qui en sont sortis.
Comment Hyra 2.0 maintient un projet de recherche pendant des semaines
Pour suivre des recherches longues, Hyra 2.0 s’appuie sur trois niveaux d’agents, un stockage persistant et une étape de revue indépendante. Le compte rendu de lancement d’IT之家, citant le compte WeChat officiel de Tencent Hunyuan, décrit l’organisation Overall, Mission et Worker conçue pour poursuivre des expériences durant plusieurs jours ou semaines sans perdre le contexte.
Les agents Overall échangent avec les chercheurs humains, alignent les objectifs et répartissent les budgets de calcul. Les agents Mission prennent chacun en charge une direction de recherche, choisissent les voies expérimentales et portent la responsabilité des conclusions. Les agents Worker, eux, lisent le code, lancent des expériences réelles, analysent les échecs et peuvent remettre en cause le jugement d’un agent Mission. Plusieurs Workers peuvent travailler en parallèle avec différents modèles de base.
Trois mécanismes assurent la persistance du travail :
- État du projet : il conserve l’avancement d’un programme de recherche afin que les tâches survivent aux interruptions dans des files persistantes.
- Mémoire d’agents à plusieurs niveaux : elle sépare les observations temporaires des résultats établis sur le long terme, plutôt que de tout empiler dans une seule fenêtre de contexte.
- Books partagés : ils consignent des connaissances selon leur niveau de preuve — observation d’une seule exécution, résultat reproduit ou convention confirmée par un humain. Les méthodes reconnues comme transférables sont extraites sous forme de petites skills réutilisables lors des futurs travaux.
Deux garde-fous complètent cette architecture. Chaque conclusion est associée à des logs précis et à des versions de code, tandis qu’un Worker de revue distinct réexamine l’affirmation à partir d’un point de départ vierge avant sa transmission aux humains. Les gros calculs restent soumis à approbation humaine. Selon l’analyse technique d’Eyerys, le système se connecte aussi aux outils habituels d’un laboratoire : messagerie d’entreprise, plateformes de soumission de jobs et dépôts de code.
Cette vérification a un coût. Un praticien estime que l’inspection mutuelle des sessions entre Workers peut fortement alourdir la facture en tokens (@d6355v). Tencent n’a publié ni budget de tokens, ni coût de calcul, ni taux d’échec, ni fréquence à laquelle la revue indépendante détecte des erreurs. L’architecture doit donc être considérée comme une approche de fiabilité pour les projets au long cours, dont le coût d’exploitation reste inconnu.
Ce que Hyra 2.0 a réellement publié à ce jour
Les éléments publics autour de Hyra 2.0 se répartissent en deux catégories : des artefacts téléchargeables avec poids et code, et des résultats annoncés par Tencent qui attendent encore une reproduction externe. Chaque ligne du tableau renvoie vers une source vérifiable.
| Artefact | Nature | Chiffre principal | Niveau de preuve |
|---|---|---|---|
| HyInv | Modèle d’inverse folding de protéines de 1,96 M de paramètres, poids de 7,8 MB, CLI + API Python | Génération ~57x plus rapide que ProteinMPNN ; 25 ms contre ~1 s sur des protéines de 148 résidus (1x GPU H20), selon l’examen de TSN | Artefact inspectable (MIT) ; benchmark exécutable ; résultat principal pas encore reproduit indépendamment |
| HyPLM-Flash | Modèle de langage protéique masqué de 650 M de paramètres, poids de 2,6 GB, moteur INT8 | ~130 000 résidus/s sur 1x H20 ; inférence la plus rapide dans le test Tencent sur 12 modèles et 35 tâches, rang moyen 3e ; Spearman ProteinGym de 0,409, à égalité avec la classe ESM-2 650M, selon l’examen de TSN | Artefact inspectable (MIT) ; nécessite un GPU CUDA ; les deux évaluations couvrent des nombres différents de modèles et de tâches |
| HyFF | 5 champs de force ML (Presto, Vivace, Moderato, Andante, Largo), de 2,3 M à 1,2 B de paramètres, 83 éléments | Erreur d’énergie de Largo : 0,364 meV/atome contre 0,380 pour DPA4-Pro, à une vitesse 9,7x supérieure ; Andante atteint 29x la vitesse d’UMA-S-1.2 sur une dynamique moléculaire de 2 586 atomes, 1x H20 | Artefact inspectable (Apache-2.0) avec le paquet hyff ; les vitesses sont liées à une charge de travail unique sur H20 |
| Conjecture de Petty en dim-5 | Artefact de preuve : tout espace normé réel de dimension 5 contient 6 points équidistants (meilleur résultat antérieur : dim 4, Makeev 2005), selon l’index du dépôt | Résout le cas de la dimension 5 | Article inspectable ; aucune évaluation par les pairs en revue n’est signalée |
| Action de cercle de Yau | Contre-exemple revendiqué : variété fermée de dimension 7, à courbure sectionnelle positive, sans action effective du cercle, selon l’index du dépôt | Résout le cas sans restriction ; le cas simplement connexe reste ouvert | Article inspectable ; aucune évaluation par les pairs en revue n’est signalée |
| HyQEC | Code de correction d’erreurs quantiques issu de la lignée qLDPC Challenge, selon Prompt Blueprints | ~48 % d’efficacité d’encodage supérieure au précédent leader | Annoncé ; artefact complet en attente sur GitHub |
| XiangShan RISC-V | Optimisation d’un processeur open source, selon Prompt Blueprints | +5,79 % de score par GHz, hausse de surface minimale ; bugs multicœurs corrigés | Annoncé ; nom du benchmark et référence non divulgués |
| Main robotique | Main à cinq doigts, avec des longueurs de doigts graduées, selon Eyerys | +28,6 % de vitesse de rotation d’objet dans une simulation à budget fixe | Annoncé ; uniquement simulé à ce stade |
Par rapport à Hyra 1.0, le changement est clair : il ne s’agit plus de livrer des réponses, mais des actifs réutilisables. Hyra 1.0 avait démontré que la boucle itérative pouvait fonctionner : son entrée sums_diffs avait fait passer une constante de combinatoire de 1,14489 à 1,21079, et Tencent lui attribue des avancées sur un problème de combinatoire additive vieux de 50 ans. L’analyse de lancement de Prompt Blueprints souligne que Hyra 2.0 conserve ce moteur itératif, mais y ajoute la hiérarchie, les projets persistants et l’extraction de skills afin que chaque réussite puisse être réemployée.
Ce que vous pouvez exécuter aujourd’hui, et ce qui reste fermé
Les produits de Hyra 2.0 sont utilisables, mais l’orchestrateur lui-même ne s’installe pas publiquement. Le dépôt Hyra-results est sous licence Apache-2.0, et chaque dossier de résultat est censé inclure les artefacts finaux ainsi que des scripts de reproduction. Pour commencer :
git clone https://github.com/Tencent-Hunyuan/Hyra-results.git
ls AI4Science/hyinv
Vous pouvez ensuite choisir l’une de ces voies :
- HyInv, le plus simple à prendre en main : ouvrez
AI4Science/hyinvpour les poids, le code d’inférence et le rapport technique. Le parcours de référence fonctionne sur CPU comme sur GPU ; le chemin accéléré en BF16 n’est validé que sur des GPU de classe Hopper. - HyPLM-Flash, avec CUDA obligatoire : ouvrez
AI4Science/hyplm_flash, puis lancezweights/download.shafin de récupérer, fusionner et vérifier les 2,6 GB de poids. Prévoyez un GPU de classe H20/H100 ; utilisez INT8 pour l’extraction de représentations et BF16 pour la régression fine des variants. - HyFF, avec un H20 pour atteindre les vitesses annoncées : utilisez la section HyFF pour accéder aux cinq modèles de champs de force, de 9 MB à 4,8 GB chacun, ainsi qu’au paquet
hyff, qui prend en charge les dynamiques moléculaires sur structure unique, par lots et en NVE/NVT/NPT.
Ce qui reste fermé : l’orchestrateur Overall/Mission/Worker, les prompts, ordonnanceurs, évaluateurs et le stockage Books/skills. Les validations humaines nécessaires pour les gros jobs de calcul signifient également que l’allocation de ressources n’est pas entièrement autonome. En pratique, il n’y a donc aucun agent à installer ; l’artefact le plus facile à tester commence par un téléchargement de 7,8 MB. Comme le note TSN, mettre en place une comparaison directe entre HyInv et ProteinMPNN sur des backbones identiques ne coûte pas cher.
Les chiffres mis en avant résistent-ils à l’examen ?
TSN indique que tous les chiffres de performance proviennent de Tencent ou de la documentation de ses modèles, sans reproduction indépendante publiée au 2 novembre 2026. Chaque valeur doit donc être lue avec ses conditions d’évaluation.
D’abord, la vitesse ne mesure pas la qualité. Le facteur 57x de HyInv compare le débit de génération sur un Nvidia H20 — environ 25 ms contre environ 1 s sur 148 résidus, et 54 ms contre 2,6 s sur 402 résidus —, pas le taux de réussite en laboratoire humide. La similarité structurelle est évaluée par rapport à des structures prédites, sans validation wet lab rapportée :
57x over ProteinMPNN and ~2,500 designs/sec is throughput, not design quality. What I'd want next: self-consistency RMSD and sequence recovery... Inverse folding is rarely the bottleneck anyway — the refold step after it is.
Ensuite, les promesses d’efficacité exigent de préciser le matériel et le périmètre. La formule « fastest among 12 » pour HyPLM-Flash correspond à l’évaluation de Tencent dans un billet portant sur 12 modèles et 35 tâches. L’évaluation appariée du dépôt couvre quant à elle 28 checkpoints et 32 tâches, avec un Spearman zéro-shot ProteinGym de 0,409, statistiquement à égalité avec ESM-2 650M, ESM C 600M et E1-600M. Les vitesses 29x et 9,7x de HyFF reposent sur un système de 2 586 atomes exécuté sur un H20. L’erreur de force d’Andante, à 7,65 meV/Å, est en outre légèrement plus élevée que celle d’UMA-S-1.2, à 7,55 meV/Å : une vitesse supérieure à précision presque égale, pas une domination sans partage.
Enfin, la réutilisation — qui constitue toute la promesse de la version 2.0 — reste à démontrer. Les documents de lancement n’expliquent pas comment une skill générée est validée avant sa réutilisation, qui l’approuve, ni si cette réutilisation a été mesurée entre différents projets :
Building reusable tools instead of one-off answers is the right direction. Most agent runs throw away everything they figured out once the task ends. Curious how Hyra decides a tool is good enough to keep and reuse.
Un second praticien soulève la même question de validation, cette fois sous l’angle du contrôle humain (@ModelPlaneHQ). Les documents de lancement de Tencent et les analyses tierces citées plus haut ne publient aucun benchmark comparatif direct avec des concurrents comme AI Co-Scientist de Google ou Sakana AI Scientist. Tout classement actuel reposerait donc sur les propres chiffres de Tencent. Pour évaluer un modèle construit par agent, posez plutôt quatre questions : sur quel matériel, avec quel réglage de qualité, reproduit par qui et réutilisé où ?
FAQ
Hyra 2.0 est-il open source, et peut-on l’essayer ?
Le framework est fermé, les artefacts sont ouverts. Il n’existe ni démo publique, ni API, ni installation disponible pour l’agent. Les paquets de modèles HyInv et HyPLM-Flash sont sous licence MIT, tandis que HyFF relève des termes Apache-2.0 du dépôt ; vérifiez le README et la licence de chaque dossier.
En quoi Hyra 2.0 diffère-t-il de Hyra 1.0 ?
Hyra 1.0 était centré sur la résolution itérative de problèmes, notamment un résultat de combinatoire resté longtemps ouvert. Hyra 2.0 ajoute la hiérarchie Overall/Mission/Worker, l’état persistant des projets, la connaissance Books, l’extraction de skills et l’objectif explicite de produire des modèles et workflows réutilisables.
Les résultats mathématiques ont-ils été évalués par les pairs ?
Pas sous forme de publications en revue. Les articles sur le cas de Petty en dimension 5 et le contre-exemple de Yau sont publics et inspectables. L’index du dépôt mentionne également des formalisations Lean 4 pour trois résultats antérieurs à noyau fini : Beurling-Ahlfors, Hadamard partiel et commutateur. Ils doivent tous être considérés comme des affirmations en attente d’examen expert.
Quel matériel faut-il pour reproduire les modèles de protéines ?
Le parcours de référence de HyInv fonctionne sur CPU et GPU, avec un téléchargement de 7,8 MB. HyPLM-Flash requiert un GPU CUDA, de préférence de classe H20/H100, pour son moteur INT8 de 2,6 GB ; les chiffres de vitesse de HyFF supposent un H20.
Évaluer Hyra 2.0 sans lui prêter plus qu’il ne démontre
Hyra 2.0 parie que l’unité de progrès scientifique doit être l’outil plutôt que la réponse. Ses skills réutilisables sont censées s’accumuler pour créer ce que Tencent appelle des rendements composés de l’intelligence (智能复利). Le lancement montre que le projet a publié des modèles et outils attribués au système. Mais il faudra attendre des données sur le taux de réutilisation, le coût de validation et les reproductions indépendantes, en plus des records de vitesse, pour savoir si ces outils accélèrent réellement et durablement les travaux scientifiques suivants.