 AIREITER
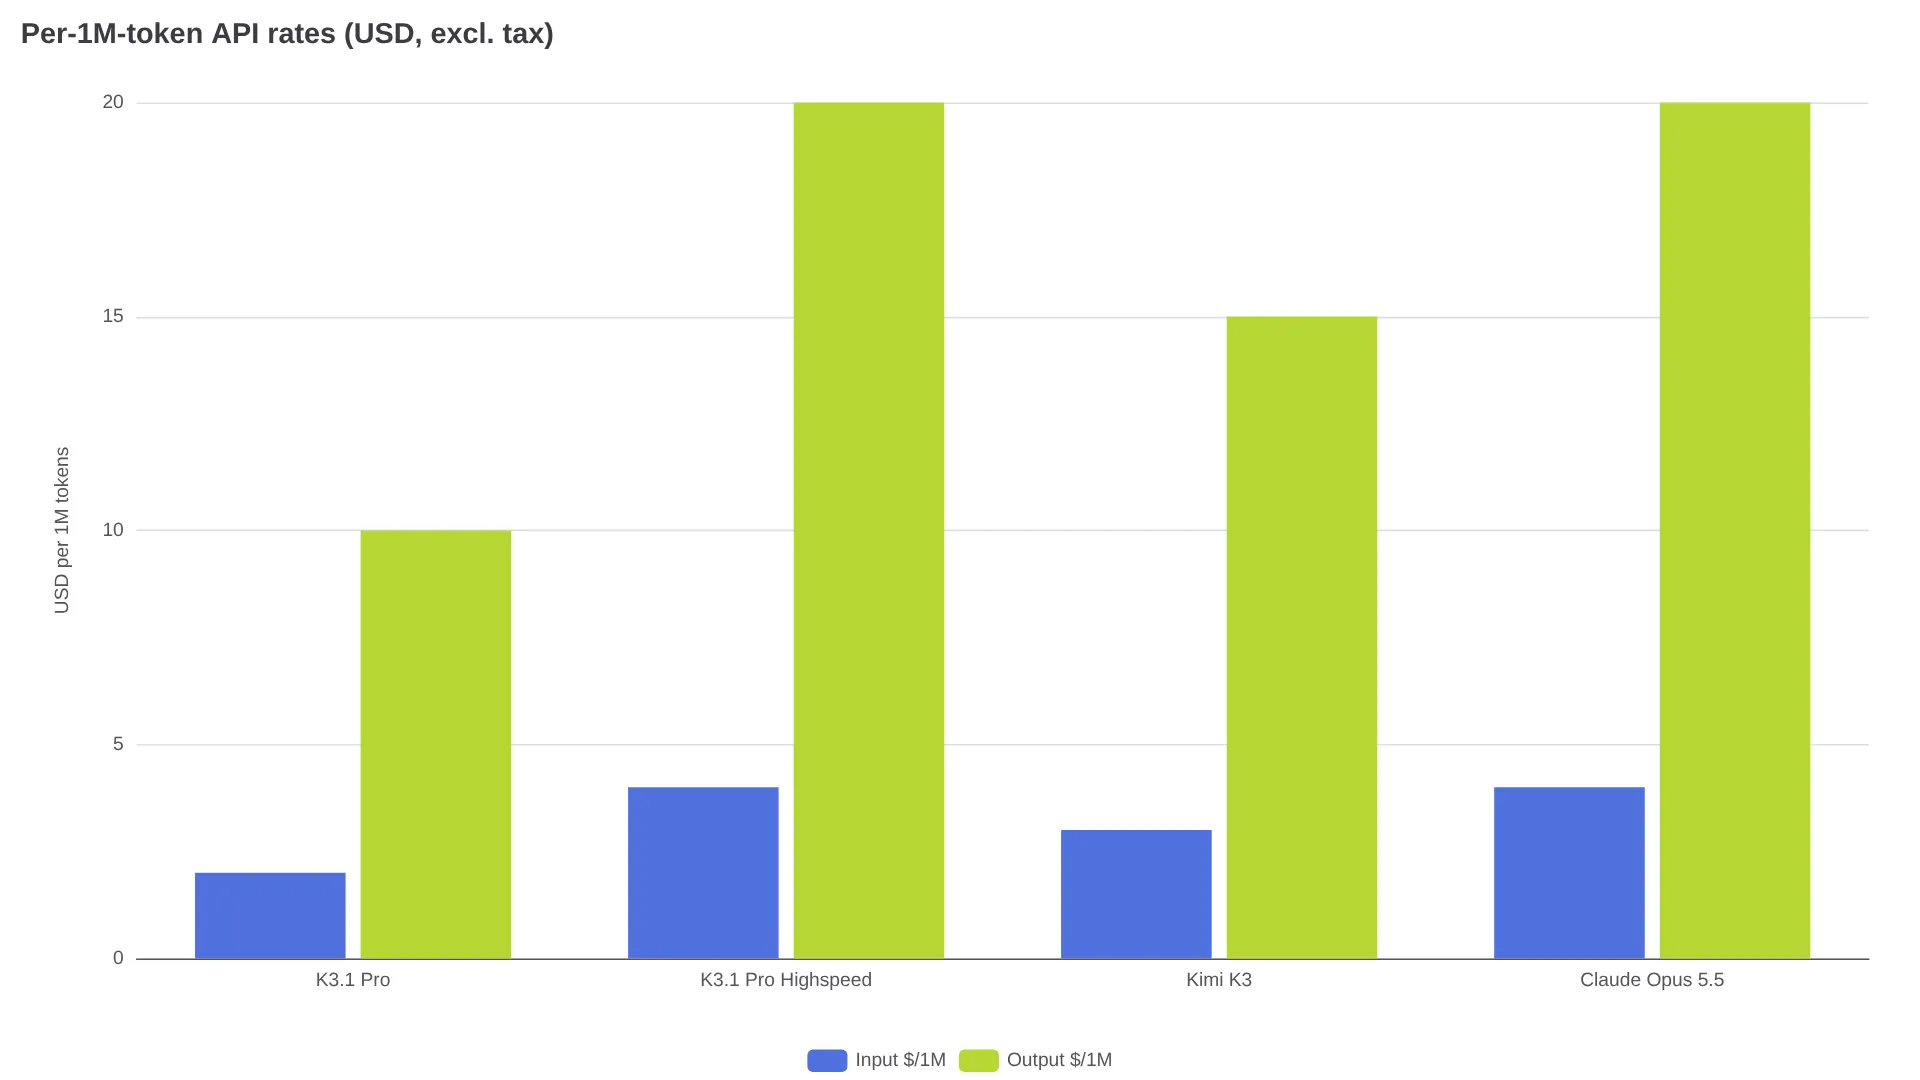
Pour l’API Kimi K3.1 Pro, tout se joue entre le tarif affiché de 2 $/10 $ et ce que le raisonnement ainsi que le cache ajoutent réellement à la facture. L’offre standard coûte 2 $ par million de tokens en entrée et 10 $ en sortie. Highspeed double ces deux montants pour accélérer les réponses, tandis que les lectures en cache restent facturées 0,20 $ dans les deux cas (platform.kimi.ai).
| Modèle | Entrée / 1 M | Sortie / 1 M | Lecture en cache / 1 M | Écriture cache 5 min / 1 M | Écriture cache 1 h / 1 M |
|---|---|---|---|---|---|
Kimi K3.1 Pro (kimi-k3.1-pro) | 2,00 $ | 10,00 $ | 0,20 $ | 2,00 $ | 4,00 $ |
Kimi K3.1 Pro Highspeed (kimi-k3.1-pro-highspeed) | 4,00 $ | 20,00 $ | 0,20 $ | 4,00 $ | 8,00 $ |
| Kimi K3 (génération précédente) | 3,00 $ | 15,00 $ | 0,30 $ | 3,00 $ | 6,00 $ |
Les tarifs sont exprimés en dollars américains par million de tokens, hors taxes. Ils s’appliquent à l’ensemble de la fenêtre de contexte de 1 million de tokens, sans supplément pour les contextes longs, selon la grille tarifaire officielle de Kimi (kimi.ai).
Une requête avec 100 000 tokens de contexte affiche 0,30 $, avant les autres coûts
Un exemple simple permet de situer les montants : 100 000 tokens d’entrée non mis en cache et 10 000 tokens de sortie coûtent 0,20 $ + 0,10 $, soit 0,30 $. Ce calcul découle directement des tarifs officiels de 2 $/10 $. Pour une requête réelle, utilisez plutôt cette formule sur l’offre standard — les tarifs d’entrée, de sortie et d’écriture sont doublés avec Highspeed :
Total = (uncached_in x 2 + cached_read x 0.20 + write_5m x 2
  + write_1h x 4 + (visible_out + reasoning_out) x 10) / 1M
  + searches x 0.004
Cette formule reprend le détail officiel de Kimi : tokens d’entrée non mis en cache, lectures du cache, écritures selon leur durée de conservation et tokens de sortie (kimi.ai). Il faut y ajouter 0,004 $ par appel à Web Search. La facturation étant à l’usage et calculée requête par requête (kimi.ai), une requête relancée repasse entièrement au compteur. Le raisonnement est toujours activé sur K3.1 Pro et facturé au tarif de sortie : les traces masquées consomment donc le même budget de 10 $ par million de tokens que la réponse visible. Une réponse visible de 10 000 tokens accompagnée de 40 000 tokens de raisonnement caché représente ainsi 50 000 tokens de sortie, soit 0,50 $. Un retour utilisateur réel mentionnant 935 tokens d’entrée et 56 097 tokens de sortie pour 0,5628 $ correspond presque exactement au tarif de 10 $ par million de tokens en sortie (x.com).
Le cache est l’autre poste souvent oublié. Un préfixe nouvellement mis en cache entraîne des frais d’écriture, tandis que la réutilisation d’un préfixe inchangé pendant la période prévue fait passer la lecture à 0,20 $ par million de tokens. La durée par défaut est de cinq minutes, avec une option d’une heure à chaque appel (kimi.ai). Si un préfixe est modifié près du début du contexte, tout ce qui suit peut ne plus être réutilisable (kimi.ai). Pour vérifier qu’un accès au cache a bien été comptabilisé, il faut consulter le détail d’utilisation de chaque requête et distinguer les tokens lus dans le cache des tokens non mis en cache : une formulation simplement similaire ne suffit pas à garantir un accès au cache.
Tarifs de l’API Kimi K3.1 Pro : ce qui change entre Standard et Highspeed
Highspeed revendique le même niveau d’intelligence et la même fenêtre de contexte de 1 million de tokens, avec une vitesse environ 2 à 3 fois supérieure. En contrepartie, les tarifs d’entrée, de sortie et d’écriture du cache sont exactement doublés (platform.kimi.ai), comme l’explique l’annonce de Moonshot (kimi.ai).
Le tarif qui ne double pas est celui de la lecture en cache : les deux variantes facturent 0,20 $ par million de tokens d’entrée mis en cache. Cette différence compte dans les boucles d’agents qui rejouent de longs prompts système et des définitions d’outils. La remise sur la réutilisation est identique, mais les nouveaux tokens et le raisonnement coûtent deux fois plus cher avec Highspeed.
Trois points de facturation doivent guider toute estimation :
- La facturation de l’API est à l’usage, avec un décompte séparé pour l’entrée et la sortie. Elle est indépendante des abonnements Kimi et de Kimi Code : le solde d’un abonnement ne peut donc pas financer des appels API (kimi.ai).
- L’API est compatible avec OpenAI, avec les identifiants de modèle
kimi-k3.1-proetkimi-k3.1-pro-highspeed, accessible viahttps://api.moonshot.ai/v1. Des passerelles la proposent également sous le nommoonshotai/kimi-k3.1-prosur OpenRouter et Vercel AI Gateway. - Les appels facultatifs à Web Search coûtent 0,004 $ chacun en plus des tokens. Les fichiers importés ne sont pas facturés directement, mais leur contenu analysé est facturé comme de l’entrée. L’accès à l’API est débloqué après un premier rechargement d’au moins 1 $, avec des limites de débit par palier (kimi.ai).
Quand le tarif deux fois plus élevé de Highspeed se justifie — et quand il fait exploser la facture
Highspeed ne devient intéressant que lorsque l’attente coûte plus cher que les tokens. Les sessions de code interactives, les assistants en direct et les démonstrations destinées à des utilisateurs, où quelqu’un regarde un indicateur de chargement, peuvent justifier le tarif de 4 $/20 $ : dans ces cas, la latence fait partie du produit. Les traitements par lots, les agents lancés pendant la nuit et les campagnes d’évaluation, où personne n’attend la réponse, ont plutôt intérêt à rester sur l’offre standard à 2 $/10 $, soit environ la moitié des tarifs par token. En pratique, Highspeed ne se justifie que si la valeur du temps gagné dépasse le surcoût des tokens, lequel correspond approximativement à une facture standard supplémentaire sur les requêtes dominées par l’entrée.
Réduire l’effort de raisonnement est un levier moins coûteux que changer d’offre. L’API accepte reasoning_effort avec les valeurs low, high et max. Cette dernière est utilisée par défaut et correspond au réglage associé aux scores publiés par Moonshot (datacamp.com). Passer une requête de max à high, ou de high à low, réduit le volume de tokens de raisonnement sur les tâches simples sans payer la prime de Highspeed. Mieux vaut conserver un seul niveau par session : le changer en cours de route invalide le cache du contexte (datacamp.com).
Les retours de la communauté donnent une idée concrète du compromis. Un utilisateur japonais a comparé des tâches équivalentes : Opus 5.5 les terminait en 14 min 32 s, contre 27 min 53 s pour Kimi K3.1 Pro, avec une qualité de sortie jugée proche. Sa conclusion : réserver Kimi aux travaux pour lesquels l’attente ne pose pas problème :
Le prix devait être deux fois inférieur, mais l’attente était presque deux fois plus longue. ... Opus 5.5 a mis 14 minutes 32 secondes, contre 27 minutes 53 secondes pour Kimi K3.1 Pro. Honnêtement, le résultat était assez proche. Pour ma part, je réserverais Kimi aux tâches où l’on peut attendre. — @rutinelabo (x.com)
Des utilisateurs de Reddit décrivent un écart similaire : environ 80 tokens par seconde avec Highspeed, contre environ 30 tokens par seconde avec l’offre standard, tout en jugeant la version rapide très chère :
Encore une fois, le modèle dispose d’une version haut débit qui coûte une fortune et va bien plus vite que ce que l’œil peut lire (80 t/s), tandis que la version normale tourne à 30 t/s quand elle en a envie. — u/Kiverty (reddit.com)
La règle simple : commencez avec K3.1 Pro standard, réduisez d’abord reasoning_effort et ne payez Highspeed que lorsqu’une personne attend réellement la réponse.
Auto-hébergement après le 4 novembre : le cas concret d’un modèle de classe 3T
Moonshot annonce la publication des poids complets de Kimi K3.1 Pro au plus tard le 4 novembre 2026. Le modèle est présenté comme appartenant à la classe des 3T, avec une fenêtre de contexte de 1 million de tokens (kimi.com). Au 2 novembre, aucun dépôt officiel de K3.1 Pro n’apparaît encore dans l’organisation Moonshot sur Hugging Face, à l’adresse huggingface.co/moonshotai. Celle-ci liste toujours Kimi K3 et les modèles précédents, tandis que les résultats de recherche ne montrent que des forks non officiels. La licence finale, les formats de fichiers et les options de quantification restent eux aussi inconnus ; les trackers tiers les indiquent comme non confirmés dans l’attente de la publication officielle (ctrlaltorion.com).
C’est précisément cette échelle qui rend l’auto-hébergement rarement moins cher que l’API. K3.1 Pro est le successeur post-entraîné de Kimi K3, un modèle mixture-of-experts de 2,8T paramètres, et la mention « classe 3T » va dans le même sens (datacamp.com). Le nombre total de paramètres d’un modèle MoE ne correspond pas au nombre de paramètres actifs pour chaque token. Il est donc impossible de calculer pour l’instant une quantité fiable de VRAM pour une seule station de travail.
Mieux vaut utiliser un seuil de rentabilité symbolique que d’inventer un prix de GPU :
API_month = monthly_tokens_1M x blended_$/1M (from formula above)
Self-host wins when cluster_monthly_cost < API_month at sustained utilization
Avec 2 $ par million de tokens en entrée et 10 $ en sortie, un milliard de tokens d’entrée et 100 millions de tokens de sortie représentent 2 000 $ + 1 000 $, soit environ 3 000 $ de consommation API. L’auto-hébergement peut devenir intéressant pour les équipes qui disposent déjà d’un cluster adapté, exécutent des inférences à gros volume de manière soutenue ou doivent conserver leurs données sur site. Pour celles qui n’ont ni ce cluster ni un taux d’utilisation élevé et régulier, la formule ci-dessus favorisera généralement l’API à la consommation. Attendez le checkpoint officiel et la licence avant de bâtir un projet autour du self-hosting.
Deux pièges de facturation qui reviennent sans cesse
Le premier piège est le raisonnement facturé comme de la sortie, ce que la formule précédente prend déjà en compte. Limitez les exécutions avec max_completion_tokens, commencez les tests en low, passez à high uniquement en cas d’échec et gardez max pour la dernière exécution, celle qui doit résoudre le problème difficile.
Le second concerne la consommation des quotas d’abonnement, à comparer avec la prévisibilité de l’API. Plusieurs utilisateurs payants disent avoir épuisé une allocation de cinq heures en quelques minutes sur des tâches de code exigeantes ; un utilisateur haut de gamme affirme même avoir consommé son quota mensuel en six heures (reddit.com). Moonshot a reconnu le problème le 25 octobre, s’excusant pour les limites de débit et la consommation inutile de quota. L’entreprise a accordé une réinitialisation ponctuelle de 25 % du quota, tout en réduisant les appels redondants aux sous-agents et la longueur des sorties (x.com). Pour le raisonnement intensif et le code, une utilisation API facturée à 0,30 $ par unité de 100 000 tokens d’entrée et 10 000 tokens de sortie reste plus prévisible que des quotas d’abonnement pouvant disparaître en une seule tâche.
FAQ sur les tarifs de l’API Kimi K3.1 Pro
Combien coûte l’API Kimi K3.1 Pro par million de tokens ?
L’offre standard coûte 2,00 $ en entrée, 10,00 $ en sortie, 0,20 $ pour la lecture de tokens d’entrée mis en cache, 2,00 $ pour une écriture du cache de cinq minutes et 4,00 $ pour une écriture du cache d’une heure, par million de tokens et hors taxes (kimi.ai).
Quelle différence entre K3.1 Pro et Highspeed ?
Highspeed revendique le même niveau d’intelligence et la même fenêtre de contexte de 1 million de tokens, mais répond environ 2 à 3 fois plus vite. Le tarif passe à 4,00 $ en entrée et 20,00 $ en sortie par million de tokens ; les écritures du cache doublent également, tandis que les lectures en cache restent à 0,20 $ (platform.kimi.ai).
Quels sont les identifiants des modèles API ?
Utilisez kimi-k3.1-pro pour l’offre standard et kimi-k3.1-pro-highspeed pour la version rapide sur le endpoint compatible OpenAI de Moonshot. Les passerelles le référencent sous moonshotai/kimi-k3.1-pro (openrouter.ai).
L’utilisation de l’API est-elle incluse dans un abonnement Kimi ?
Non. La facturation de l’API est indépendante des abonnements Kimi et des offres Kimi Code, avec des clés et des soldes séparés. Les crédits d’un abonnement ne peuvent donc pas financer des appels API (kimi.ai).
Peut-on désactiver le raisonnement pour réduire les coûts ?
Non. K3.1 Pro raisonne toujours. Pour maîtriser les coûts, il faut agir sur reasoning_effort (low, high ou max, avec max par défaut) et sur max_completion_tokens, pas désactiver la réflexion (datacamp.com).
Quand les poids ouverts seront-ils disponibles, et faut-il attendre ?
Moonshot vise le 4 novembre 2026, mais au 2 novembre aucun dépôt Hugging Face officiel ni aucune licence finale n’ont été publiés. Pour le moment, prévoyez d’utiliser l’API et ne réévaluez l’auto-hébergement qu’après la publication du checkpoint et de la licence officiels.
À lire également : Kimi K3.1 Pro API : guide des tarifs, benchmarks et de Highspeed pour le détail complet des benchmarks, Tarifs de Kimi K3 pour les prix de la génération précédente et la page de l’API Kimi K3 pour appeler les modèles Kimi avec une seule clé.