 AIREITER
Sur le papier, Kimi K3.1 Pro de Moonshot coche beaucoup de cases pour le code et les agents : 1 million de tokens de contexte, 2 $ par million de tokens d’entrée et 10 $ par million de tokens de sortie. Pour les charges de travail signalées durant la semaine de lancement et examinées ci-dessous, l’API à l’usage revenait très nettement moins cher que l’abonnement à 39 $.
Kimi K3.1 Pro : ce que propose réellement le modèle
Kimi K3.1 Pro est le premier modèle de la série K3.1 de Moonshot AI. Lancé le 23 octobre 2026, il prend la suite, après post-entraînement, de Kimi K3. Moonshot le présente comme un modèle Mixture-of-Experts de classe 3T, conçu pour le code sur des horizons longs, les workflows d’outils 3D et CAD, l’analyse de documents financiers et les agents à plusieurs étapes.
Sa fenêtre de contexte atteint 1 048 576 tokens. Ce quota est partagé entre l’entrée, les tokens de raisonnement et la sortie : il ne s’agit donc pas de 1 M de tokens en entrée auquel s’ajouterait 1 M en sortie. Les produits Moonshot acceptent du texte, des images et de la vidéo ; l’API, elle, renvoie du texte, du code et des appels d’outils. Le résultat visuel est produit par le logiciel externe, qu’il s’agisse de Blender, d’un moteur de jeu ou d’un outil PDF. Le raisonnement est systématiquement activé. Les niveaux de reasoning_effort disponibles sont low, high et max, ce dernier étant le réglage par défaut.
Moonshot avait promis des poids ouverts avant le 4 novembre. Toutefois, lors de sa vérification du 24 octobre, TheQuery n’avait confirmé ni checkpoint téléchargeable ni licence définitive, tandis qu’ArtificialWatch indiquait également une licence inconnue. Mieux vaut donc prévoir un usage via API hébergée tant que le checkpoint et sa licence n’ont pas été publiés.
Tarifs Kimi K3.1 Pro : Standard ou Highspeed
Sur la plateforme API Kimi, Kimi K3.1 Pro Standard coûte 2 $ par million de tokens d’entrée non mis en cache et 10 $ par million de tokens de sortie. Kimi K3.1 Pro Highspeed double les tarifs des tokens facturés — 4 $ en entrée et 20 $ en sortie — tout en conservant le même tarif de 0,20 $ pour la lecture d’entrées mises en cache. Cette grille à 2 $/10 $ et 4 $/20 $ est également reprise par ArtificialWatch et dans le tableau tarifaire d’AI/ML API.
| Opération (par 1 M de tokens) | Kimi K3.1 Pro | Kimi K3.1 Pro Highspeed |
|---|---|---|
| Entrée non mise en cache | 2,00 $ | 4,00 $ |
| Sortie (raisonnement inclus) | 10,00 $ | 20,00 $ |
| Lecture d’entrée mise en cache | 0,20 $ | 0,20 $ |
| Écriture du cache, durée de vie de 5 minutes | 2,00 $ | 4,00 $ |
| Écriture du cache, durée de vie de 1 heure | 4,00 $ | 8,00 $ |
Trois éléments de facturation comptent davantage que le prix affiché. D’abord, les tarifs ne changent pas selon la longueur du contexte et le cache dure cinq minutes par défaut. Réutilisez le préfixe d’un prompt durant cette fenêtre : vous paierez 0,20 $ au lieu de 2,00 $. Ensuite, les tokens de raisonnement sont facturés au tarif de sortie ; avec l’effort max, la trace d’un agent long peut donc devenir le principal poste de coût. Enfin, les frais d’API sont distincts des abonnements Kimi et Kimi Code. Or, la vérification par TheQuery du guide Batch API ne listait pas K3.1 Pro : ne présumez pas qu’une remise Batch s’applique.
À ces tarifs, un exemple à volume fixe reste économique : 100 000 tokens d’entrée non mis en cache (0,20 $), plus 10 000 tokens de sortie (0,10 $), reviennent à 0,30 $ avant les écritures de cache, les outils, les tentatives supplémentaires et les taxes.
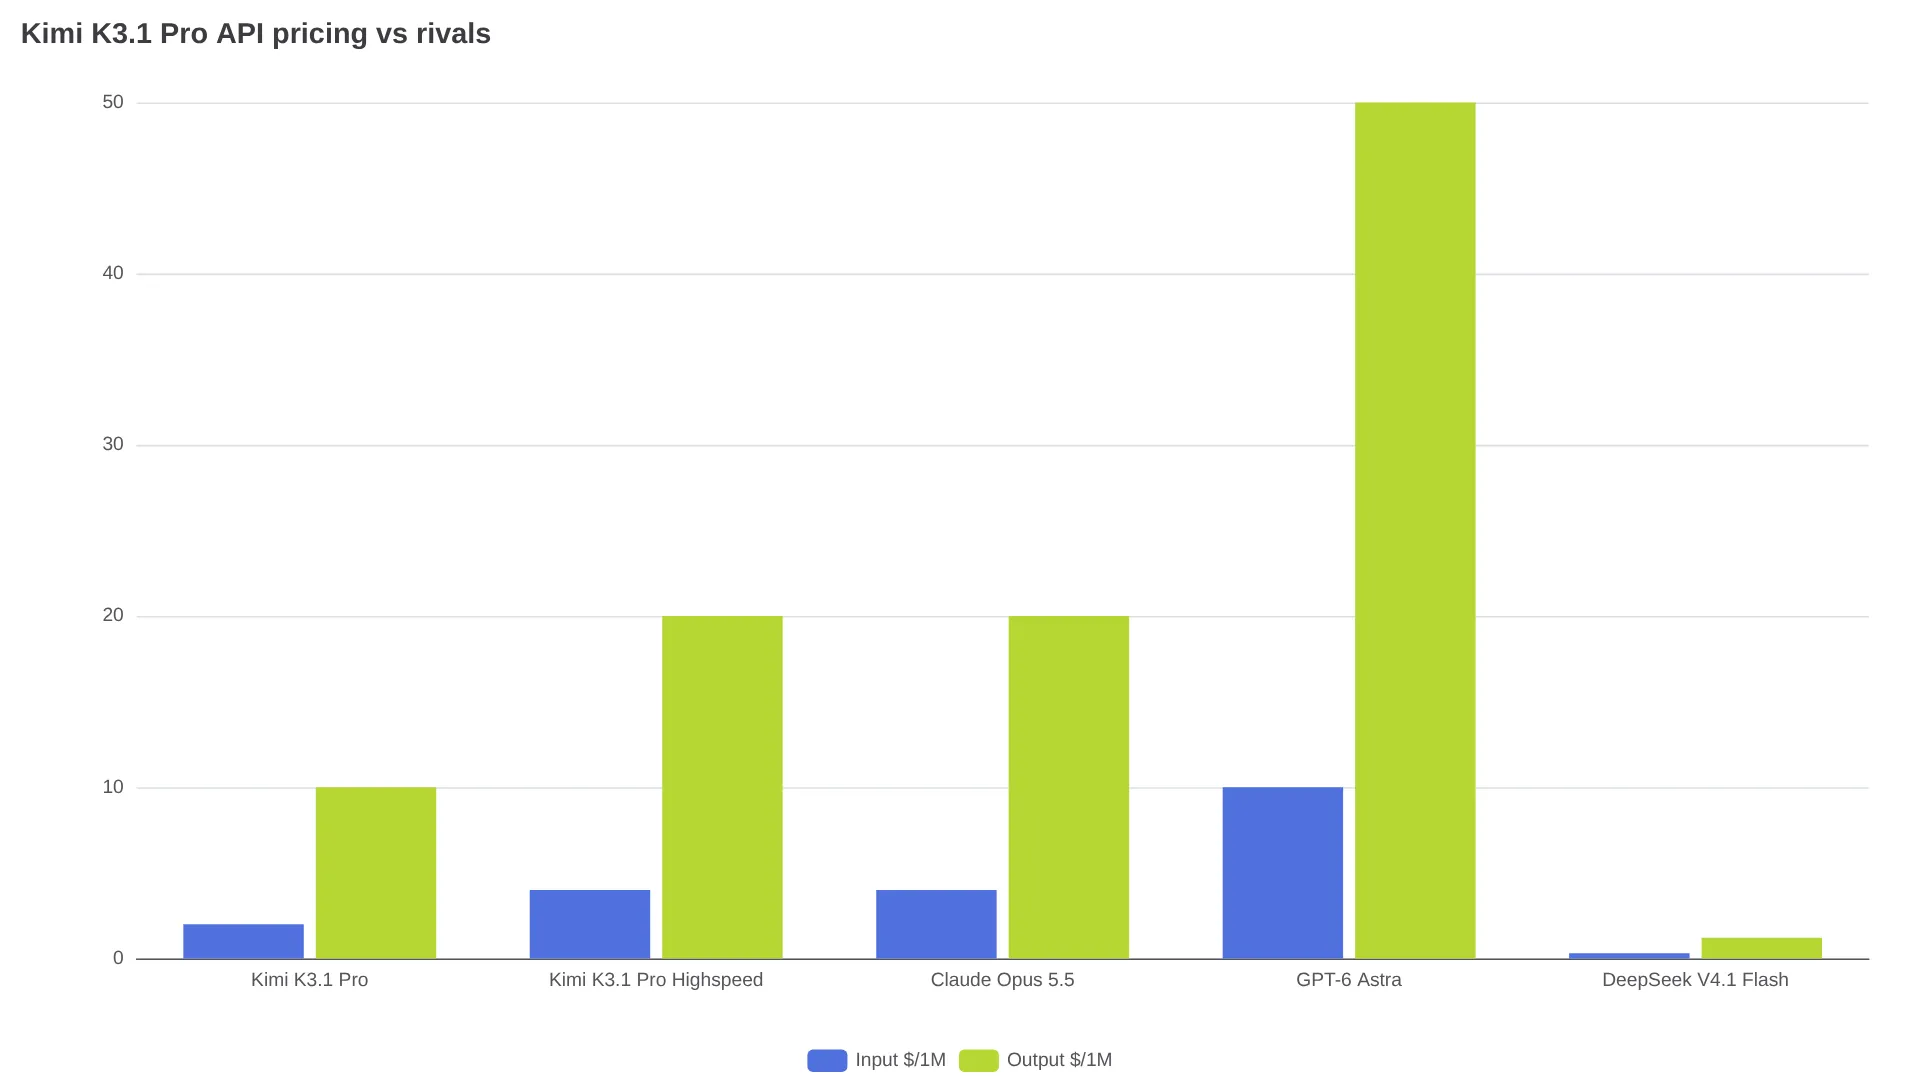
Face aux concurrents, K3.1 Pro Standard coûte 33 % de moins que Kimi K3 (3 $/15 $), deux fois moins que Claude Opus 5.5 (4 $/20 $) et cinq fois moins que GPT-6 Astra (10 $/50 $), selon la comparaison d’ArtificialWatch. DeepSeek V4.1 Flash est moins cher que tous les rivaux cités, à 0,30 $/1,20 $ d’après le tableau tarifaire d’AI/ML API, mais ses scores de benchmark, présentés dans la section suivante, sont très en retrait. Highspeed s’aligne exactement sur le tarif d’Opus 5.5 : il ne se justifie que si son accélération annoncée de 2 à 3x réduit suffisamment la durée d’une tâche limitée par la latence pour compenser le doublement du coût par token.
Pourquoi l’abonnement à 39 $ s’épuise, contrairement à l’API
Le prix de l’API paraissait raisonnable le jour du lancement ; celui de l’abonnement, beaucoup moins. Plusieurs clients payants ont indiqué avoir épuisé leur quota de 5 heures après un ou deux prompts, voire consommé leur quota mensuel avec une seule tâche de code.
"Kimi K3.1 Pro is the best open model in the world right now. No contest. But it's practically unusable on its own subscription. I was on the $39 plan. I built the ship test... it ate 11.6% of my monthly quota. That means I can build something like this about 8 times a month... Worst subscription out there... The bottleneck isn't quality. It's compute." — @Da7_Tech, consommation de quota signalée par l’utilisateur
"absolutely disgusting and shameful usage limits on Kimi K3.1 Pro. My 5-hour limit was DONE after exactly 1 min into the prompt, and nothing was built!" — @MiaAI_lab, abonné à l’offre à 39 $
Un utilisateur a déclaré avoir dépensé 400 $ en abonnements pour quatre prompts et estimé le même travail à 29 $ via l’API. Un autre a rapporté qu’une seule tâche d’animation avait consommé l’essentiel d’un quota de 5 heures. La conséquence est claire pour les développeurs : évaluez K3.1 Pro via une API à l’usage — Moonshot, OpenRouter ou Vercel AI Gateway — où 100 000 tokens en entrée et 10 000 en sortie coûtent 0,30 $ avant nouvelles tentatives et outils, plutôt qu’au travers d’un quota d’abonnement qui mesure bien plus sévèrement le même raisonnement.
Benchmarks : les réserves à garder en tête
Tous les scores phares ci-dessous proviennent de Moonshot, sauf indication contraire. Ils ont été obtenus avec l’effort de raisonnement maximal, une température de 1,0 et un top-p de 0,95. Les faibles écarts doivent être interprétés avec prudence : les scores concurrents ont été collectés avec des harness différents — Kimi Code pour Kimi, Claude Code pour les autres et Codex pour GPT-6 Astra sur OfficeQA — comme le documente AI/ML API.
| Évaluation | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek V4.1 Flash 1017 |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65,7 % | 66,4 % | 58,2 % | 42,3 % |
| SWE-Marathon v1.1 | 51,7 % | 46,3 % | 42,5 % | 40,0 % |
| Agents' Last Exam v1.1 | 43,2 % | 42,6 % | 32,8 % | 37,7 % |
| OfficeQA Pro v2 | 64,4 % | 62,2 % | 54,4 % | 40,4 % |
| BenchCAD avec outils | 92,7 % | 96,2 % | 95,9 % | 81,6 % |
Kimi arrive en tête dans trois évaluations sur cinq. Il accuse 0,7 point de retard sur Terminal-Bench, un écart que TheQuery souligne comme inférieur à l’erreur standard de 2,6 points rapportée par Anthropic pour Opus. Le score de 92,7 % sur BenchCAD correspond au recouvrement de voxels sur un sous-ensemble de 1 000 cas de modèles ouverts. Les chiffres de Claude proviennent quant à eux de system cards, et non d’une réexécution uniforme, selon les notes méthodologiques d’AI/ML API.
Sur la factualité, le benchmark interne Kimi Hallu Bench de Moonshot attribue à K3.1 Pro 5,4 % d’erreurs au niveau des affirmations sur le jeu standard, contre 4,2 % pour GPT-6 Astra, puis 8,3 % contre 5,5 % sur le jeu Hard with-tools, selon le tableau Hallu d’AI/ML API. Cela représente une baisse relative de 65 % par rapport au taux de 23,4 % de K3 sur le jeu difficile. Astra reste néanmoins en tête sur les deux jeux : il doit donc rester dans la sélection quand une seule affirmation erronée suffit à invalider le résultat. Ces tests sont tous des stress tests adversariaux, pas des probabilités d’erreur en usage courant.
Le seul point de données indépendant disponible au lancement venait d’Artificial Analysis. L’organisme a attribué 55 à K3.1 Pro dans son Intelligence Index et l’a classé 4e au général, derrière Claude Opus 5.5, Sonnet 5.5 et Muse Wonder Full. Ce classement étaye l’idée d’un modèle proche de la frontière pour moitié moins cher, sans reposer exclusivement sur des évaluations du fournisseur.
Appeler l’API sans faire exploser la facture
Kimi K3.1 Pro est compatible OpenAI : une migration se limite donc à modifier l’URL de base et l’identifiant du modèle. L’endpoint officiel est https://api.moonshot.ai/v1, avec les model IDs kimi-k3.1-pro et kimi-k3.1-pro-highspeed, d’après la vérification d’endpoint de TheQuery et le guide de configuration d’AI/ML API. Les passerelles tierces emploient des IDs avec préfixe, par exemple moonshot/kimi-k3.1-pro chez Requesty ou moonshotai/kimi-k3.1-pro chez Vercel.
Le quickstart fixe la température à 1,0 et le top-p à 0,95, et recommande de les omettre plutôt que de les ajuster, selon les notes de TheQuery sur le comportement de l’API. Pour maîtriser la dépense, pilotez plutôt reasoning_effort : commencez en low pour les essais, passez à high lorsqu’une tâche échoue, et ne réservez max — la valeur par défaut — qu’à l’exécution finale. Un budget de max_completion_tokens de 8 192 tokens peut produire une réponse visible bien plus courte, car le raisonnement caché consomme le même budget, facturé 10 $ par million.
Liste de contrôle pour limiter les coûts, selon les recommandations d’AI/ML API sur l’usage d’outils et les tokens :
- Conservez le message assistant complet entre les étapes d’outils, y compris
reasoning_contenten streaming, puis renvoyez les résultats des outils avant l’appel suivant. - Réutilisez les préfixes de prompts dans la fenêtre de cache de 5 minutes afin de ramener les entrées répétées à 0,20 $ par million.
- Mesurez le coût par résultat accepté, pas le coût par token.
- Un modèle moins cher par token qui nécessite deux tentatives n’est pas moins cher.
from openai import OpenAI
client = OpenAI(
    base_url="https://api.moonshot.ai/v1",
    api_key="YOUR_KIMI_KEY",
)
resp = client.chat.completions.create(
    model="kimi-k3.1-pro",
    messages=[{"role": "user", "content": "Refactor this module with tests"}],
    extra_body={"reasoning_effort": "low"},
    max_completion_tokens=8192,
)
print(resp.choices[0].message.content)
Un rechargement de 1 $ débloque l’accès, sous réserve de limites de débit par paliers. L’accès entreprise est désactivé par défaut en attendant l’activation par un administrateur, selon la vérification de TheQuery sur le comportement de l’API. Côté confidentialité, l’audit par Opper de la route Moonshot indique que le contenu est conservé et que les données clients servent à l’entraînement par défaut, sans option de zero-data-retention sur cette route. N’y envoyez pas de données confidentielles ou réglementées sans garanties contractuelles.
Faut-il l’utiliser ? Le compromis à intégrer au budget
| Votre besoin | Choix | Pourquoi |
|---|---|---|
| Exécutions de code de niveau frontière au meilleur prix | API Kimi K3.1 Pro | En tête sur SWE-Marathon pour la moitié du prix d’Opus, contexte partagé de 1 M |
| Latence minimale | Kimi K3.1 Pro Highspeed | Accélération annoncée de 2 à 3x, mais coût par token exactement doublé |
| Le moins d’erreurs factuelles | GPT-6 Astra | 4,2 % contre 5,4 % sur Hallu standard, pour 5x le prix |
| Les tokens les moins chers, avec des scores plus faibles | DeepSeek V4.1 Flash | 0,30 $/1,20 $, mais dernier sur quatre des cinq benchmarks listés |
| Auto-hébergement | Attendre | Poids promis avant le 4 novembre, licence inconnue |
Si Moonshot publie les poids complets sous une licence permissive avant le 4 novembre, l’auto-hébergement pourrait rebattre les cartes dans le calcul quota contre API. Les développeurs qui comparent des modèles de code à long contexte ont aussi intérêt à consulter notre sélection des meilleurs LLM pour les agents de code en 2026 avant de s’engager.
FAQ sur l’API Kimi K3.1 Pro
Combien coûte l’API Kimi K3.1 Pro ?
Kimi K3.1 Pro Standard coûte 2 $ par million de tokens d’entrée non mis en cache et 10 $ par million de tokens de sortie. Les lectures d’entrées mises en cache sont facturées 0,20 $ par million. Highspeed double les tarifs d’entrée, de sortie et d’écriture du cache, tout en conservant le prix de 0,20 $ pour les lectures en cache.
Quelle est la différence entre K3.1 Pro et Highspeed ?
Highspeed annonce la même intelligence avec une vitesse de service 2 à 3x supérieure, pour un tarif d’entrée et de sortie doublé (4 $/20 $ contre 2 $/10 $). Le tableau des fournisseurs en direct de Vercel indique une latence plus faible et un débit supérieur pour Highspeed, mais l’accélération revendiquée par Moonshot n’a pas de comparaison indépendante de réalisation de tâches.
Quels sont les model IDs de l’API ?
Utilisez kimi-k3.1-pro et kimi-k3.1-pro-highspeed sur l’API Kimi officielle, ou leurs équivalents avec préfixe, comme moonshot/kimi-k3.1-pro sur les passerelles tierces. Les intégrations K3 existantes doivent changer explicitement d’ID.
L’usage de l’API est-il inclus dans un abonnement Kimi ?
Non. La facturation de l’API est distincte des abonnements Kimi et Kimi Code. Durant la semaine de lancement, les utilisateurs ont constaté que les quotas d’abonnement étaient bien plus restrictifs que les tokens à l’usage pour le même travail.
Peut-on désactiver le raisonnement ?
Non. Kimi K3.1 Pro raisonne systématiquement ; low, high et max ne font que réduire le niveau de délibération, max étant la valeur par défaut. Pour de courtes requêtes ne nécessitant pas de raisonnement, utilisez un autre modèle.
L’API est-elle compatible OpenAI ?
Oui. Pointez un client SDK OpenAI vers https://api.moonshot.ai/v1 — ou l’URL de base d’une passerelle —, définissez le model ID et activez le streaming avec stream=True. Le quickstart fixe la température à 1,0 et le top-p à 0,95. Ajustez plutôt reasoning_effort et max_completion_tokens.