 AIREITER
Pour auto-héberger un modèle dès cette semaine, le choix est simple : MiniMax M3.1 Flash est le seul des deux dont les poids sont téléchargeables. Ceux de Kimi K3.1 Pro ne sont pas encore publiés ; Moonshot promet leur arrivée au plus tard le 4 novembre 2026.
MiniMax est le seul disponible sur Hugging Face pour l’instant
MiniMax a publié les poids de M3.1 Flash vers les 22 et 23 octobre 2026 sur Hugging Face, sous licence minimax-community. Une disponibilité sur ModelScope a également été rapportée lors du lancement (Cocoloop). De son côté, le blog technique officiel de Kimi indique que Kimi K3.1 Pro est déjà accessible via Kimi.com, ses applications, Kimi Code et l’API Kimi, mais que les poids complets n’arriveront que d’ici le 4 novembre 2026 (kimi.com).
M3.1 Flash et Kimi K3.1 Pro : ce que l’on sait des deux modèles
MiniMax M3.1 Flash est un MoE multimodal natif d’environ 428 milliards de paramètres au total, dont 23 milliards actifs par token. Il accepte du texte, des images et de la vidéo en entrée, produit du texte, et prend en charge jusqu’à 1M tokens de contexte (billet de lancement de MiniMax). Kimi K3.1 Pro est officiellement présenté comme un MoE de classe 3T avec une fenêtre de contexte de 1M tokens (kimi.com). Les chiffres de 2,8T de paramètres totaux et 104B actifs proviennent de la couverture du lancement (ArtificialWatch, ExplainX), et non d’une divulgation de paramètres par Moonshot.
| Élément | MiniMax M3.1 Flash | Kimi K3.1 Pro |
|---|---|---|
| Paramètres totaux / actifs | ~428B / 23B par token | Classe 3T ; la couverture du lancement évoque 2,8T / 104B actifs |
| Dépôt Hugging Face | MiniMaxAI/MiniMax-M3.1-Flash, disponible | Aucun au 24 octobre 2026 ; attendu d’ici le 4 novembre |
| Taille du téléchargement | Environ 252 Go | Inconnue ; avec la densité de MiniMax (~0,59 Go par B de paramètres), un checkpoint de 2,8T serait de classe To |
| Contexte | Jusqu’à 1M tokens, selon le déploiement | 1M tokens |
| Entrées / sortie | Texte, image et vidéo en entrée ; texte en sortie | Multimodal, sortie texte ; modalités exactes en auto-hébergement non confirmées |
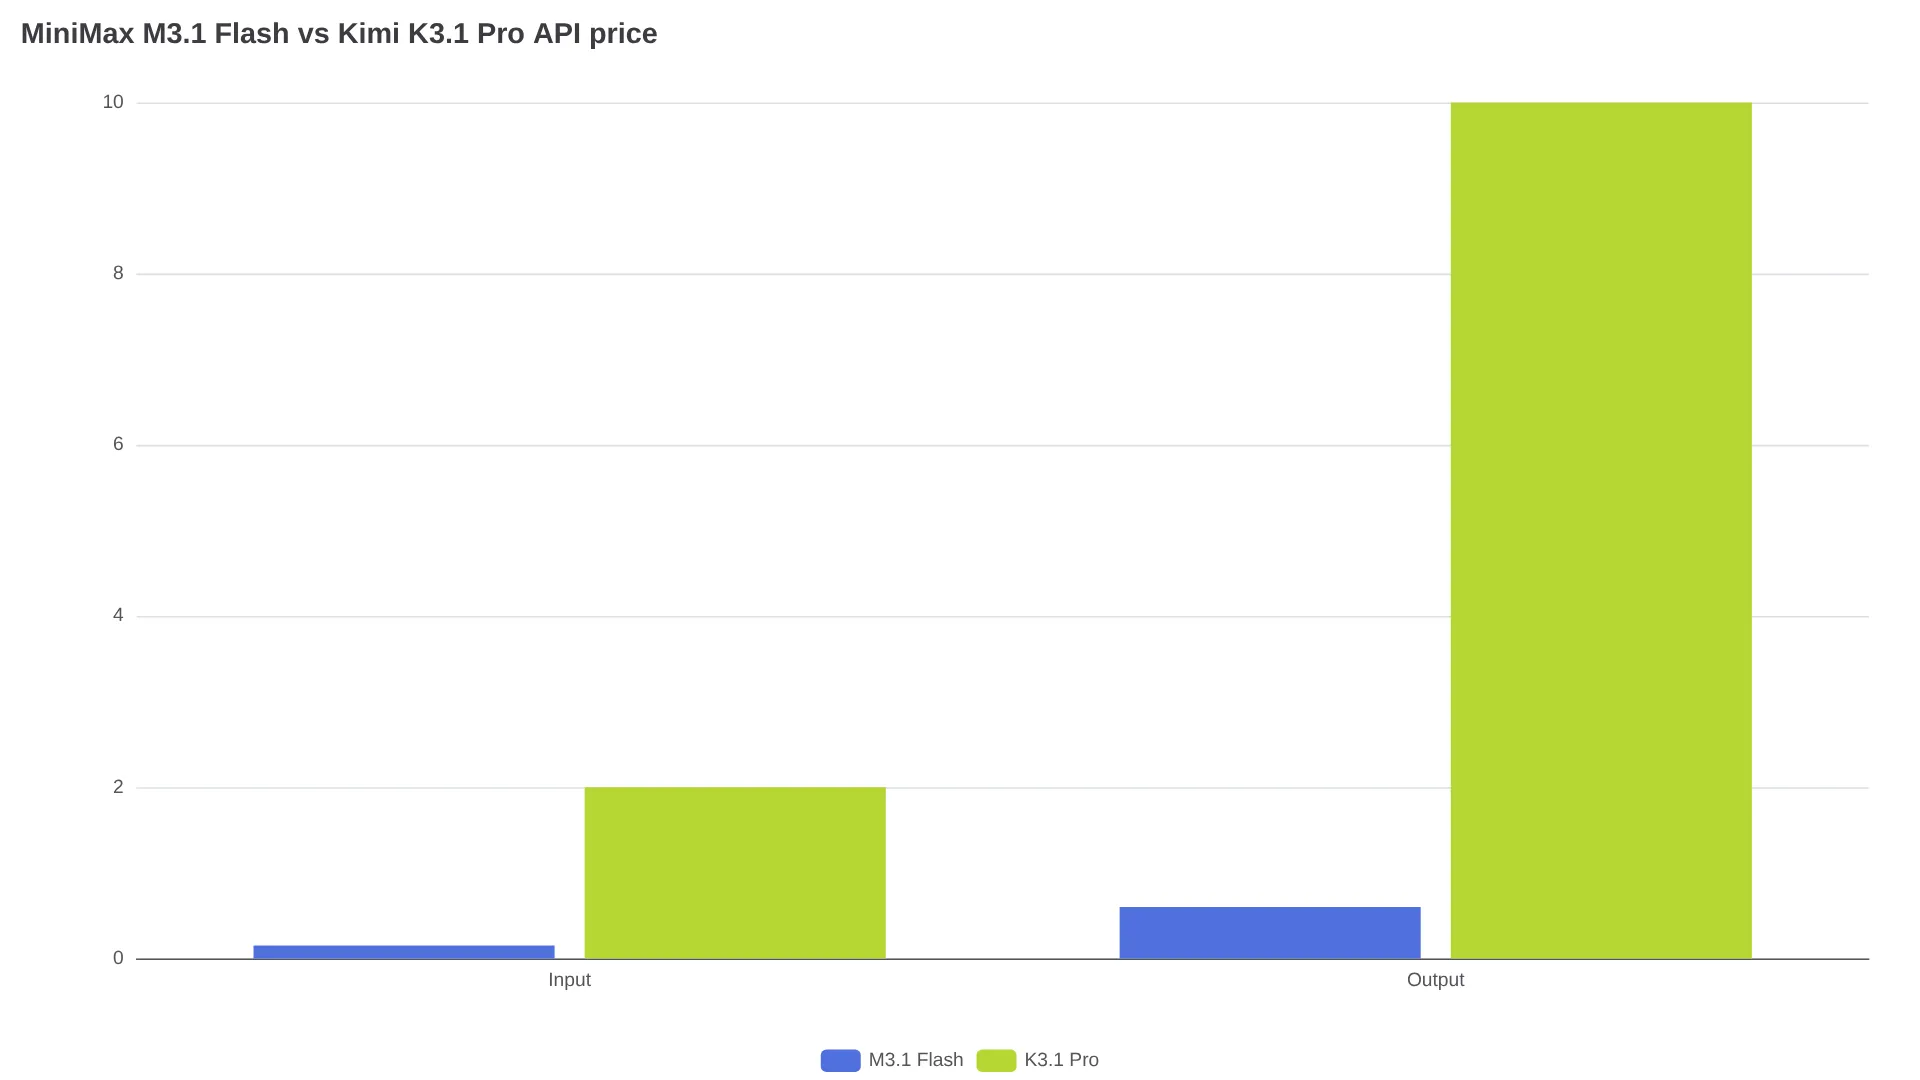
| Tarif API officiel | 0,15 $ en entrée / 0,60 $ en sortie / 0,015 $ en cache par 1M tokens (MiniMax) | Tarifs rapportés de 2 $ en entrée / 10 $ en sortie par 1M tokens (ArtificialWatch) |
| Recettes de serving | SGLang, vLLM, TokenSpeed ; FlagOS en multi-puce | Non annoncées ; identifiants API kimi-k3.1-pro / kimi-k3.1-pro-highspeed (documentation Kimi) |
| Échantillonnage recommandé | Température 1.0, top-p 0.95 ; raisonnement low à max | Effort de raisonnement maximal, température 1.0, top-p 0.95 selon la configuration de benchmark de Kimi |
Pour récupérer le checkpoint MiniMax, utilisez la commande officielle :
hf download MiniMaxAI/MiniMax-M3.1-Flash --local-dir MiniMax-M3.1-FlashAvant de lancer des benchmarks, vérifiez que vous disposez de l’ensemble des fichiers, y compris la tête de brouillon DSpark, le tokenizer et les fichiers de configuration. MiniMax précise que ses résultats concernent les poids officiels et que les quantifications tierces peuvent se comporter différemment.
Pour les benchmarks, considérez les chiffres suivants comme des résultats communiqués par l’éditeur, sauf mention contraire :
| Benchmark | M3.1 Flash (éditeur) | Concurrent cité par l’éditeur |
|---|---|---|
| Automation-Bench v1.0.6 | 62.8 | DeepSeek V4.1 Flash-1017: 60.5 |
| BankerToolBench | 76.2 | Opus 5: 76.2 (égalité) |
| LOCA-Bench 256K | 60.3 | GPT-5.6 Sol: 60.0 |
| DeepSWE v1.1 | 73.7 | DeepSeek V4.1 Flash-1017: 77.0 |
| OSWorld 2.0 | 61.7 | Opus 5: 70.6 |
| Terminal-Bench 4.0 | 38.1 | Opus 5: 51.8 |
Un instantané indépendant cité place M3.1 Flash au milieu du classement, à 53.78 % (16e sur 26), avec des scores faibles sur les tâches de longue durée (Vals). Le graphique de Kimi affirme pour sa part que K3.1 Pro mène sur 6 des 14 tests affichés, dont Agents' Last Exam (43.2) et SWE Marathon (51.7), avec 65.7 sur Terminal-Bench 4.0.
Héberger les 252 Go : ce qu’il faut prévoir
Le dépôt pèse environ 252 Go. À 4 bits par poids, les 428B paramètres représentent à eux seuls quelque 214 Go, avant le cache KV et les buffers d’exécution. Prévoyez donc plusieurs GPU de classe 80 Go avant de pouvoir exploiter un contexte utile. Le compte NVIDIA RTX Spark renvoie vers une DGX Station ou un cluster de 4x DGX Spark 128 GB pour des exécutions locales (post X). Des auto-hébergeurs sur X soulignent qu’un téléchargement de 252 Go et ce niveau de matériel excluent les machines de bureau ordinaires, alors que l’API reste peu coûteuse (@bufcapy).
Commencez par le calcul côté API : celle de MiniMax est inhabituellement bon marché. À 0,15 $ par million de tokens en entrée et 0,60 $ en sortie, une journée à 10M de tokens d’entrée et 2M de tokens de sortie revient à 10 × 0,15 $ + 2 × 0,60 $ = 2,70 $, soit environ 81 $/mois.
Le seuil de rentabilité se calcule en divisant le coût mensuel du cluster par le coût API par token. À 0,15 $ par 1M de tokens d’entrée, chaque tranche de 150 $/mois de location équivaut à 1B de tokens d’entrée ; à 0,60 $ par 1M de tokens de sortie, chaque tranche de 600 $/mois équivaut à 1B de tokens de sortie. Ajoutez votre devis de location et le temps d’ingénierie : l’auto-hébergement ne devient intéressant que si votre facture API mensuelle à ces tarifs dépasse ce total, ou si vos règles imposent de conserver les poids dans votre périmètre. L’écart est encore plus marqué pour Kimi : ses tarifs API rapportés de 2 $/10 $ par 1M tokens représentent environ 13x MiniMax en entrée et près de 17x en sortie. Un futur checkpoint de 2,8T paramètres nécessiterait donc un débit soutenu très élevé pour justifier un stockage de classe To et un cluster multi-nœud.
Ce que l’auto-hébergement apporte dès le premier jour
La prise en charge par les frameworks existe dès le lancement, mais reste incomplète. La carte du modèle cite SGLang, vLLM et TokenSpeed, ainsi que FlagOS pour le déploiement multi-puce, avec des images Docker pour SGLang. Les intégrations Transformers, KTransformers, unsloth et ATOM étaient encore en cours au moment de la sortie. Un déployeur a relevé que l’exemple de configuration vLLM pour H100/H200 cible 256K tokens, plutôt que le 1M complet, désactive l’entrée vidéo et n’active pas le décodage spéculatif DSpark (@sancaksofttech). Le téléchargement est le même, mais toutes les configurations ne débloquent pas toutes les fonctions.
Une inquiétude récurrente sur r/LocalLLaMA : « Flash » décrit l’économie d’inférence, pas un petit modèle :
With quantization can it fit on 256GB? Praying — u/BawbbySmith on r/LocalLLaMA
La licence peut trancher avant même le choix du matériel
M3.1 Flash propose des poids ouverts, mais n’est pas open source. Le fichier LICENSE du dépôt, intitulé minimax-community (voir le fichier LICENSE), autorise librement les usages non commerciaux. Pour un usage commercial, il faut afficher visiblement « Built with MiniMax M3.1-Flash » et adresser une notification unique à MiniMax. Les organisations ou produits réalisant plus de 20M $ de chiffre d’affaires annuel doivent aussi obtenir une autorisation écrite préalable ; les usages militaires sont interdits.
Cette contrainte est légère pour des outils internes, mais peut devenir bloquante pour un service commercial hébergé, où le badge et le seuil de revenus sont les plus difficiles à satisfaire. La licence de Kimi reste inconnue jusqu’à la publication des poids le 4 novembre. Moonshot a déjà précisé dans son blog technique que le checkpoint ouvert différera du modèle API, car les données d’entraînement liées à la cybersécurité ont été retirées des poids ouverts (kimi.com). Lisez les deux fichiers LICENSE avant de construire quoi que ce soit.
Le bon choix selon votre situation
| Votre situation | Choix |
|---|---|
| Besoin de poids cette semaine pour une évaluation locale, une base de fine-tuning ou un déploiement isolé | MiniMax M3.1 Flash — la seule option téléchargeable des deux |
| Agents de code sensibles aux coûts avec une charge variable | API MiniMax à 0,15 $/0,60 $ — n’auto-hébergez qu’au-delà d’un volume soutenu élevé |
| Code de pointe sur des tâches longues, et possibilité d’attendre | Évaluez l’API Kimi K3.1 Pro maintenant ; décidez de l’auto-hébergement après l’arrivée des poids, de la licence et de la taille réelle le 4 novembre |
| Produit commercial hébergé | Faites d’abord valider juridiquement l’attribution MiniMax et le seuil d’autorisation de 20M $ ; Kimi reste impossible à trancher avant la publication de sa licence |
| GPU grand public ou Mac unique | Aucune recette validée sur un seul appareil n’est citée — utilisez l’API, sauf si vous êtes prêt à tester une configuration non prise en charge |
FAQ
Où télécharger officiellement les poids de MiniMax M3.1 Flash ?
Le dépôt officiel est MiniMaxAI/MiniMax-M3.1-Flash sur Hugging Face, avec un miroir ModelScope. Téléchargez-le avec hf download MiniMaxAI/MiniMax-M3.1-Flash --local-dir MiniMax-M3.1-Flash.
Existe-t-il un dépôt Hugging Face officiel pour Kimi K3.1 Pro ?
Non. Au 24 octobre 2026, aucun dépôt public de poids K3.1 Pro n’est disponible ; le blog technique de Moonshot s’engage à publier les poids complets d’ici le 4 novembre 2026.
Puis-je utiliser MiniMax M3.1 Flash commercialement ?
Oui, sous conditions : affichez « Built with MiniMax M3.1-Flash », envoyez une notification unique et obtenez une autorisation écrite préalable au-delà de 20M $ de chiffre d’affaires annuel. Les usages militaires sont interdits. Vérifiez le fichier LICENSE du dépôt avec vos conseils juridiques.
Peut-il tourner sur un GPU grand public ou Apple Silicon ?
Les recommandations de déploiement citées n’incluent pas de configuration validée sur un seul GPU grand public. Les estimations exigent plusieurs GPU de 80 Go pour les poids quantifiés et le cache KV. NVIDIA renvoie vers une DGX Station ou un cluster de 4x DGX Spark 128 GB.
Fonctionne-t-il déjà avec vLLM ou SGLang ?
Les deux disposent de recettes dès le lancement, auxquelles s’ajoutent TokenSpeed et FlagOS pour les exécutions multi-puce. Mais les configurations d’exemple peuvent limiter le contexte à 256K, désactiver l’entrée vidéo ou laisser DSpark désactivé : consultez la recette actuelle de la carte du modèle pour votre matériel.
Le contexte complet de 1M est-il disponible en auto-hébergement ?
Le maximum annoncé est de 1M tokens, mais la longueur réellement utilisable dépend de la mémoire GPU et de la configuration de serving. Prévoyez explicitement une marge pour le cache KV dans les charges de travail à long contexte.
À lire aussi : MiniMax M3.1 Flash Open Weights: Download, Run, Cost Guide, Kimi K3.1 Pro API Pricing Guide, Kimi K3 Open Weights