 AIREITER
Hablar en tiempo real con una IA ya no es una novedad. Lo que ByteDance plantea con SeedRealtime, lanzado el 5 de agosto de 2026, va un paso más allá: un LLM audiovisual full-duplex nativo que procesa audio, vídeo y texto de forma conjunta. La clave no está simplemente en la voz en tiempo real, sino en que un único modelo decide cuándo escuchar, intervenir y responder, sin delegar los turnos de conversación en un módulo externo. Para los desarrolladores hay una limitación importante: en su lanzamiento no cuenta con API pública ni precios, y se integra en productos propios de ByteDance.
Qué propone SeedRealtime
Desarrollado por el equipo Seed de ByteDance, SeedRealtime reúne audio, vídeo y texto en una sola arquitectura. En lugar de mover la información entre etapas separadas, percibe, interpreta, decide y responde sobre flujos multimodales continuos.
ByteDance lo resume con la idea de «ver, escuchar y hablar a la vez»: cada respuesta se apoya conjuntamente en lo que el modelo oye y en lo que ve. SeedRealtime forma parte de la familia de modelos Seed, junto a Seed2.1 —la familia LLM que impulsa Doubao—, Seedance para generación de vídeo, Seedream para imágenes, Seed Audio 1.0 para generación de audio y Seed GR-RL para robótica.
No encaja del todo en las categorías habituales: no es un modelo TTS, aunque genera voz y también la comprende; tampoco es un modelo de visión convencional, porque su capacidad visual está al servicio de la conversación. Y ByteDance no lo presenta como otro asistente de voz en tiempo real sin más.
Full-duplex: la diferencia importante
El término «full-duplex» implica que el modelo puede escuchar y responder simultáneamente, manteniendo de forma continua un modelo de quién habla y cuándo conviene intervenir, como en una conversación real. SeedRealtime asegura lograrlo al integrar sonido, visión, ritmo y expresión dentro de un único modelo end-to-end, en vez de ensamblar módulos independientes.
La interacción con IA en tiempo real ha estado condicionada por dos enfoques anteriores. Los sistemas en cascada enlazan ASR, de voz a texto, con un LLM o VLM y después TTS, de texto a voz. Son modulares y más fáciles de depurar, pero cada relevo introduce latencia y pérdida de información: el tono, las interrupciones, los acentos y el contexto visual suelen desaparecer ya en la fase ASR. Los modelos de voz end-to-end eliminan esos traspasos y resultan más naturales, pero la mayoría sigue recurriendo a un detector externo de actividad de voz, o VAD, para decidir de quién es el turno. En la práctica siguen siendo half-duplex: una pregunta, una respuesta.
SeedRealtime integra percepción, comprensión, toma de decisiones y expresión en un único modelo que ejecuta esos procesos en paralelo sobre flujos audiovisuales continuos, sin un VAD externo que determine los turnos.
| Enfoque | Cómo funciona | Dúplex | Gestión de turnos | Principal limitación |
|---|---|---|---|---|
| En cascada (ASR + LLM/VLM + TTS) | Módulos encadenados de forma secuencial | Half | Finalización fija | Latencia y pérdida de información en cada relevo |
| End-to-end + VAD externo | Un modelo con detector de turnos externo | Half | VAD externo | Sigue el patrón de una pregunta y una respuesta |
| SeedRealtime | Modelo audiovisual end-to-end unificado | Full (según ByteDance) | Interna y multimodal | Es el más reciente; sus capacidades proceden de la descripción del proveedor |
El vídeo añade una dificultad particular: a diferencia del habla, no tiene pausas naturales. El modelo debe decidir constantemente qué objeto merece atención, qué voz es relevante y si debe intervenir, sin reaccionar ante el ruido de fondo.
Las tres capacidades que destaca ByteDance
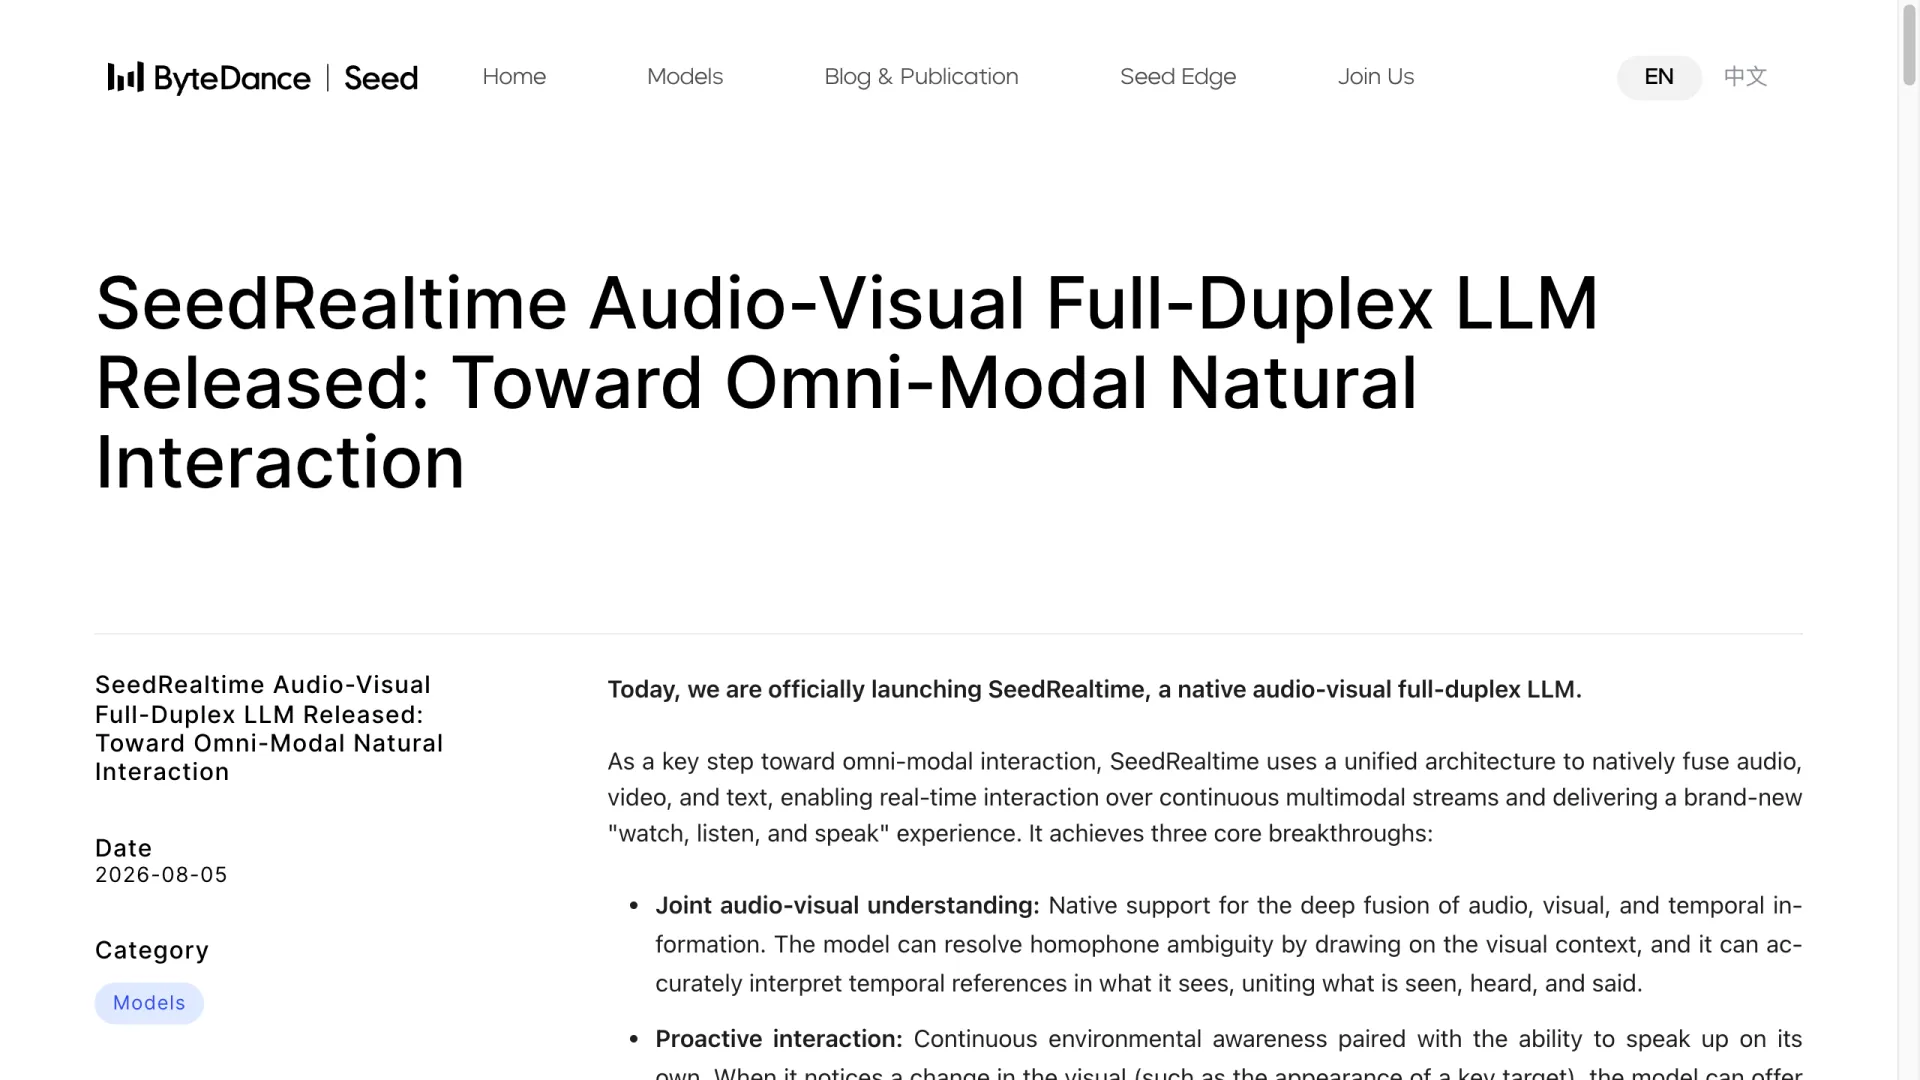
ByteDance agrupa el comportamiento de SeedRealtime en tres capacidades: comprensión audiovisual conjunta, interacción proactiva y ritmo conversacional natural. En vez de apoyarse en tablas de benchmarks, las ilustra con escenarios concretos.
Comprensión conjunta de audio y vídeo
El modelo usa la escena en directo para resolver expresiones ambiguas. Si alguien pregunta «¿cómo hago esto?», SeedRealtime combina la pantalla, los gestos, la mirada y las acciones anteriores para determinar a qué se refiere «esto».
En una demostración de ByteDance, una persona presenta a cuatro amigos durante una cena. SeedRealtime asocia cada nombre con un rostro y mantiene vinculada la voz de cada participante con su identidad mientras el grupo organiza un viaje con preferencias incompatibles: uno quiere playa, otro no soporta el calor y otro tiene alergia al marisco. En un restaurante de Sichuan, lee con la cámara un menú solo en chino, recomienda platos en inglés y explica por qué el «cerdo con sabor a pescado» no lleva pescado.
Interacción proactiva
El modelo puede intervenir por iniciativa propia cuando cambia la escena, sin esperar una pregunta. Durante una visita a un museo, un usuario le pide que le avise al ver el soporte de bronce de un tigre devorando un ciervo. SeedRealtime vigila la señal de la cámara hasta que aparece la pieza y entonces ofrece el recordatorio junto con contexto sobre el objeto.
Al ver a alguien echar granos de café enteros directamente en un portafiltro, interviene para indicar que primero hay que molerlos hasta obtener polvo fino. Después de la extracción, sugiere reducir la siguiente preparación entre dos y tres segundos según el color de la crema. Las llamadas a herramientas, como búsquedas y reservas, se integran en estas respuestas en lugar de resolverse en un paso aparte.
Ritmo de conversación natural
SeedRealtime decide cuándo hablar, hacer una pausa o guardar silencio a partir del contexto multimodal, y trata de evitar activaciones erróneas. En un aeropuerto de Pekín lleno de gente, ignora la mención casual de «el vuelo del viejo Li» por parte de un acompañante, pero cuando se le pregunta recuerda la información de la pantalla de salidas que ya ha desaparecido y consulta en internet la ubicación de la cinta de equipajes. En casa, mientras uno de los padres habla por teléfono al fondo, mantiene la atención en corregir la pronunciación en inglés de un niño.
La evaluación humana end-to-end de ByteDance indica que, frente a modelos en cascada, SeedRealtime reduce aproximadamente a la mitad los problemas de ritmo en conversaciones audiovisuales: menos cortes a mitad de frase, respuestas lentas tras una pausa y activaciones falsas por ruido, además de una mayor proporción de turnos individuales completados de forma fluida. Son evaluaciones realizadas por el proveedor, no benchmarks independientes.
SeedRealtime frente a GPT-4o Realtime, Gemini Live y las arquitecturas en cascada
La cuestión práctica es en qué se diferencia SeedRealtime de los sistemas en tiempo real que los desarrolladores ya pueden utilizar. La respuesta honesta es que la mayoría de las API «realtime» actuales se centran en el audio; la propuesta diferencial de SeedRealtime es modelar conjuntamente audio y vídeo en full-duplex.
La Realtime API de OpenAI y la función para consumidores Gemini Live de Google, junto con su Live API para desarrolladores, ofrecen interfaces de conversación en tiempo real y baja latencia. Sin embargo, se centran en el audio —voz de entrada y voz de salida—, gestionan la visión por separado y mantienen una gestión de turnos que depende de endpointing o VAD. El posicionamiento de SeedRealtime se basa en la combinación de fusión audiovisual nativa, temporización full-duplex decidida dentro del modelo, intervenciones proactivas y uso de herramientas incorporado a la conversación.
| Modelo | Modalidades nativas | Dúplex | Gestión de turnos | Proactividad / uso de herramientas | API pública |
|---|---|---|---|---|---|
| SeedRealtime | Audio + vídeo + texto (fusionados) | Full (según ByteDance) | Interna y multimodal | Sí, integrada | No (en el lanzamiento) |
| GPT-4o Realtime API | Audio + texto | Tiempo real, gestionado por VAD | Endpointing externo | Mediante herramientas de función | Sí |
| Gemini Live / Live API | Audio + texto (cámara en la app de consumo) | Tiempo real, gestionado por VAD | Endpointing externo | Limitado | Sí (Live API, audio) |
| Arquitectura en cascada | Texto (audio mediante ASR/TTS) | Half | Fija | Personalizado | Construida por el usuario |
Las ventajas de SeedRealtime proceden de las propias demostraciones y evaluaciones de ByteDance; no hay una comparación directa publicada frente a GPT-4o realtime o Gemini Live. La tabla anterior debe entenderse como posicionamiento arquitectónico, no como una superioridad medida.
¿Pueden usar SeedRealtime los desarrolladores?
En el momento de su lanzamiento, el 5 de agosto de 2026, SeedRealtime no está disponible como API para desarrolladores. ByteDance afirma que está «fully rolled out», pero se refiere a su despliegue dentro de los productos de la compañía, no a un endpoint abierto al que cualquiera pueda acceder.
No hay API pública, página de precios ni documentación para desarrolladores de SeedRealtime en el lanzamiento. El brazo comercial de API de ByteDance es Volcengine (火山引擎), que aloja la familia de modelos Doubao: los LLM Seed 2.1 Pro y Turbo, Seed-ASR, Seed-TTS y otros. SeedRealtime no figura entre ellos en el lanzamiento, y los servicios de terceros tampoco ofrecen un sustituto audiovisual en tiempo real.
Para los equipos que hoy necesitan un endpoint en tiempo real, las opciones realistas a corto plazo siguen siendo soluciones centradas en audio: la Realtime API de OpenAI, la Live API de Google o una arquitectura en cascada propia. SeedRealtime es, por ahora, una arquitectura a seguir de cerca. ByteDance no ha dado una fecha para una API en tiempo real de Volcengine o BytePlus.
Preguntas frecuentes
¿SeedRealtime está disponible para el público?
Desde el lanzamiento del 5 de agosto de 2026 está desplegado dentro de productos propios de ByteDance, pero no existe una aplicación pública ni un endpoint llamado SeedRealtime al que sea posible registrarse.
¿SeedRealtime tiene API?
No en el lanzamiento. ByteDance no ha publicado acceso por API, precios ni documentación para desarrolladores. Su posible destino futuro sería la familia de API Doubao de Volcengine, donde SeedRealtime todavía no aparece.
¿En qué se diferencia SeedRealtime de GPT-4o realtime?
La Realtime API de GPT-4o se centra en audio: voz de entrada y voz de salida. SeedRealtime asegura modelar conjuntamente audio y vídeo en un único modelo full-duplex que además decide su propio ritmo e interviene de forma proactiva. Todavía no hay una comparación independiente directa.
¿SeedRealtime es gratis?
En el lanzamiento no existe un producto independiente ni una API con precio, así que la distinción entre gratis y de pago todavía no aplica: es una capacidad integrada en productos de ByteDance.
¿Qué significa «full-duplex» en un modelo de IA?
Significa que el modelo puede escuchar y responder a la vez, manteniendo continuamente el estado de la conversación y decidiendo por sí mismo cuándo hablar o hacer una pausa, en lugar de limitarse a turnos de una pregunta y una respuesta.
Lecturas relacionadas
- Precios de OpenAI Realtime API — el endpoint de audio en tiempo real que los desarrolladores pueden utilizar hoy
- Qwen Audio 3 Realtime — otro modelo de voz en tiempo real para comparar