 AIREITER
Qwen-UI-Agent firma los mejores resultados publicados en las comparativas de uso móvil: un 92.2% en la prueba con dispositivos reales MobileWorld-Real y un 97.5% en AndroidDaily. El problema es que el modelo de 27B que está detrás de esas cifras no tiene pesos públicos confirmados ni API. Hoy solo se pueden consultar el informe técnico, las demos y los predecesores más pequeños de MAI-UI. Esa distancia entre lo que promete la tabla de clasificación y lo que realmente se puede descargar es la clave de este lanzamiento. En esta guía repasamos todas las cifras oficiales y comprobamos qué hay disponible de verdad.
La tabla completa de resultados de Qwen-UI-Agent
Qwen-UI-Agent es un agente GUI fundacional publicado por el equipo Tongyi-MAI de Alibaba en forma de informe técnico el 30 de julio de 2026 (arXiv 2607.28227). Un único modelo cubre entornos móviles, uso del ordenador, web y DeepSearch, con un espacio de acciones unificado que incluye operaciones GUI, ejecución de CLI y secuencias de acciones por lotes. En la página oficial de resultados, Qwen-UI-Agent lidera todos los benchmarks móviles y de grounding mostrados, queda segundo en OSWorld-Verified y tercero en la prueba de tareas largas OSWorld-v2. El informe evalúa las variantes 27B, 35B-A3B y 4B; las cifras que aparecen a continuación corresponden al modelo insignia de 27B.
Móvil: la reivindicación del estado del arte
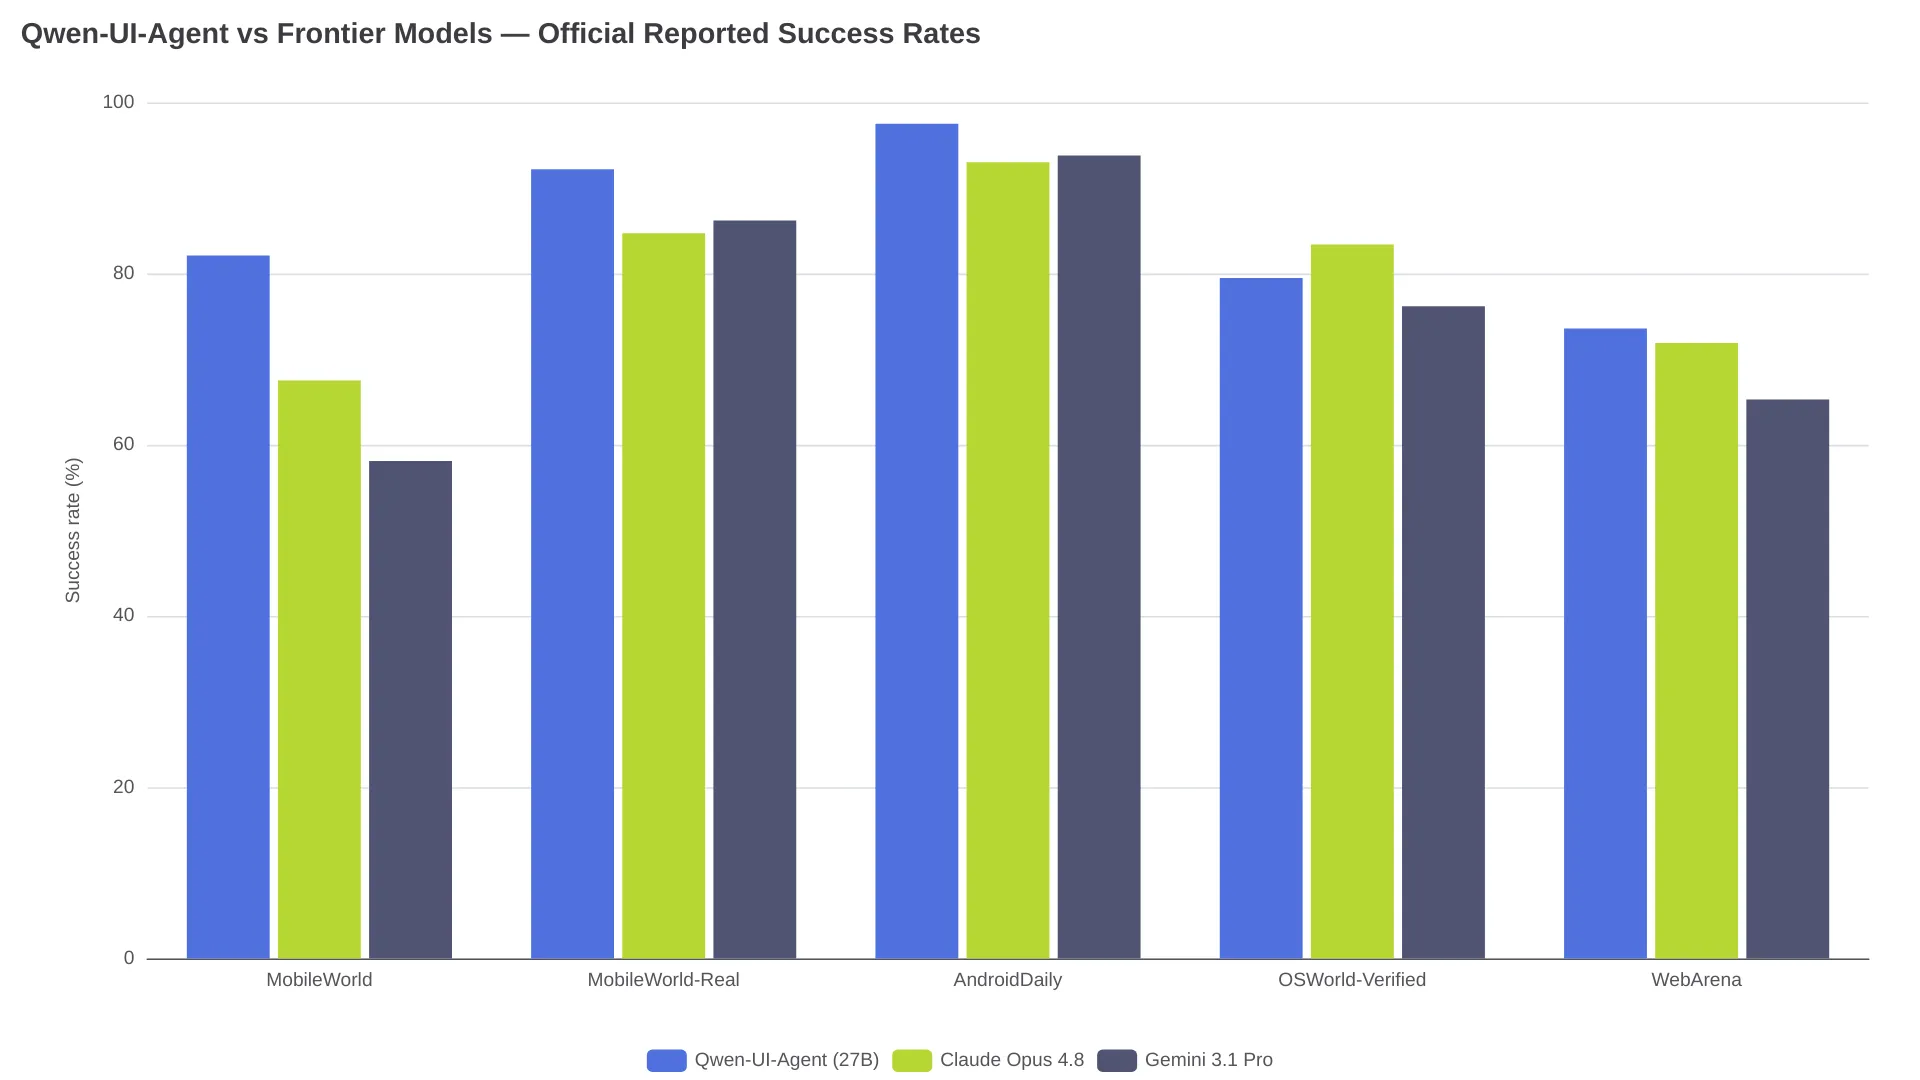
El apartado móvil es donde el informe reclama el estado del arte, y la diferencia no es precisamente marginal. En la división de MobileWorld que solo mide GUI, Qwen-UI-Agent alcanza un 82.1%: 8.9 puntos más que el siguiente modelo generalista, Seed 2.1 Pro, con un 73.2%, y 38.2 puntos por encima del agente GUI especializado más fuerte, GUI-Owl-1.5-32B-Instruct, con un 43.9%.
| Modelo | MobileWorld (solo GUI) | MobileWorld-Real | AndroidDaily |
|---|---|---|---|
| Qwen-UI-Agent (Alibaba) | 82.1 | 92.2 | 97.5 |
| Seed 2.1 Pro (ByteDance) | 73.2 | 88.7 | 95.2 |
| Claude Opus 4.8 (Anthropic) | 67.5 | 84.7 | 93.0 |
| Gemini 3.1 Pro (Google) | 58.1 | 86.2 | 93.8 |
| Qwen 3.7 Plus (Alibaba) | 62.3 | 72.7 | 79.8 |
Las tablas oficiales utilizan GPT-5.6 Sol para las filas móviles (70.1 / 85.4 / 92.6) y GPT-5.5 para las filas de escritorio. Conviene tenerlo claro antes de citar una única cifra de «GPT» como si todas procedieran del mismo modelo.
MobileWorld-Real es el benchmark estrella y también una creación del propio equipo: 409 tareas de principio a fin en 104 aplicaciones Android reales de siete ámbitos de uso cotidiano. Las pruebas se ejecutan en dispositivos activos, con cuentas reales e interrupciones del mundo real, y un juez basado en el voto mayoritario de cinco VLM se encarga de puntuarlas.
Uso del ordenador: buenos resultados, pero no lidera
En escritorio es donde el calificativo «competitivo» del informe adquiere todo su sentido. El 79.5% de Qwen-UI-Agent en OSWorld-Verified le coloca segundo, 3.9 puntos por detrás de Claude Opus 4.8. En la prueba de tareas largas OSWorld-v2, el 40.0% corresponde a progreso parcial; la finalización binaria se queda en 13.9%. Claude Opus 4.8, con 54.8, y GPT-5.5, con 49.5, están claramente por delante.
| Modelo | OSWorld-Verified | OSWorld-v2 (parcial) | OSWorld-v2 (binario) |
|---|---|---|---|
| Claude Opus 4.8 | 83.4 | 54.8 | no publicado |
| Qwen-UI-Agent | 79.5 | 40.0 | 13.9 |
| Seed 2.1 Pro | 78.8 | no publicado | no publicado |
| GPT-5.5 | 78.7 | 49.5 | 13.0 |
| MiniMax M3 | no publicado | 22.3 | no publicado |
Eso sí, la eficiencia es un punto a favor. Las acciones por lotes reducen la media a 135.8 pasos por tarea, frente a los 326.7 de MiniMax M3 y los 173.5 de Qwen 3.7 Plus. Además, el modelo supera por más de 17 puntos a todos los modelos de pesos abiertos en progreso parcial. En OSWorld-v2, los comandos CLI representan más del 50% de las operaciones del agente: el diseño híbrido GUI+CLI tiene un efecto medible.
Navegador y DeepSearch
WebArena también cae del lado de Qwen-UI-Agent, con un 73.6%, por delante de Claude Opus 4.8 (71.9), GPT-5.5 (69.5) y Gemini 3.1 Pro (65.3). En investigación, BrowseComp alcanza 64.1 frente al 61.0 de la línea base Qwen3.5-27B, mientras que BrowseComp-ZH llega a 75.0 frente a 62.1. La formación en DeepSearch se nota en la capacidad de investigar, no solo en la de señalar elementos en pantalla.
Grounding GUI: pleno en todas las pruebas
El grounding —hacer clic en el píxel correcto a partir de una instrucción visual— es un pleno: según la página oficial de resultados, Qwen-UI-Agent ocupa el primer puesto en todos los benchmarks de grounding mostrados.
| Benchmark | Qwen-UI-Agent | Mejor competidor |
|---|---|---|
| ScreenSpot-Pro (sin zoom) | 76.6 | 72.9 (GUI-Owl-1.5) |
| ScreenSpot-Pro (con zoom) | 81.5 | 80.7 (Seed 2.1 Pro) |
| SS-V2 | 97.5 | 96.6 (Seed 2.1 Pro / Qwen 3.7 Plus) |
| MM-GUI-L2 | 92.6 | 91.3 (MAI-UI) |
| OSW-G-R | 78.5 | 78.2 (Qwen 3.7 Plus) |
| UI-Vision | 70.0 | 68.0 (Qwen 3.7 Plus) |
El precio de ser generalista es pequeño
Los modelos especializados en GUI suelen perder fuelle cuando toca comportarse como modelos de lenguaje. Qwen-UI-Agent apenas paga ese precio: obtiene 86.5 en MMLU-Pro frente al 86.0 de Qwen3.5-27B, y 90.2 en IFEval frente a 90.4. Cuando se compara con modelos especializados, eso sí, la diferencia se convierte en un abismo.
| Benchmark | Qwen-UI-Agent | Qwen3.5-27B | UI-Venus 30B-A3B | GUI-Owl 32B | OpenCUA-72B |
|---|---|---|---|---|---|
| Tau2-Bench | 89.9 | 89.2 | 22.7 | 6.1 | 14.4 |
| Terminal-Bench 2.0 | 50.1 | 41.1 | 3.2 | 0.0 | 9.0 |
| BFCL-v4 | 74.2 | 71.3 | 19.8 | 32.7 | 28.3 |
| BrowseComp | 64.1 | 61.0 | no publicado | no publicado | no publicado |
| QwenClawBench | 44.2 | 48.5 | 6.4 | 5.1 | 11.4 |
La única derrota visible frente a su propia línea base llega en QwenClawBench (44.2 frente a 48.5). También hay que tener en cuenta que la página oficial identifica estas puntuaciones de capacidades generales como resultados reproducidos en el entorno de evaluación de los autores.
Cómo se entrenó Qwen-UI-Agent
Según el informe técnico, los datos de entrenamiento de Qwen-UI-Agent proceden de una flota de dispositivos reales: más de 100 teléfonos físicos que cubren más de 150 aplicaciones. Con ellos, el equipo alimenta un ciclo de datos impulsado por agentes que construyen y diagnostican sus propias tareas. Después del fine-tuning supervisado llega un entrenamiento RL en varias etapas, con trayectorias de más de 100 turnos y despliegues en más de 10.000 entornos simultáneos.
Hasta dónde confiar en la tabla de resultados
La página oficial deja tres advertencias que deberían acompañar a cualquier cifra que se cite. La primera: MobileWorld-Real es un benchmark creado por los propios autores. La segunda: las puntuaciones de las líneas base marcadas con una daga fueron reproducidas por los autores en su propio entorno; el arnés, el juez, el simulador y los subconjuntos de tareas pueden diferir de las evaluaciones oficiales de otros proveedores. La tercera: el 40.0% de OSWorld-v2 mide progreso parcial, no tasa de éxito. (Fuente: las notas de la página oficial de resultados y el informe técnico).
«El nuevo agente GUI de Alibaba gana en el teléfono y se atasca en el escritorio». — @Daily_AI_Brief en X, que también señaló que «Alibaba puntuó todas las líneas base en su propio entorno».
Las lecturas independientes publicadas en X llegaron a la misma conclusión. Un análisis en japonés de @itarutomy destacó el liderazgo móvil con dispositivos reales y subrayó que las cifras de escritorio lo dejan en segundo lugar. El hilo del anuncio oficial de Pengxiang Li, de Tongyi Lab (@oliverlee1999), es la fuente primaria del lanzamiento. La conclusión es sencilla: MobileWorld-Real debe considerarse una afirmación potente pendiente de reproducción, mientras que OSWorld-Verified ofrece una comparación más fácil de trasladar a otros contextos porque no es un benchmark creado por los autores.
Cómo acceder hoy a Qwen-UI-Agent
Qwen-UI-Agent es, por ahora, un lanzamiento de investigación: hay un informe, una página de proyecto y repositorios de código, pero no un checkpoint público confirmado del modelo. Esto es lo que incluye cada recurso disponible.
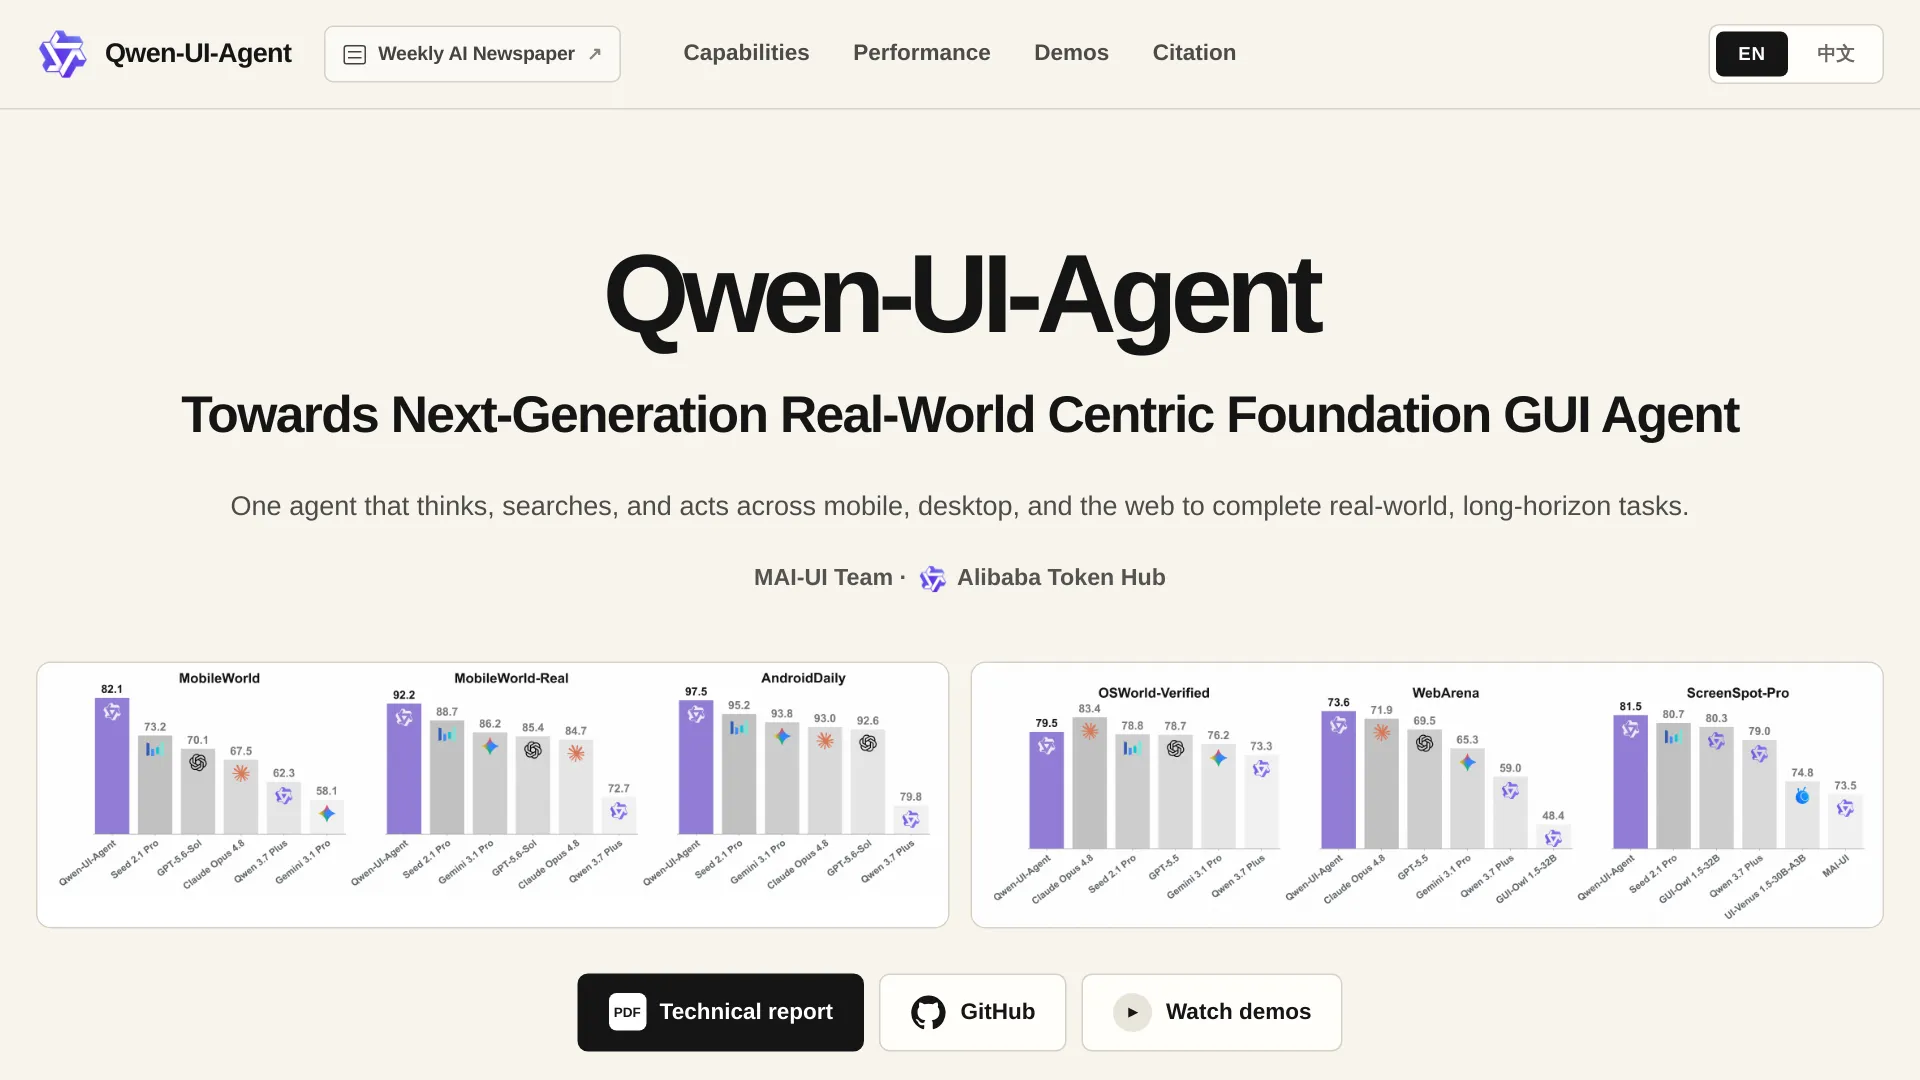
Auditoría de los recursos publicados
| Recurso | Enlace | Qué contiene |
|---|---|---|
| Informe técnico | arxiv.org/abs/2607.28227 | Informe completo, enviado el 30 de julio de 2026; PDF, HTML y código fuente TeX |
| Página del proyecto | tongyi-mai.github.io/Qwen-UI-Agent | Demos de capacidades, gráficos completos de benchmarks e información de citación |
| Repositorio de MAI-UI | github.com/Tongyi-MAI/MAI-UI | Repositorio con licencia Apache-2.0, renombrado para Qwen-UI-Agent; enlaza los checkpoints MAI-UI-8B y MAI-UI-2B de Hugging Face, publicados en diciembre de 2025 |
| Repositorio de Qwen-UI-Agent | github.com/Tongyi-MAI/Qwen-UI-Agent | Solo contiene el código de la web; el propio repositorio indica que no incluye el modelo, el código de entrenamiento ni la implementación del agente |
El repositorio de MAI-UI es la continuación oficial del proyecto. Allí se anunció Qwen-UI-Agent el 30 de julio de 2026 y, por ahora, se enlazan los únicos checkpoints descargables de esta línea.
La situación de los pesos
Los únicos checkpoints descargables son MAI-UI-8B y MAI-UI-2B, los predecesores de diciembre de 2025 enlazados desde las referencias de Hugging Face del repositorio de MAI-UI. No hay confirmación pública de ningún checkpoint Qwen-UI-Agent 27B, 35B-A3B o 4B. El estado de disponibilidad se comprobó en los repositorios oficiales y en la página del proyecto a finales de agosto de 2026, y en ninguno aparecía un lanzamiento. No confundas los enlaces a los checkpoints de MAI-UI ni el repositorio con el código de la web con los pesos del modelo Qwen-UI-Agent.
Sin API ni ejecución propia… de momento
No aparece ningún endpoint público de Qwen-UI-Agent, producto alojado ni paquete para vLLM/Ollama en los canales oficiales. En la práctica, si necesitas sacar adelante flujos de trabajo de escritorio, los resultados publicados en OSWorld favorecen a Claude Opus 4.8. Para experimentar con GUI y pesos abiertos, la vía disponible es MAI-UI 2B/8B junto con tu propio arnés; y eso es MAI-UI, no Qwen-UI-Agent. Consulta los repositorios oficiales de Tongyi-MAI y los canales de Qwen para enterarte de futuros anuncios. Para la línea generalista de Qwen, que sí dispone de API, el catálogo de modelos Qwen de AIReiter mantiene al día los endpoints y los precios.
El lugar de Qwen-UI-Agent en el árbol familiar
Qwen-UI-Agent es la tercera generación de la línea de agentes GUI de Alibaba. UI-TARS abrió el camino del enfoque GUI de Qwen en 2025; MAI-UI (arXiv 2512.22047, diciembre de 2025) introdujo el ciclo de datos centrado en el mundo real y publicó los pesos 2B/8B con licencia abierta; y Qwen-UI-Agent lleva esa receta hasta 27B con ejecución híbrida GUI+CLI. En las dos métricas de OSWorld de las tablas anteriores, Claude Opus 4.8 ocupa el primer puesto.
Preguntas frecuentes sobre Qwen-UI-Agent
¿Qwen-UI-Agent es de código abierto?
Los repositorios de código utilizan Apache-2.0 y el informe es público, pero no hay confirmación de que el modelo tenga pesos abiertos. Solo se pueden descargar los checkpoints predecesores MAI-UI-8B y MAI-UI-2B (Hugging Face, diciembre de 2025). En el momento de redactar este artículo no había un lanzamiento público confirmado de ningún checkpoint Qwen-UI-Agent 27B, 35B-A3B o 4B.
¿Se puede ejecutar Qwen-UI-Agent en local hoy?
No existe una configuración local verificada: no hay checkpoint, paquete GGUF u Ollama, ni receta para vLLM. Los experimentos locales se limitan a MAI-UI 2B/8B con tu propio arnés.
¿Tiene API Qwen-UI-Agent?
No se ha anunciado ningún endpoint público ni producto alojado. Consulta los repositorios oficiales de Tongyi-MAI en GitHub y los canales del equipo de Qwen para conocer futuros lanzamientos.
¿Cómo se compara Qwen-UI-Agent con Claude Opus 4.8 en el uso del ordenador?
Claude Opus 4.8 lidera OSWorld-Verified por 83.4 frente a 79.5 y el progreso parcial de OSWorld-v2 por 54.8 frente a 40.0. Qwen-UI-Agent, en cambio, gana en WebArena por 73.6 frente a 71.9 y en todos los benchmarks móviles mostrados. Para tareas largas de escritorio, la ventaja actual es de Claude; el terreno donde Qwen-UI-Agent ofrece sus mejores cifras publicadas es el uso móvil.
¿Qué es MobileWorld-Real?
Es un benchmark Android con dispositivos reales creado por los autores de Qwen-UI-Agent: 409 tareas en 104 aplicaciones activas de siete ámbitos de uso cotidiano, puntuadas por un juez basado en el voto mayoritario de cinco VLM. Sus resultados son autodeclarados y todavía esperan una reproducción independiente.
Qué podría cambiar este análisis
Hay tres señales que modificarían de forma sustancial esta valoración:
| Señal | Por qué importa |
|---|---|
| Un checkpoint de Qwen-UI-Agent bajo la presencia de Tongyi-MAI en Hugging Face | Convertiría el lanzamiento de investigación en una opción utilizable y permitiría obtener cifras de terceros |
| Una reproducción de OSWorld-Verified fuera del arnés de Alibaba | Permitiría saber si el 79.5% se mantiene más allá del entorno de los autores |
| Cualquier superficie de producto: API, integración en una aplicación de Qwen o preview | Llevaría la comparación de las tablas del informe a las decisiones y compromisos de producción |
Hasta que llegue alguna de esas señales, el equilibrio sigue sin resolverse: el liderazgo móvil de las comparativas publicadas hasta ahora es autodeclarado y se basa en un benchmark creado por el mismo equipo.
Lecturas relacionadas: el nuevo buque insignia generalista de Alibaba y el estado de sus pesos abiertos se analizan en Qwen3.8-Max open weights, mientras que sus costes por endpoint aparecen en la guía de precios de la API de Qwen3.8-Max.