 AIREITER
Tras tres semanas bajo el cartel de «próximamente», los pesos de Qwen3.8-2.4T-A95B aparecieron en ModelScope el 12 de agosto de 2026. La cifra que acapara titulares es de 2,4 billones de parámetros totales, aunque solo activa 95.000 millones por token. El problema está en la infraestructura: incluso cuantizado a 4 bits, necesita alrededor de 1,2 TB de VRAM. Para prácticamente cualquiera que no opere en un centro de datos, ejecutarlo en local no es una opción realista. Esto es lo que incluye el lanzamiento, cuánto cuesta utilizarlo y cuándo la API es la única vía con sentido.
Ya puedes descargar los pesos de Qwen3.8-2.4T-A95B
Los pesos ya están disponibles. El equipo Qwen de Alibaba publicó el checkpoint de Qwen3.8-2.4T-A95B a última hora del 12 de agosto a través de su cuenta comunitaria de ModelScope. Es el primer modelo de la gama Qwen-Max que recibe una publicación de pesos abiertos. Los tres Qwen Max anteriores —Qwen3.5-Max, Qwen3.6-Max y Qwen3.7-Max— se mantuvieron exclusivamente como API.
Conviene aclarar desde el principio una diferencia de nombres: «Qwen3.8» puede referirse a dos productos distintos.
| Nombre | Qué es | Dónde conseguirlo |
|---|---|---|
| Qwen3.8-2.4T-A95B | Modelo base con pesos abiertos | ModelScope (checkpoint descargable) |
| Qwen3.8-Max | Versión alojada en la nube con capacidades adicionales para producción | Alibaba Token Plan, Qoder, QoderWork |
Qwen3.8-Max parte del modelo A95B de pesos abiertos, pero incorpora mejoras posteriores al entrenamiento. Alibaba describe un sistema de tres etapas que abarca escalado en entornos reales, señales de recompensa unificadas y equilibrio de datos en línea. Los pesos abiertos dan acceso al modelo base, no a toda la pila de producción de Max.
Las guías que aún indican que los pesos están «prometidos pero no disponibles» han quedado desactualizadas: el lanzamiento llegó dentro de la ventana prevista por Alibaba para la «semana del 10 de agosto».
Especificaciones confirmadas: 95B activos y contexto nativo de 256K
Desde el adelanto del 19 de julio, la cantidad de parámetros activos era el dato ausente más solicitado. Varias guías de terceros lo señalaban expresamente como «no publicado». Ahora está confirmado: 95.000 millones de parámetros activos por token de un total de 2,4 billones.
| Especificación | Valor confirmado |
|---|---|
| Parámetros totales | 2.4T |
| Parámetros activos por token | 95B |
| Arquitectura | MoE (continúa el diseño híbrido de Qwen3.5) |
| Expertos por capa MoE | 512 |
| Expertos enrutados por token | 10 |
| Expertos compartidos por token | 1 |
| Ventana de contexto nativa | 262.144 tokens (256K) |
| Contexto ampliable | 1.010.000 tokens (1.01M) |
| Método de entrenamiento | Multi-Token Prediction (MTP) |
| Primer lanzamiento Qwen-Max con pesos abiertos | Sí (12 de agosto de 2026) |
Hay dos matices importantes. El primero es que la ventana de contexto nativa es de 256K, no de 1 millón de tokens como se había asumido ampliamente. La cifra de 1.01M corresponde a un modo ampliable cuyas concesiones de calidad Alibaba aún no ha documentado. El segundo es que el enrutamiento MoE es extremadamente disperso: solo se activan 11 de los 512 expertos por token, 10 enrutados y 1 compartido. Esa tasa de activación de parámetros de alrededor del 4 % —95B de 2.4T— es la que permite que un input a $2/M sea viable económicamente pese a la huella total de 2.4T.
El entrenamiento MTP (Multi-Token Prediction) permite que los motores de inferencia compatibles predigan varios tokens en cada pasada hacia delante, con el potencial de mejorar el rendimiento. Alibaba no ha concretado qué motores lo admiten.
Autoalojar 2.4T: la realidad del hardware y el coste
Las especificaciones impresionan hasta que toca cargar el modelo. Las cuentas son claras.
Con cuantización a 4 bits, 2,4 billones de parámetros ocupan aproximadamente 1,2 TB de almacenamiento, antes de sumar la caché KV, la memoria de activaciones o la sobrecarga de ejecución. Una GPU NVIDIA H200 tiene 141 GB de memoria. Ocho H200 suman 1.128 GB, una capacidad insuficiente para alojar los pesos y atender a la vez una ventana de contexto mínimamente útil.
| Escenario de despliegue | VRAM necesaria (est.) | Hardware | ¿Es viable? |
|---|---|---|---|
| Precisión completa (16 bits) | ~4.8 TB | 34+ GPU H200 | Solo centro de datos |
| Cuantizado a 4 bits | ~1.2 TB | 9+ GPU H200 | Solo centro de datos |
| Cuantizado a 1.5 bits | ~450 GB | 4+ GPU H200 | Muy ajustado; la pérdida de calidad es incierta |
| Qwen3.8-27B (alternativa) | ~27 GB a 4 bits | 1 GPU de consumo | Sí |
Los 95B de parámetros activos ayudan al rendimiento de inferencia por token, ya que el modelo solo enruta una fracción de sus expertos en cada pasada. Pero los parámetros activos no reducen la memoria necesaria para almacenar las 512 redes de expertos. Como resume GEO Toolbox: «La activación dispersa hace que el modelo sea barato de ejecutar a escala, no barato de poseer».
Para un despliegue local o en un único servidor, la opción realista es la variante Qwen3.8-27B. Comparte la línea de entrenamiento de Qwen3.8, pero cabe en una sola GPU de consumo a 4 bits. El modelo de 2.4T está pensado para investigación y centros de datos.
Cuándo conviene más usar la API
Como autoalojar un modelo MoE de 2.4T está fuera del alcance de casi cualquier equipo, el acceso práctico pasa por la API. Model Studio de Alibaba fija Qwen3.8 Max en $2 por millón de tokens de entrada y $6 por millón de tokens de salida, por debajo tanto de su predecesor como de su rival chino más cercano.
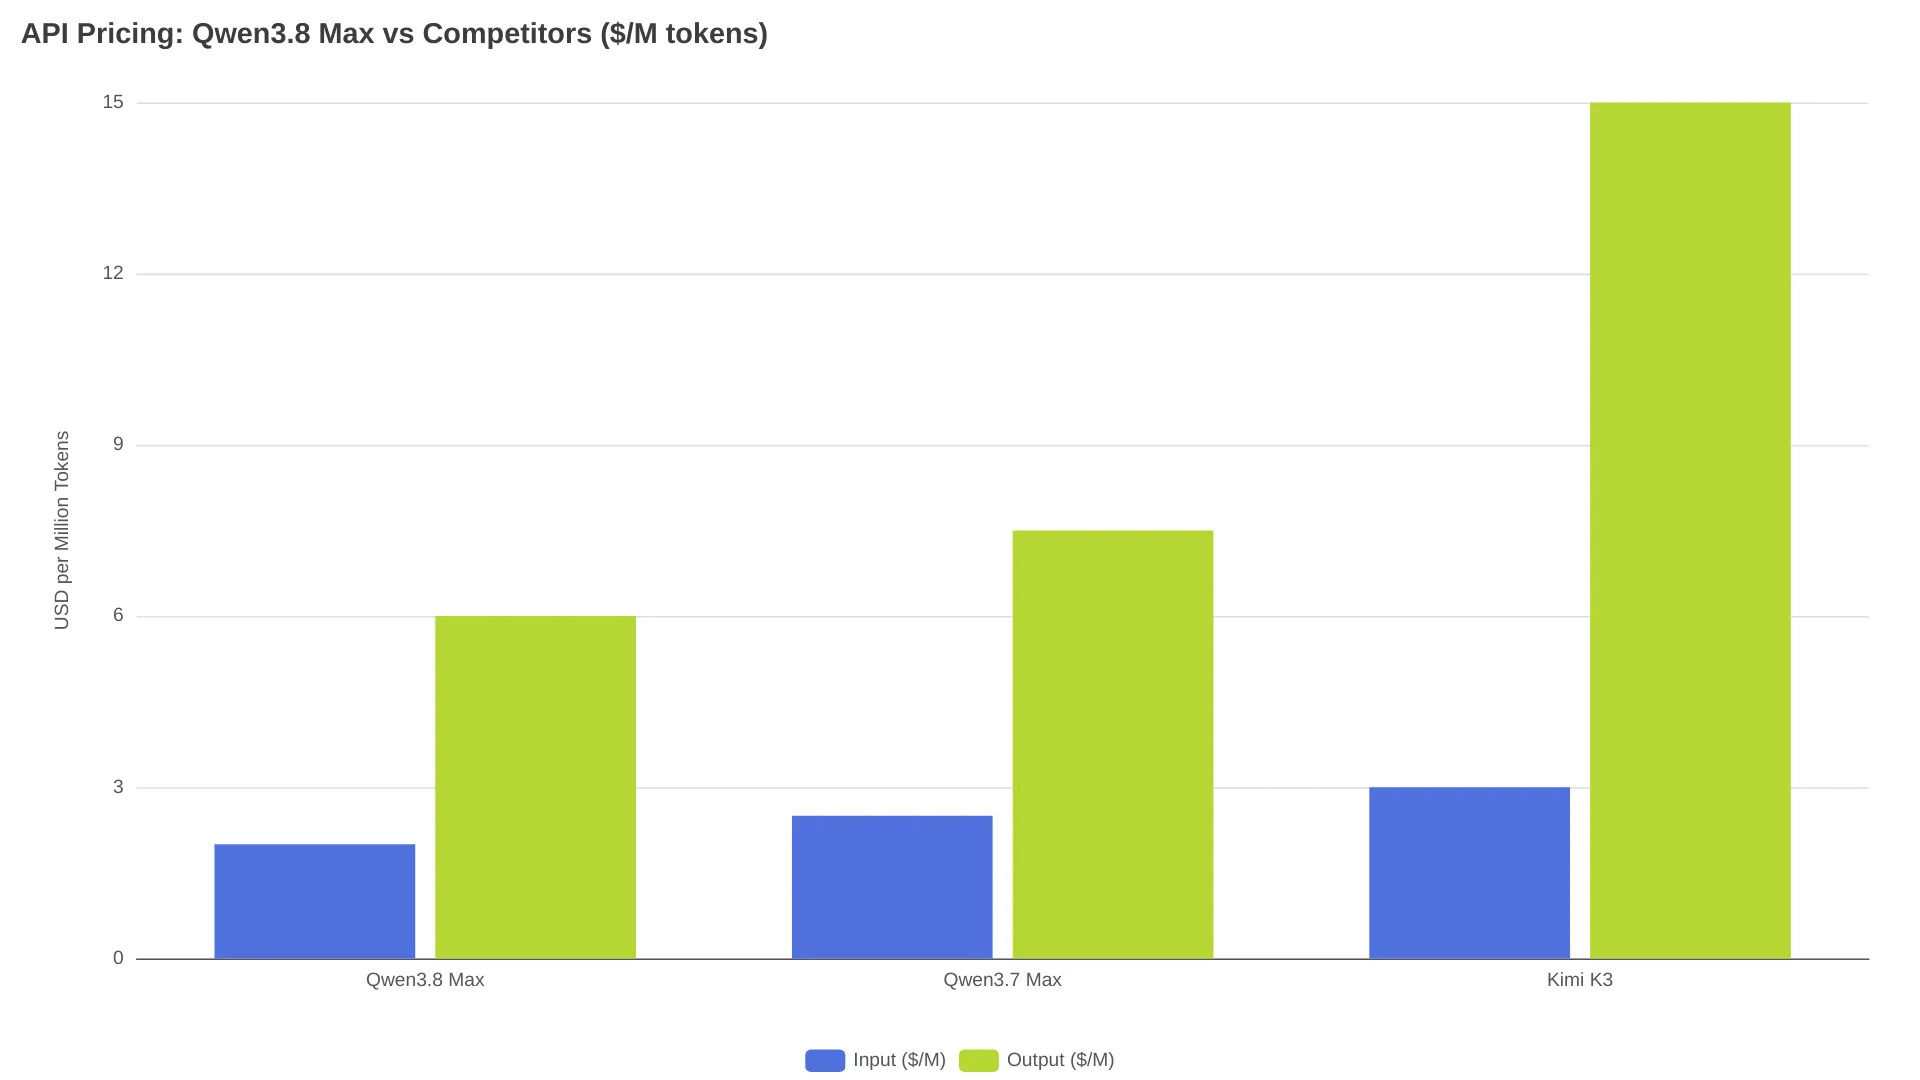
| Modelo | Entrada ($/M) | Salida ($/M) | Contexto |
|---|---|---|---|
| Qwen3.8 Max | $2.00 | $6.00 | 256K nativo (1.01M ampliable) |
| Qwen3.7 Max | $2.50 | $7.50 | 1M |
| Kimi K3 | $3.00 | $15.00 | 1M |
Además de la API por token, Alibaba ofrece tres niveles de suscripción:
- Lite: $6/mes (~10.000 créditos)
- Standard: $18/mes (~40.000 créditos)
- Pro: $68/mes (~160.000 créditos)
El endpoint Token Plan admite formatos de API compatibles tanto con OpenAI como con Anthropic, por lo que herramientas como Claude Code, Cursor y OpenCode funcionan sin cambios en el cliente. Qoder, el producto de programación de Alibaba, ofrece promociones con créditos desde 0,01 veces la tarifa estándar durante las horas valle (14:00-00:00 UTC), aunque se trata de descuentos de lanzamiento, no de precios permanentes.
El modelo de suscripción tiene una contrapartida clara. El modo de razonamiento de Qwen3.8 Max es verboso y los informes de la comunidad sobre el rápido consumo de cuota son consistentes:
«Qwen tiende a pensar DEMASIADO.» - u/darko, r/Qwen_AI
En el mismo hilo de Reddit, un suscriptor Lite afirmó haber agotado su asignación semanal en menos de dos días con unos 50 millones de tokens. Un usuario del plan Pro describió haber consumido 500 millones de tokens en un solo día con siete agentes en paralelo y una tasa de aciertos de caché del 94 %. El parámetro reasoning_effort, configurable como low, medium o xhigh, controla directamente cuánto razonamiento genera el modelo y, por tanto, la velocidad a la que desaparecen los créditos. En la prueba de un usuario, establecerlo en low redujo el tiempo de reflexión a unos 10 segundos por solicitud.
Para un desglose detallado de costes, consulta nuestra guía de precios de la API de Qwen3.8 Max.
Benchmarks: en qué destaca Qwen3.8 Max y dónde se queda atrás
Alibaba publicó resultados de benchmark que comparan Qwen3.8 Max con Fable 5 y GPT-5.6 Sol. El balance es mixto, y la distancia entre las cifras del proveedor y las mediciones independientes es suficientemente grande como para tenerla en cuenta.
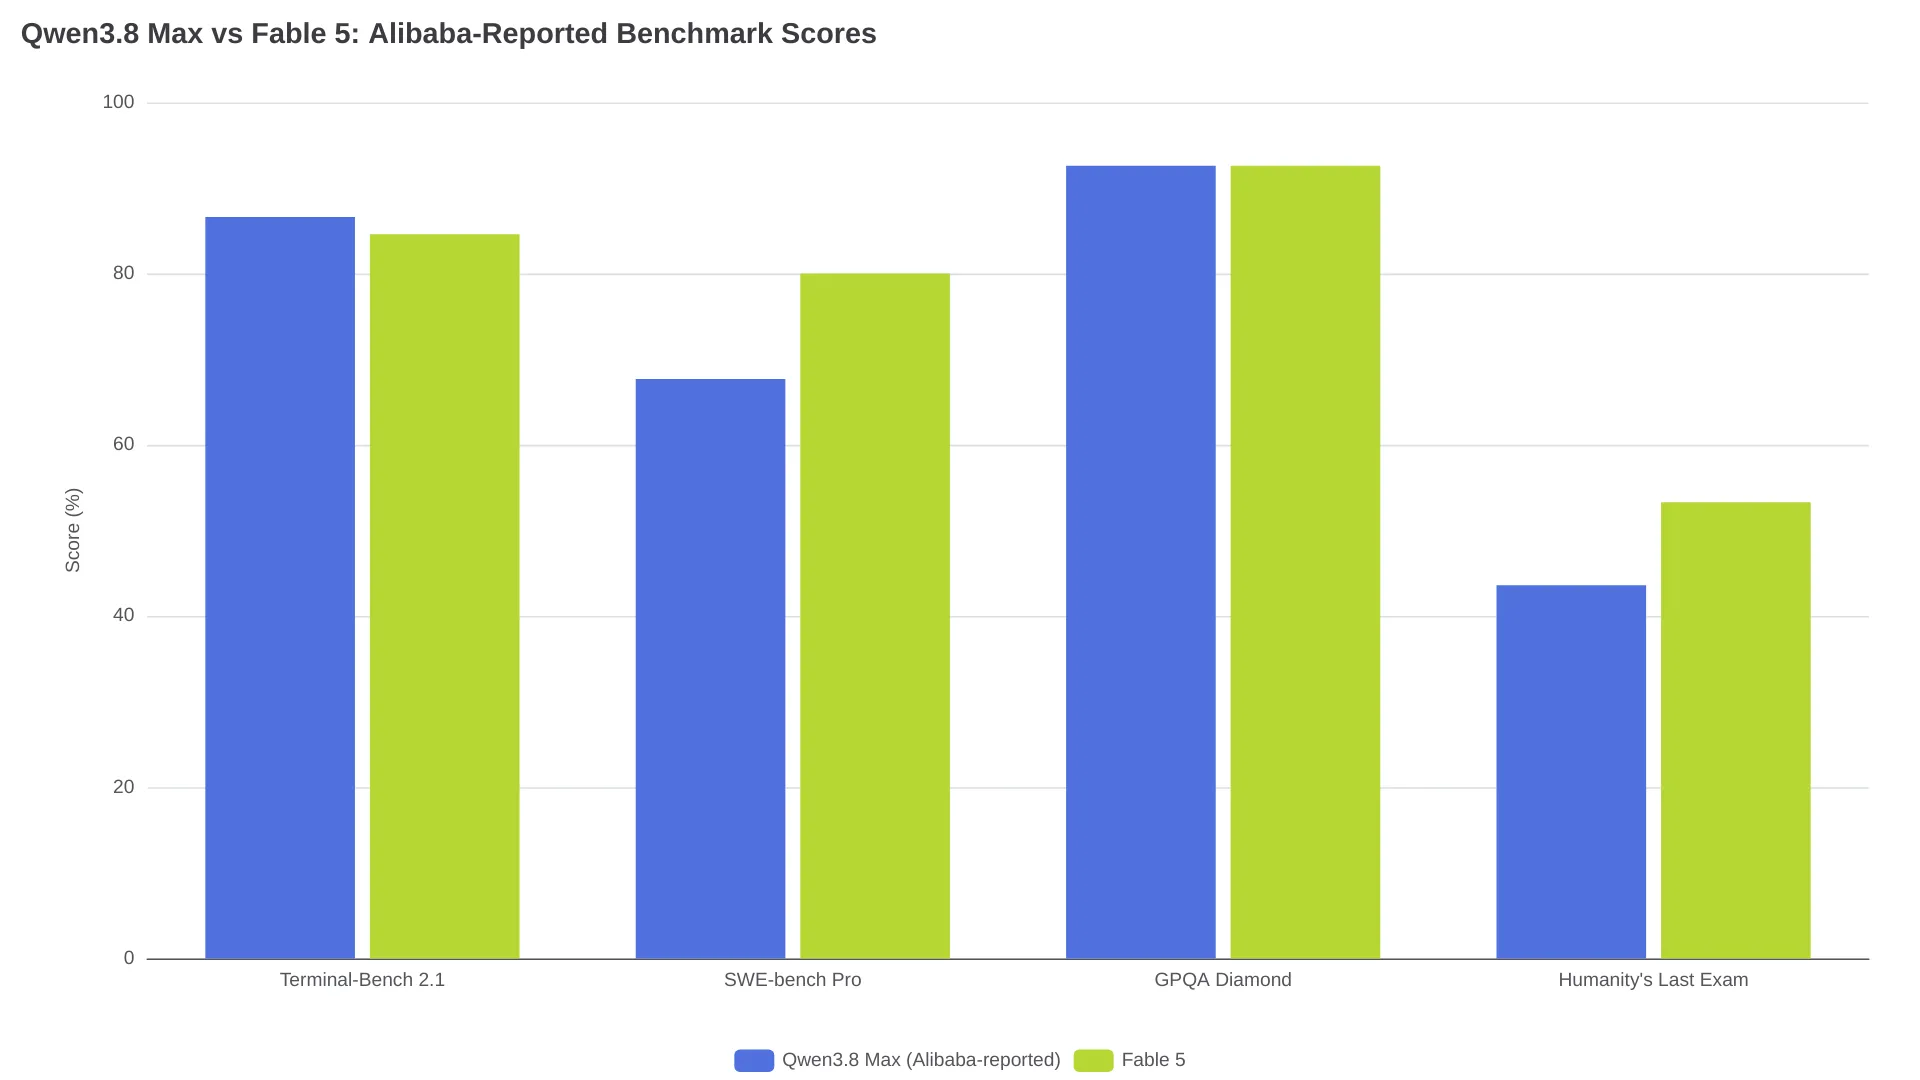
| Benchmark | Qwen3.8 Max (Alibaba) | Fable 5 | GPT-5.6 Sol |
|---|---|---|---|
| Terminal-Bench 2.1 | 86.6 | 84.6 | Por encima de Qwen (puntuación exacta no publicada) |
| SWE-bench Pro | 67.7 | 80.0 | 64.6 |
| GPQA Diamond | 92.6 | 92.6 | Por encima de Qwen |
| Humanity's Last Exam | 43.6 | 53.3 | No publicado |
Las pruebas independientes ofrecen una imagen distinta. Artificial Analysis midió un 81,3 % para Qwen3.8 Max en Terminal-Bench 2.1, 5,3 puntos menos que el 86,6 % comunicado por Alibaba. Con ese resultado independiente, Qwen se sitúa aproximadamente en el décimo puesto global, por detrás de Fable 5 (84,6 %) y Kimi K3 (85,0 %).
Qwen3.8 Max sí conserva ventaja en algunos frentes: su 67,7 % en SWE-bench Pro supera el 64,6 % de GPT-5.6 Sol, y sus resultados multimodales son sólidos: MathVision 95,2 frente al 92,7 de Fable 5, y LogicVista 91,9 frente a 85,7. El modelo también mejoró notablemente respecto a Qwen3.7 Max en DeepSWE 1.1 (21.6 -> 56.6), una señal de avances reales en tareas de agentes de ingeniería de software.
La opinión de la comunidad reproduce esta división. En el mismo hilo de Reddit que criticaba su tendencia a sobrepensar, también aparecía este comentario:
«La calidad de la respuesta era de otro nivel.» - u/TangerineLogical9779, r/Qwen_AI
La velocidad parece inestable: se informa de entre 8 tokens/s y 60 tokens/s según la carga y la hora del día. Para una comparación directa con Kimi K3, consulta nuestro análisis de Qwen3.8 Max frente a Kimi K3.
Preguntas frecuentes
¿Se pueden descargar los pesos de Qwen3.8-Max?
Sí. Alibaba publicó el checkpoint Qwen3.8-2.4T-A95B en ModelScope el 12 de agosto de 2026. Es el primer modelo de la gama Qwen-Max con pesos abiertos. El Qwen3.8-Max alojado en la nube incorpora capacidades adicionales de producción sobre este modelo base.
¿Qué licencia tienen los pesos abiertos?
La licencia exacta no se ha confirmado en el momento de escribir estas líneas. El precedente histórico apunta a Apache 2.0, ya que Qwen3.6 se distribuyó bajo esa licencia, pero Qwen3.7 Max siguió siendo cerrado. Antes de crear cualquier producto comercial, revisa el archivo de licencia real del repositorio de ModelScope.
¿En qué se diferencia Qwen3.8-2.4T-A95B de Qwen3.8-Max?
Qwen3.8-2.4T-A95B es el modelo base de pesos abiertos: 2.4T de parámetros, 95B activos, arquitectura MoE y contexto nativo de 256K. Qwen3.8-Max es la versión en la nube de Alibaba, construida sobre ese modelo y ampliada con posentrenamiento para entornos de producción, incluidos sistemas de recompensa unificados y equilibrio de datos en línea. Los pesos abiertos proporcionan la base; la API da acceso a la versión mejorada.
¿Puedo ejecutar Qwen3.8-Max en local?
No de forma práctica. Con cuantización a 4 bits, el modelo requiere aproximadamente 1,2 TB de VRAM: nueve o más GPU H200 solo para los pesos, sin margen para la caché de contexto. Incluso a 1,5 bits sigue necesitando cientos de gigabytes. La variante Qwen3.8-27B es la alternativa local realista, ya que cabe en una sola GPU de consumo.
¿Cuánto cuesta la API de Qwen3.8 Max?
La API de Model Studio cobra $2 por millón de tokens de entrada y $6 por millón de tokens de salida. Las suscripciones parten de $6/mes para Lite y llegan a $68/mes para Pro. Qoder ofrece descuentos promocionales en créditos de hasta el 98 % durante las horas valle, pero son precios de lanzamiento y pueden cambiar.