 AIREITER
Desde agosto de 2026, comparar Qwen 3.8 con Kimi K3 ya no admite una respuesta única. Los pesos de ambas familias se pueden descargar y sus modelos insignia están disponibles de forma general, pero cada uno encaja en un escenario distinto: Kimi K3 conserva el mejor historial verificado en programación agéntica; Qwen 3.8 Max gana en precio por token; y Qwen3.8-27B, bajo Apache-2.0, cabe en una sola GPU de consumo. La matización importante es que el modelo insignia «abierto» de Kimi ocupa, según los informes, 1,56 TB: publicar pesos no equivale necesariamente a poder autoalojarlos de forma práctica.
Qué han lanzado realmente Qwen 3.8 y Kimi K3
Kimi K3 (Moonshot AI) llegó el 16 de julio de 2026 como un único modelo insignia: un MoE de 2,8 billones de parámetros, con 104B activos por token, Kimi Delta Attention junto a Gated MLA, una ventana de contexto de 1.048.576 tokens y visión nativa. Los pesos y el informe técnico se publicaron el 27 de julio bajo la licencia personalizada Kimi K3 License; el resumen de condiciones de Emergent indica restricciones para revendedores comerciales a gran escala y productos que superen los 100 millones de usuarios mensuales.
Alibaba respondió con una familia completa, no con un único modelo. Qwen 3.8 Max se mostró en vista previa el 19 de julio y alcanzó disponibilidad general en QwenCloud el 3 de agosto, con 2,4T de parámetros totales y unos 95B activos. Sus pesos aparecieron en Hugging Face alrededor del 12 de agosto como Qwen/Qwen3.8-2.4T-A95B, bajo una licencia personalizada qwen3.8-max. Pocos días después llegó Qwen/Qwen3.8-27B: un modelo denso visión-lenguaje de 27B bajo Apache-2.0, con 262K de contexto nativo y ampliable a 1M mediante YaRN (fechado entre el 13 y el 14 de agosto por Yotta Labs).
| Kimi K3 | Qwen 3.8 Max | Qwen3.8-27B | |
|---|---|---|---|
| Parámetros totales / activos | 2,8T / 104B | 2,4T / ~95B | 27B denso |
| Contexto | 1.048.576 | 1M (991,8K de entrada máxima) | 262K nativo, 1M mediante YaRN |
| Licencia | Kimi K3 License (personalizada) | Licencia personalizada qwen3.8-max | Apache-2.0 |
| Pesos disponibles desde | 27 de julio de 2026 | ~12 de agosto de 2026 | ~13–14 de agosto de 2026 |
| Entrada de visión | Texto + imagen (formal) | Texto, imagen y vídeo mediante API | Texto, imagen y vídeo |
Moonshot también habría pausado nuevas suscripciones de consumo en las 48 horas posteriores al lanzamiento de K3, al superar la demanda su capacidad de GPU. Conviene tenerlo presente antes de basar un producto en un único proveedor.
Benchmarks: qué cifras son del proveedor y cuáles están medidas
Los dos proveedores publican tablas de benchmarks ambiciosas, pero ambas mezclan distintos harnesses. La propia ficha de Kimi advierte que las puntuaciones de competidores proceden de diferentes harnesses agénticos y que, en algunas filas, se usó hardware H20 en lugar de H100. Las filas compartidas que siguen deben leerse como datos reportados por los proveedores, no como resultados auditados.
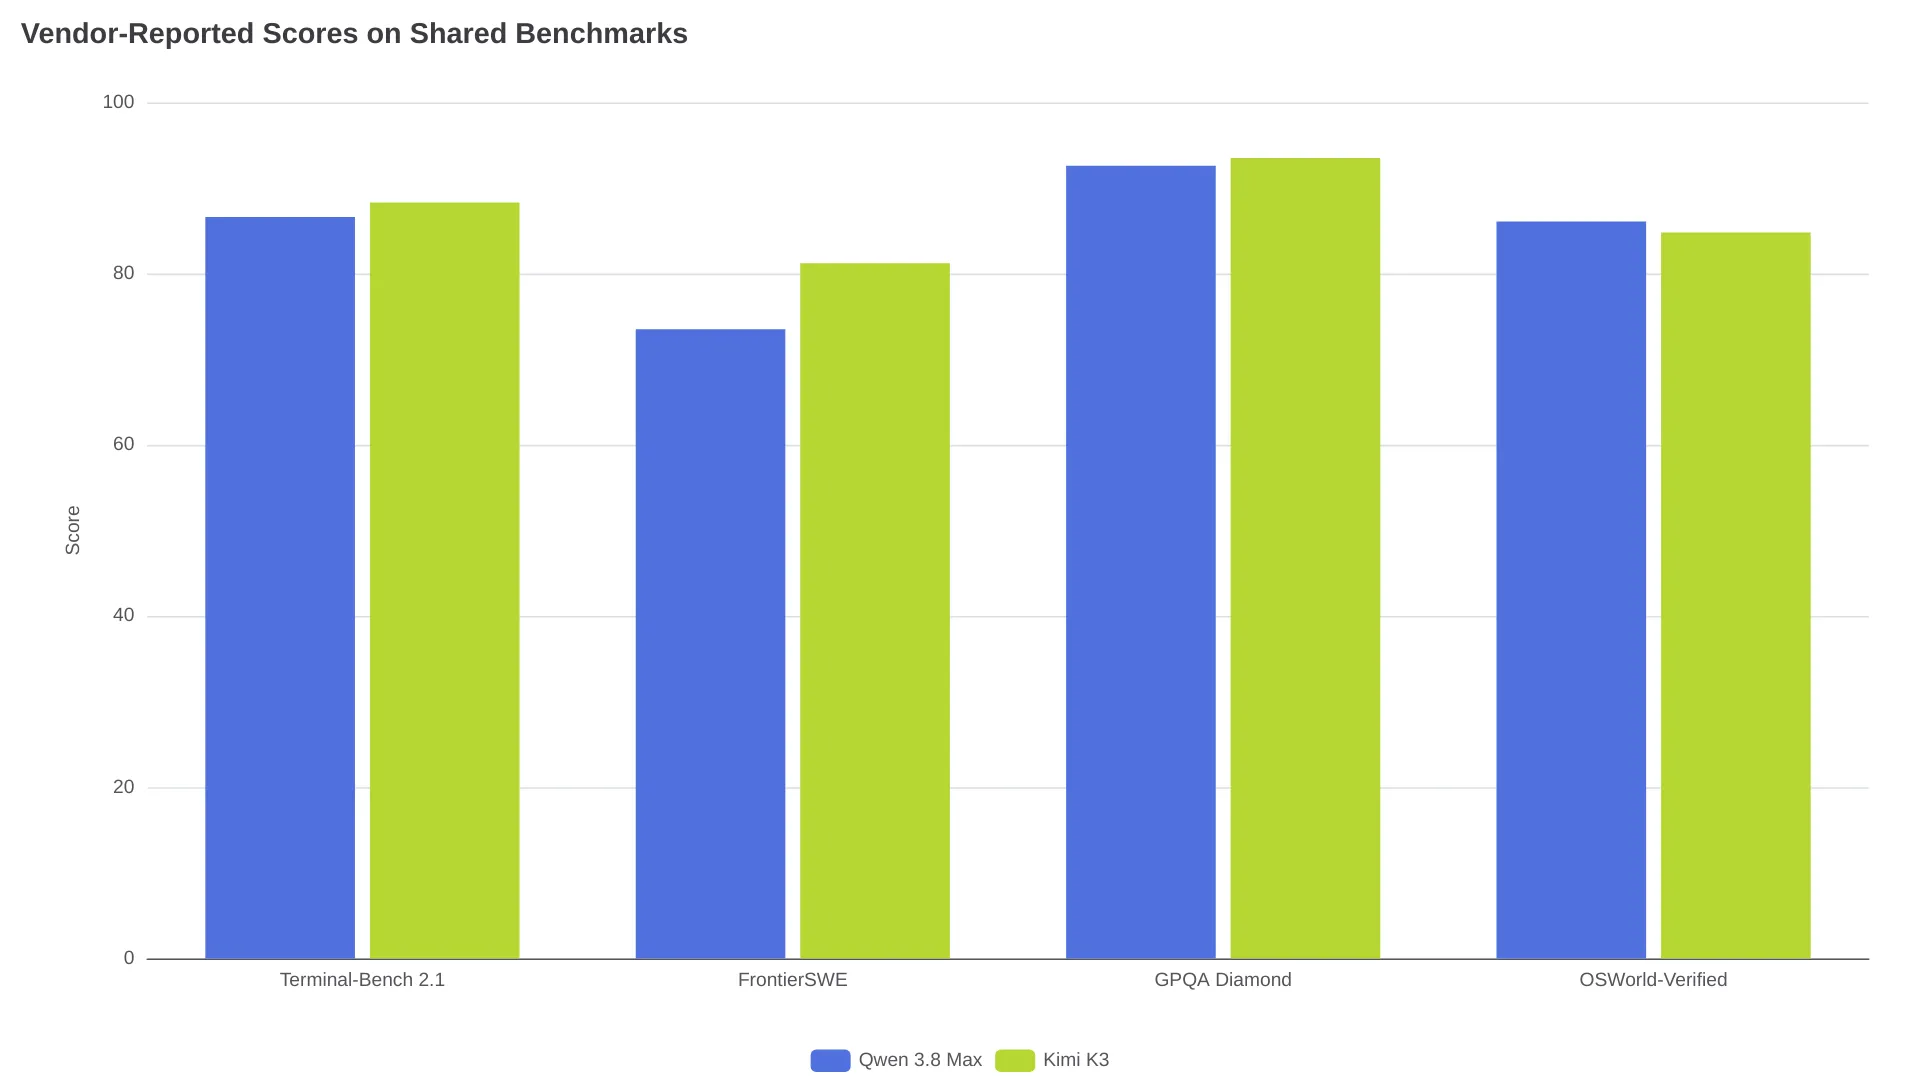
En esas filas comunes, Kimi K3 domina las pruebas más relevantes para programación agéntica: según su model card, logra 81,2 frente a 73,5 en FrontierSWE y 88,3 frente a 86,6 en Terminal-Bench 2.1 (en el lado de Qwen, la ficha del modelo 2.4T). Los materiales de lanzamiento de Qwen reclaman 86,1 en OSWorld-Verified, frente al 84,8 de la ficha de K3, y la ficha de Qwen presenta resultados destacados en filas individuales: 93,0 en PaperBench, 82,8 en IFBench y 67,7 en SWE-bench Pro. K3, por su parte, publica 42,0 en SWE-Marathon, 91,2 en BrowseComp y 94,5 en MCPMark-Verified en pruebas que Qwen no reporta.
Por ahora, el registro independiente está claramente desequilibrado. El seguimiento de Emergent atribuye a Kimi K3 un índice de inteligencia de Artificial Analysis de 57 en el lanzamiento y de 60 en la versión actual del índice, situado tras Claude Fable 5 y GPT-5.6 Sol. La comparativa de Orcarouter añade un primer puesto en Frontend Code Arena con 1.679 Elo. Qwen 3.8 Max no fue indexado de forma independiente al lanzarse; el rastreador de cheapestinference.com informó de 53 como cifra del índice de Artificial Analysis, mientras que las publicaciones de la comunidad que hablan de una actualización a 56 siguen sin verificar.
El único cara a cara sobre la misma tarea, el análisis de arquitectura StackPerf de TrilogyAI (documentado por Orcarouter), dio 83/100 a K3 frente a 80/100 para Qwen en el endpoint de vista previa. Qwen registró 354 citas de repositorios frente a 274 de Kimi, realizó 22 solicitudes de gateway frente a 53 y no tuvo llamadas a herramientas fallidas, frente a las dos de Kimi.
Hay además una comparación que las tablas compartidas omiten: en la propia ficha de Qwen, el 27B alcanza 84,3 en OSWorld-Verified frente al 84,8 de K3. Un modelo denso de 27B queda a medio punto de un insignia de 2,8T en uso de ordenador. No está al nivel de K3 en programación —73,0 frente a 88,3 en Terminal-Bench—, pero sus 90,3 en LiveCodeBench v6 y 61,7 en SWE-bench Pro lo convierten en una herramienta de trabajo seria. Un hilo comparativo práctico en r/AISEOInsider llegó a la misma conclusión que los datos: Qwen gana más construcciones de una sola pasada, mientras que Kimi toma ventaja cuando crecen el contexto y la profundidad de las revisiones.
Coste de API: la brecha de $15 en salida y el coste del razonamiento
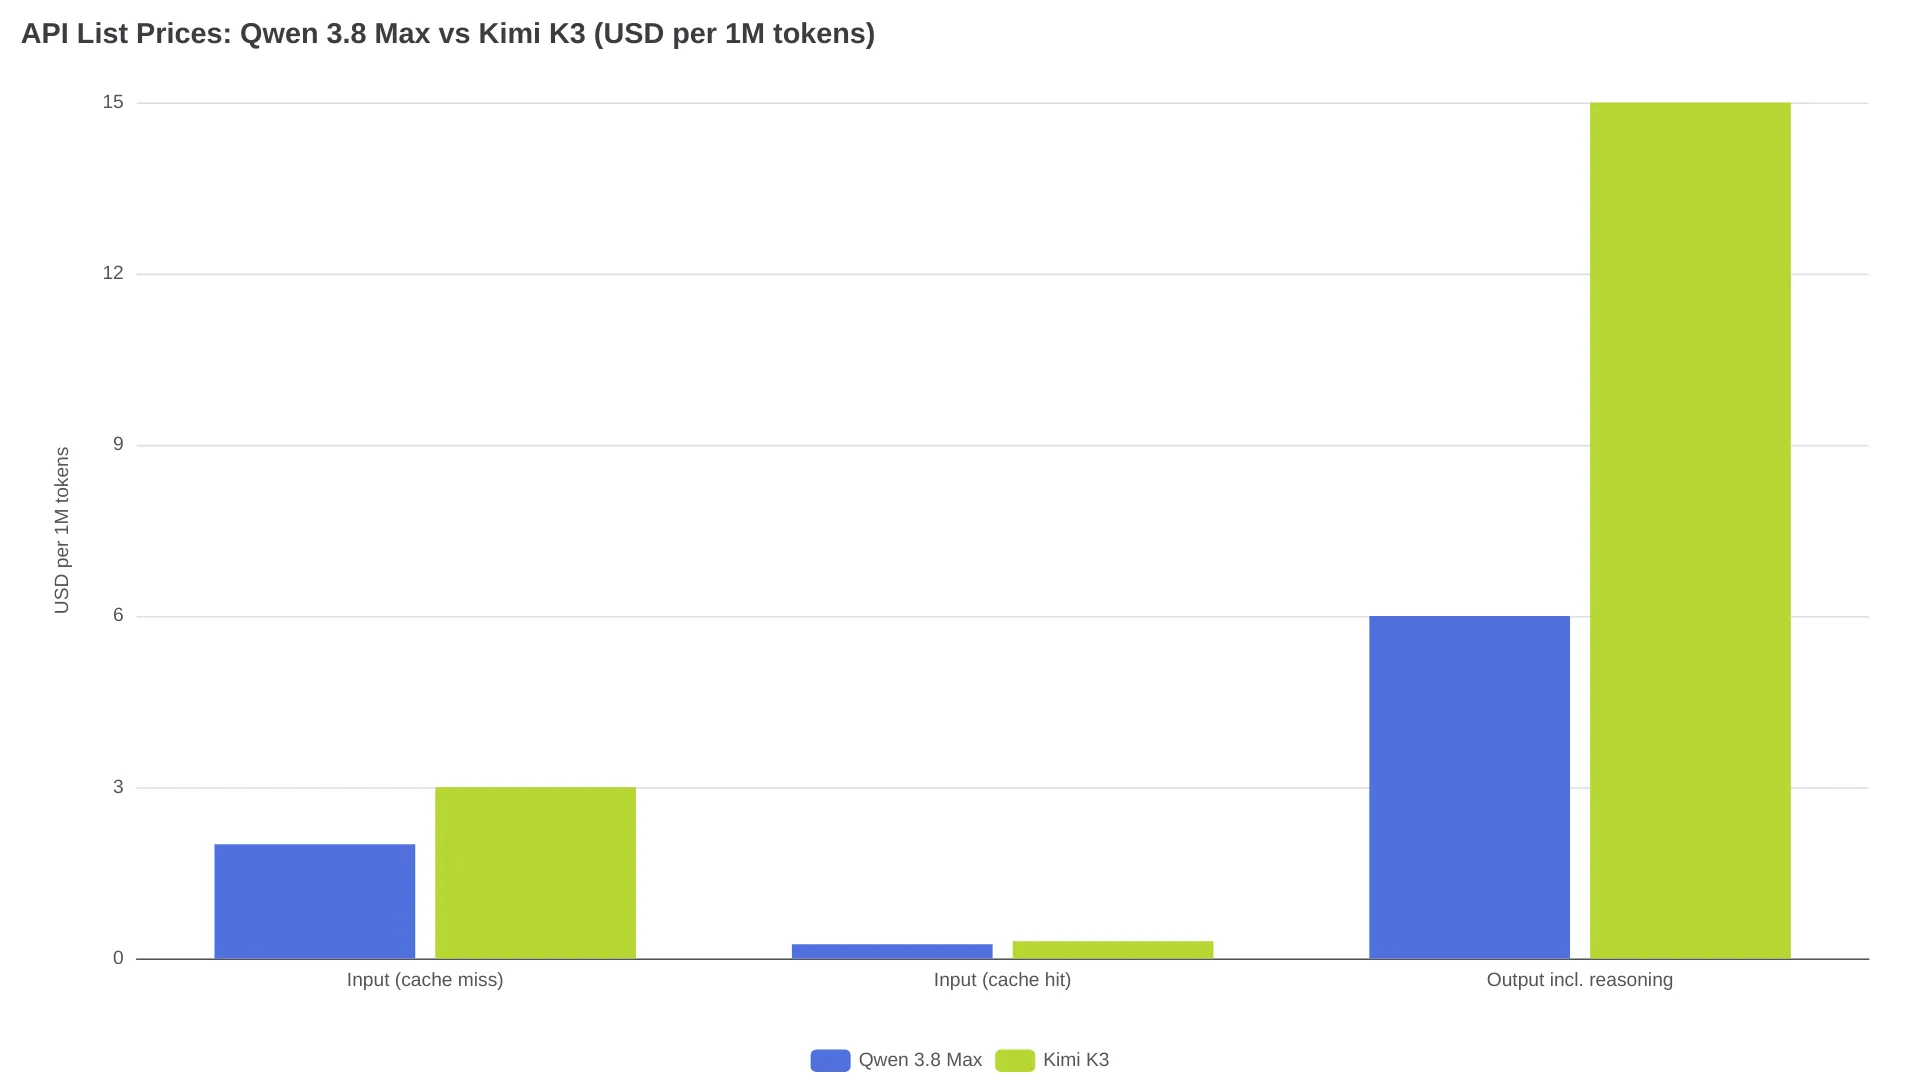
Los precios de lista apuntan en una dirección, y el gasto real lo hace aún con más fuerza. Ambos modelos razonan por defecto —K3 con reasoning_effort: max y Qwen con xhigh—, y los tokens de razonamiento se facturan como salida.
| Por 1M de tokens | Qwen 3.8 Max (QwenCloud) | Kimi K3 (Moonshot) |
|---|---|---|
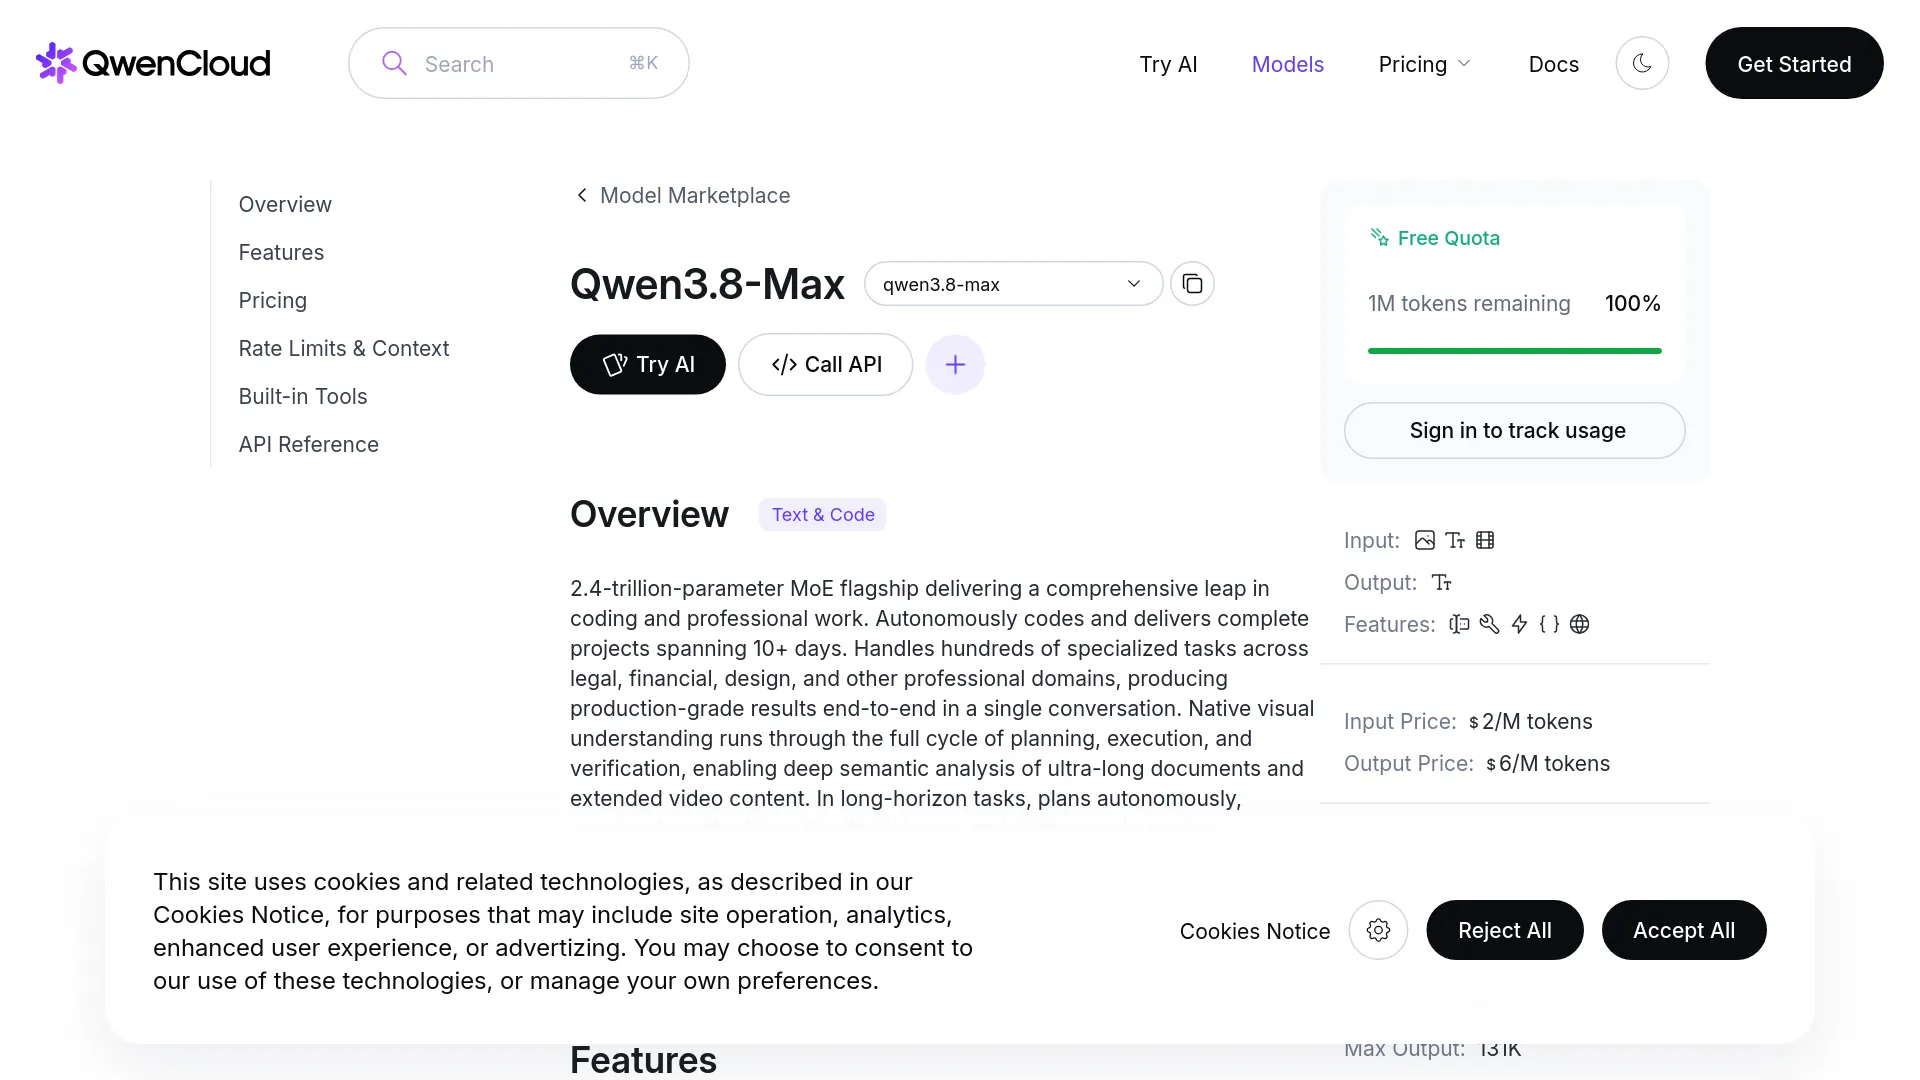
| Entrada (fallo de caché) | $2.00 | $3.00 |
| Entrada (acierto de caché) | $0.25 | $0.30 |
| Salida, razonamiento incluido | $6.00 | $15.00 |
| Creación / lectura explícita de caché | $2.50 / $0.17 | — |
Dos sesiones calculadas con los precios de lista de agosto de 2026:
| Sesión | Qwen 3.8 Max | Kimi K3 | Diferencia |
|---|---|---|---|
| Programación agéntica: 500K de entrada (60% en caché), 40K de salida | $0.72 | $1.29 | 1.8× |
| Pipeline documental con contexto nuevo: 2M de entrada, 100K de salida | $4.60 | $7.50 | 1.6× |
De esos cálculos sale una regla de enrutamiento clara: envía una tarea a K3 solo si su tasa de aceptación en tu carga de trabajo supera la de Qwen en más de la brecha de coste por token de unas 1,8×. La propia Moonshot comercializa una alternativa más económica: Kimi K2.7 Code cuesta $0.95 de entrada y $4.00 de salida con 256K de contexto, así que K3 no es la opción más barata para programación dentro de la familia Kimi. Si hoy enrutas tráfico a K3, su endpoint de API aparece aquí con las tarifas publicadas por Moonshot. El detalle de la estructura de precios de ambos modelos está desglosado en el análisis de precios de Qwen3.8-Max y la guía de precios de Kimi K3.
Autoalojamiento: 1,56 TB frente a una RTX 4090
Aquí es donde las dos propuestas de pesos abiertos se separan por aproximadamente dos órdenes de magnitud.
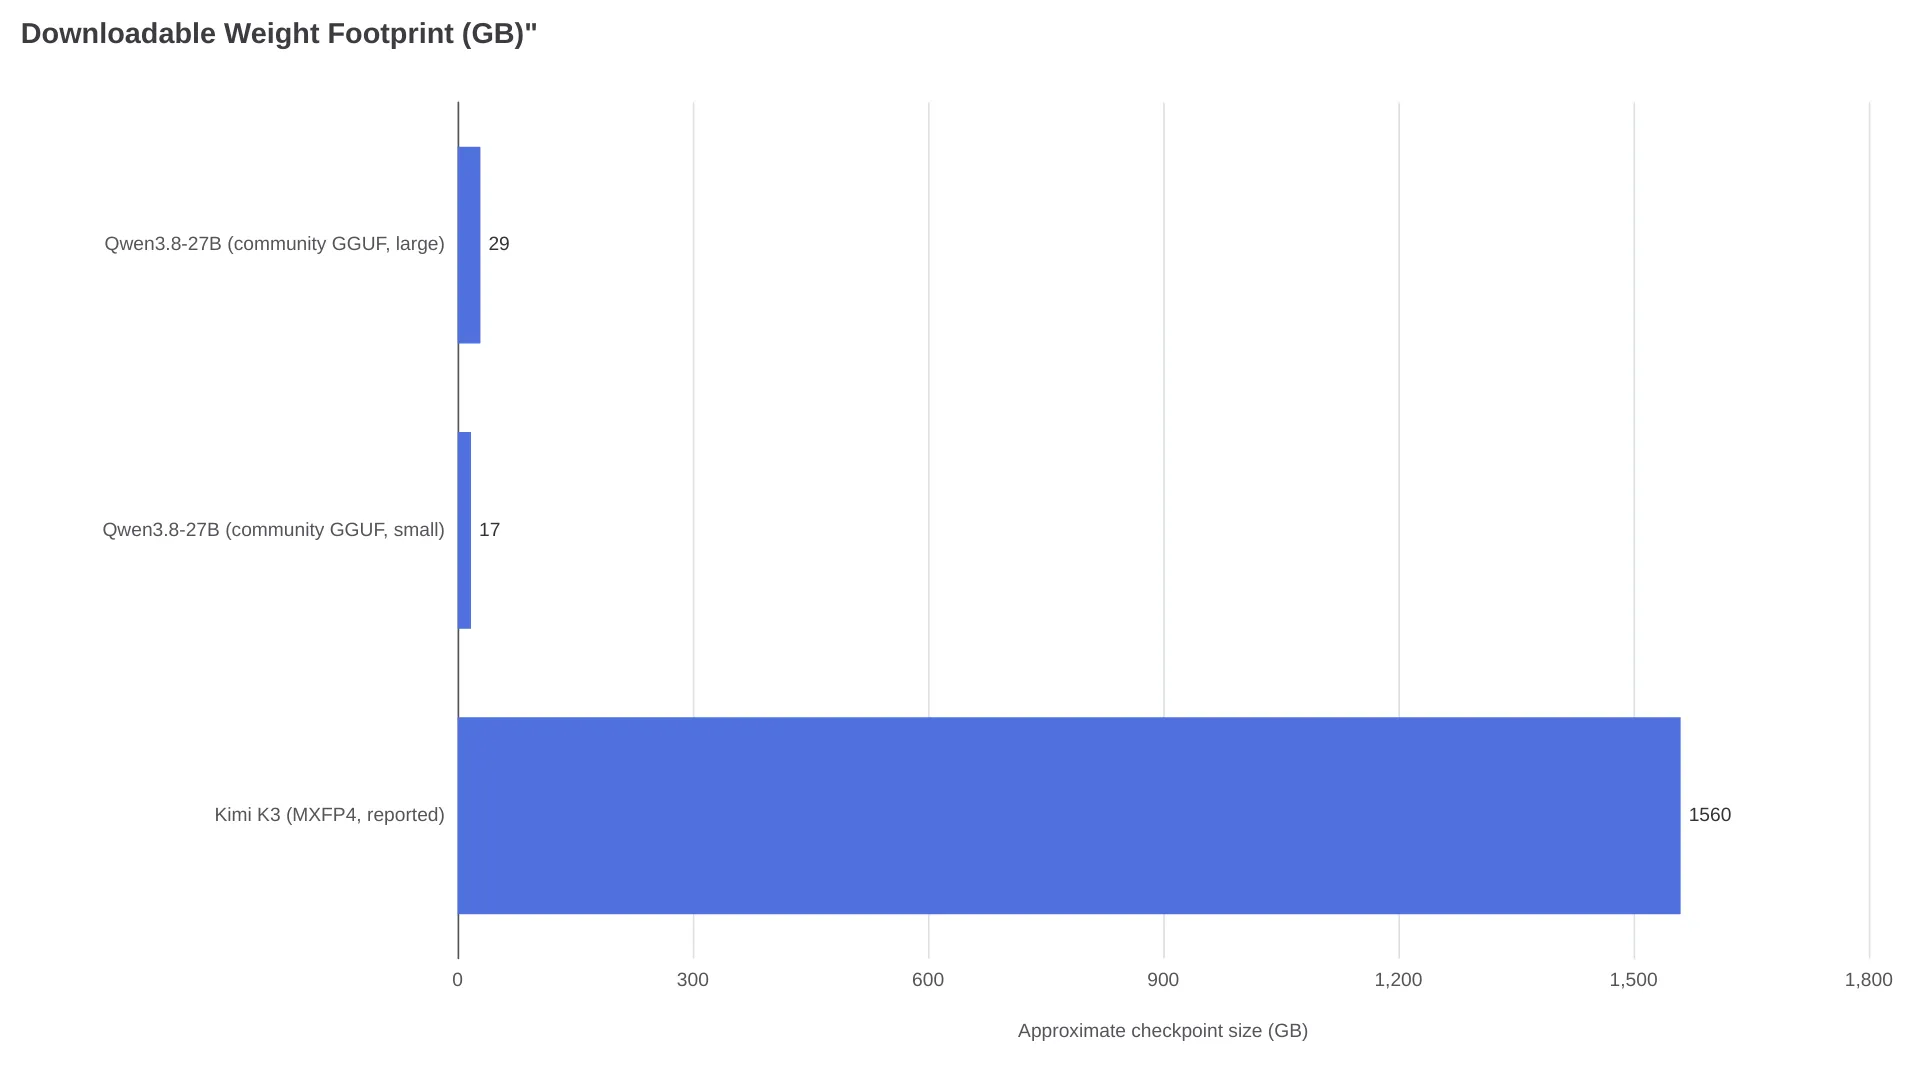
K3 incluye pesos MXFP4 compatibles con cuantización (model card), pero un checkpoint de 1,56 TB según los informes es un proyecto de clúster. La misma fuente recomienda vLLM distribuido en 64 aceleradores o más. Es un coste real, aunque alquilable, antes de servir un solo token; y además se aplican las condiciones de la licencia para uso a gran escala.
El 27B cuenta la historia opuesta. Las compilaciones GGUF de la comunidad van aproximadamente de 8,5 GB a 28,9 GB; las compilaciones dynamic GGUF y NVFP4 de Unsloth se sitúan en unos 17 GB como mínimo, y existe una variante oficial FP8 para despliegues de servidor. Funciona en hardware que mucha gente ya tiene:
"Qwen3.8-27B con 160K de contexto en una SOLA RTX 4090 — 47–57 tok/s, descarga completa en GPU" — publicación de despliegue en r/Qwen_AI
Los pesos de Max quedan a medio camino. Qwen3.8-2.4T-A95B y su versión FP8 se pueden descargar bajo la licencia personalizada qwen3.8-max, pero el artefacto abierto solo admite texto y su razonamiento no puede desactivarse. La entrada de visión, un modo sin razonamiento y el contexto predeterminado de 1M pertenecen a la capa de API de QwenCloud, no al checkpoint. Para saber qué puede y qué no puede hacer el 27B en cada cuantización, la guía de campo de Qwen3.8-27B reúne runtimes y tablas de VRAM; la publicación de los pesos de K3 se analiza en el artículo sobre los pesos abiertos de Kimi K3.
Detalles de integración que pueden decidir un proyecto agéntico
Hay tres comportamientos a nivel de model card que pueden costarte un día de depuración si los descubres ya en producción.
| Modelo | Comportamiento / límite | Consecuencia en la implementación |
|---|---|---|
| Kimi K3 | El razonamiento está siempre activo; los clientes multi-turn y de uso de herramientas deben reenviar el mensaje completo anterior del asistente, incluidos reasoning_content y tool_calls (ficha) | Si eliminas el rastro de razonamiento, los bucles agénticos se degradan; si lo conservas, el gasto crece con la longitud del bucle |
| Qwen3.8-27B | preserve_thinking viene activado por defecto; reasoning_effort puede bajar a medium/low; YaRN más allá de 262K usa escalado estático (ficha) | Se puede desactivar en cada petición; la ficha advierte que reducir el esfuerzo no siempre acorta el tiempo total, porque los reintentos se comen el ahorro; activa YaRN solo para trabajos largos |
| Límites de Qwen 3.8 Max y K3 | Max: 991,8K de entrada / 131,07K de salida (QwenCloud); K3: 1.048.576 de entrada / 131K de salida predeterminada, ampliable hacia 1M | Ninguno de los dos «1M de contexto» garantiza 1M de salida útil; una prueba de aguja de terceros encontró 18/18 hechos con 248K y no evaluó más allá |
Preguntas frecuentes
¿Qwen 3.8 es mejor que Kimi K3 para programar?
Con la evidencia disponible, no. Kimi K3 lidera las filas de programación agéntica que importan —FrontierSWE 81,2 frente a 73,5 y Terminal-Bench 2.1 88,3 frente a 86,6— y cuenta con las únicas puntuaciones de índices independientes. Qwen 3.8 Max se acerca en trabajo de terminal y es más barato por token y en las sesiones modeladas; el 27B pertenece a una categoría de pesos completamente distinta.
¿Cuál es más barato, Qwen 3.8 o Kimi K3?
Qwen 3.8 Max gana en todas las líneas de precio: $2 frente a $3 en entrada y $6 frente a $15 en salida. Como ambos modelos facturan el razonamiento activado por defecto como salida, la desventaja de Kimi aumenta con la dificultad de la tarea: aproximadamente 1,8× en una sesión agéntica con caché según los cálculos anteriores.
¿Se pueden autoalojar y bajo qué licencias?
Sí, los tres checkpoints se pueden descargar. Qwen3.8-27B está bajo Apache-2.0 y, cuantizado, cabe en una sola GPU de 24 GB; Kimi K3 requiere hardware de escala clúster para su checkpoint MXFP4 de ~1,56 TB y usa la licencia personalizada Kimi K3 License; los pesos de Qwen3.8-Max son públicos como Qwen3.8-2.4T-A95B bajo la licencia personalizada qwen3.8-max.
¿La ventana de contexto de 1M es real en ambos?
A grandes rasgos, sí. Kimi K3 especifica 1.048.576 tokens; Qwen 3.8 Max anuncia 1M con 991,8K de entrada máxima; el 27B tiene 262.144 de forma nativa y solo alcanza 1M con el escalado YaRN, que sacrifica calidad en contexto corto. La verificación independiente solo existe hasta el nivel de 248K.
La elección y qué podría cambiarla
| Tu escenario | Elección | Motivo |
|---|---|---|
| Agentes de programación por API, priorizando calidad | Kimi K3 | FrontierSWE 81,2, Terminal-Bench 88,3, 60 verificado por AA |
| Trabajo por API donde importa el gasto, mucha documentación o visión | Qwen 3.8 Max | $6 frente a $15 en salida, OSWorld 86,1, caché explícita a $0.17/lectura |
| Autoalojamiento en hardware propio | Qwen3.8-27B | Apache-2.0, cuantizaciones de ~17–29 GB, 160K de contexto en una RTX 4090 |
| Autoalojar un modelo insignia de frontera | Kimi K3 | El único checkpoint abierto aquí con puntuaciones independientes de nivel frontera; reserva presupuesto para un clúster |
Dos factores podrían cambiar parte de esta tabla: una evaluación independiente de Qwen 3.8 Max —53 reportado por rastreadores frente al 60 verificado de K3, sobre evidencia limitada— y la publicación de los términos de la licencia personalizada qwen3.8-max. Hasta que ocurra una de esas dos cosas, el cara a cara de API entre Qwen 3.8 Max y Kimi K3 profundiza más en el escenario exclusivo de API.
Lecturas relacionadas: Qwen3.8-27B: qué está confirmado y qué funciona realmente con 17GB · Pesos abiertos de Kimi K3 · Qwen 3.8 Max vs Kimi K3: edición API