 AIREITER
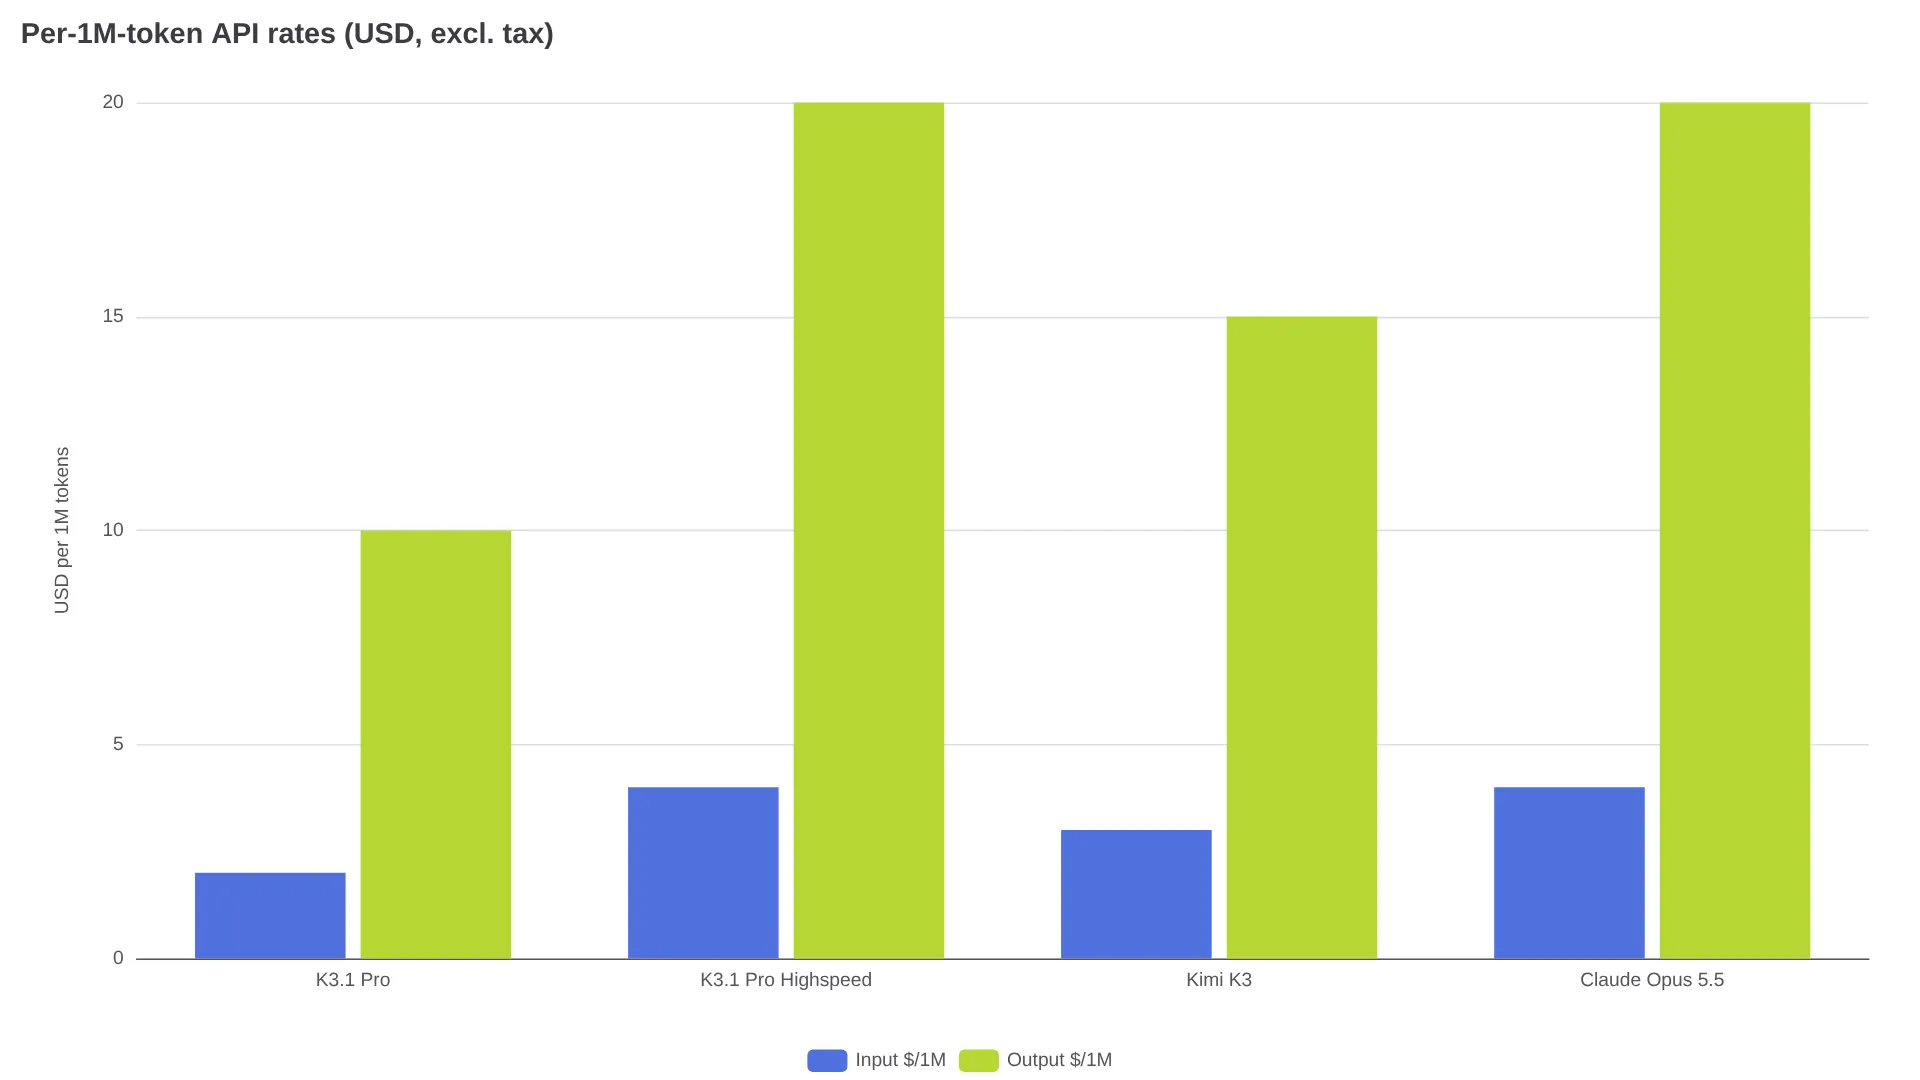
La tarifa de la API de Kimi K3.1 Pro parece sencilla hasta que entran en juego el razonamiento y la caché. La modalidad estándar cobra 2 $ por cada 1M de tokens de entrada y 10 $ por cada 1M de salida; Highspeed duplica ambas cifras para ofrecer más velocidad. Las lecturas desde caché, en cambio, se mantienen en 0,20 $ en los dos niveles (platform.kimi.ai).
| Modelo | Entrada / 1M | Salida / 1M | Lectura desde caché / 1M | Escritura en caché 5 min / 1M | Escritura en caché 1 h / 1M |
|---|---|---|---|---|---|
Kimi K3.1 Pro (kimi-k3.1-pro) | 2,00 $ | 10,00 $ | 0,20 $ | 2,00 $ | 4,00 $ |
Kimi K3.1 Pro Highspeed (kimi-k3.1-pro-highspeed) | 4,00 $ | 20,00 $ | 0,20 $ | 4,00 $ | 8,00 $ |
| Kimi K3 (generación anterior) | 3,00 $ | 15,00 $ | 0,30 $ | 3,00 $ | 6,00 $ |
Son tarifas en USD por cada 1M de tokens, antes de impuestos, y se aplican igual a todo el contexto de 1M de tokens, sin recargo por contextos largos, según la información oficial de precios de Kimi (kimi.ai).
Una petición con 100K de contexto parte de 0,30 $, pero la factura incluye más conceptos
Un ejemplo directo: 100.000 tokens de entrada sin caché y 10.000 tokens de salida cuestan 0,20 $ más 0,10 $, es decir, 0,30 $. Es el cálculo básico con las tarifas oficiales de 2/10 $. Para peticiones reales, usa esta fórmula (en la modalidad estándar; en Highspeed se duplican las tarifas de entrada, salida y escritura):
Total = (uncached_in x 2 + cached_read x 0.20 + write_5m x 2
  + write_1h x 4 + (visible_out + reasoning_out) x 10) / 1M
  + searches x 0.004
La fórmula recoge el desglose oficial de Kimi: entrada sin caché, lecturas desde caché, escrituras según el tiempo de vida y salida (kimi.ai), además de los 0,004 $ por cada consulta de Web Search. Como la facturación es de pago por uso y se calcula petición a petición (kimi.ai), un reintento vuelve a poner el contador a cero. El razonamiento está siempre activado en K3.1 Pro y se cobra como salida: las trazas internas consumen el mismo presupuesto de 10 $ por cada 1M que la respuesta visible. Una respuesta visible de 10.000 tokens con 40.000 tokens de razonamiento ocultos factura 50.000 tokens de salida, o 0,50 $. Un caso real compartido por un usuario —935 tokens de entrada y 56.097 de salida por 0,5628 $— encaja prácticamente al céntimo con la tarifa de 10 $ por cada 1M de salida (x.com).
La caché es el otro concepto que suele pasar desapercibido. Los prefijos que se almacenan por primera vez generan un cargo de escritura; si se reutiliza un prefijo sin cambios dentro del periodo de validez, la lectura baja a 0,20 $ por cada 1M. El tiempo de vida predeterminado es de cinco minutos, aunque cada llamada puede solicitar una hora (kimi.ai). Si cambia un prefijo cerca del inicio del contexto, puede invalidarse la reutilización de todo lo que viene después (kimi.ai). Para confirmar que la caché se ha aplicado hay que revisar el desglose de uso de cada petición y distinguir los tokens leídos desde caché de los que no lo fueron; que el texto sea parecido no garantiza un acierto.
Precios de la API de Kimi K3.1 Pro, al detalle: Standard frente a Highspeed
Highspeed ofrece la misma inteligencia declarada y el mismo contexto de 1M, pero responde aproximadamente 2-3 veces más rápido a cambio de duplicar exactamente las tarifas de entrada, salida y escritura en caché (platform.kimi.ai), tal como explica Moonshot en su anuncio (kimi.ai).
La única tarifa que no se duplica es la lectura desde caché: ambas variantes cobran 0,20 $ por cada 1M de tokens de entrada almacenados. La diferencia es importante en los agentes que repiten prompts de sistema largos y definiciones de herramientas: el descuento por reutilización es idéntico, mientras que los tokens nuevos y el razonamiento cuestan el doble en Highspeed.
Hay tres datos de facturación que conviene tener presentes:
- La API se factura por uso, con medición separada de entrada y salida, y funciona al margen de las membresías de Kimi y de las suscripciones de Kimi Code. El saldo de una membresía no sirve para pagar llamadas a la API (kimi.ai).
- La API es compatible con OpenAI y utiliza los identificadores
kimi-k3.1-proykimi-k3.1-pro-highspeed. Está disponible enhttps://api.moonshot.ai/v1y también a través de gateways con el identificadormoonshotai/kimi-k3.1-proen OpenRouter y Vercel AI Gateway. - Las llamadas opcionales a Web Search cuestan 0,004 $ cada una, además del consumo de tokens. Los archivos subidos no generan un cargo propio, pero su contenido procesado se factura como entrada. El acceso a la API se desbloquea tras una recarga mínima de 1 $ y cuenta con límites de velocidad por niveles (kimi.ai).
Cuándo compensa pagar el doble por Highspeed y cuándo es tirar el dinero
Highspeed solo compensa cuando el tiempo de espera cuesta más que los tokens. Las sesiones de programación interactivas, los asistentes en directo y las demostraciones de cara al usuario pueden justificar los 4/20 $, porque ahí la latencia forma parte del producto. En trabajos por lotes, ejecuciones nocturnas de agentes y baterías de evaluación en las que nadie está esperando, lo lógico es quedarse con la tarifa estándar de 2/10 $, aproximadamente la mitad por token. En términos prácticos, Highspeed solo está justificado si el valor del tiempo ahorrado supera el cargo adicional, que en ejecuciones intensivas en entrada equivale aproximadamente a volver a pagar toda la factura estándar.
Antes de cambiar de tarifa, es más barato ajustar el esfuerzo de razonamiento. La API admite reasoning_effort con los valores low, high y max; max es el valor predeterminado y el utilizado en las puntuaciones de referencia publicadas por Moonshot (datacamp.com). Bajar una prueba de max a high, o de high a low, reduce el volumen de tokens de razonamiento en tareas sencillas sin asumir la prima de Highspeed. Conviene mantener un único nivel por sesión, ya que cambiarlo a mitad de la conversación invalida la caché de contexto (datacamp.com).
Algunos informes de la comunidad ayudan a poner cifras al intercambio. Un usuario japonés comparó trabajos equivalentes y registró 14:32 para Opus 5.5 frente a 27:53 para Kimi K3.1 Pro, con una calidad de salida parecida. Su conclusión fue reservar Kimi para los trabajos en los que el tiempo de espera no importe:
Aunque se supone que cuesta la mitad, la espera fue casi el doble. ... Opus 5.5 tardó 14 minutos y 32 segundos; Kimi K3.1 Pro, 27 minutos y 53 segundos. Sinceramente, el resultado fue bastante parecido. Yo dejaría para Kimi solo los trabajos en los que pueda esperar. — @rutinelabo (x.com)
Usuarios de Reddit describen una diferencia similar: aproximadamente 80 tok/s en Highspeed frente a unos 30 tok/s en la modalidad estándar, aunque consideran que la versión rápida es muy cara:
Una vez más, el modelo tiene una versión de alta velocidad que cuesta un ojo de la cara y funciona mucho más rápido de lo que alcanza a leer el ojo (80 t/s), mientras que la versión normal va a 30 t/s cuando le apetece. — u/Kiverty (reddit.com)
Regla rápida: usa K3.1 Pro estándar por defecto, reduce primero reasoning_effort y paga Highspeed solo cuando haya una persona esperando la respuesta.
Alojamiento propio después del 4 de noviembre: la realidad de una clase de 3T
Moonshot afirma que publicará los pesos completos de Kimi K3.1 Pro el 4 de noviembre de 2026 como fecha límite, y describe el modelo como perteneciente a la clase de 3T, con una ventana de contexto de 1M de tokens (kimi.com). A 2 de noviembre, no aparece ningún repositorio oficial de K3.1 Pro en la organización de Moonshot en Hugging Face, disponible en huggingface.co/moonshotai; allí siguen figurando Kimi K3 y modelos anteriores, mientras que los resultados de búsqueda solo muestran forks no oficiales. La licencia definitiva, los formatos de archivo y las opciones de cuantización también siguen sin confirmarse. Los rastreadores externos marcan estos datos como desconocidos a la espera del lanzamiento oficial (ctrlaltorion.com).
La escala es la razón por la que el alojamiento propio rara vez sale más barato en este caso. K3.1 Pro es el sucesor con postentrenamiento de Kimi K3, un modelo de mezcla de expertos con 2,8T de parámetros, y la etiqueta de clase 3T apunta en la misma dirección (datacamp.com). En un modelo MoE, el total de parámetros no equivale a los parámetros activos por token, así que todavía no se puede calcular una cifra fiable de VRAM para una sola estación de trabajo.
En lugar de inventar un precio de GPU, conviene plantear el punto de equilibrio de forma simbólica:
API_month = monthly_tokens_1M x blended_$/1M (from formula above)
Self-host wins when cluster_monthly_cost < API_month at sustained utilization
Con 2 $ por cada 1M de tokens de entrada y 10 $ por cada 1M de salida, 1.000 millones de tokens de entrada más 100 millones de salida cuestan 2.000 $ más 1.000 $, es decir, unos 3.000 $ en consumo de API. El alojamiento propio puede compensar a equipos que ya dispongan de un clúster adecuado, ejecuten inferencia a gran volumen de forma sostenida o necesiten mantener los datos en sus instalaciones. Para quienes no tengan ese clúster ni una utilización constante, la fórmula anterior normalmente favorecerá a la API de pago por uso. Lo prudente es esperar al checkpoint oficial y a la licencia antes de hacer planes.
Dos trampas de facturación que siguen apareciendo
La primera es olvidar que el razonamiento se factura como salida. La fórmula ya lo refleja: limita las ejecuciones con max_completion_tokens, empieza las pruebas en low, sube a high solo si falla y reserva max para la ejecución final más difícil.
La segunda es confundir el consumo de cuota de una suscripción con la previsibilidad de la API. Varios usuarios de pago aseguran haber agotado en minutos una asignación de cinco horas al afrontar tareas exigentes de programación; un usuario del nivel superior afirmó que su cuota mensual desapareció en seis horas (reddit.com). Moonshot reconoció el problema el 25 de octubre, pidió disculpas por los límites de velocidad y el consumo innecesario de cuota, y concedió un reinicio único del 25 % de la cuota mientras reducía las llamadas redundantes de subagentes y la longitud de las respuestas (x.com). Para tareas intensivas de razonamiento y programación, el uso medido de la API —0,30 $ por cada unidad de 100K tokens de entrada y 10K de salida— resulta más predecible que unas cuotas de suscripción que pueden desaparecer en una sola tarea.
Preguntas frecuentes sobre los precios de la API de Kimi K3.1 Pro
¿Cuánto cuesta la API de Kimi K3.1 Pro por cada 1M de tokens?
La modalidad estándar cobra 2,00 $ por la entrada, 10,00 $ por la salida, 0,20 $ por la lectura de entrada desde caché, 2,00 $ por la escritura en caché durante cinco minutos y 4,00 $ por la escritura durante una hora, todo por cada 1M de tokens y antes de impuestos (kimi.ai).
¿Qué diferencia hay entre K3.1 Pro y Highspeed?
Highspeed utiliza la misma inteligencia declarada y el mismo contexto de 1M, pero responde aproximadamente 2-3 veces más rápido. Cobra 4,00 $ por la entrada y 20,00 $ por la salida por cada 1M de tokens; las escrituras en caché también duplican su precio, mientras que las lecturas desde caché se mantienen en 0,20 $ (platform.kimi.ai).
¿Cuáles son los identificadores de los modelos de la API?
Usa kimi-k3.1-pro para la modalidad estándar y kimi-k3.1-pro-highspeed para la rápida en el endpoint compatible con OpenAI de Moonshot. Los gateways lo muestran como moonshotai/kimi-k3.1-pro (openrouter.ai).
¿El uso de la API está incluido con una membresía de Kimi?
No. La facturación de la API es independiente de las membresías de Kimi y de los planes de Kimi Code, con claves y saldos separados. Por tanto, los créditos de una membresía no pueden pagar llamadas a la API (kimi.ai).
¿Se puede desactivar el razonamiento para reducir costes?
No. K3.1 Pro razona siempre. El control de costes pasa por reasoning_effort (low, high, max, con max como valor predeterminado) y por max_completion_tokens, no por desactivar el pensamiento (datacamp.com).
¿Cuándo llegarán los pesos abiertos y conviene esperar?
Moonshot apunta al 4 de noviembre de 2026, pero a 2 de noviembre todavía no había publicado ningún repositorio oficial en Hugging Face ni la licencia definitiva. Por ahora, planifica con la API y vuelve a valorar el alojamiento propio cuando aparezcan el checkpoint y la licencia oficiales.
Lecturas relacionadas: Kimi K3.1 Pro API: Pricing, Benchmarks and Highspeed Guide para consultar el análisis completo de benchmarks, Kimi K3 Pricing para ver las tarifas de la generación anterior y la Kimi K3 API page para llamar a modelos de Kimi con una sola clave.