 AIREITER
Una API que cuesta $0.15 por hora puede cobrar $0.30 por una hora de audio, mientras que otra de $0.36 por hora factura $0.36 por ese mismo archivo. Este pequeño detalle de facturación condiciona más presupuestos de STT que cualquier ranking de precisión, aunque la mayoría de comparativas lo esconda.
La mejor API de voz a texto en 2026 depende de si vas a transcribir archivos o a ejecutar un agente de voz en directo. Para audio grabado con presupuesto ajustado, el punto de partida es AssemblyAI Universal-2, a $0.15 por hora. Para agentes en directo donde el turno de palabra sea clave, conviene probar Deepgram Flux o Nova-3 en streaming. Y si necesitas más de 90 idiomas con una cobertura amplia de diarización, prueba ElevenLabs Scribe v2, a $0.22 por hora en procesamiento por lotes. Los precios que aparecen abajo son las tarifas oficiales de pago por uso, normalizadas a una hora de audio antes de aplicar descuentos por volumen.
El procesamiento por lotes y el streaming son productos distintos
Conviene tratar la transcripción por lotes y la transcripción en tiempo real como dos compras independientes. Las API por lotes cobran por cada hora de audio procesada y suelen funcionar con un flujo de subir el archivo y consultar después el resultado. Las API de streaming cobran por minuto de sesión, incluido el tiempo de inactividad mientras el WebSocket permanece abierto, y dependen por completo de la rapidez con la que entregan resultados parciales.
La latencia del primer resultado parcial, la finalización y el cierre de turno miden momentos diferentes: cuándo aparecen las primeras palabras, cuándo dejan de cambiar y cuándo el sistema decide que el interlocutor ha terminado. Comparar proveedores mezclando estas definiciones puede llevar a conclusiones equivocadas, como advierten las comparativas de streaming de Dexto y versusref.
La división práctica es esta:
- Archivos grabados grandes, podcasts, reuniones y registros de llamadas: prioriza el precio por hora, la precisión de la diarización, el manejo de archivos grandes y el tiempo necesario para corregir errores.
- Subtítulos en directo o agentes telefónicos: prioriza resultados parciales estables, detección del final de turno, gestión de interrupciones y la latencia de extremo a extremo, incluido tu LLM y el TTS.
- Llamadas de contact center en AWS o GCP: la contratación y la facturación por canal suelen pesar más que una diferencia de $0.05 por hora en el precio de lista.
"Prueba estas API con grabaciones reales de clientes. Salas ruidosas. Acentos indios. Cambio entre hindi e inglés... Primero precisión, latencia y fiabilidad. El precio, lo último." — @Aditya_Chawla20
La publicación comparaba AssemblyAI a $0.21 por hora, ElevenLabs Scribe v2 a $0.22 por hora y Deepgram Nova-3 cerca de $0.26 por hora. Su conclusión fue que la diferencia de 5 centavos importa menos que saber qué modelo resiste mejor el audio real.
Cuánto cuesta una hora de audio
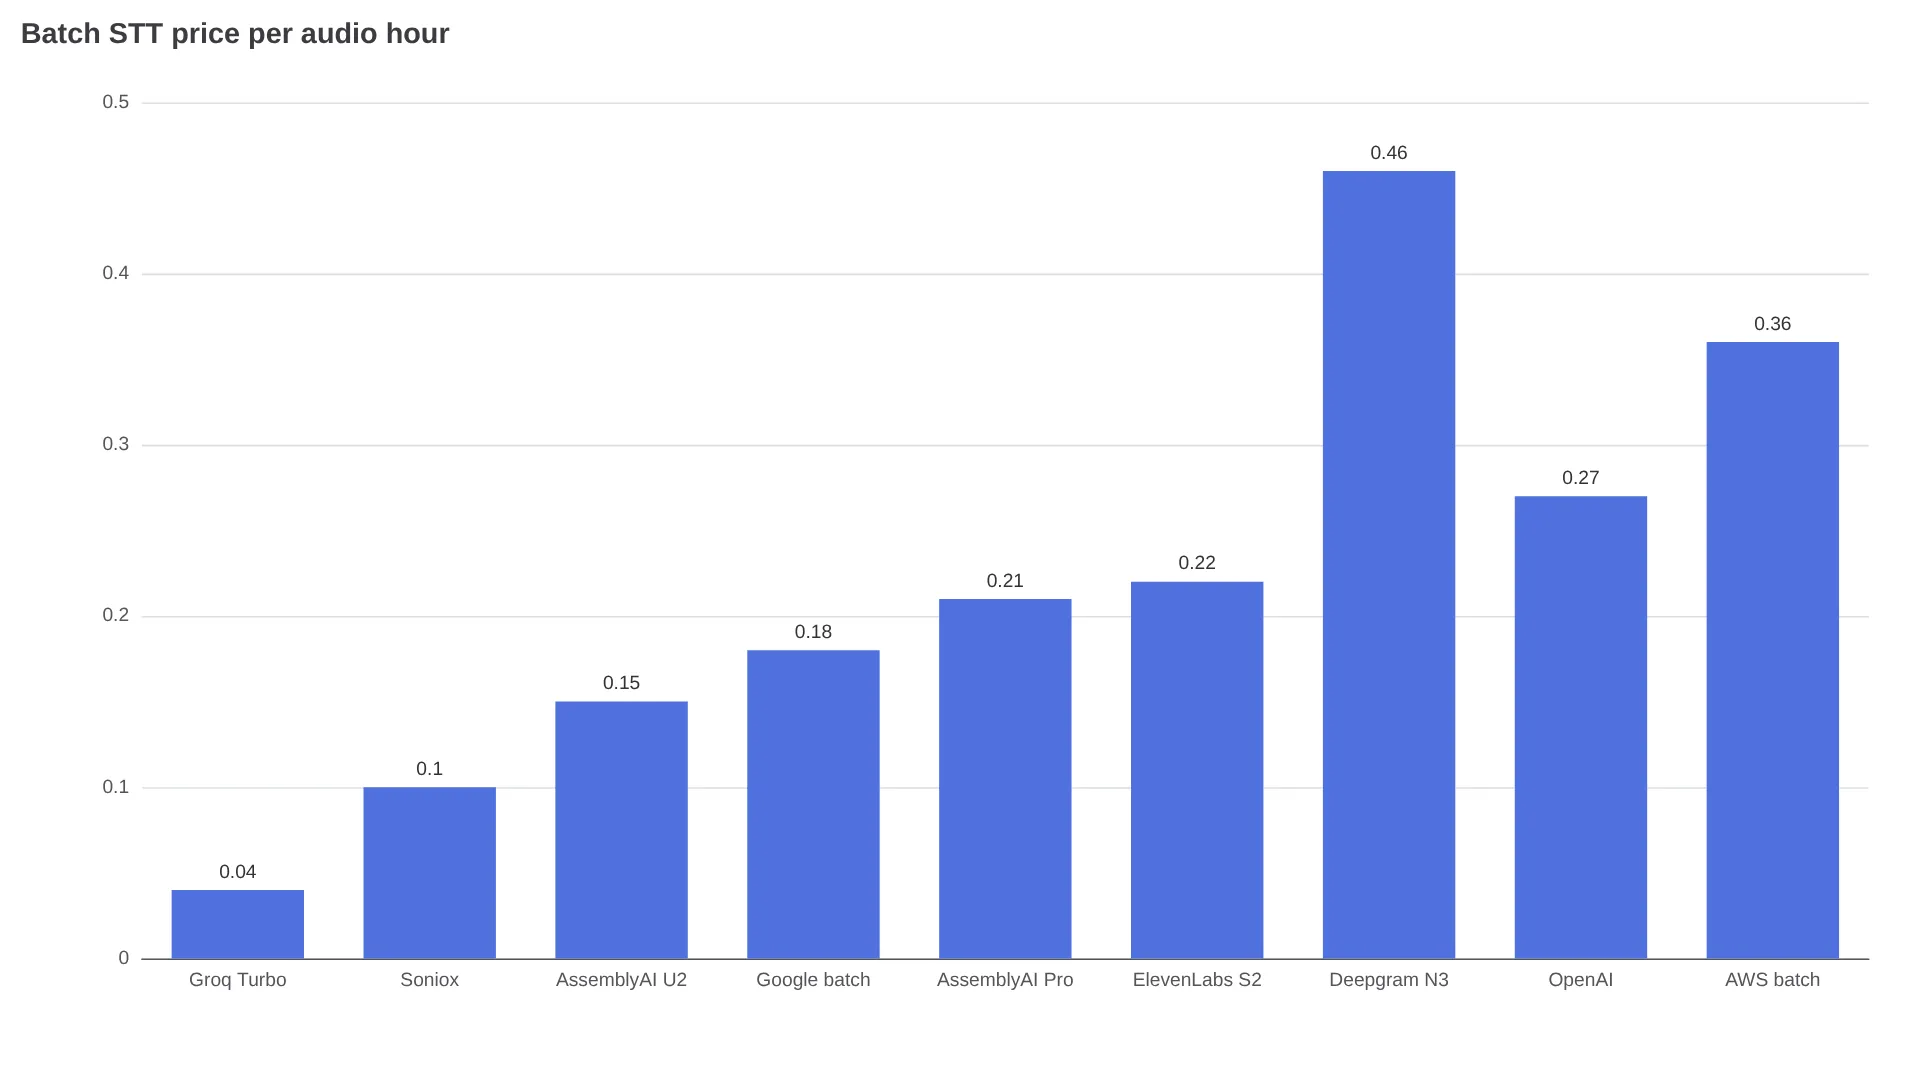
| Proveedor | Por lotes | Streaming / tiempo real | Idiomas | Oferta inicial gratuita |
|---|---|---|---|---|
| Groq Whisper | Large v3 Turbo $0.04/h | Sin endpoint de streaming | Conjunto multilingüe de Whisper | Plan gratuito con límites |
| Soniox | ~$0.10/h asíncrono | ~$0.12/h en tiempo real | Más de 60 en un único modelo | No especificada |
| AssemblyAI | Universal-2 $0.15/h; Universal-3.5 Pro $0.21/h | Universal-Streaming $0.15/h; Pro Realtime $0.45/h | 99 en U2; 18 en 3.5 Pro | Crédito de $50, sin tarjeta |
| Google Cloud | Dynamic Batch $0.18/h; Standard $0.96/h | Standard $0.96/h durante los primeros 500.000 min | Afirma ofrecer más de 125 variantes regionales | Crédito de Cloud de $300 |
| ElevenLabs Scribe | Scribe v2 $0.22/h | Scribe v2 Realtime $0.39/h | Más de 90 | ~4,5 h en el plan gratuito |
| Deepgram | Nova-3 $0.26–$0.46/h según el nivel (promocional frente a monolingüe normal) | Nova-3 promocional ~$0.29/h; Flux English $0.39/h ($0.0065/min) | Más de 45 | Crédito de $200 |
| OpenAI | gpt-transcribe $0.27/h ($0.0045/min) | gpt-live-transcribe $1.02/h ($0.017/min) | Se indica por modelo; Whisper 98 | No especificada |
| AWS Transcribe | $0.36/h ($0.006/min) | $0.60/h ($0.01/min) | Amplia; varía según la función | 60 min/mes durante 12 meses |
| Speechmatics | Melia 1 $0.24/h base | Linden 1 $0.30/h; Enhanced $0.80/h | Más de 55 | Crédito de $100 |
| Gladia | Solaria-3 €0.16/h | €0.68/h | Más de 100 en Solaria-1; 6 en Solaria-3 | Crédito de €50, durante 1 año |
El rango de Deepgram refleja la diferencia entre el precio promocional y el precio normal para audio pregrabado monolingüe. Antes de preparar un presupuesto, confirma el nivel activo en la página de precios de Deepgram.
La trampa de los canales múltiples
Una hora de audio estéreo no siempre equivale a una hora facturable. AssemblyAI y Google cobran cada canal por separado, así que una llamada de 60 minutos con dos canales en Universal-2 cuesta $0.15 x 2 = $0.30. La misma llamada con Google Standard cuesta $0.96 x 2 = $1.92. AWS Transcribe incluye hasta dos canales dentro del cargo por duración, por lo que esa llamada estéreo se queda cerca de $0.36 por lotes en el ejemplo de alto volumen de US East citado por CometAPI. Comprueba cómo cuenta los canales cada proveedor antes de comparar dos cifras expresadas en $/hora.
Los extras pueden cambiar completamente el ranking
La transcripción base es solo el principio. Según el desglose por conceptos de CometAPI, la transcripción pregrabada monolingüe de Deepgram Nova-3, a $0.0077/min, pasa a $0.0097/min con diarización y a $0.0117/min con diarización más redacción; la inclusión de términos clave añade otros $0.0013/min. AssemblyAI cobra $0.02/h por la diarización de grabaciones, pero $0.12/h por la diarización en streaming. ElevenLabs añade $0.08/h por términos clave en tiempo real y $0.07/h por detección de entidades.
El coste total por transcripción aceptada = procesamiento de la API + funciones de pago + reintentos + almacenamiento/transferencia + tiempo de corrección humana. En el ejemplo de CometAPI, calculado con un coste de $30/h para el revisor, una ruta de $0.15/h que necesitaba 8 minutos de correcciones acababa costando $4.15, mientras que una ruta de $0.60/h que requería 3 minutos sumaba $2.10.
Si estás creando un agente de voz, prueba primero la gestión de turnos
Los agentes de voz fallan más por las interrupciones y las pausas que por el WER con audio limpio. Compara el mecanismo de gestión de turnos, los controles de contexto, el precio en tiempo real y la principal limitación de cada opción.
| Proveedor | Gestión de turnos | Precio en tiempo real | Limitación |
|---|---|---|---|
| Deepgram Flux | Eventos EndOfTurn, umbral ajustable; modo eager + TurnResumed; según la documentación de Deepgram citada por Dexto, eager puede aumentar las llamadas al LLM un 50–70 % | Flux English $0.0065/min; Nova-3 en streaming promocional ~$0.0048/min | Flux multilingüe en 10 idiomas; las promociones caducan |
| AssemblyAI | Prompt + términos clave + 1.750 caracteres de la respuesta anterior del agente; detección del final basada en la puntuación | Universal-Streaming $0.15/h; Pro Realtime $0.45/h | El nivel de streaming barato está centrado en inglés; se factura el tiempo con el socket inactivo |
| ElevenLabs Scribe | ~150 ms de latencia del modelo según el proveedor; más de 90 idiomas; diarización por lotes de hasta 32 hablantes | Scribe v2 Realtime $0.39/h + $0.08/h por términos clave en tiempo real | No se indica diarización en tiempo real; la cifra del proveedor excluye la red y la pila del agente |
| OpenAI | Deltas de transcripción por WebSocket; sin VAD en el servidor; el cliente confirma el turno; sin etiquetas de hablante ni marcas temporales por palabra en tiempo real | gpt-live-transcribe $0.017/min | Se necesita detección del final en el cliente; es el precio por hora en tiempo real más alto de esta tabla |
Mide también el tiempo de las llamadas a herramientas y del LLM. Un desarrollador de agentes para hoteles contó en X que sufría entre 5 y 7 segundos de silencio después de las llamadas a herramientas pese a tener un STT rápido: @albertolco88. Esa diferencia de extremo a extremo nunca aparece en las tablas que solo comparan STT.
Si transcribes grabaciones, evalúa por separado el texto y la diarización
Una prueba compartida por un usuario en r/speechtech utilizó una reunión real en sueco de 2 horas y 22 minutos, con seis hablantes, y la comparó con una referencia de pyannote. El autor concluyó que Deepgram era el más rápido y el más sólido en diarización; ElevenLabs ofrecía mejor texto en sueco, pero no identificaba a dos de los seis hablantes; y AssemblyAI quedaba cerca en precisión, aunque era mucho más lento en ese flujo. En lugar de proclamar un ganador, combinó varios proveedores.
"Deepgram es el más sólido de los tres y fue muy rápido." — u/DoctorNootNoot en r/speechrecognition
Tres comprobaciones específicas para grabaciones separan las API realmente utilizables de las que acaban resultando frustrantes:
- Cambio de idioma dentro de una misma intervención. Los desarrolladores del hilo sobre reuniones multilingües cuentan que aparecen transiciones ilegibles cuando los hablantes mezclan finés e inglés o español e inglés a mitad de una frase. Universal-3.5 Pro indica compatibilidad con cambio de idioma entre 18 lenguas; Gladia y Speechmatics presentan la detección multilingüe como uno de sus puntos fuertes. Ningún proveedor resuelve perfectamente todas las parejas europeas de serie, así que prueba las combinaciones que realmente necesitas.
- Diarización a escala. Pregunta cuántos hablantes admite el sistema (ElevenLabs indica 32 en lotes, Azure indica 35 y Speechmatics no especifica un límite en tiempo real), si existe diarización en tiempo real y cuánto añade al precio y a la latencia. El mismo autor de la prueba en sueco describió el tiempo de respuesta de AssemblyAI como demasiado lento para su flujo de producción, aunque la precisión del texto fuese parecida.
- Archivos grandes. OpenAI limita las cargas de audio a 25 MB, lo que complica las grabaciones largas. Las API orientadas a lotes aceptan trabajos basados en URL, archivos de varias horas y consultas asíncronas persistentes. Un usuario del hilo sobre transcripción por lotes afirmó que "no puede subir archivos grandes" y que no entendía el procesamiento mediante URL: un obstáculo de adopción que ninguna tabla de WER refleja.
Whisper large-v3 autoalojado sigue siendo la opción offline. En la prueba de Echosaw con el mismo audio, que abarcó 22,7 minutos de lectura y conversación en inglés, las API alojadas obtuvieron menos de un 2,1 % de WER en capítulos limpios, mientras que una configuración de Whisper con dos vCPU obtuvo entre un 10 y un 17 %, con segmentos perdidos, además de un 32,7 % en audio de reuniones a 0,5x del tiempo real. En producción, el autoalojamiento suele requerir una GPU con VAD y división en fragmentos para conseguir un rendimiento práctico.
Nube, proveedor especializado o autoalojamiento
- Nativo del hyperscaler. Google Dynamic Batch, a $0.18 por hora, encaja en grandes archivos no urgentes que ya estén en GCP; Standard, a $0.96 por hora, penaliza el uso en tiempo real. AWS Transcribe encaja en flujos de llamadas con S3/IAM e incluye dos canales. Azure Speech factura los lotes cerca de $0.18 por hora y el tiempo real cerca de $1.00 por hora, con un nivel gratuito de 5 horas mensuales en tiempo real. Añade al cálculo el almacenamiento, la transferencia y las tarifas de redacción, que quedan fuera de la línea de transcripción.
- Lotes gestionados baratos. Groq Whisper Turbo, a $0.04 por hora, es más barato que cualquier API gestionada para volcados por lotes sencillos, pero no ofrece streaming ni especifica diarización. Soniox, cerca de $0.10 por hora en modo asíncrono, es la cifra más baja de la tabla para lotes que combina más de 60 idiomas con diarización y marcas temporales incluidas, aunque cuenta con una cobertura de pruebas independientes más limitada.
- Pipeline híbrido. Usa ElevenLabs para el texto de la transcripción cuando sea el que mejor funcione, Deepgram para la diarización cuando destaque en ella y Whisper o Groq para los lotes de bajo coste. Esta separación añade trabajo de orquestación, pero si ningún proveedor supera a los demás tanto en texto como en identificación de hablantes con tu audio, dos llamadas baratas pueden salir mejor que una costosa ronda de correcciones.
Nota sobre migración: OpenAI marca whisper-1, gpt-4o-transcribe, gpt-4o-mini-transcribe y gpt-4o-transcribe-diarize como obsoletos, con el cierre programado para el 26 de febrero de 2027. Los equipos que todavía usen esos modelos deberían probar alternativas antes de esa fecha límite, especialmente cuando cambien el comportamiento de las marcas temporales por palabra y la diarización.
Haz una prueba de 7 días con tu propio audio
Las cifras de WER de los proveedores utilizan conjuntos de datos, normalizadores y versiones de modelo distintos, por lo que no se pueden comparar directamente. Reúne entre 30 y 50 intervenciones reales de clientes o fragmentos de reuniones con tus acentos, ruido y vocabulario. Transcribe una vez la referencia manualmente y después envía el mismo audio en streaming o súbelo a dos o tres proveedores, sin cambiar el resto del pipeline.
Registra los segundos de audio, el número de canales, las funciones activadas, la versión del modelo, la latencia de los parciales, el retraso hasta la finalización, la latencia de extremo a extremo del agente, la tasa de error de diarización y los minutos de corrección por transcripción aceptada. Puntúa por separado los términos críticos para el negocio —nombres, correos electrónicos, importes y nombres de productos— y el WER general. La ruta con el precio por hora más bajo que duplica la revisión humana normalmente acaba perdiendo en coste total.
Preguntas frecuentes
¿Cuál es la API de voz a texto más barata en 2026?
Soniox, cerca de $0.10 por hora, y AssemblyAI Universal-2, a $0.15 por hora, son los precios de lista más bajos entre las API gestionadas por lotes con soporte de diarización de la tabla anterior. Groq Whisper Turbo, a $0.04 por hora, es más barato para procesamiento por lotes sin streaming ni diarización.
¿Qué API ofrece la menor latencia en streaming?
Según el resumen de afirmaciones de proveedores de Dexto: ElevenLabs declara ~150 ms de latencia del modelo, Deepgram ~260 ms hasta el final del turno y Speechmatics <350 ms de finalización media. Prueba la latencia de los parciales, la finalización y el recorrido completo en tus propias llamadas.
¿Qué API de STT es mejor para agentes de voz?
Deepgram Flux para la gestión nativa de turnos, AssemblyAI para los prompts de contexto, ElevenLabs Realtime para una cobertura amplia de idiomas dentro de una pila de voz de ElevenLabs y OpenAI Live Transcription para pilas nativas de OpenAI que puedan implementar la detección del final de turno.
¿Cuál gestiona mejor el audio multilingüe y con cambio de idioma?
ElevenLabs (más de 90), AssemblyAI U2 (99; 3.5 Pro 18 con cambio de idioma), Gladia Solaria-1 (más de 100) y Speechmatics (más de 55). Prueba la combinación exacta que necesitas: los cambios a mitad de frase todavía pueden producir transiciones ilegibles.
¿Debería usar un solo proveedor o combinar transcripción y diarización?
Si un proveedor ofrece el mejor texto pero queda por detrás en las etiquetas de hablante con tu audio, como ocurrió en el informe sueco de seis hablantes enlazado arriba, combinar proveedores puede superar a cualquiera de ellos por separado. Compara el coste de orquestación y la doble facturación con el tiempo de corrección que ahorras.
¿Van a cerrar OpenAI Whisper?
OpenAI ha marcado como obsoletos varios modelos antiguos de transcripción, incluidos whisper-1 y las variantes de gpt-4o-transcribe, con el cierre programado para el 26 de febrero de 2027. Las opciones actuales son gpt-transcribe para archivos y gpt-live-transcribe para audio en directo.
| Carga de trabajo | Empieza con | Por qué |
|---|---|---|
| Archivo grande de grabaciones | AssemblyAI U2 / Google Dynamic Batch / Groq Whisper | El menor precio por hora; Groq es el más barato cuando no hace falta diarización |
| Agente de voz en directo | Deepgram Flux / AssemblyAI Realtime / ElevenLabs Realtime | Gestión de turnos, prompts de contexto y baja latencia del modelo |
| Reuniones multilingües | ElevenLabs Scribe v2 / Speechmatics / Gladia | Posicionamiento en más de 90/55/100 idiomas y diseño para cambios de idioma |
| Nativo de AWS o GCP | Transcribe / Cloud STT | IAM, almacenamiento y contratación pesan más que el precio de lista |
| Uso offline o residencia de datos | Whisper autoalojado | El audio nunca sale de tu hardware |
Lecturas relacionadas: Mejor API de texto a voz, Mejor API de clonación de voz en 2026, Guía de la API Gemini 3.5 Transcribe.