 AIREITER
Opus 5.5 gana en calidad y GPT-6.1 Sol en precio, pero solo mientras cada petición se mantenga por debajo de 272K tokens de entrada. Al superar ese umbral, el recargo por contexto largo de Sol se come buena parte de su ventaja. Además, varios usuarios de Codex aseguran que Sol resulta más lento en tiempo real.
Los dos modelos ya están disponibles. Anthropic lanzó Claude Opus 5.5 el 22 de septiembre de 2026 como el primer modelo Claude 5.5, y OpenAI lanzó GPT-6.1 Sol el 29 de septiembre de 2026 con el ID de API gpt-6.1-sol. Las tablas de especificaciones no cuentan toda la historia: el coste real depende del salto de precio por contexto largo, del nivel de esfuerzo y del comportamiento de las cuotas en las suscripciones.
La respuesta rápida
Elige Claude Opus 5.5 cuando corregir un parche equivocado o demasiado complejo cueste más que los tokens: migraciones largas, auditorías de varios repositorios y agentes desatendidos. Opta por GPT-6.1 Sol para trabajos de gran volumen y bien delimitados por debajo de 272K tokens de entrada por petición: automatización de tickets, extracción de PDF y flujos empresariales.
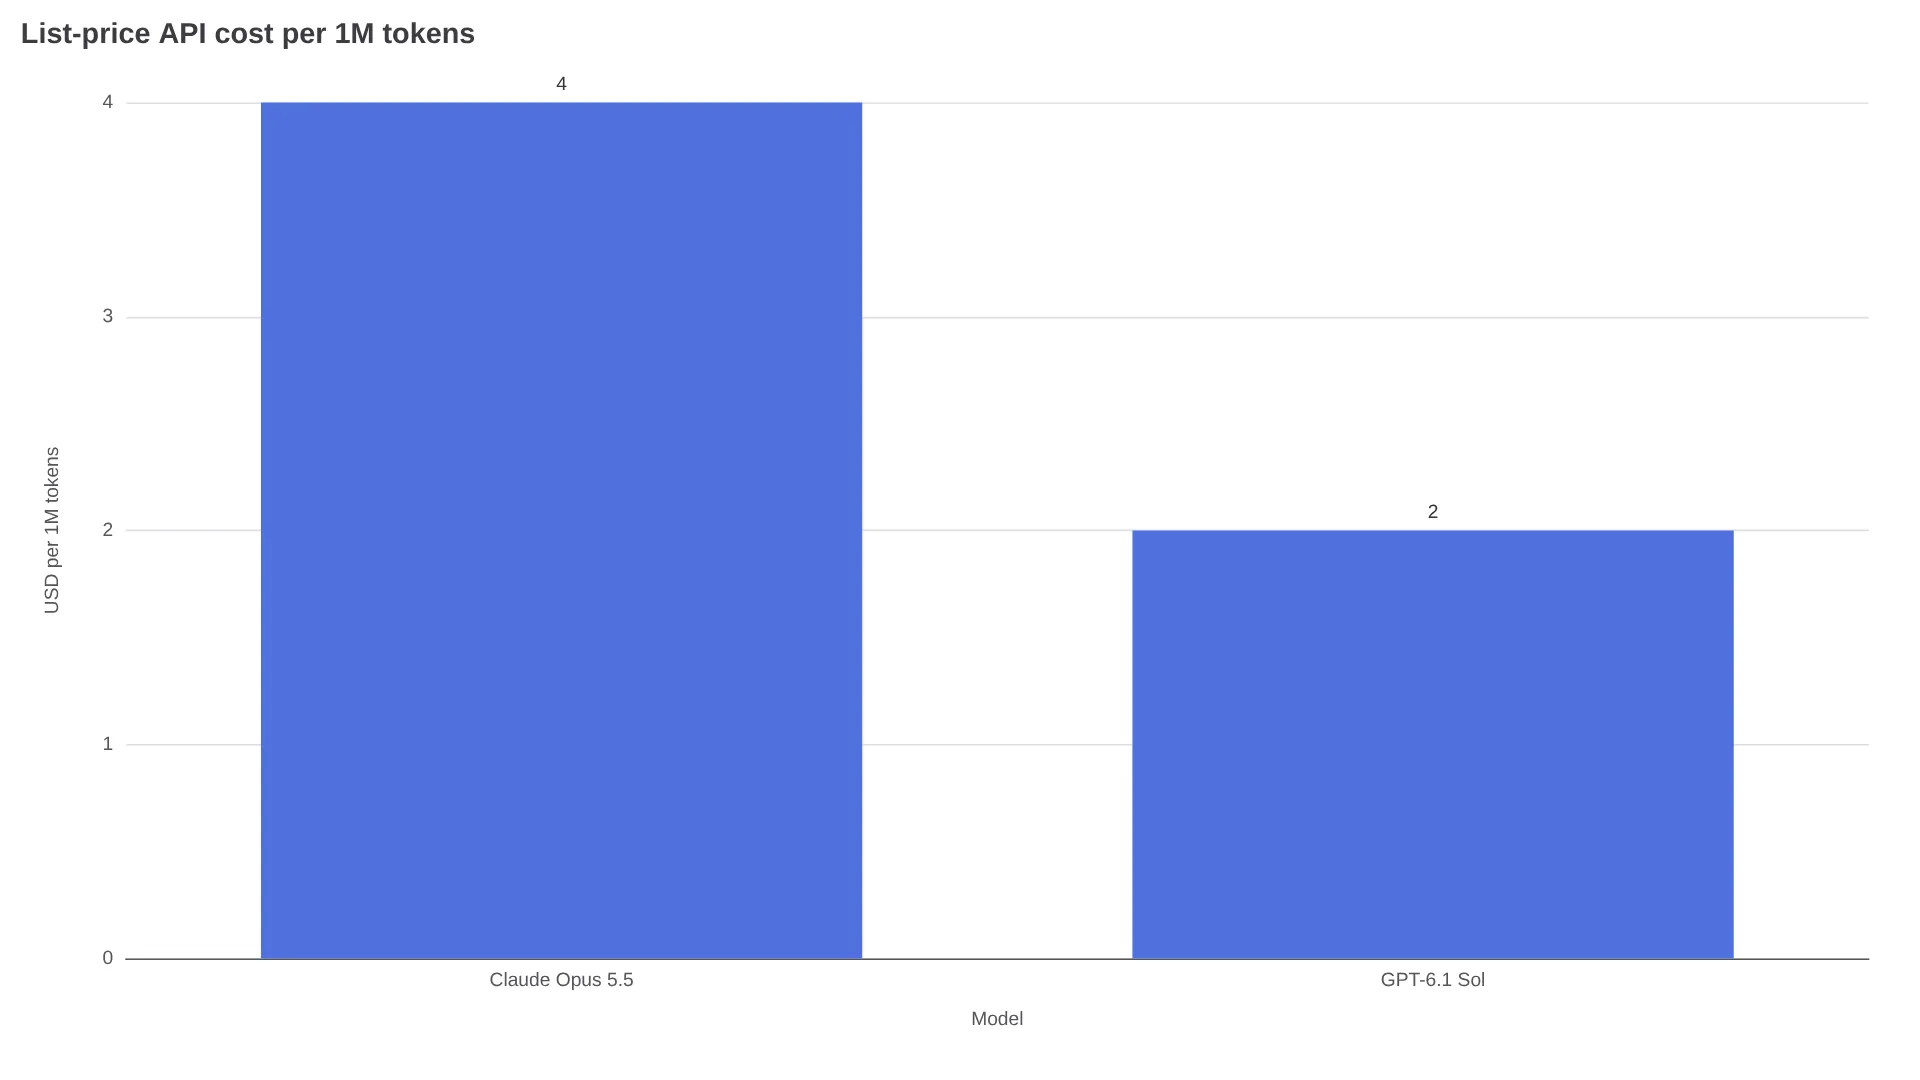
Sobre el papel, la diferencia técnica es pequeña: 1M frente a 1,05M de contexto, 128K tokens de salida máxima en ambos casos y $4/$20 frente a $2/$10 por cada millón de tokens de entrada/salida. En la práctica, la brecha de comportamiento es mayor: Opus 5.5 registra mejores resultados en programación agéntica (66,4 % en Terminal-Bench 4.0, 54,4 % en FrontierCode v1.1 y 57,8 % en CursorBench 4.0), mientras que Sol responde con aproximadamente la mitad de precio y una victoria documentada en AutomationBench con un tercio del coste por tarea. En las suscripciones aparece una complicación adicional: las pruebas de cuotas publicadas en Reddit indican que Sol consume la asignación más rápido de lo que su precio de API haría pensar.
Precio, contexto y dónde usar cada modelo
| Claude Opus 5.5 | GPT-6.1 Sol | |
|---|---|---|
| Proveedor | Anthropic | OpenAI |
| Lanzamiento | 22 de septiembre de 2026 | 29 de septiembre de 2026 |
| ID de API | familia claude-opus-5-5 en la mayoría de gateways | gpt-6.1-sol |
| Entrada / salida por 1M | $4.00 / $20.00 | $2.00 / $10.00 |
| Lectura de entrada en caché por 1M | $0.20 | $0.10 |
| Ventana de contexto | 1.000.000 tokens | 1.050.000 tokens |
| Salida máxima | 128K tokens | 128K tokens |
| Nivel rápido | Modo Fast: $8 / $40, hasta 2,5 veces más velocidad | Ultrafast: hasta 8 veces en Codex, aproximadamente el doble de las tarifas estándar |
| Disponible mediante | Claude Code, API, Bedrock, Vertex, Foundry, OpenRouter | Codex, ChatGPT Work, API, Azure, Bedrock, OpenRouter |
| No disponible en | — | Chat para consumidores habitual en el lanzamiento |
Para cambiar de uno a otro basta con modificar la cadena del modelo. AIReiter permite usar ambos desde una misma consola sin tener que gestionar dos claves de proveedor.
Lo que acabarás pagando en cargas de trabajo reales
Las tarifas publicadas dicen que Sol es un 50 % más barato. En la práctica, el tamaño de cada petición y el uso de caché son determinantes.
El recargo de OpenAI se aplica por petición cuando se superan los 272K tokens de entrada: duplica las tarifas de entrada y caché y multiplica por 1,5 la de salida para toda esa petición. Anthropic incluye la ventana completa de 1M con las mismas tarifas y no ha comunicado ningún recargo por petición. Las lecturas en caché cuestan $0.20 frente a $0.10, así que los bucles con mucho uso de caché conservan parte de la ventaja de Sol.
| Carga de trabajo | Opus 5.5 | GPT-6.1 Sol | Diferencia |
|---|---|---|---|
| Asistente equilibrado: 1M de entrada / 250K de salida, con peticiones inferiores a 272K | $9.00 | $4.50 | Sol es un 50 % más barato |
| Retrieval, peticiones inferiores a 272K: 10M de entrada / 1M de salida | $60 | $30 | Sol es un 50 % más barato |
| Retrieval, todas las peticiones por encima de 272K: 10M de entrada / 1M de salida | $60 | ~$55 | Sol solo es ~8 % más barato |
| Bucle con mucha caché: prefijo de 100K escrito una vez y después 1.000 veces (5K nuevos + 100K de lectura en caché + 1K de salida) | ~$60.50 | ~$30.25 | Sol es ~50 % más barato |
Son cálculos con tarifas estándar y sin tener en cuenta diferencias entre tokenizadores. La ventaja de Sol es mayor en peticiones cortas y numerosas, y menor en recuperaciones gigantes de una sola petición.
La cuenta de las suscripciones no coincide con la de la API. Una comparación realizada por un usuario con 128 prompts de GPT-6.1 Sol, GPT-6 Sol y Opus 5.5 sobre prompts fijos concluyó que el consumo de la suscripción de la familia Sol era superior al que sugería el precio por token. Otro comentarista lo resumió así:
"mi ChatGPT acaba de citar esto. En fin, quizá estén igualados en consumo, pero Opus es muchísimo más rápido en tiempo real y me arrepiento de haber cambiado este mes" — u/ebrbrbr, hilo de prueba de cuotas de r/ChatGPT
Otro usuario de Codex describió el mismo problema:
"No me importaría usar GPT 6.1 Sol si el consumo fuese razonable, pero, aunque sea más 'eficiente', sigo quedándome sin uso. Es increíble." — u/Longjumping_Stop6269, r/codex
Regla presupuestaria: si tu petición mediana supera los 272K, calcula el recargo antes de migrar. Si pagas una suscripción de $20 o $100, mide la cuota consumida por pull request integrado, no los tokens por dólar.
Programación y agentes: benchmarks y dos pruebas prácticas
Los resultados de terceros son orientativos; los harnesses y niveles de esfuerzo no son iguales. Fuentes: Anthropic, OpenAI, prueba de DataCamp, rendimiento de OpenRouter, recopilación de benchmarks de SpringPrompt.
| Benchmark | Opus 5.5 | GPT-6.1 Sol | Nota |
|---|---|---|---|
| Terminal-Bench 4.0 | 66,4 % | no publicado | Ejecutado por Anthropic, xhigh |
| FrontierCode v1.1 Main | 54,4 % | igual que Fable 5.1, sin cifra | Informes de fuentes distintas |
| CursorBench 4.0 | 57,8 % | no publicado | Ejecutado por Anthropic |
| DeepSWE v1.1 | no publicado | igual que Astra, +6,4 puntos porcentuales frente a GPT-6 Sol | Ejecutado por OpenAI, esfuerzo máximo |
| AutomationBench (47 herramientas) | 40,0 % | +2,2 puntos porcentuales frente a Opus en nivel medio, ~1/3 del coste | Prueba independiente, sin alternativas, según el relato de Anthropic sobre la prueba de Zapier |
| OSWorld 2.0 parcial | 81,8 % | ~60,5 % en el conjunto offline | Subconjuntos distintos, pruebas de los proveedores |
| GDPval-AA v2.1 | 1.846 Elo | Sol supera a Opus con alternativas en GDP.pdf por <1/2 del coste | Afirmación entre proveedores de OpenAI |
Opus 5.5 cuenta con el conjunto publicado más completo en programación agéntica. Las mejores victorias documentadas de Sol llegan en flujos empresariales y análisis de documentos con un coste menor por tarea. Anthropic afirma que sus resultados se obtuvieron con las medidas de protección activas en producción.
Dos pruebas de terceros aportan algo más de contexto:
- Desarrollo de un Tetris en un solo archivo (DataCamp, OpenCode, mismo prompt, esfuerzo alto, un intento). Los dos superaron la lógica difícil de inversión de la gravedad. Sol obtuvo 5,0 frente a 4,3 en mecánicas, completitud y sensaciones; Opus terminó en 3 turnos y 2 llamadas a herramientas frente a los 6 turnos y 9 llamadas de Sol, pero costó $0.87 frente a $0.26 después de consumir 22,5K tokens de razonamiento frente a los 8,1K de Sol.
- Prueba de cuotas con 128 prompts (Reddit, prompts fijos, cuota y tiempos registrados). Sol consumió más cuota de suscripción que GPT-6 Sol en la misma carga de trabajo, mientras que Opus terminó antes en tiempo real.
Hay un comentario recurrente de los usuarios: Opus se contiene más.
"La mayor ventaja de Opus 5.5 para mí ni siquiera es la velocidad de programación, sino que no sobrediseña las soluciones sencillas. Los modelos anteriores reescribían 4 archivos cuando pedías un parche de 3 líneas; 5.5 respeta la arquitectura existente" — u/food_fatherr, r/ClaudeAI
También hay un informe extremo en la dirección contraria: un desarrollador contó que Sol escribió 30.000 pruebas para una petición de precisión píxel a píxel y que solo eliminó 25 cuando le pidieron reducirlas.
La velocidad que ves frente a la velocidad que indican las cifras
Las fichas técnicas favorecen a Opus en la generación: ~96 frente a ~53 tokens/s en Artificial Analysis según SpringPrompt, y 74 frente a 29 de rendimiento mediano en OpenRouter. Según SpringPrompt, Sol queda ligeramente por delante en tiempo hasta el primer token (1,71 s frente a 6,89 s con esfuerzo bajo). Sin embargo, los informes citados de Codex describen lo contrario en esperas de principio a fin, con tareas sencillas que tardan varios minutos y trabajos largos con documentos.
Ambas cosas pueden ser ciertas: tokens por segundo mide la generación después del primer bloque; el tiempo total también incluye razonamiento, colas y la sobrecarga del harness.
- El modo Fast de Opus cuesta $8/$40 (2x) y ofrece hasta 2,5 veces más velocidad; Sol Ultrafast promete hasta 8 veces más velocidad en Codex con tarifas de aproximadamente 2x.
- Los informes citados de Codex y Work se centran en la latencia, no en la generación de la API. Un trabajo con un PDF de 40 minutos consumió solo el 6 % de una ventana de 5 horas en una única anécdota, no en una medición típica.
- Si tu flujo es interactivo —Cursor, Claude Code o Codex CLI—, prueba tres tickets reales con cada modelo antes de decidir.
Los ajustes que deciden la factura
Los valores predeterminados importan más que la etiqueta del modelo:
- Empieza Opus en Medium o High. Los informes de usuarios citados sugieren que Extra High y Max consumen mucha cuota con poca mejora en parches normales.
- Los bloqueos de razonamiento no funcionan igual. El razonamiento de Opus no se puede desactivar, rechaza el uso forzado de herramientas y el contexto editado puede generar un error 400 en cuentas nuevas (notas de la API de DataCamp). Sol escala de
noneamaxy permite cambiar el esfuerzo a mitad de conversación sin invalidar la caché (controles de razonamiento de DataCamp), algo más cómodo para bucles con presupuesto limitado. - Las medidas de seguridad pueden redirigir el trabajo. La mayoría de tareas de ciberseguridad con Opus se redirigen a Opus 4.8 fuera del Cyber Verification Program; el trabajo de biología requiere el programa Life Sciences (Anthropic). En esas tareas pueden aparecer sorpresas de calidad y cuota relacionadas con el fallback.
Qué modelo elegir según tu carga de trabajo
| Si vas a hacer… | Elige… | Por qué |
|---|---|---|
| Migración de 200.000 líneas, auditoría de varios repositorios, ejecución de un agente durante 9 horas | Opus 5.5 | Mejores resultados agénticos, menos reescrituras innecesarias y precio plano para 1M |
| 10.000 tickets al día por debajo de 272K cada uno, RAG con fragmentos pequeños | GPT-6.1 Sol | La mitad de precio, buenos resultados en AutomationBench y GDP.pdf por dólar |
| Recuperación gigante de una sola petición por encima de 272K | Opus 5.5 o divide el trabajo para usar Sol | El recargo de Sol reduce su ventaja a ~8 % |
| Preguntas y respuestas financieras y jurídicas basadas en muchos PDF | Prueba primero Sol | Victoria declarada frente a Opus con alternativas por <1/2 del coste por tarea; verifícalo con tus documentos |
| Suscriptor de $20 con CLI interactiva | Prueba ambos; los informes citados favorecen a Opus | Los usuarios dicen que Sol agota la cuota antes de lo que predice la cuenta de tokens y se siente más lento |
No hay un ganador universal. Sol es la opción eficiente; Opus, la de la contención y la autonomía. Una división práctica consiste en usar Opus para planificar y revisar, y Sol para ejecutar tareas en masa.
Preguntas frecuentes sobre Opus 5.5 y GPT-6.1 Sol
¿Cuál es más barato mediante la API?
Sol a precio estándar ($2/$10 frente a $4/$20, y $0.10 frente a $0.20 en caché). La diferencia se reduce a ~8 % cuando todas las peticiones superan los 272K tokens de entrada.
¿Cuál es mejor para agentes de programación?
Opus 5.5 lidera los resultados publicados de Terminal-Bench, FrontierCode y CursorBench. Sol responde con paridad con Astra en DeepSWE y una victoria en AutomationBench por un tercio del coste.
¿Cuál es más rápido en el uso real?
La generación favorece a Opus (~74–96 tok/s frente a ~29–53); Sol gana ligeramente en el primer token. Los informes de Codex de octubre de 2026 apuntan a que Sol es más lento.
¿Cuáles son los IDs de los modelos en la API?
gpt-6.1-sol y los slugs claude-opus-5-5 en la mayoría de gateways.
¿GPT-6.1 Sol está disponible en el ChatGPT habitual?
No en el lanzamiento del 29 de septiembre: primero en Work, Codex y la API. Comprueba tu suscripción si el acceso es importante.
¿Qué nivel de esfuerzo debería utilizar?
Empieza Opus 5.5 en Medium o High, no en Max; empieza Sol en medium y súbelo solo si aumentan los reintentos. En ambos casos, los tokens de razonamiento se cobran en el mismo contador por token (notas de facturación de DataCamp).
La diferencia que no puedes solucionar con un prompt
Opus 5.5 respeta el repositorio, pero cobra ese razonamiento; Sol rebaja el coste de los tokens, aunque puede inundarte de trabajo que revisar y hacerte esperar. Si un fallo silencioso puede acabar enviando un bug a producción, paga por Opus. Si los errores son baratos y lo importante es el volumen, aprovecha el ahorro de Sol siempre que te mantengas por debajo de 272K.
Lecturas relacionadas: análisis y precios de Claude Opus 5.5, análisis de precios de la API de GPT-6.1 Sol.