 AIREITER
Elige GLM-5.3-Flash para trabajar con imágenes, vídeo y archivos; apuesta por DeepSeek V4 Flash si tu prioridad es procesar texto y código con mucho uso de caché. En la práctica, la carga de trabajo y la forma de facturación pesan más que cualquier benchmark aislado.
La comparación empieza por los identificadores de modelo
Esta comparativa enfrenta GLM-5.3-Flash (glm-5.3-flash) con el modelo de producción de la API de DeepSeek, deepseek-v4-flash, identificado en la página oficial de precios como DeepSeek-V4-Flash-0731. DeepSeek V4 Pro y el endpoint experimental independiente deepseek-v4-flash-vision-exp no son sustitutos del modelo Flash principal en este análisis. Para conocer la identidad de Ox Alpha, los límites de hardware y las salvedades de la versión preliminar, consulta la reseña de GLM-5.3-Flash de AIReiter.
La respuesta rápida según el tipo de carga
| Si tu prioridad es… | Elige | Motivo |
|---|---|---|
| Convertir capturas en código, inspeccionar interfaces, trabajar con vídeo o archivos | GLM-5.3-Flash | Admite imágenes, vídeo y archivos de forma nativa en un solo modelo |
| Procesamiento masivo de texto con una tasa alta de aciertos de caché | DeepSeek V4 Flash | Precio oficial más bajo para entradas almacenadas en caché, especialmente fuera de las horas punta |
| Tráfico con entradas nuevas y muchas salidas durante la promoción de GLM | GLM-5.3-Flash | Sus tarifas promocionales de entrada y salida son inferiores a las tarifas oficiales de DeepSeek para caché no acertada y salidas |
| Programación intensiva en terminal con una opción de producción conservadora | DeepSeek V4 Flash | Ruta pública versionada en beta y resultados oficiales de evaluación de Flash |
| Agentes visuales de navegador o de uso del ordenador | GLM-5.3-Flash | La información visual permanece dentro del ciclo de programación o uso de herramientas |
| Un contexto de texto de 1M de tokens | Ninguno por defecto | Ambos anuncian un contexto de clase 1M; prueba la recuperación con el tamaño real de tus prompts |
| Un único modelo para texto, código e imágenes | GLM-5.3-Flash | Evita utilizar un endpoint de visión separado para la ruta multimodal principal |
Lo que dicen realmente las especificaciones oficiales
La documentación de modelos de Z.AI y la página de precios de Z.AI describen el modelo y la facturación de GLM. La documentación de DeepSeek sobre modelos y precios y su registro de cambios ofrecen los datos equivalentes sobre la versión Flash y sus funciones.
| Especificación | GLM-5.3-Flash | DeepSeek V4 Flash |
|---|---|---|
| Identificador del modelo en la API | glm-5.3-flash | deepseek-v4-flash |
| Versión publicada | GLM-5.3-Flash | DeepSeek-V4-Flash-0731 |
| Ventana de contexto | 1M de tokens | 1M de tokens |
| Salida máxima indicada en la documentación oficial | 128K tokens | 384K tokens |
| Tipos principales de entrada | Texto, imágenes, vídeo y archivos | Texto y código; la visión está disponible en un modelo experimental separado |
| Salida | Texto | Texto |
| Control del razonamiento | Thinking activado; admite reasoning_effort | Modos thinking y non-thinking; niveles de esfuerzo low, high y max |
| Herramientas y salida estructurada | Llamadas a funciones, streaming, caché de contexto y salida JSON | Llamadas a herramientas, salida JSON, Responses API y compatibilidad con Anthropic API |
| Pesos | Pesos abiertos publicados por el proveedor | Pesos abiertos publicados por el proveedor |
Los 320.000 millones de parámetros totales y los 18.000 millones activos de GLM describen una arquitectura dispersa de expertos, no un checkpoint local de 18.000 millones de parámetros; la página oficial de precios de DeepSeek no publica una cifra comparable para Flash.
GLM acepta entradas visuales desde la ruta principal del modelo. DeepSeek ofrece deepseek-v4-flash-vision-exp por separado, lo que cambia los supuestos de enrutamiento y de las pruebas.
La programación y los agentes plantean dos pruebas distintas
Los agentes de terminal ponen a prueba el trabajo con repositorios y herramientas; los agentes visuales también tienen que interpretar interfaces renderizadas y estados de una GUI.
Trabajo con terminal y repositorios
La tabla de lanzamiento de Z.ai y la actualización oficial del 31 de julio de DeepSeek publican estos resultados:
| Benchmark | GLM-5.3-Flash | DeepSeek V4 Flash | Estado de la evidencia |
|---|---|---|---|
| Terminal Bench 2.1 | 84.3 | 82.7 | Evaluaciones independientes comunicadas por cada proveedor |
| DeepSWE | 63.4 | 54.4 | Evaluaciones independientes comunicadas por cada proveedor |
| Toolathlon Verified | 78.4 | 70.3 | Evaluaciones independientes comunicadas por cada proveedor |
| AutomationBench | 48.8 | 25.1 | Evaluaciones independientes comunicadas por cada proveedor |
| Agents’ Last Exam | 26.3 | 25.2 | Evaluaciones independientes comunicadas por cada proveedor |
GLM lidera estos benchmarks comunicados por los proveedores, pero como los bancos de pruebas no utilizan necesariamente los mismos arneses, conviene usarlos para crear una lista de candidatos, no para tomar la decisión definitiva.
La evidencia independiente ofrece una imagen menos contundente. En su prueba del 27 de agosto con 30 tareas de agentes de varios pasos, Composio registró 21/30 tareas completadas por GLM-5.3-Flash y 20/30 por DeepSeek V4 Flash. DeepSeek fue el más rápido en 19 de 30 tareas, mientras que el coste comunicado por tarea completada con éxito fue de aproximadamente 0,028 $ para DeepSeek frente a unos 0,06 $ para GLM. Estas cifras proceden de la prueba de Composio, no de ninguno de los dos proveedores.
Para agentes centrados en la terminal, empezaría probando DeepSeek V4 Flash si las prioridades son la velocidad, la reproducibilidad y contar con una ruta inicial fácil de justificar. GLM merece entrar en la comparación cuando la calidad de reparación en el primer intento o un comportamiento más amplio con herramientas justifiquen medirlo frente a ese coste inferior.
Herramientas, estados del navegador y feedback visual
GLM encaja mejor cuando el agente tiene que inspeccionar el resultado que ha producido su propio código. Z.ai describe un ciclo en el que el modelo lee capturas o interfaces renderizadas, modifica la implementación y vuelve a comprobar el resultado. Este enfoque sirve para convertir capturas en código, depurar frontends, usar el navegador, trabajar con documentos y abordar algunos flujos 3D.
DeepSeek puede encargarse del trabajo de agentes basado en texto y código mediante deepseek-v4-flash; la entrada visual requiere la ruta independiente deepseek-v4-flash-vision-exp. Si tu pipeline ya cuenta con enrutamiento de visión, esta separación puede ser aceptable. Pero si el agente alterna entre código fuente, una captura del navegador y vídeo sin cambiar de endpoint, GLM resulta más sencillo. La guía de la API DeepSeek V4 Flash Vision Exp explica esa alternativa.
Lo que cuentan los usuarios después de los benchmarks
La evidencia de la comunidad apunta a un intercambio de ventajas, no a un ganador universal. Un informe de usuario tras dos días describió GLM como competente con contextos pequeños, pero menos estable a medida que crecía el prompt, aunque destacó su compatibilidad con imágenes:
“Cuando crece demasiado, empieza a comportarse de forma ansiosa y descuidada”. — @XBToshi, sobre dos días de uso intensivo de GLM-5.3-Flash en una comparativa publicada
Es una observación anecdótica, no una tasa de fallos. Aun así, señala un problema que las tablas de benchmarks no reflejan: una ventana de contexto grande no garantiza un comportamiento estable en agentes con múltiples turnos.
Un pequeño experimento con Ollama también favoreció a DeepSeek en las unidades de cuota específicas del proveedor, aunque su autor no equiparó esas unidades al coste en dólares de la API.
La latencia y la evidencia del servicio cambian la respuesta
No se ha publicado una comparación de latencia p50 ni de rendimiento mediante el mismo arnés para estos modelos exactos; no extrapoles resultados de Pro, Vision-Exp u otras rutas. Composio encontró que DeepSeek fue el más rápido en 19/30 tareas de agentes, una señal útil, aunque no equivale a una medición de throughput. Para asistentes interactivos, mide el tiempo hasta la primera llamada útil a una herramienta; para trabajos por lotes, mide el tiempo total hasta obtener un resultado aceptado.
El precio por token no equivale al coste por tarea completada
Las tarifas oficiales ofrecen una conclusión más matizada que “DeepSeek es más barato”. Z.AI anuncia una promoción del 50% para GLM-5.3-Flash hasta el 9 de septiembre de 2026 a las 24:00 UTC+8. DeepSeek, por su parte, separa los precios de los aciertos y fallos de caché, además de distinguir entre horas punta y horas valle.
Todas las cifras siguientes están expresadas en dólares estadounidenses por cada millón de tokens.
| Concepto de facturación | Promoción de GLM-5.3-Flash | Tarifa estándar de GLM-5.3-Flash | DeepSeek V4 Flash fuera de horas punta | DeepSeek V4 Flash en horas punta |
|---|---|---|---|---|
| Entrada nueva/sin acierto de caché | $0.075 | $0.15 | $0.22 | $0.44 |
| Entrada almacenada en caché | $0.015 | $0.03 | $0.007 | $0.014 |
| Salida | $0.25 | $0.50 | $0.66 | $1.32 |
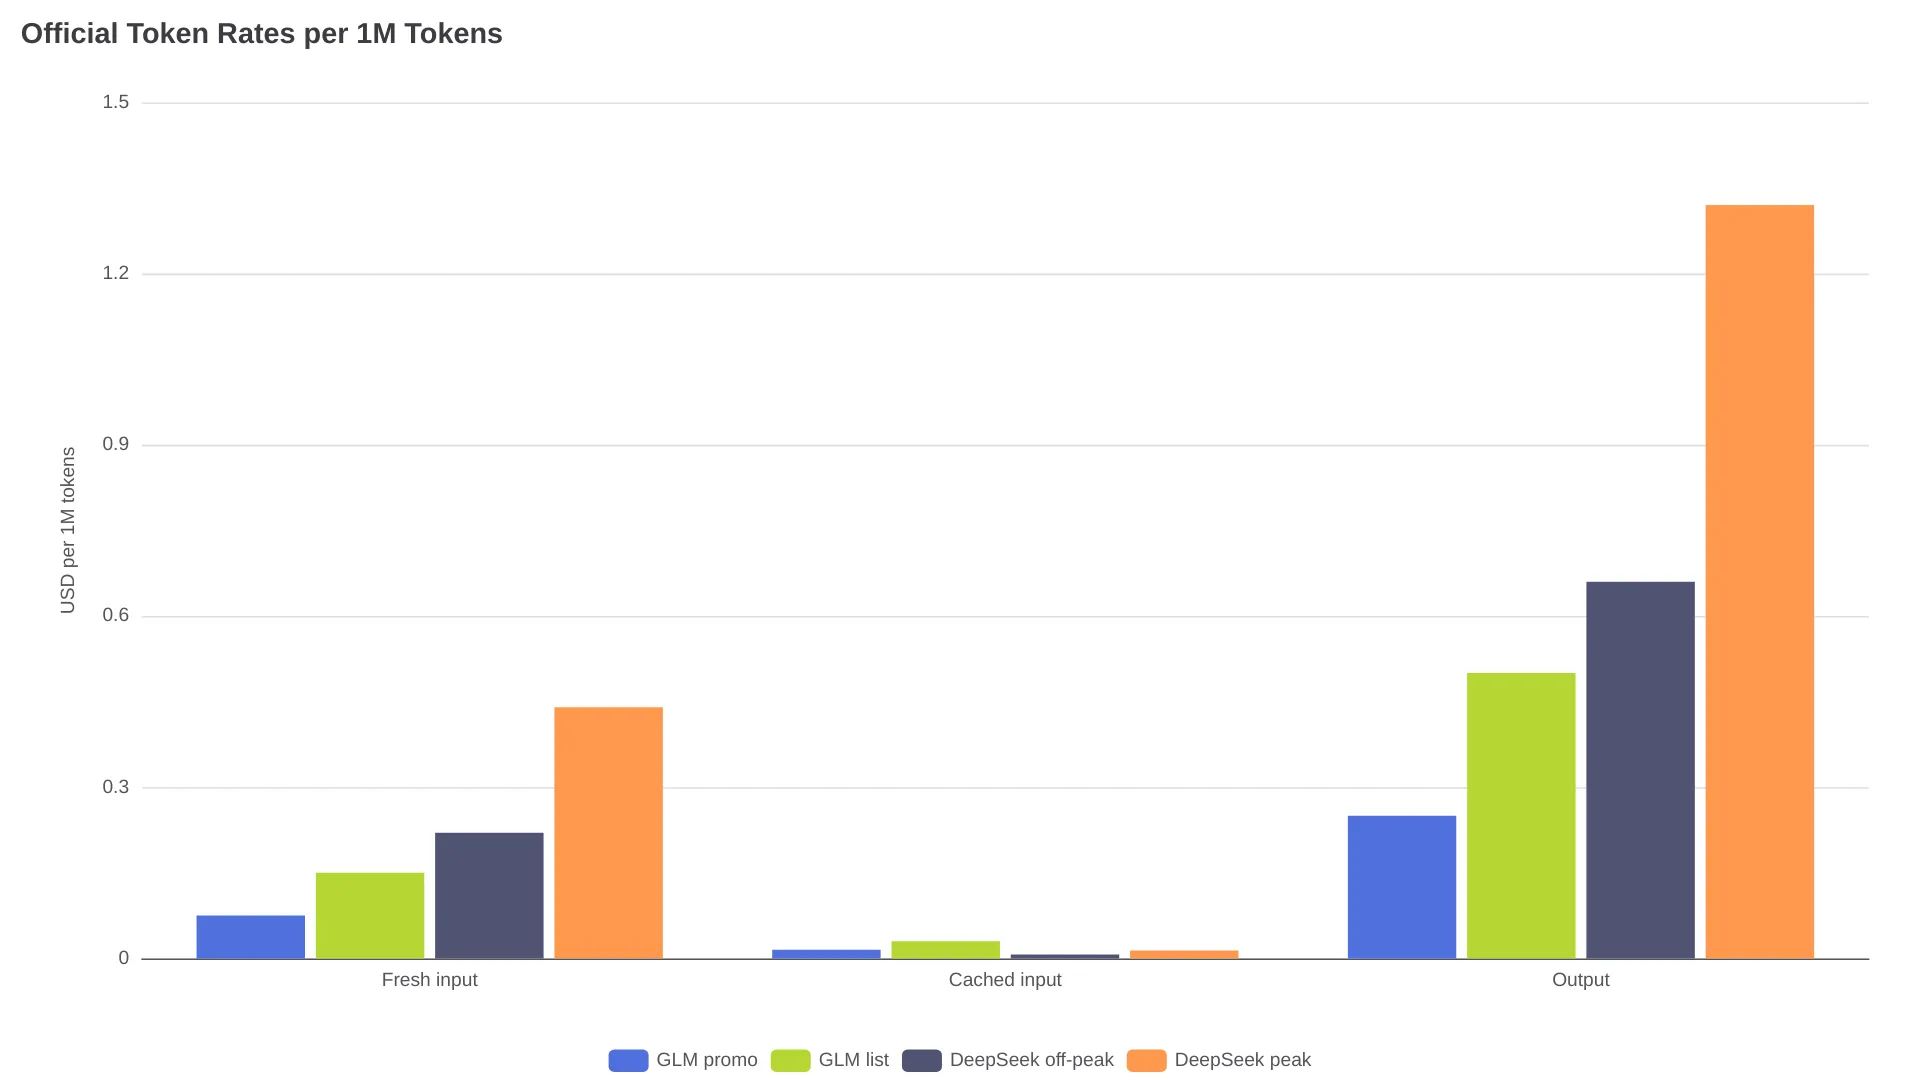
Las franjas punta de DeepSeek son 01:00–04:00 UTC y 06:00–10:00 UTC, de lunes a viernes; el resto del tiempo se considera fuera de horas punta. Su tabla oficial también indica una concurrencia de 2.500 para V4 Flash. La página de precios de GLM menciona almacenamiento de entradas en caché gratuito por tiempo limitado, pero no ofrece allí una cifra universal de concurrencia.
- DeepSeek gana en precio para entradas en caché durante todos los periodos comparables.
- La promoción de GLM gana en precio para entradas nuevas y salidas frente a las tarifas oficiales de DeepSeek para fallos de caché y salidas.
- Una vez terminada la promoción, las tarifas estándar de GLM para entradas nuevas y salidas siguen por debajo de las tarifas de DeepSeek fuera de horas punta.
- El mejor argumento económico de DeepSeek aparece en cargas con mucho uso de caché, dominadas por las entradas y con salidas cortas, sobre todo si pueden programarse fuera de las horas punta.
Ejemplo con 10M de tokens de entrada y 2M de salida
Supongamos 10 millones de tokens de entrada nuevos y 2 millones de tokens de salida, sin costes de herramientas ni reintentos:
| Modelo y ruta de facturación | Cálculo | Total |
|---|---|---|
| Promoción de GLM | 10 × $0.075 + 2 × $0.25 | $1.25 |
| Tarifa estándar de GLM | 10 × $0.15 + 2 × $0.50 | $2.50 |
| DeepSeek fuera de horas punta, fallo de caché | 10 × $0.22 + 2 × $0.66 | $3.52 |
| DeepSeek en horas punta, fallo de caché | 10 × $0.44 + 2 × $1.32 | $7.04 |
Si los 10 millones de tokens de entrada son aciertos de caché, el total de DeepSeek fuera de horas punta baja a $1.39 (10 × $0.007 + 2 × $0.66), mientras que el total promocional de GLM queda en $0.65 (10 × $0.015 + 2 × $0.25). La ventaja de DeepSeek en caché gana importancia cuando la proporción entre entradas y salidas es mucho mayor y las salidas son cortas.
Cuándo el menor coste de DeepSeek resulta decisivo
Elige DeepSeek V4 Flash cuando la mayoría de las peticiones reutilice un prefijo largo y estable del sistema o del repositorio, genere respuestas cortas y pueda ejecutarse fuera de las horas punta. La clasificación, la extracción, los resúmenes y la automatización rutinaria basada solo en texto encajan mejor en este patrón que los agentes guiados por capturas.
Cuándo la capacidad adicional de GLM puede reducir el coste total
GLM puede abaratar el pipeline cuando una imagen, un documento o un vídeo exigirían de otro modo una petición de visión independiente. Su tarifa promocional de salida también importa en agentes que generan parches de código largos. Comprueba esta hipótesis con los tokens facturados, los ciclos de reparación y la tasa de tareas aceptadas; no des por hecho que siempre ofrecerá un coste menor por tarea.
El contexto largo es una cifra de capacidad, no una garantía de calidad
La documentación oficial de ambos modelos indica una ventana de contexto de 1M de tokens, así que el tamaño del contexto acaba en empate. DeepSeek especifica una salida máxima de 384K, mientras que la documentación de modelos de Z.AI indica una salida máxima de 128K para GLM-5.3-Flash. La diferencia solo resulta relevante en aplicaciones que permitan generaciones excepcionalmente largas.
Z.ai afirma que GLM ofrece una computación de atención 3,01 veces menor y un tamaño de caché KV 4,44 veces menor que GLM-5.3, aunque también señala que la caché KV de GLM sigue siendo ligeramente superior a la de DeepSeek V4 Flash. Estas afirmaciones del proveedor no demuestran una ventaja de latencia ni de calidad de recuperación frente a DeepSeek.
Prueba la recuperación, la finalización de herramientas y la tasa de tareas aceptadas con 50K, 200K y el tamaño máximo real de tus prompts, aplicando la regla de aceptación de la siguiente lista de control.
Elige un modelo por defecto o enruta ambos
| Carga de trabajo | Primer modelo que probar | Alternativa o escalado |
|---|---|---|
| Clasificación y extracción basadas solo en texto | DeepSeek V4 Flash | GLM si falla el formato o la calidad |
| Chat con repositorios y mucho uso de caché | DeepSeek V4 Flash | GLM para los turnos de reparación más difíciles |
| Agente de programación en terminal | DeepSeek V4 Flash | GLM cuando importe más completar la tarea al primer intento |
| Conversión de capturas en código | GLM-5.3-Flash | DeepSeek para el trabajo posterior basado solo en texto |
| Agente de navegador o de uso del ordenador | GLM-5.3-Flash | DeepSeek para los pasos de planificación no visuales |
| Análisis basado en vídeo, imágenes o archivos | GLM-5.3-Flash | DeepSeek Vision Exp si aceptas utilizar una ruta separada |
| Texto largo con salida corta | DeepSeek V4 Flash | GLM si la recuperación se degrada |
| Generación de código largo durante la promoción | GLM-5.3-Flash | DeepSeek cuando domine la economía de los aciertos de caché |
Antes de cambiar una carga de producción, ejecuta una prueba breve con el mismo arnés:
- Fija los identificadores exactos:
glm-5.3-flashydeepseek-v4-flash; no permitas que un router sustituya silenciosamente estos modelos por Pro o Vision-Exp. - Utiliza entre 20 y 50 tareas reales que incluyan trabajos completados con éxito y fallos recientes. Si el producto utiliza agentes, incluye al menos cinco tareas con uso de herramientas.
- Registra la tasa de éxito, los ciclos de reparación, las llamadas a herramientas omitidas, el tiempo hasta la primera acción útil, el total de tokens de entrada y salida y la proporción de aciertos de caché.
- Compara el coste por tarea aceptada y conserva el otro modelo como alternativa hasta que las tasas de timeout y de fallos sean estables.
La guía de inicio rápido de Z.AI y la guía de DeepSeek para realizar la primera llamada a la API documentan el acceso compatible con OpenAI; sus controles de razonamiento, rutas de visión y semántica de facturación no son idénticos.
Preguntas que aún se hacen los compradores
¿GLM-5.3-Flash es el mismo modelo que Ox Alpha?
Z.ai identificó oficialmente GLM-5.3-Flash como el modelo que había probado de forma anónima bajo el nombre Ox Alpha. El enrutamiento, las cuotas y el comportamiento del endpoint durante la fase preliminar no deben considerarse especificaciones permanentes del modelo público.
Utiliza la tabla de enrutamiento y valida después el modelo predeterminado con identificadores fijados, casos de fallo reales y el mismo arnés. La reseña de GLM-5.3-Flash analiza la identidad y la evidencia de despliegue; la guía de la API DeepSeek V4 Flash Vision Exp cubre la ruta visual independiente.