 AIREITER
Antes de su presentación oficial, un modelo anónimo circulaba bajo el nombre de Ox Alpha. Z.ai acaba de ponerle nombre público a aquel experimento: GLM-5.3-Flash. La revelación es importante, aunque conviene interpretar con cuidado la etiqueta “Flash”: el modelo activa 18B parámetros por token, pero el checkpoint publicado ronda los 320B y sigue exigiendo un hardware considerable para ejecutarlo en local.
En resumen: Ox Alpha era la vista previa de GLM-5.3-Flash
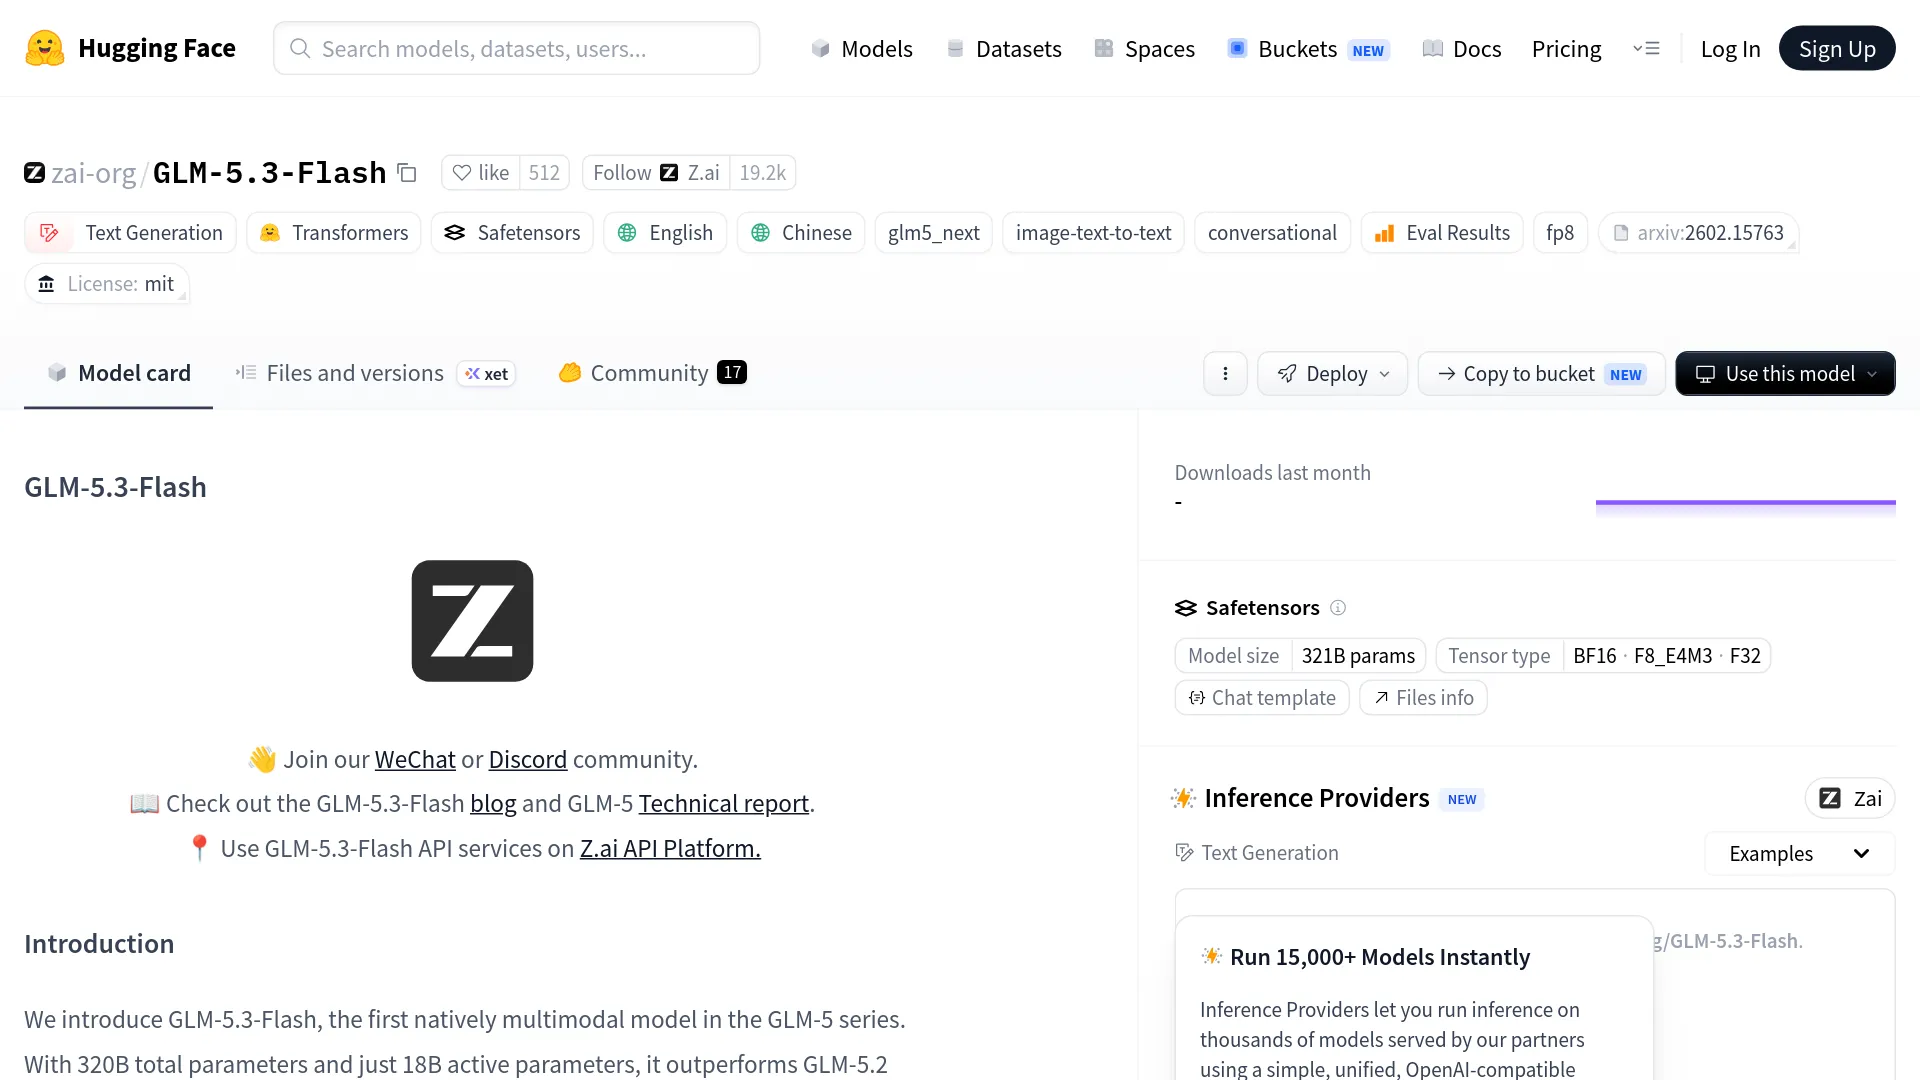
En su anuncio del 26 de agosto de 2026, Z.ai identifica GLM-5.3-Flash como el modelo que había probado de forma anónima bajo el nombre de Ox Alpha en OpenCode y OpenRouter. La ficha del modelo en Hugging Face ya incluye el checkpoint público, la licencia MIT, las entradas multimodales y referencias para ejecutarlo en local.
Los informes sobre Ox Alpha deben entenderse como evidencias de una fase preliminar, no como especificaciones del modelo comercializado. Ox Alpha tenía sus propias condiciones de enrutamiento, tráfico y operación, por lo que los primeros comentarios sobre velocidad, cuotas o políticas podrían no aplicarse a todos los endpoints de GLM-5.3-Flash.
“Para mí no ha cambiado nada. Ambos modelos son demasiado grandes para mi sistema con 32 GB de RAM.” — u/dampflokfreund en r/LocalLLaMA
GLM-5.3-Flash, de un vistazo
| Especificación | GLM-5.3-Flash |
|---|---|
| Lanzamiento oficial | 26 de agosto de 2026 |
| Nombre de la vista previa | Ox Alpha / ox-alpha |
| Arquitectura | 320B parámetros totales, 18B activos por token |
| Ventana de contexto | 1.048.576 tokens (1M) |
| Entrada | Texto, imágenes y vídeo |
| Salida | Texto |
| Licencia | MIT |
| Checkpoint oficial | zai-org/GLM-5.3-Flash |
| Precio publicado de entrada en la API | $0.15 por 1M de tokens |
| Precio publicado de entrada en caché | $0.03 por 1M de tokens |
| Precio publicado de salida en la API | $0.50 por 1M de tokens |
La página de Hugging Face muestra un tamaño almacenado de aproximadamente 321B parámetros, mientras que la descripción del modelo utiliza la denominación abreviada 320B-A18B. Ambas cifras describen cosas distintas: la capacidad total almacenada y el cálculo activo por token, respectivamente. Que haya 18B parámetros activos no convierte el checkpoint en un modelo local de 18B.
Qué cambió entre Ox Alpha y el modelo público
Z.ai afirma que ejecutó GLM-5.3-Flash de forma anónima bajo el nombre de Ox Alpha antes del lanzamiento público, utilizando OpenCode y OpenRouter para recopilar impresiones de uso real. La ficha de OpenRouter presentaba aquella vista previa como un modelo multimodal y de contexto largo, con un precio temporal de $0. El lanzamiento público permite ahora atribuir el proveedor, el checkpoint y la licencia.
La vista previa y el modelo comercializado siguen siendo entornos operativos distintos. Que coincidan el tokenizador o ciertos errores de una API al estilo de GLM puede apuntar a un mismo origen, pero no demuestra que todas las peticiones anónimas utilizaran los pesos finales ni la misma capa de enrutamiento. Para el despliegue y la reproducibilidad, la referencia válida es ahora el checkpoint público.
La arquitectura que hay detrás de la etiqueta “Flash”
GLM-5.3-Flash combina una arquitectura dispersa de mezcla de expertos con cambios en el mecanismo de atención pensados para reducir el coste de los contextos muy largos. Z.ai habla de 320B parámetros totales, 18B parámetros activos, 45 capas, atención híbrida dispersa y lineal, recuperación IndexPool y Manifold-Constrained Hyper-Connections (mHC). La ficha del modelo también atribuye su entrenamiento a un corpus multimodal de preentrenamiento de 30T tokens.
Z.ai asegura que, con un contexto de 1M, GLM-5.3-Flash utiliza 3 veces menos cálculo de atención y una caché KV 4,4 veces más pequeña que GLM-5.3. Son afirmaciones arquitectónicas del fabricante, no una garantía de latencia independiente del hardware: la velocidad real seguirá dependiendo de la longitud del contexto, la concurrencia, el preprocesado visual y la pila de inferencia.
La multimodalidad nativa del modelo resulta especialmente interesante para agentes, más que para presentarlo simplemente como otro “chatbot con visión”. El flujo de trabajo que plantea Z.ai permite que un agente inspeccione interfaces renderizadas, estados del navegador, documentos u otros elementos visuales y, a continuación, modifique el código o el resultado generado. La ficha oficial demuestra la entrada de imágenes, mientras que la documentación pública del modelo y del despliegue también describe la entrada de vídeo.
Qué demuestran los benchmarks y qué no
El lanzamiento oficial y la ficha del modelo muestran resultados sólidos, especialmente en programación y tareas de agentes. Entre las cifras visibles en la ficha aparecen 84,3 en TerminalBench 2.1, 63,4 en DeepSWE y 55,3 en HLE. El material de lanzamiento de Z.ai también informa de una puntuación de 57 en el Artificial Analysis Intelligence Index, 48,8 en AutomationBench y 29,0 en Z.ai Code Bench con el máximo nivel de esfuerzo.
| Benchmark | GLM-5.3-Flash | Comparativa o referencia | Fuente y limitación |
|---|---|---|---|
| TerminalBench 2.1 | 84,3 | GLM-5.2: 81,0; Claude Opus 4.8: 85,0 | Resultado de Z.ai/la ficha del modelo; el entorno de evaluación y los presupuestos importan |
| DeepSWE v1.1 | 63,4 | GLM-5.2: 46,2 | Evaluación publicada; no debe generalizarse a cualquier repositorio |
| AutomationBench | 48,8 | GLM-5.2: 26,2 | Evaluación publicada con una versión concreta del benchmark |
| Z.ai Code Bench, máximo esfuerzo | 29,0 | Claude Opus 4.8: 29,5 | Resultado prácticamente empatado bajo la configuración de Z.ai |
| Artificial Analysis Intelligence Index v4.1.1 | 57 | Z.ai afirma que es comparable a Claude Opus 4.8 | Índice externo; la mezcla de tareas no equivale a una puntuación exclusiva de programación |
Los resultados publicados utilizan distintos entornos de evaluación, límites de contexto, tiempos de espera y jueces. Lo razonable es compararlos como indicadores generales, no como posiciones dentro de una clasificación universal. La conclusión más sólida es que GLM-5.3-Flash cuenta con evidencias creíbles de una mejora importante frente a GLM-5.2 en evaluaciones de agentes de programación, no que supere a todos los modelos punteros en cualquier tarea.
La misma cautela se aplica a las primeras pruebas de la comunidad. @prz_chojecki informó de que Ox Alpha obtuvo mejores resultados que GLM-5.2 en los 226 problemas de ErdosBench. Es un dato útil para definir casos de prueba, pero no sustituye a una evaluación controlada con tus propias herramientas y repositorio.
Los límites prácticos que encontraron los primeros usuarios
“Flash” describe de forma más fiable el cálculo activo y el posicionamiento de costes que la latencia interactiva. En los debates de usuarios de r/opencodeCLI se mencionaron tanto buenos resultados programando como esperas frustrantes, especialmente durante la vista previa anónima. Son observaciones específicas del proveedor y de la carga de trabajo, no benchmarks oficiales de latencia.
“¿Cómo puede llamarse ‘Flash’ si es mucho más lento que el modelo principal?” — u/ahriad en r/opencodeCLI
La señal operativa más útil es la fiabilidad de los agentes durante ejecuciones largas y con carga. @solomonneas informó de 30 compilaciones completadas en 49 intentos durante una prueba de siete días, con 14 fallos que llegaron en forma de tiempos de espera agotados. Esto no demuestra una tasa de fallos fija para la API oficial, pero sí justifica disponer de una ruta alternativa para las tareas que pueden prolongarse durante horas.
El modelo también tiene una limitación para el despliegue local que los titulares de los benchmarks suelen ocultar: el checkpoint oficial en FP8 ocupa aproximadamente 306 GiB antes de sumar la sobrecarga del entorno de ejecución y la caché KV. Por tanto, un modelo de 320B parámetros totales necesita una infraestructura con mucha memoria aunque solo active 18B parámetros en cada token.
Opciones de API, acceso alojado y despliegue local
Para el uso alojado, la página de precios de Z.ai sitúa GLM-5.3-Flash en $0.15 por 1M de tokens de entrada, $0.03 por 1M de tokens de entrada en caché y $0.50 por 1M de tokens de salida. Una promoción temporal del 50% fija los precios en $0.075 para la entrada, $0.015 para la entrada en caché y $0.25 para la salida, y termina a las 24:00 del 9 de septiembre de 2026, UTC+8. Consulta la tabla oficial de precios de Z.AI antes de preparar el presupuesto, ya que la promoción tiene una fecha de finalización.
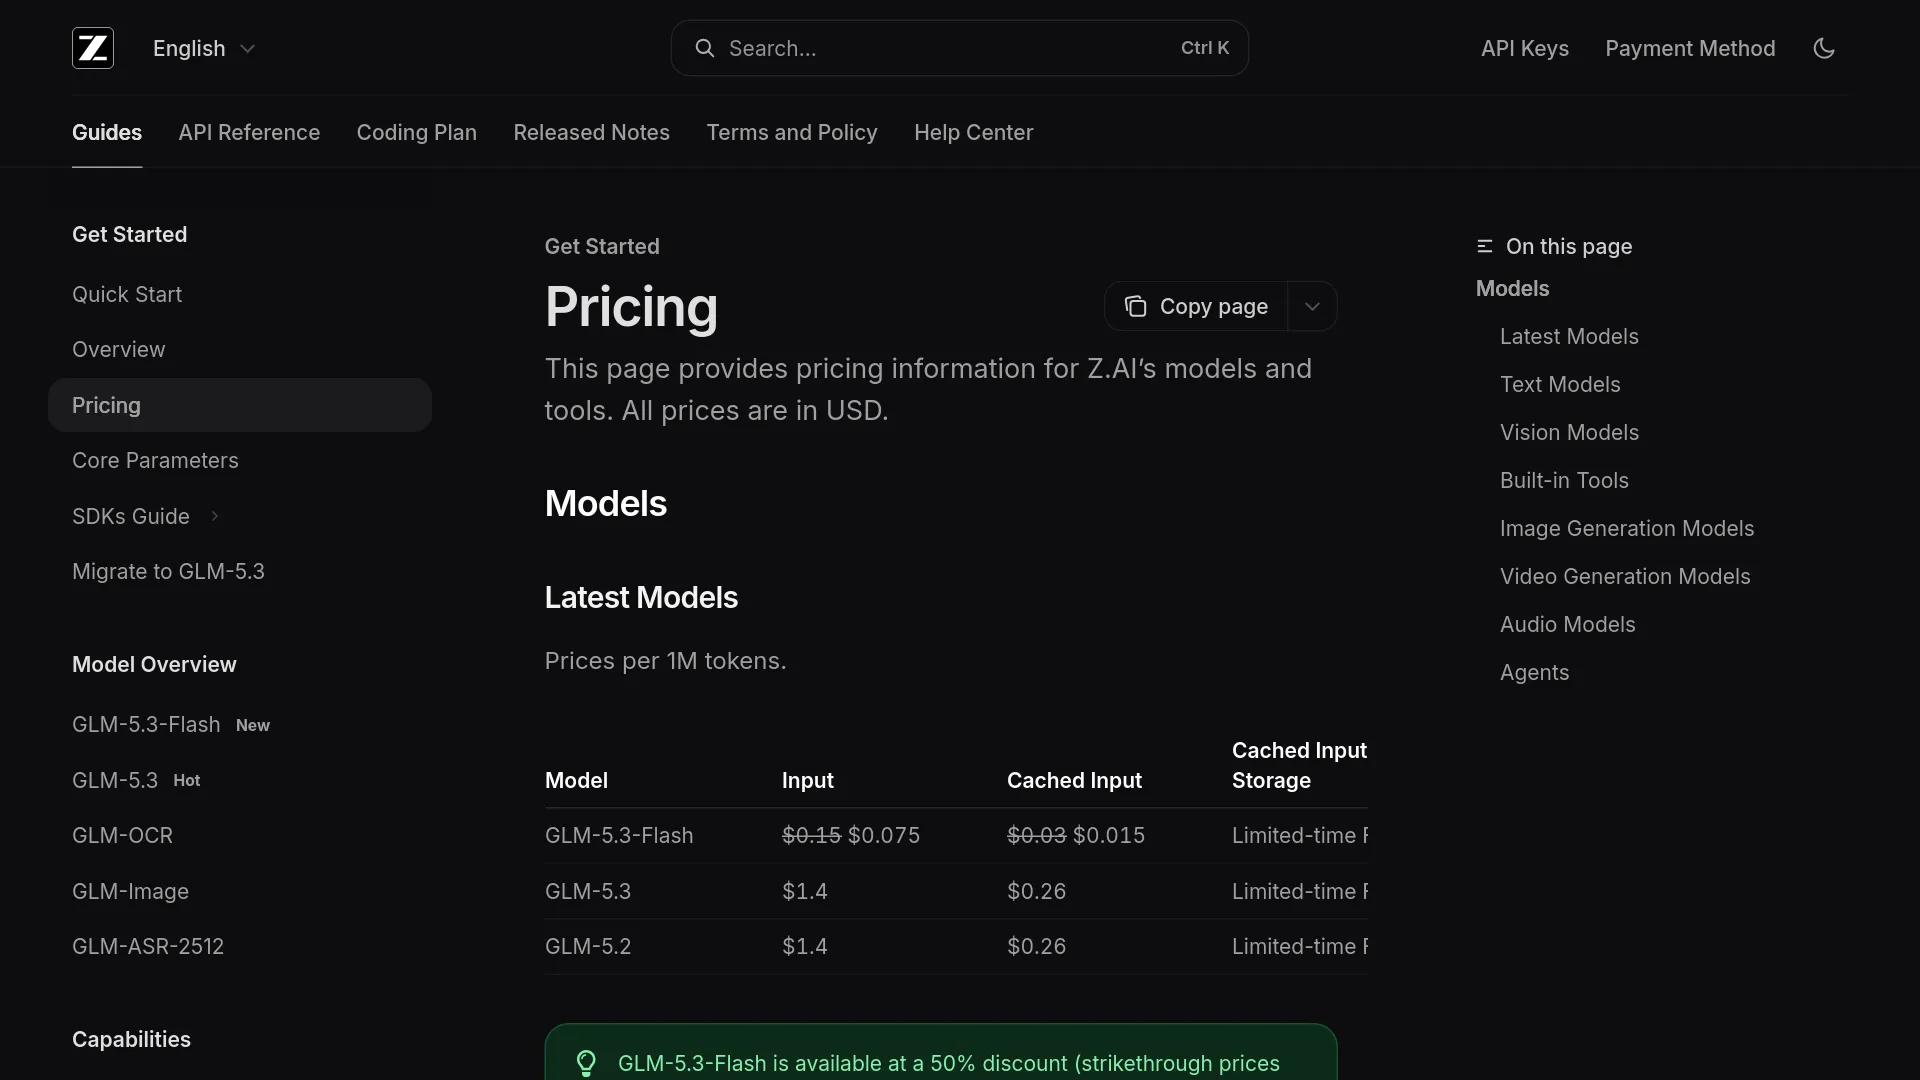
El precio oficial de la API es independiente del precio temporal de la vista previa de Ox Alpha. Como ejemplo sencillo, 10M tokens de entrada más 2M tokens de salida costarían $2.50 al precio estándar, antes de cualquier otra tarifa del proveedor: 10 × $0.15 + 2 × $0.50. La entrada en caché puede reducir la parte correspondiente a la entrada cuando el proveedor factura esos tokens como almacenados en caché.
Ejecutarlo en local es posible, pero se trata más de un proyecto de infraestructura que de una descarga para el portátil. La receta oficial de vLLM indica aproximadamente 306 GiB para los pesos en FP8 y 386GB de VRAM para el despliegue FP8 predeterminado; para BF16 se indican 772GB. En la ruta compatible actual se necesitan GPU NVIDIA Hopper o posteriores, una versión reciente de FlashInfer y una imagen dedicada de vLLM mientras la integración sigue madurando.
El tutorial de KTransformers documenta la inferencia heterogénea entre CPU y GPU, el uso directo de los pesos oficiales en FP8 y al menos 350GB de memoria libre del sistema. Su ejemplo con una sola GPU utiliza una configuración con descarga parcial; no demuestra que una única GPU de consumo pueda alojar el modelo completo. El tutorial también utiliza un ajuste validado de 501.025 tokens y limita cada petición multimodal a ocho imágenes o un vídeo.
| Ruta de despliegue | Qué permite la documentación | Principal limitación |
|---|---|---|
| API de Z.ai | Acceso alojado con facturación por uso; tarifas estándar y promocionales publicadas | Verifica los límites de frecuencia, las condiciones regionales y la promoción vigente |
| vLLM | Inferencia FP8/BF16, endpoint compatible con OpenAI, paralelismo de tensores y ruta multimodal | Infraestructura NVIDIA con mucha memoria; la receta actual está orientada a Hopper+ |
| KTransformers | Inferencia heterogénea entre CPU y GPU y carga en FP8 | Aproximadamente 306 GiB para los pesos; se recomiendan al menos 350GB de memoria del sistema |
| Ecosistema Ollama/LM Studio/llama.cpp | La ficha del modelo enlaza a distribuciones cuantizadas y herramientas compatibles | La compatibilidad y la velocidad dependen de la compilación concreta |
Quién debería usar GLM-5.3-Flash ahora
Úsalo para agentes de programación sensibles al coste y pilotos de ingeniería con contexto largo. El precio oficial bajo, el contexto de 1M y la mejora publicada frente a GLM-5.2 lo convierten en un candidato sólido para analizar repositorios, modificar varios archivos, generar pruebas y lanzar llamadas repetidas a un agente. Mantén pruebas de aceptación y un modelo alternativo hasta que la tasa de éxito en tu entorno sea estable.
Úsalo para trabajos técnicos multimodales cuando los modelos GLM de solo texto sean el cuello de botella. La entrada de imágenes y vídeo puede ayudar a un agente a inspeccionar la salida de un navegador, diseños de interfaz, diagramas, documentos y elementos renderizados. El modelo no genera vídeo: razona sobre entradas visuales y devuelve texto o código.
No lo elijas solo porque “18B activos” suene a modelo de escritorio. El checkpoint completo ronda los 320B parámetros, y ejecutarlo en local requiere cientos de gigabytes de almacenamiento o memoria antes de añadir la sobrecarga del contexto y del entorno de ejecución. La API alojada suele ser la opción económica más sencilla, salvo que ya dispongas de hardware de inferencia con mucha memoria.
No envíes código confidencial a un endpoint de vista previa que no hayas verificado. El lanzamiento público de GLM-5.3-Flash es atribuible a Z.ai, pero siguen importando las condiciones del proveedor, la retención de datos y el enrutamiento. Para tráfico de producción, registra la política de datos vigente del endpoint y utiliza la API oficial o un proveedor cuyas condiciones operativas puedas auditar.
Preguntas frecuentes
¿Ox Alpha es exactamente lo mismo que GLM-5.3-Flash?
Z.ai identifica oficialmente GLM-5.3-Flash como el modelo que se había probado anteriormente bajo el nombre de Ox Alpha. El comportamiento inicial de Ox Alpha sigue siendo un contexto útil, pero el enrutamiento y los límites de aquella vista previa no deben tratarse como especificaciones del modelo público.
¿GLM-5.3-Flash es de código abierto?
El checkpoint oficial de Hugging Face se publica bajo la licencia MIT y Z.ai ofrece referencias para ejecutarlo en local. La descripción operativa más precisa es “pesos abiertos”: los pesos están disponibles, pero ejecutar el modelo completo sigue requiriendo una infraestructura considerable.
¿Cuánta memoria necesita GLM-5.3-Flash para ejecutarse en local?
Los pesos oficiales en FP8 ocupan aproximadamente 306 GiB antes de sumar la sobrecarga del entorno de ejecución y la caché KV. La receta de vLLM indica 386GB de VRAM para su despliegue FP8 predeterminado, mientras que KTransformers recomienda al menos 350GB de memoria del sistema para la inferencia heterogénea.
¿La API cuesta realmente $0.15 por cada millón de tokens de entrada?
Sí. La página oficial de precios de Z.AI indica $0.15 para la entrada, $0.03 para la entrada en caché y $0.50 para la salida; la promoción del 50% figura como válida hasta el 9 de septiembre de 2026, UTC+8.
¿GLM-5.3-Flash es más rápido que otros modelos Flash?
Los datos disponibles no permiten establecer una clasificación universal de latencia. Los primeros usuarios informaron de sesiones de agentes lentas o interrumpidas por tiempos de espera, así que mide el tiempo hasta el primer token, el tiempo total de finalización, los reintentos y la tasa de tareas aceptadas en tu propia ruta de proveedor.
¿GLM-5.3-Flash admite imágenes y vídeo?
Sí. Z.ai y la ficha oficial del modelo describen entradas de texto, imagen y vídeo, con salida de texto. La documentación para ejecutarlo en local añade límites por petición, como un máximo de ocho imágenes o un vídeo en la configuración documentada de KTransformers.
Utiliza la API alojada si quieres aprovechar el coste y la multimodalidad de GLM-5.3-Flash sin comprar un equipo de inferencia con varios cientos de gigabytes; prueba el despliegue local solo si ya cuentas con esa infraestructura. Para trabajos largos de agentes, conserva una alternativa probada: las evidencias públicas son más contundentes sobre sus capacidades y precio que sobre su fiabilidad interactiva sostenida.