 AIREITER
Si estás buscando alternativas a GLM-5-3-Flash, seguramente no necesitas otra explicación sobre la aparición de Ox Alpha. Lo que necesitas es sustituir una ruta de agente barata pero a veces lenta, evitar un checkpoint local de 320B o conservar el procesamiento multimodal sin rehacer tu cliente de API. La alternativa adecuada depende del problema que quieras resolver.
La respuesta rápida: elige según el fallo que quieras corregir
DeepSeek V4 Flash es la opción de texto más flexible cuando importan el precio de las coincidencias de caché, el modo opcional sin razonamiento y una alta concurrencia. Ofrece un contexto de 1M de tokens, un límite de concurrencia de 2.500 solicitudes y precios oficiales en horas valle de 0,22 $ por millón de tokens de entrada sin caché y 0,66 $ por millón de tokens de salida.
Qwen3.8-Flash es la alternativa alojada que conviene probar cuando necesitas entradas de imagen y vídeo, compatibilidad con la API y herramientas integradas. Su tarifa publicada es de 0,15 $ por millón de tokens de entrada y 0,47 $ por millón de tokens de salida.
GLM-5.3 es la vía de escalado dentro de la misma familia si quieres seguir con Z.ai pero necesitas su modelo de texto insignia. GPT-5.6 Terra y Claude Opus 4.8 son opciones premium para trabajos en los que completar una tarea adicional justifica pagar varias veces más. Kimi K3 aporta una opción con contexto de 1M, pero no es un sustituto barato.
La decisión no consiste en responder «¿qué modelo gana?». Se trata de optimizar el coste por token, la entrada visual, la programación de largo recorrido, el control local o la tasa de tareas aceptadas.
El endpoint de Ox Alpha ha desaparecido: empieza por identificar tu situación de migración
El anuncio oficial de Z.ai identificó la vista previa anónima de Ox Alpha como GLM-5.3-Flash el 26 de agosto de 2026. El lanzamiento público añadió un checkpoint con nombre, precios publicados, un modelo de Hugging Face con licencia MIT y acceso documentado mediante API. El entorno de vista previa no debería tratarse como un contrato permanente del modelo: el enrutamiento, las cuotas, la latencia y el comportamiento de las políticas pueden diferir entre la vista previa y la API publicada.
Si alguna configuración sigue llamando a stealth/ox-alpha, el identificador público en OpenRouter es z-ai/glm-5.3-flash; las solicitudes directas a Z.ai utilizan la URL base general https://api.z.ai/api/paas/v4. Z.ai documenta un endpoint independiente para Coding Plan, https://api.z.ai/api/coding/paas/v4, así que no des por hecho que la ruta de suscripción y la API general tienen la misma facturación o los mismos límites.
La reseña de GLM-5.3-Flash en AIReiter cubre la referencia inicial, incluida la diferencia entre sus 18B parámetros activos y el checkpoint total de aproximadamente 320B. Este artículo responde a la siguiente pregunta: ¿qué deberías usar en su lugar cuando su coste, velocidad, hardware o fiabilidad ya no encajan?
«Para mí no ha cambiado nada. Los dos modelos son demasiado grandes para mi sistema con 32 GB de RAM». — u/dampflokfreund, r/LocalLLaMA
Alternativas comparadas por precio, contexto y vía de despliegue
Los precios siguientes son referencias publicadas por los proveedores y comprobadas el 28 de agosto de 2026. No forman parte de una única promoción: DeepSeek cambia sus tarifas entre las horas punta y las horas valle, mientras que el precio de Flash de Z.ai incluye un descuento temporal hasta el 9 de septiembre de 2026 a las 24:00 UTC+8.
| Modelo | Entrada / 1M tokens | Salida / 1M tokens | Contexto | Modalidades de entrada | Motivo principal para sustituirlo |
|---|---|---|---|---|---|
| DeepSeek V4 Flash | 0,22 $ valle; 0,44 $ punta | 0,66 $ valle; 1,32 $ punta | 1M | Texto | Enrutamiento de texto consciente de la caché y modo sin razonamiento |
| Qwen3.8-Flash | 0,15 $ | 0,47 $ | 1M | Texto, imagen, vídeo | Multimodalidad alojada y compatibilidad con la API |
| GLM-5.3 | 1,40 $ | 4,40 $ | 1M | Texto | Continuidad con el proveedor y modelo de mayor capacidad dentro de la familia |
| GPT-5.6 Terra | 2,00 $ | 12,00 $ | 1,05M | Texto | Mayor confianza en trabajos difíciles con agentes |
| Claude Opus 4.8 | 5,00 $ | 25,00 $ | 1M | Texto | Programación compleja y revisión con contexto largo |
| Kimi K3 | 3,00 $ | 15,00 $ | 1M | Texto | Trabajos que exigen capacidad y contexto largo |
Actualmente, Z.ai muestra GLM-5.3-Flash a 0,075 $ por millón de tokens de entrada, 0,015 $ por millón de tokens de entrada en caché y 0,25 $ por millón de tokens de salida durante su promoción del 50 %. Los precios de lista son 0,15 $, 0,03 $ en caché y 0,50 $. La gráfica comparativa utiliza el precio de lista, no la tarifa promocional temporal. (Precios de Z.ai)
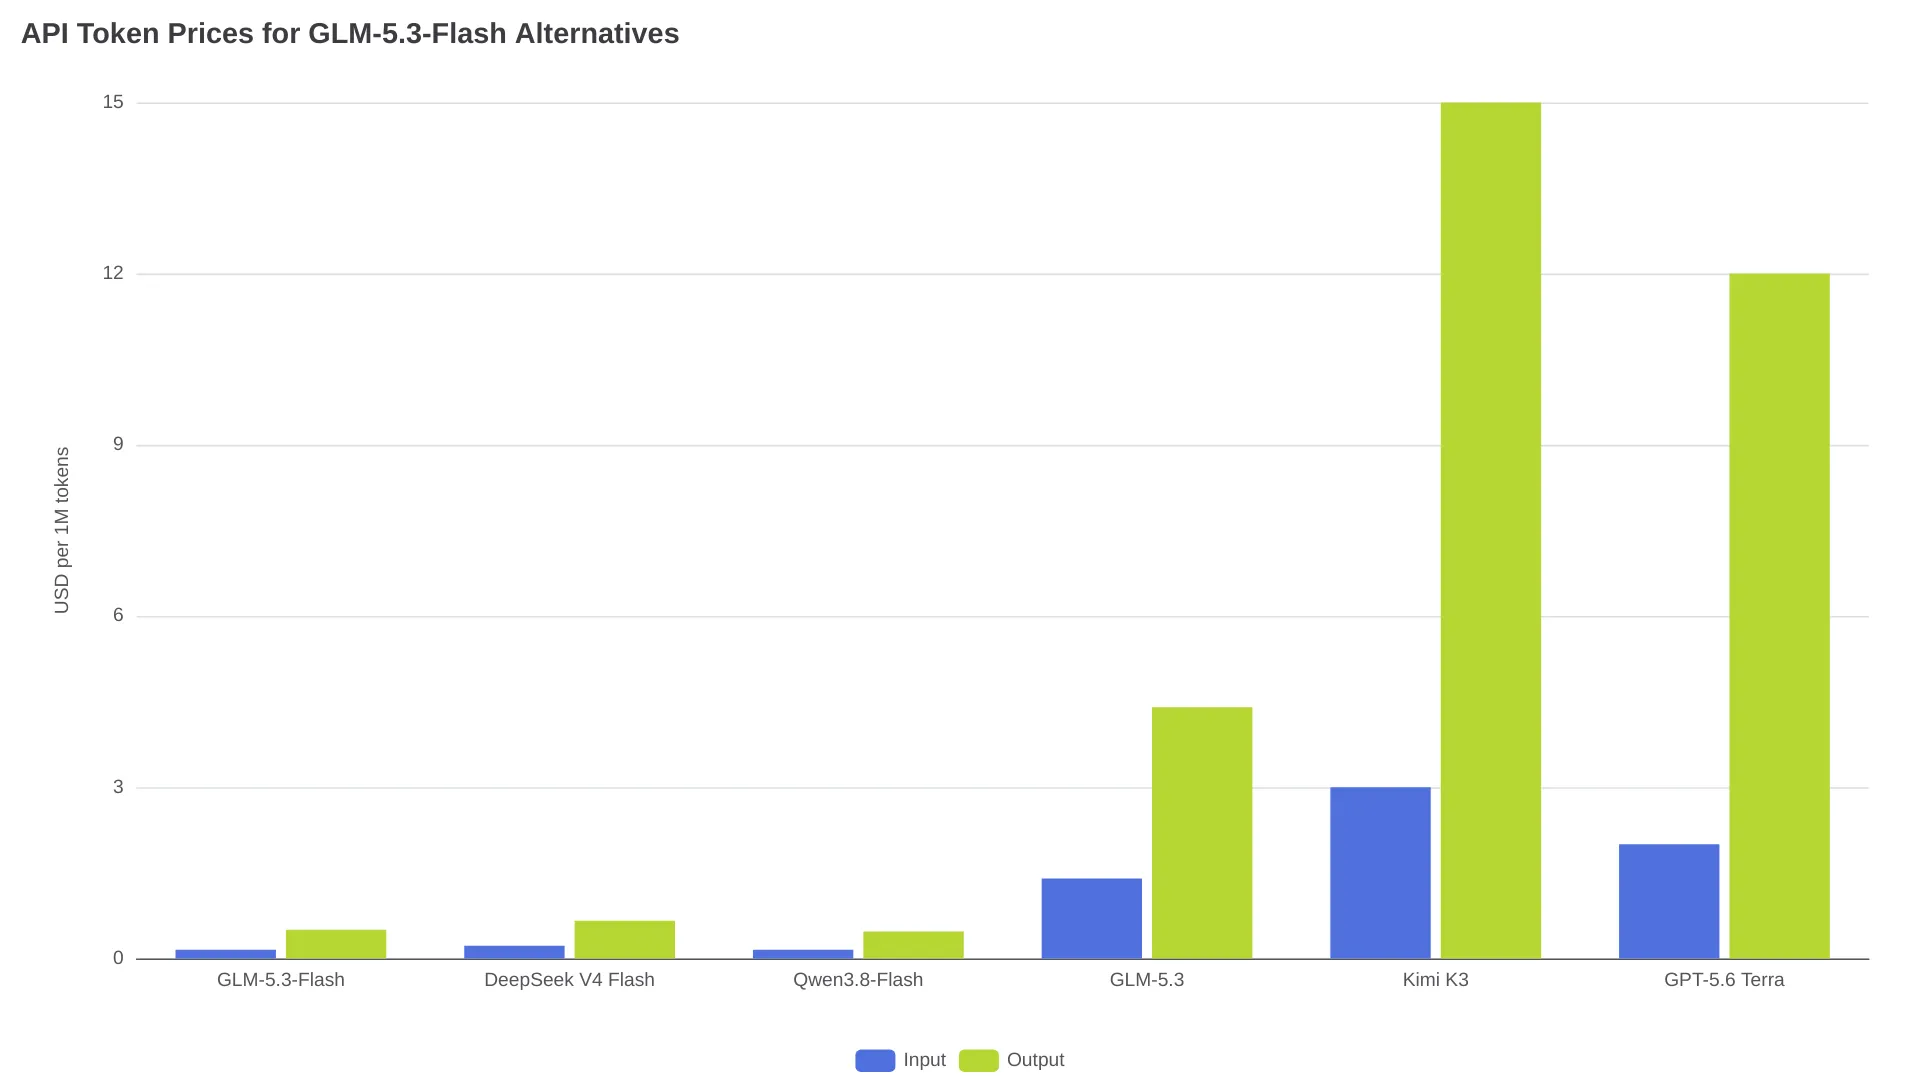
Base de precios: precio de lista de GLM-5.3-Flash, precio oficial de DeepSeek V4 Flash en horas valle y tarifas actuales publicadas por los proveedores para las demás filas. El precio de DeepSeek en horas punta duplica su tarifa de horas valle.
Las seis vías de sustitución que realmente merece la pena considerar
DeepSeek V4 Flash: texto y programación con una caché bien aprovechada
DeepSeek V4 Flash es el primer modelo que conviene probar cuando GLM-5.3-Flash sale demasiado caro para el tráfico de texto habitual. DeepSeek indica un contexto de 1M de tokens, una salida máxima de 384K, salida JSON, llamadas a herramientas, la Responses API y acceso compatible con Anthropic. Su límite oficial de concurrencia es de 2.500 solicitudes.
La diferencia en la facturación es importante. DeepSeek separa las coincidencias de caché de las solicitudes sin coincidencia y duplica las tarifas durante las franjas punta de los días laborables: de 01:00 a 04:00 y de 06:00 a 10:00 UTC. También admite modos con razonamiento y sin razonamiento, mientras que la ficha del modelo GLM-5.3-Flash documenta niveles de esfuerzo de razonamiento bajo, alto y máximo, en lugar de una opción sencilla sin razonamiento.
Elige DeepSeek V4 Flash para cargas con contexto repetido, chats intensivos en recuperación y programación basada únicamente en texto cuando te interesen las coincidencias de caché o controlar el razonamiento. Qwen3.8-Flash tiene tarifas publicadas más bajas para tokens nuevos, así que DeepSeek no es automáticamente la opción más barata para cualquier solicitud de texto. Tampoco es un sustituto visual directo: la entrada de imágenes pertenece a la ruta independiente deepseek-v4-flash-vision-exp de DeepSeek, y los tokens derivados de imágenes se facturan como entrada.
Qwen3.8-Flash: el sustituto multimodal alojado más cercano
Qwen3.8-Flash es la alternativa alojada más cercana que deberías probar si tu agente envía capturas de pantalla, gráficos o vídeos y quieres conservar una integración con forma de API. QwenCloud indica que admite entradas de imagen, texto y vídeo; un contexto de 1M de tokens; un máximo de entrada de 991K; y un máximo de salida de 131K. También admite APIs compatibles con OpenAI y Anthropic, herramientas, salidas estructuradas, caché, procesamiento por lotes, búsqueda web y ajuste fino.
El principal compromiso operativo está en la estructura de la caché. QwenCloud publica 0,016 $ por millón de tokens para lecturas de caché implícitas, 0,20 $ para crear caché y 0,47 $ para la salida. Sus límites publicados son de 2M de tokens por minuto y 15.000 solicitudes por minuto, pero la página no aclara si se aplican por cuenta, clave, organización o despliegue.
Escoge Qwen3.8-Flash cuando la entrada visual sea imprescindible o importe el precio de los tokens nuevos. La página oficial del modelo no ofrece una tabla de benchmarks con nombres, resultados de latencia ni un estudio de fiabilidad en sesiones largas, así que valida el modelo con tus propios registros de agentes en lugar de asumir que la paridad de funciones implica el mismo comportamiento.
GLM-5.3: el salto dentro de la familia cuando Flash se queda corto
GLM-5.3 no es la alternativa económica. Es el salto lógico cuando el problema es la falta de profundidad en trabajos de texto, no el precio o la multimodalidad. La tarifa de Z.ai muestra 1,40 $ por millón de tokens de entrada, 0,26 $ por millón de tokens de entrada en caché y 4,40 $ por millón de tokens de salida: aproximadamente un orden de magnitud por encima del precio de lista de Flash.
Z.ai presenta GLM-5.3 como su modelo insignia para programación, mientras que GLM-5.3-Flash es el modelo multimodal nativo de menor coste. Utiliza GLM-5.3 de forma selectiva para tareas difíciles centradas en texto; cambiar a este modelo puede eliminar el flujo de trabajo visual que hacía útil a Flash.
GPT-5.6 Terra: para ejecutar agentes con más garantías
GPT-5.6 Terra es una opción premium para equipos que priorizan completar tareas difíciles por encima de mantener bajas las tarifas por token. OpenAI publica un precio de 2 $ por millón de tokens de entrada, 0,20 $ por millón de tokens de entrada en caché y 12 $ por millón de tokens de salida, con una ventana de contexto de aproximadamente 1,05M de tokens. En la tabla de benchmarks publicada por Z.ai, GPT-5.6 Terra obtiene 87,4 en Terminal-Bench 2.1 y 69,6 en DeepSWE v1.1, por encima de los 84,3 y 63,4 de GLM-5.3-Flash en las configuraciones citadas.
Estas cifras justifican probar Terra cuando una tarea de programación fallida cuesta más que una factura de API elevada; no demuestran que sea superior en producción en todos los casos. Úsalo como nivel de escalado para cambios de alto valor en repositorios o trabajos autónomos complejos.
Claude Opus 4.8: para programación difícil y revisión con contexto largo
Claude Opus 4.8 cuesta 5 $ por millón de tokens de entrada y 25 $ por millón de tokens de salida con las tarifas globales estándar de Anthropic. Anthropic también publica 0,50 $ por millón de tokens para lecturas de caché y tarifas de procesamiento por lotes equivalentes a la mitad del precio estándar de entrada y salida.
En la tabla comparativa de Z.ai, Opus 4.8 supera a GLM-5.3-Flash en Terminal-Bench 2.1, Agents’ Last Exam, HLE with Tools y NL2Repo, mientras que Flash gana en varias pruebas centradas en herramientas y automatización. Ese reparto convierte a Opus en un modelo de escalado que conviene medir, no en una opción predeterminada para todo.
Kimi K3: para trabajos con contexto de 1M, no para inferencia barata
Kimi K3 aparece aquí porque responde a un motivo distinto para cambiar de modelo: quizá necesites una ruta con contexto de 1M para flujos largos de ingeniería de software o investigación. Kimi publica 0,30 $ por millón de tokens de entrada en caché, 3 $ de entrada y 15 $ de salida.
Con esas tarifas, elige Kimi K3 solo cuando su contexto y su perfil de capacidades justifiquen la prima. No es la respuesta a la pregunta «¿cómo reduzco mi factura de tokens?».
Elige la alternativa según el trabajo, no según el puesto en la clasificación
| Trabajo o limitación | Primer modelo que probar | Motivo |
|---|---|---|
| Clasificación o extracción masiva de texto | Qwen3.8-Flash | Tarifas publicadas más bajas para entrada y salida nuevas que DeepSeek V4 Flash en horas valle |
| Texto largo con prefijos repetidos | DeepSeek V4 Flash | Precios para coincidencias de caché y modo opcional sin razonamiento |
| Texto largo con entrada principalmente nueva | Qwen3.8-Flash | Tarifas publicadas más bajas para tokens nuevos |
| Capturas de pantalla, gráficos o vídeo en un flujo de API | Qwen3.8-Flash | Entrada nativa de imagen y vídeo, además de protocolos de API conocidos |
| Mismo ecosistema de Z.ai, pero con razonamiento de texto más exigente | GLM-5.3 | Mantiene el proveedor y sube de nivel dentro de la familia |
| Programación en la que fallar sale caro | GPT-5.6 Terra | Escalado premium con mejores puntuaciones de programación en las pruebas citadas |
| Revisión cuidadosa de código o planificación de repositorios | Claude Opus 4.8 | Razonamiento premium, además de opciones de caché y procesamiento por lotes |
| Trabajos de largo recorrido en los que el contexto importa más que el precio | Kimi K3 | Posicionamiento como modelo con contexto de 1M |
| Portátil convencional o estación de trabajo con 32GB | Empieza por una API alojada | GLM-5.3-Flash es un checkpoint de aproximadamente 320B parámetros totales, no un modelo local de 18B |
La limitación del despliegue local es considerable. El checkpoint oficial de GLM-5.3-Flash se describe como un modelo de aproximadamente 320B parámetros totales; la reseña de despliegue de AIReiter registra un tamaño de unos 306 GiB en FP8 y un despliegue predeterminado con vLLM de alrededor de 386GB de VRAM. La cuantización reduce las exigencias, pero no convierte el modelo en una descarga normal para un portátil.
Un patrón de migración más seguro para agentes
Mantén separado el adaptador del proveedor del enrutamiento de tareas y evalúa la alternativa con el trabajo que realmente importa.
- Conserva una única interfaz de solicitudes. Mantén la capa de mensajes, herramientas y salidas estructuradas compatible con OpenAI cuando el proveedor la admita. Trata los controles de razonamiento, las cargas visuales, las llamadas a herramientas, las salidas estructuradas y los límites de contexto como indicadores de capacidad, no como campos universales.
- Prueba tareas aceptadas, no solo texto generado. Registra si el código compila, si la llamada a la herramienta es válida, si se supera la comprobación visual y si la tarea termina sin reintentos. Una primera respuesta barata que necesita dos reintentos del tamaño de un repositorio puede no resultar más económica.
- Enruta según el modo de fallo. Envía el texto con contexto repetido a DeepSeek V4 Flash, las solicitudes multimodales a Qwen3.8-Flash y las tareas de programación de alto riesgo a GPT-5.6 Terra, Claude Opus 4.8 o GLM-5.3 según tus resultados de aceptación.
- Mantén una alternativa de respaldo. La reseña de AIReiter registra una prueba comunitaria de siete días con 30 compilaciones correctas de 49 intentos y 14 fallos por tiempo de espera. No es una tasa de fallo universal del proveedor, pero sí una razón suficiente para no ejecutar un agente de producción con una única ruta.
- Haz el presupuesto con los precios normales. La promoción de Flash de Z.ai termina el 9 de septiembre de 2026. Las tarifas de DeepSeek cambian según la franja punta. La creación de caché y las lecturas de caché de Qwen tienen precios distintos. Una migración que solo funciona con una tarifa temporal no constituye un modelo de costes estable.
Una primera prueba práctica puede consistir en diez solicitudes rutinarias o centradas en texto y otras diez de programación, uso de herramientas o tareas visuales. Compara la tasa de tareas aceptadas, el tiempo total de finalización, los reintentos y el gasto total en tokens. Para muchos equipos, eso implica probar DeepSeek V4 Flash para texto con contexto repetido y Qwen3.8-Flash para trabajos multimodales, mientras mantienen GLM-5.3-Flash como respaldo hasta comprobar que las nuevas rutas son fiables.
Preguntas frecuentes
¿Cuál es la mejor alternativa gratuita a Ox Alpha?
Las fuentes oficiales consultadas no establecen ninguna sustitución gratuita permanente y neutral respecto al proveedor. Los proveedores pueden ofrecer cuotas o promociones variables, pero una decisión de producción debería basarse en las tarifas publicadas y considerar el acceso gratuito como un extra.
¿Qué alternativa admite imágenes y vídeo?
Qwen3.8-Flash indica oficialmente que admite entradas de imagen, texto y vídeo. La ruta estándar de DeepSeek V4 Flash es distinta de su ruta deepseek-v4-flash-vision-exp, así que prueba el endpoint exacto antes de migrar un agente visual.
¿Qué alternativa puedo ejecutar localmente?
Entre las opciones de pesos abiertos están el checkpoint GLM-5.3-Flash y Qwen3.8-Flash-Next. GLM-5.3-Flash tiene aproximadamente 320B parámetros totales, mientras que la documentación de Qwen para Flash-Next de pesos abiertos describe un contexto nativo de 262K que puede ampliarse a 1M con YaRN. No deberías asumir que ninguno de los dos cabe en un equipo con 32GB.
¿Cómo evito sorpresas después de cambiar de proveedor?
Ejecuta 20 tareas representativas en dos rutas y compara la tasa de tareas aceptadas, el tiempo total de finalización, los reintentos y el gasto total en tokens. Mantén la ruta actual de GLM-5.3-Flash como respaldo hasta que la alternativa demuestre ser fiable con tus propias herramientas y repositorios.