 AIREITER
La elección depende del tipo de trabajo. Claude Opus 5 es el punto de partida más seguro para la mayoría de las tareas acotadas y con mucho contenido generado, mientras que Claude Fable 5.1 es el modelo especializado que conviene probar para agentes de larga duración y contextos excepcionalmente grandes y reutilizables. El principal ahorro de Fable 5.1 procede de las lecturas de caché, no de unas tarifas de entrada o salida más bajas.
La decisión entre Fable 5.1 y Opus 5 empieza por tu carga de trabajo
Para la mayoría de los equipos, lo razonable es empezar con Opus 5, aumentar su nivel de esfuerzo cuando una tarea necesite más razonamiento y derivar a Fable 5.1 únicamente los casos difíciles que hayan demostrado necesitarlo. La documentación de Anthropic sobre Fable 5.1 ofrece una orientación general similar: comenzar con Opus 5 para la mayoría de las cargas de trabajo y pasar a Fable 5.1 cuando las evaluaciones de Opus con un nivel de esfuerzo más alto no cumplan los requisitos.
| Si tu principal limitación es… | Empieza con… | Motivo |
|---|---|---|
| Peticiones cortas o acotadas | Opus 5 | Sus tarifas de entrada y salida son la mitad que las de Fable 5.1. |
| Tráfico de producción con mucho contenido generado | Opus 5 | La menor tarifa de lectura de caché de Fable no reduce el precio de los tokens generados. |
| Programación en varios archivos con una especificación definida | Opus 5 | Su menor coste facilita asumir reintentos y niveles de esfuerzo más altos. |
| Agentes de larga duración que utilizan herramientas | Fable 5.1—después de una evaluación | Fable lidera las comparativas publicadas por Anthropic sobre uso de herramientas y agentes. |
| Contextos grandes que se reutilizan repetidamente entre turnos | Fable 5.1—después de modelar los costes | Su precio de lectura de caché es la mitad que el de Opus 5. |
| Un router de producción sensible a los fallback | Opus 5 primero | Fable 5.1 modifica el comportamiento de los bloques de razonamiento y del historial de conversación. |
La comparación se reduce a esto: Opus 5 con el nivel de esfuerzo y el coste adecuados frente a Fable 5.1 con la forma de contexto y el umbral de fiabilidad adecuados.
Qué diferencia realmente a Fable 5.1 de Opus 5
Claude Fable 5.1 es el modelo de gama alta de Anthropic para razonamiento exigente y trabajo agéntico de larga duración; Claude Opus 5 se presenta como una opción menos costosa para programación avanzada, agentes y trabajo profesional. Ambos ofrecen una ventana de contexto de 1 millón de tokens y una salida máxima de 128.000 tokens, así que el argumento de Fable está en la ejecución prolongada, no en disponer de un límite de contexto publicado más grande.
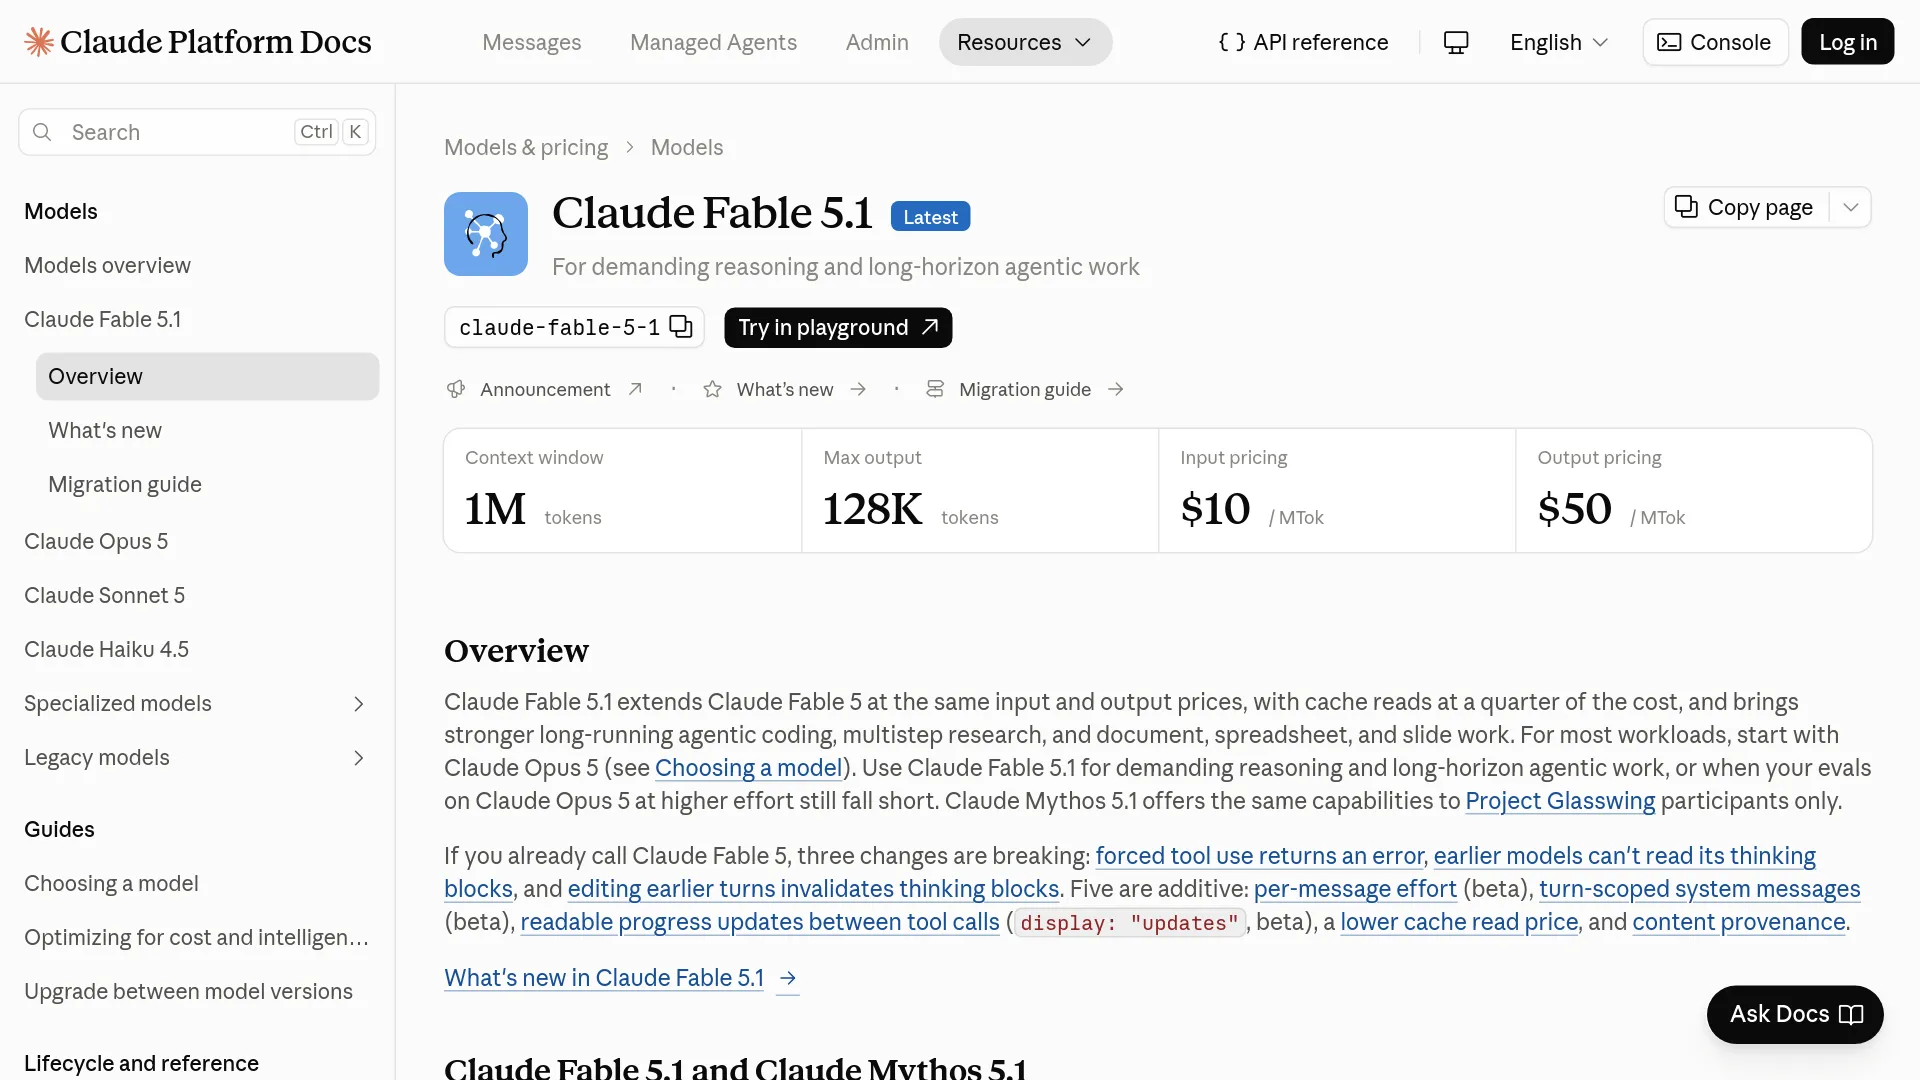
| Especificación | Claude Fable 5.1 | Claude Opus 5 |
|---|---|---|
| ID del modelo en la API | claude-fable-5-1 | claude-opus-5 |
| Ventana de contexto | 1 millón de tokens | 1 millón de tokens |
| Salida máxima | 128.000 tokens | 128.000 tokens |
| Modalidades de entrada | Texto e imágenes | Texto e imágenes |
| Modalidad de salida | Texto | Texto |
| Razonamiento | Adaptativo, siempre activado | Razonamiento controlado por nivel de esfuerzo |
| Controles de esfuerzo | low, medium, high, xhigh, max | Niveles de esfuerzo configurables |
| Posicionamiento de Anthropic | Razonamiento exigente y agentes de larga duración | La mayoría de las cargas de trabajo y programación avanzada |
| Estado de lanzamiento | Activo/última versión; lanzado el 1 de septiembre de 2026 | Modelo Opus activo; lanzado el 24 de julio de 2026 |
Para consultar los identificadores de modelo y la disponibilidad según el despliegue, utiliza la página del modelo Fable 5.1 y la página de producto de Claude Opus 5.
El resultado del benchmark favorece a Fable 5.1, pero no en todos los escenarios
La tabla de benchmarks publicada por Anthropic sitúa a Fable 5.1 por delante de Opus 5 en todas las filas indicadas en las que se informa de resultados para ambos modelos. Como la tabla procede de pruebas realizadas por el propio proveedor, sus resultados son una referencia útil sobre la evaluación de lanzamiento, no una garantía para producción.
| Evaluación de Anthropic | Fable 5.1 | Opus 5 | Ventaja de Fable 5.1 |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52,6% | 29,0% | 23,6 puntos |
| Terminal-Bench 4.0 | 55,8% | 52,3% | 3,5 puntos |
| GDPval-AA v2 | 1.853 Elo | 1.824 Elo | 29 Elo |
| OSWorld 2.0, estricto | 41,7% | 39,6% | 2,1 puntos |
| Humanity’s Last Exam, con herramientas | 65,0% | 63,6% | 1,4 puntos |
| AutomationBench | 31,4% | 26,9% | 4,5 puntos |
| CursorBench 3.2.0 | 73,4% | 70,0% | 3,4 puntos |
Anthropic afirma que las medidas de protección de producción estaban activadas y que algunas intervenciones podían generar resultados de cero o derivar el trabajo a modelos de fallback. También informa de un error estándar de aproximadamente 3,5–4,5 puntos porcentuales por modelo en Terminal-Bench-Science 0.1. Por eso, una diferencia de 23,6 puntos resulta bastante más significativa que una diferencia de 1,4 puntos en Humanity’s Last Exam.
En una evaluación independiente de CodeRabbit con 45 tareas que contenían 105 problemas conocidos, Fable 5.1 obtuvo un 61,0% de recall y un 37,3% de precisión, frente al 55,2% de recall y el 39,3% de precisión de Opus 5; ambos generaron 166 comentarios procesados, aunque los autores advierten de que las configuraciones no fueron idénticas.
“Fable 5.1 es un revisor especializado”. — Descripción de CodeRabbit sobre el resultado de su evaluación (CodeRabbit)
El precio de la API cambia la comparación práctica
Fable 5.1 cuesta el doble que Opus 5 tanto en entrada sin caché como en salida, pero sus lecturas de caché cuestan la mitad. Esto crea un punto de equilibrio en sesiones de agentes largas y repetitivas; no convierte en más barata cualquier petición realizada con Fable 5.1.
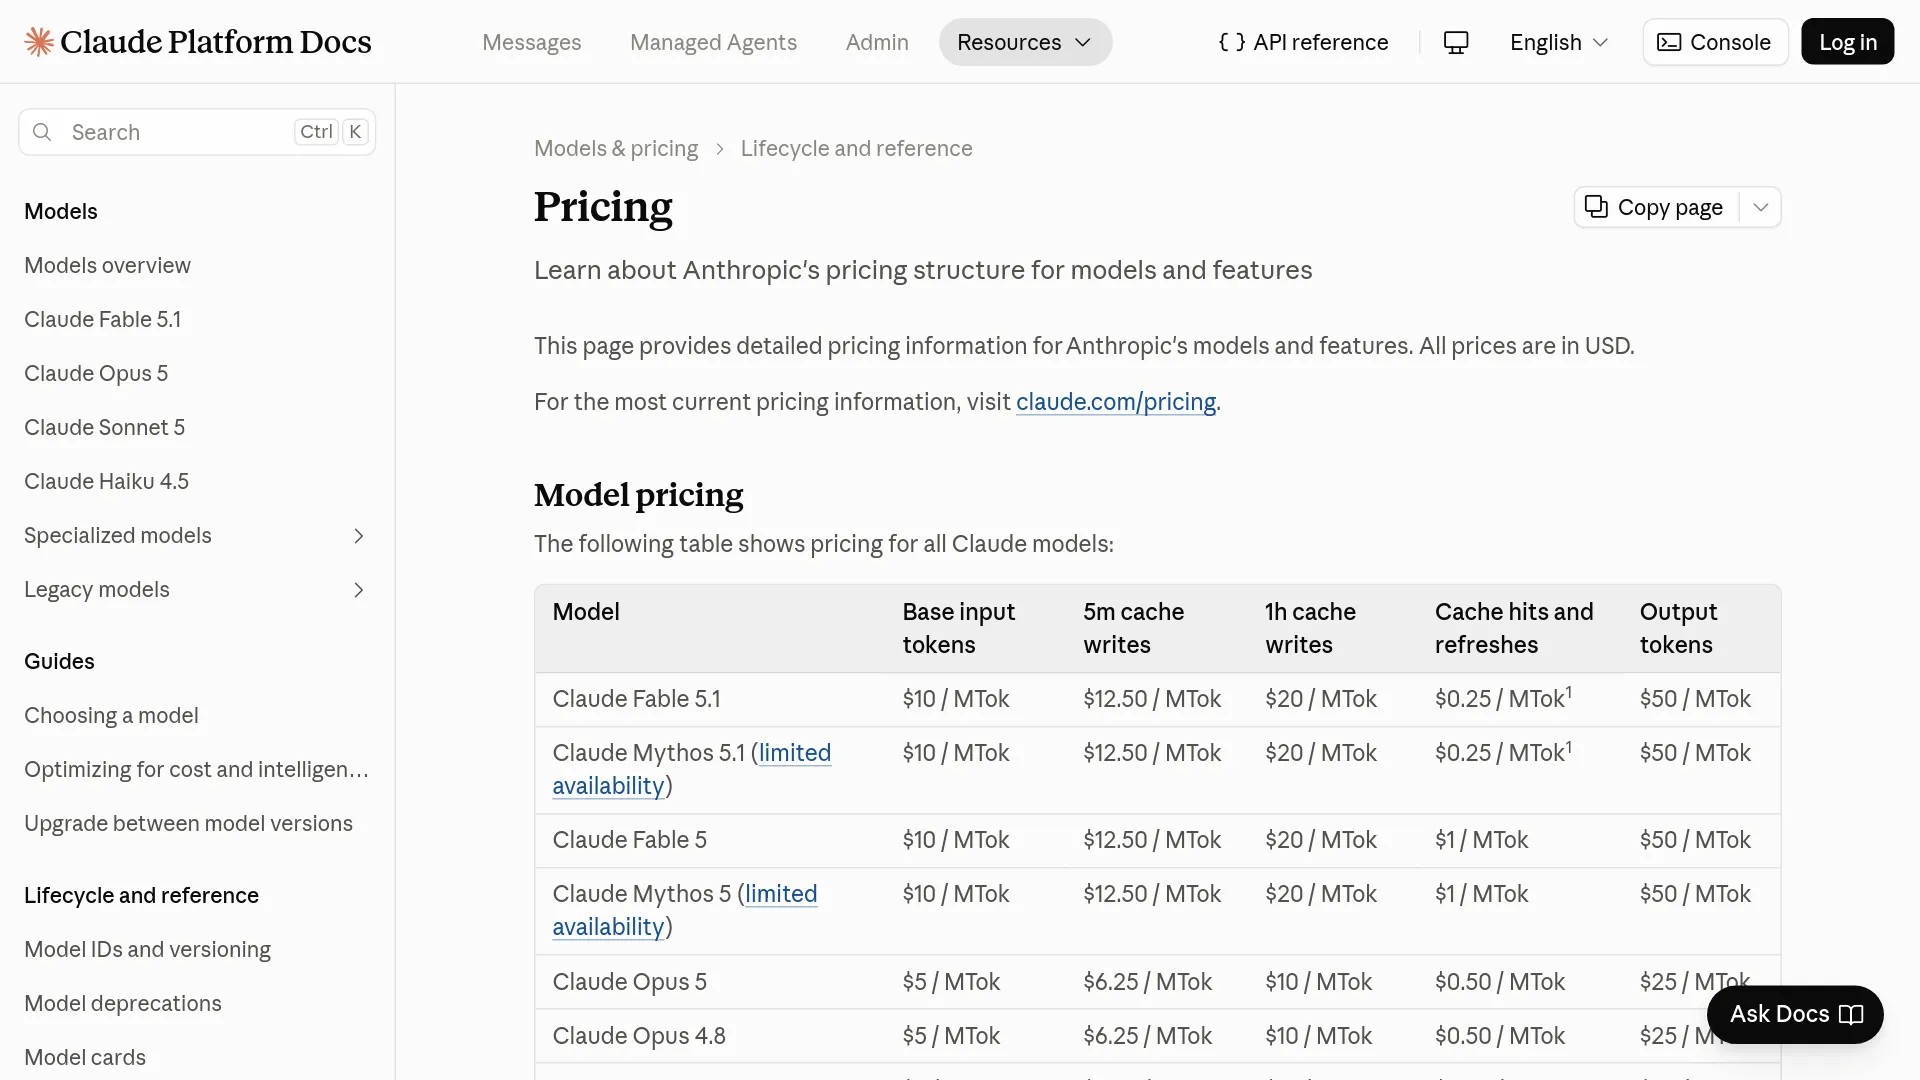
Las siguientes tarifas proceden de la documentación actual de precios de la API de Anthropic y están expresadas en USD por millón de tokens.
| Concepto de facturación | Claude Fable 5.1 | Claude Opus 5 |
|---|---|---|
| Entrada base | $10.00 | $5.00 |
| Escritura de caché de 5 minutos | $12.50 | $6.25 |
| Escritura de caché de 1 hora | $20.00 | $10.00 |
| Lectura de caché | $0.25 | $0.50 |
| Salida | $50.00 | $25.00 |
| Entrada / salida por lotes | $5.00 / $25.00 | $2.50 / $12.50 |
Los precios de entrada y salida de Fable 5.1 no han cambiado respecto a Fable 5. El cambio que impulsa el ahorro anunciado es la tarifa de lectura de caché: $0.25 por millón de tokens, frente a los $1.00 de Fable 5. Anthropic calcula un coste aproximadamente un 25% menor en cargas de trabajo típicas y de hasta alrededor de un 45% menor en cargas altamente agénticas, pero son estimaciones para determinados usos, no un descuento universal.
Un cálculo sencillo por turno ayuda a entender mejor el intercambio. Sea C el contexto almacenado en caché, I la entrada nueva y O la salida, todos medidos en millones de tokens. Si ignoramos los cargos por escritura de caché, Fable 5.1 cuesta 10I + 0.25C + 50O, mientras que Opus 5 cuesta 5I + 0.50C + 25O.
Las lecturas de caché más baratas de Fable solo compensan sus tarifas más altas de entrada nueva y salida cuando:
0.25C > 5I + 25O
En una petición con 2.000 tokens de entrada nueva y una respuesta de 1.000 tokens, I = 0.002 y O = 0.001. El contexto almacenado en caché debe superar aproximadamente los 140.000 tokens para que las cuentas basadas únicamente en lecturas favorezcan a Fable. Al sumar los costes de escritura de caché, el punto de equilibrio se desplaza aún más.
Por eso no tiene sentido actualizar a Fable 5.1 por motivos de precio en llamadas breves de extracción, clasificación, reescritura o programación puntual. Hay poco o ningún prefijo reutilizable que abaratar y cada token generado se factura al doble de la tarifa de Opus 5.
Dónde encaja mejor cada modelo en los flujos de trabajo reales
La división práctica está entre la ejecución acotada y la persistencia de larga duración. Opus 5 resulta más fácil de justificar cuando la tarea está claramente especificada o genera mucho contenido; Fable 5.1 gana interés cuando un agente debe mantener un plan, utilizar herramientas repetidamente, recuperarse de errores y conservar un contexto amplio durante muchos turnos.
Agentes de programación: decide por el trabajo terminado, no por la posición en el benchmark
Opus 5 es la primera opción que conviene probar en tareas normales de repositorio: correcciones de errores acotadas, refactorizaciones definidas, revisiones de código y trabajos en los que un coste menor permite reintentar o elevar el esfuerzo. Fable 5.1 merece un piloto en cambios que afecten a varios archivos, migraciones, depuración a nivel de sistema y sesiones de programación asíncronas en las que un fallo tardío resulte más caro que una respuesta lenta.
Los comentarios de la comunidad apuntan a dos riesgos operativos distintos. En un extenso debate de r/ClaudeCode, el usuario u/CyCoCyCo escribió:
“La única forma en la que he conseguido resultados es pedirle que cree prompts de objetivos y ejecutarlos de principio a fin”. — u/CyCoCyCo en Reddit
Esto demuestra una queja sobre el prompting y el flujo de trabajo, no que Opus 5 falle con cualquier base de código. Otros usuarios del mismo debate describieron problemas en tareas más largas y con mucho contexto, como desviaciones respecto a las instrucciones y correcciones que introducían nuevos defectos.
Fable 5.1 presenta un perfil de quejas diferente: en un debate sobre su lanzamiento, algunos usuarios informaron de un consumo inusualmente rápido de tokens o cuota. El informe es anecdótico y no demuestra que exista un límite universal de suscripción, pero sí aconseja monitorizar el uso durante un piloto en lugar de juzgar el modelo únicamente por la calidad de sus respuestas.
Un piloto razonable para agentes de programación debería registrar:
- Tareas completadas sin intervención humana.
- Errores reabiertos o regresiones después de que el modelo informe de que ha terminado.
- Total de tokens de entrada, entrada almacenada en caché y salida.
- Tiempo de ejecución y número de llamadas a herramientas.
- Tiempo de corrección humana y coste de las ejecuciones tardías fallidas.
Investigación y trabajo intensivo en documentos: aquí Fable tiene un caso más claro
Fable 5.1 es el candidato más sólido cuando el trabajo implica un conjunto documental muy grande, llamadas repetidas a herramientas, gráficos visuales, investigación en varios pasos o un entregable que debe superar varias rondas de revisión. Anthropic lo posiciona específicamente para documentos, hojas de cálculo, presentaciones, diagramas, tablas e investigaciones de larga duración.
Opus 5 tiene la misma capacidad de contexto de 1 millón de tokens y Anthropic también lo describe como capaz de trabajar con documentos complejos y agentes sofisticados. Si el trabajo consiste en un único análisis con una salida generada considerable, la menor tarifa de Opus puede importar más que la ventaja de Fable en caché. Ejecuta una muestra representativa antes de convertir la ventaja de Fable en benchmarks en un requisito de producción.
Uso del ordenador y automatización empresarial: evalúa la trayectoria completa
Fable 5.1 supera a Opus 5 en las filas de OSWorld y AutomationBench de Anthropic, pero estas tareas miden una secuencia de acciones y no una única respuesta. En un agente para navegador o procesos empresariales, evalúa si el modelo llega al estado final correcto, con qué frecuencia necesita recuperarse y si una acción fallida invalida el resto de la ejecución.
La unidad relevante es el coste por resultado completado, no solo el coste por millón de tokens. Un modelo que evita reintentos repetidos en un flujo de trabajo largo puede resultar rentable pese a tener una tarifa más alta; uno que consume el presupuesto de uso antes de llegar al estado final no lo es.
Detalles de integración que conviene revisar antes de cambiar de modelo
La documentación de migración de Fable 5.1 describe cambios en el uso forzado de herramientas, los bloques de razonamiento y la validación del historial de conversación. Los equipos que utilizan su propio router de mensajes deberían probar estos aspectos antes de cambiar el modelo predeterminado.
| Cambio | Qué puede ocurrir | Acción de migración |
|---|---|---|
| Uso forzado de herramientas | tool_choice: {"type":"any"} o la elección de una herramienta concreta puede devolver HTTP 400. | Usa auto con instrucciones claras para las herramientas o salidas estructuradas cuando corresponda. |
| Portabilidad de los bloques de razonamiento | Los modelos anteriores no pueden leer los bloques de razonamiento de Fable 5.1; los turnos de fallback pueden eliminarlos. | Audita los cambios de modelo y las rutas de fallback. |
| Edición de conversaciones | Editar un mensaje anterior, el prompt del sistema o la lista de herramientas puede invalidar los bloques de razonamiento posteriores. | Trata el historial como una secuencia de solo adición o utiliza controles compatibles limitados al turno. |
| Configuración del razonamiento | Fable 5.1 utiliza razonamiento adaptativo y no permite desactivarlo del mismo modo que Opus 5. | Controla el gasto mediante los ajustes de esfuerzo y vuelve a probar el consumo de tokens. |
El detalle del fallback es importante en routers que mezclan modelos. Una petición a Fable 5.1 puede continuar con su contexto de razonamiento, pero un fallback a Opus 5 no puede consumir los bloques de razonamiento de Fable 5.1. Si el router los elimina silenciosamente, el fallback puede tener que replantear la tarea, lo que añade latencia y tokens. Prueba tanto la ruta correcta como la ruta de error con historiales similares a los de producción.
Una evaluación pequeña vale más que una gran afirmación sobre el modelo
Utiliza los mismos prompts, herramientas, contexto, política de esfuerzo y pruebas de aceptación para ambos modelos; de lo contrario, la comparación puede acabar midiendo el arnés de evaluación en lugar del modelo.
- Vía acotada: ejecuta correcciones de errores delimitadas, extracción, redacción estructurada y revisión de código. Registra la utilidad de la salida, el tiempo de corrección y el coste.
- Vía de larga duración: ejecuta una funcionalidad en varios archivos, una migración, una tarea de investigación o un flujo de navegador. Registra el éxito del estado final, las recuperaciones, las regresiones y el tiempo total.
- Vía intensiva en caché: repite un prompt de sistema estable, el mismo conjunto de herramientas y un prefijo de repositorio o documento. Registra la proporción de aciertos de caché y la factura total, incluidas las escrituras de caché y la salida.
Empieza Opus 5 con el nivel de esfuerzo que realmente desplegarías. Después prueba un nivel de esfuerzo mayor en Opus antes de trasladar la tarea a Fable 5.1. En Fable, prueba al menos medium y high; no des por hecho que el nombre del nivel de esfuerzo equivale directamente entre modelos. Anthropic afirma que estos ajustes controlan el equilibrio entre profundidad y coste, y las pruebas de terceros concluyeron que un razonamiento más intenso no mejoraba automáticamente los resultados agregados de revisión de código.
Preguntas frecuentes sobre Fable 5.1 y Opus 5
¿Qué modelo es mejor para programar?
Fable 5.1 supera a Opus 5 en los resultados publicados por Anthropic para Terminal-Bench y CursorBench, pero Opus 5 es el punto de partida más razonable para la mayoría de las tareas de programación acotadas y sensibles al coste. Utiliza una evaluación con un repositorio representativo para comprobar si la mayor calidad de finalización de Fable compensa su precio y latencia.
¿Merece Fable 5.1 el doble de precio en la API?
No por defecto. Sus tarifas de entrada y salida duplican las de Opus 5, mientras que las lecturas de caché cuestan la mitad; Fable empieza a resultar interesante desde el punto de vista económico cuando el trabajo reutiliza repetidamente un contexto grande y genera relativamente poca salida.
¿Tiene Fable 5.1 una ventana de contexto más grande?
No. Anthropic indica una ventana de contexto de 1 millón de tokens y una salida máxima de 128.000 tokens para ambos modelos. La diferencia de Fable está en su posicionamiento para el razonamiento de larga duración y las trayectorias agénticas, no en una ventana publicada más grande.
¿Debería aumentar el esfuerzo de Opus 5 antes de cambiar?
Sí. Las directrices de Anthropic recomiendan evaluar Opus 5 con un nivel de esfuerzo mayor antes de pasar a Fable 5.1. Compara el coste adicional en tokens con la mejora de calidad en lugar de ejecutar todas las peticiones con el esfuerzo máximo.
¿Puedo usar Opus 5 como fallback de Fable 5.1 de forma segura?
Puedes crear ese fallback, pero no des por hecho que el estado de la conversación sea portable. Los modelos anteriores no pueden leer los bloques de razonamiento de Fable 5.1, y la validación del historial de Fable 5.1 puede dejar al descubierto problemas en routers que editan turnos anteriores; prueba el fallback con esquemas de herramientas e historiales de mensajes reales.
¿Dónde pueden acceder los desarrolladores a Fable 5.1 y Opus 5?
Anthropic incluye ambos modelos en sus planes de Claude y ofrece acceso para desarrolladores a través de su plataforma y de integraciones con marketplaces cloud. Los identificadores exactos y la disponibilidad pueden variar según el proveedor, así que verifica el identificador específico del despliegue en la documentación de Fable 5.1 o en la página de producto de Opus 5.
La elección práctica es una regla de enrutamiento, no una actualización permanente
| Decisión | Usa Opus 5 | Usa Fable 5.1 |
|---|---|---|
| Modelo predeterminado para tráfico mixto | Sí | Solo después de una evaluación |
| Llamadas breves de una sola ejecución | Sí | No hay un argumento de precio |
| Generación con mucha salida | Sí | Normalmente no |
| Prefijos grandes almacenados en caché | Compara con cuidado | Posible ventaja de coste |
| Programación autónoma de larga duración | Haz un piloto primero | Candidato sólido |
| Refactorizaciones estrictamente acotadas | Normalmente | Si Opus no supera las pruebas de aceptación |
| Automatización en navegador o en varios pasos | Haz un piloto primero | Buen caso según los benchmarks |
| Router de fallback personalizado | Base más sencilla | Requiere pruebas de migración |
Mantén Opus 5 como referencia, ejecuta ambos modelos con el mismo conjunto de tareas acotadas y de larga duración, y deriva a Fable 5.1 únicamente cuando mejore el trabajo completado por dólar.
Para consultar los detalles específicos de costes, visita Claude Fable 5.1 API pricing; para una referencia más amplia del modelo, consulta Claude Opus 5.