 AIREITER
Claude Sonnet 5.5 combina un precio de $2 por millón de tokens de entrada con una puntuación publicada del 70.6% en Terminal-Bench 4.0. Sin embargo, las ejecuciones de agentes con el máximo nivel de esfuerzo pueden elevar bastante el coste real de cada cambio aceptado. Para los equipos que buscan un modelo de programación para producción, Sonnet 5.5 es la opción predeterminada que conviene probar primero, no un sustituto automático de Opus 5.5.
Conclusión para producción: usa Sonnet 5.5 como opción predeterminada para programar
Empieza probando Claude Sonnet 5.5 con correcciones de errores acotadas, refactorizaciones, generación de pruebas y tareas de repositorio que requieran herramientas. El resultado publicado por Anthropic en Terminal-Bench 4.0 es del 70.6%, por encima del 66.4% de Claude Opus 5.5 y del 10.3% de Claude Sonnet 5 en la misma comparación.
Eso sí, establece límites claros: configura de forma explícita el nivel de esfuerzo y la cantidad máxima de salida. Análisis independientes de costes señalan que Sonnet 5.5 con el máximo esfuerzo puede salir más caro por tarea de benchmark que Opus 5.5, pese a sus tarifas nominales más bajas.
Qué cambia Claude Sonnet 5.5 para los equipos que usan la API
Claude Sonnet 5.5 se lanzó el 28 de septiembre de 2026. La documentación oficial del modelo indica el ID claude-sonnet-5-5, una ventana de contexto de 1 millón de tokens, una salida máxima estándar de 128.000 tokens, razonamiento adaptativo y un nivel de esfuerzo predeterminado en la API de high.
| Detalle para producción | Claude Sonnet 5.5 |
|---|---|
| Fecha de lanzamiento | 28 de septiembre de 2026 |
| ID del modelo | claude-sonnet-5-5 |
| Ventana de contexto | 1M tokens |
| Salida máxima estándar | 128K tokens |
| Salida máxima en lotes | 300K tokens con la cabecera beta documentada |
| Esfuerzo predeterminado en la API | high |
Anthropic se compromete a no retirar el modelo antes del 28 de septiembre de 2027. Es un límite mínimo de disponibilidad, no una fecha definitiva de retirada.
Los valores predeterminados de la API que afectan a la factura
El razonamiento adaptativo está activado de forma predeterminada. Los equipos que migren desde Sonnet 5 deberían probar between_tools si necesitan desactivar el razonamiento inicial; la documentación oficial indica que el uso forzado de herramientas ahora devuelve un error, y que los valores no predeterminados de temperature, top_p o top_k devuelven errores HTTP 400.
El texto generado entre llamadas a herramientas puede llegar dentro de bloques thinking. Un cliente que procese respuestas en streaming y dé por hecho que todos los mensajes intermedios son bloques de texto normales puede parecer que se ha quedado bloqueado tras la migración. Actualiza el analizador antes de incorporar Sonnet 5.5 a un agente de programación existente.
Rendimiento en Terminal-Bench: suficiente para ser la opción predeterminada
El benchmark de agentes de programación más destacado en este análisis es Terminal-Bench 4.0, que evalúa tareas de línea de comandos con varios pasos. Los resultados comunicados por Anthropic sitúan a Sonnet 5.5 en el 70.6%, frente al 66.4% de Opus 5.5 y el 10.3% de Sonnet 5.
| Modelo | Terminal-Bench 4.0 | GDPval-AA Elo | CursorBench 4.0 |
|---|---|---|---|
| Claude Sonnet 5.5 | 70.6% | 1844 | 55.5% |
| Claude Opus 5.5 | 66.4% | 1846 | 57.8% |
| Claude Sonnet 5 | 10.3% | 1449 | 34.1% |
Las cifras anteriores aparecen en el resumen de benchmarks de DataCamp, que atribuye los resultados de la evaluación al material de lanzamiento de Anthropic. Sonnet 5.5 lidera la comparación de programación en terminal, pero Opus 5.5 sigue por delante en CursorBench y en varias evaluaciones más amplias de razonamiento y trabajo de conocimiento.
Valida el modelo con reproducciones de tareas reales del repositorio y mide las pruebas superadas, los turnos de herramientas y los cambios aceptados, no solo los diffs.
Precios de la API de Claude Sonnet 5.5 en cargas reales
La tarifa de Anthropic es sencilla, pero un agente de programación puede pagar por algo más que el prompt visible. Los tokens de razonamiento se facturan como salida, y el contexto repetido del repositorio puede convertirse en lecturas de caché entre turnos.
| Elemento de la API | Precio de Claude Sonnet 5.5 |
|---|---|
| Entrada | $2 por 1M de tokens |
| Salida, incluido el razonamiento | $10 por 1M de tokens |
| Escritura en caché durante 5 minutos | $2.50 por 1M de tokens |
| Escritura en caché durante 1 hora | $4 por 1M de tokens |
| Lectura de caché | $0.20 por 1M de tokens |
| Entrada en lotes | 50% de descuento, equivalente a $1 por 1M |
| Salida en lotes | 50% de descuento, equivalente a $5 por 1M |
La documentación oficial establece un mínimo de 512 tokens para los prompts almacenables en caché y explica que Sonnet 5.5 utiliza razonamiento adaptativo. Según el análisis de precios independiente de eesel, Sonnet 5.5 utiliza el mismo tokenizador que Sonnet 5; migrar no reduce automáticamente el número de tokens.
Una solicitud con 4.000 tokens de entrada y 700 tokens de salida cuesta aproximadamente $0.015 antes de otros cargos: $0.008 por la entrada más $0.007 por la salida. Un agente de programación que realice 20 turnos con 3.000 tokens de entrada nuevos y 2.000 tokens de salida por turno consumiría aproximadamente $0.12 en entrada nueva y $0.40 en salida, antes de contar lecturas y escrituras de caché, herramientas o reintentos. Son ejemplos de cargas de trabajo, no precios universales por tarea.
El nivel de esfuerzo es el control de costes
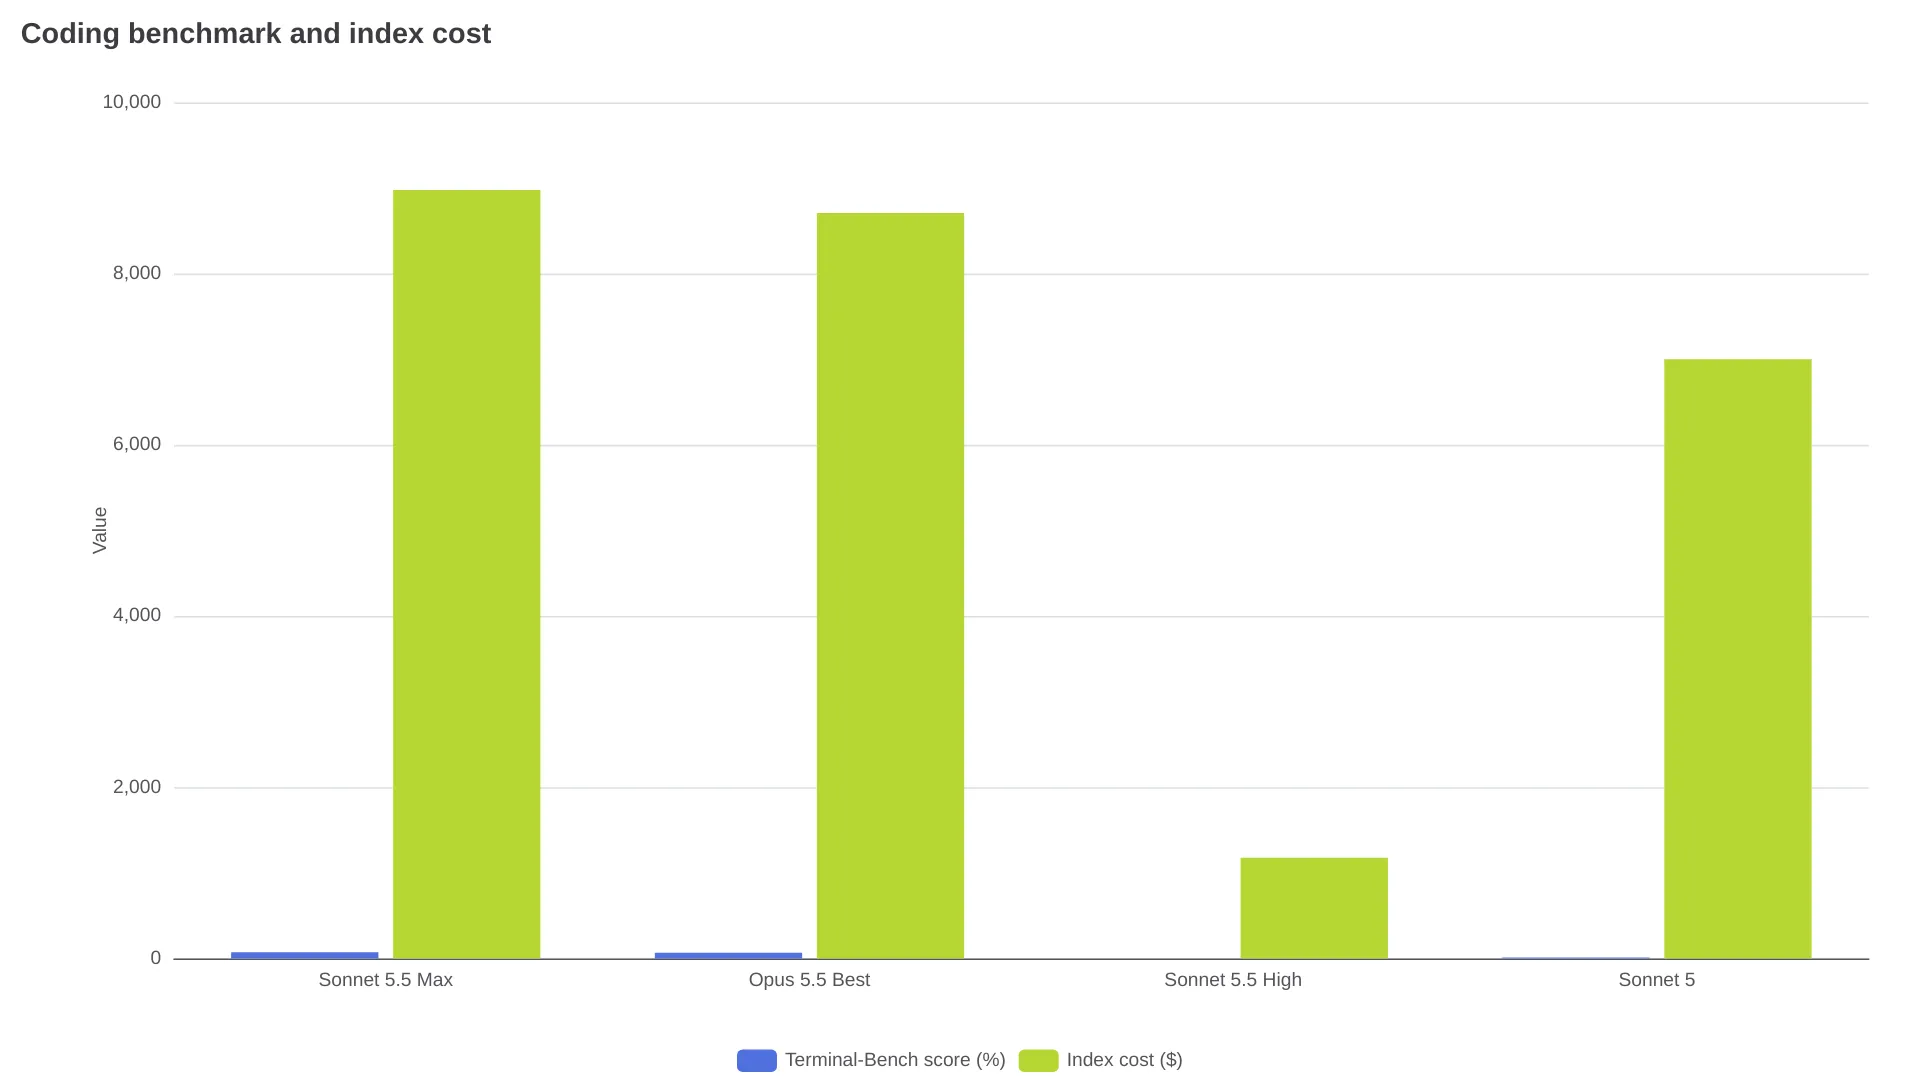
El análisis de TokenCost sobre el esfuerzo, basado en mediciones del Artificial Analysis Intelligence Index, publicó estos resultados para Sonnet 5.5:
| Esfuerzo | Puntuación | Coste del índice completo |
|---|---|---|
| Low | 35.8 | $544 |
| Medium | 40.7 | $701 |
| High | 46.7 | $1,176 |
| Xhigh | 51.9 | $2,738 |
| Max | 56.0 | $8,977 |
El resultado con max es la señal de alarma. El mismo análisis situó a Opus 5.5 en 57.6 con max por $8,708, mientras que Opus 5.5 alcanzó 56.0 con xhigh por $4,057. En esa prueba, Sonnet 5.5 con max utilizó aproximadamente 193.000 tokens de salida por tarea.
Empieza con medium o high, limita los tokens de salida y reserva una ruta más cara para las tareas fallidas o de mayor riesgo. No copies una configuración antigua de max de Sonnet 5 a Sonnet 5.5 sin repetir las evaluaciones de coste y calidad.
Checklist de migración para un modelo de programación en producción
- Fija
claude-sonnet-5-5en staging en lugar de cambiar un alias de forma global. - Reproduce correcciones de errores, refactorizaciones, pruebas y cambios en varios archivos representativos de tus repositorios.
- Configura explícitamente el nivel de esfuerzo y registra los tokens de salida, las lecturas de caché, los turnos de herramientas, el tiempo transcurrido y la tasa de cambios aceptados.
- Sustituye
thinking: disabledpor el comportamiento compatiblebetween_toolscuando corresponda. - Elimina las suposiciones sobre el uso forzado de herramientas y prueba el nuevo comportamiento de selección de herramientas.
- Actualiza el código de streaming para procesar bloques
thinkingentre llamadas a herramientas. - Vuelve a comprobar los parámetros de muestreo no predeterminados; la documentación oficial indica que
temperature,top_pytop_kno predeterminados generan errores 400. - Añade un límite de gasto y una condición de aborto para la generación descontrolada o los bucles repetidos de herramientas.
- Compara el coste por cambio aceptado, no el coste por solicitud.
- Despliega primero en un pequeño porcentaje del tráfico. Amplía el uso de Sonnet solo si iguala la tasa de cambios aceptados del modelo actual dentro de la tolerancia acordada y reduce el coste por cambio aceptado.
El empleado de Anthropic @cjav_dev informó de que las solicitudes con thinking: {"type":"disabled"} empezaron a devolver errores 400 y que debían migrarse a between_tools (publicación en X).
Cuándo elegir Sonnet 5.5, Opus 5.5 o un modelo más barato
| Carga de trabajo | Primera opción recomendada | Motivo |
|---|---|---|
| Correcciones de errores y refactorizaciones acotadas | Sonnet 5.5 con medium/high | Buena puntuación en terminal con tarifas de tokens más bajas |
| Clasificación de código a gran escala o ediciones sencillas | Sonnet 5.5 con low/medium, o un modelo más barato | Evita pagar por razonamiento innecesario |
| Agente de repositorio de larga duración | Sonnet 5.5 con caché y presupuestos estrictos | La caché y el número de turnos determinan la factura real |
| Arquitectura ambigua o revisión final | Opus 5.5 | El criterio global importa más que la tarifa más baja |
| Análisis de código offline y no urgente | Claude Sonnet 5.5 Batch API | La API ofrece un 50% de descuento en entrada y salida |
| Experimento de terminal con el máximo esfuerzo | Sonnet 5.5 solo después de un benchmark interno | Terminal-Bench es uno de sus puntos fuertes, pero max puede resultar caro |
Usa Sonnet para tareas bien definidas y medibles; deriva a Opus el trabajo de arquitectura ambiguo.
Preguntas frecuentes sobre la API de Claude Sonnet 5.5
¿Cuánto cuesta la API de Claude Sonnet 5.5?
La tarifa estándar es de $2 por millón de tokens de entrada y $10 por millón de tokens de salida. Las lecturas de caché cuestan $0.20 por millón de tokens, las escrituras cuestan $2.50 durante cinco minutos o $4 durante una hora, y la Batch API aplica un descuento del 50% a la entrada y la salida.
¿Es Sonnet 5.5 mejor que Opus 5.5 para programar?
Sonnet 5.5 lidera la comparación publicada de Terminal-Bench 4.0 con un 70.6%, frente al 66.4% de Opus 5.5. Opus sigue por delante en varias evaluaciones, así que los equipos deberían elegir la ruta según el tipo de tarea y no tratar el resultado de programación como una clasificación universal.
¿Cuál es el ID del modelo Sonnet 5.5?
Usa claude-sonnet-5-5 en la API de Claude. Los identificadores específicos de cada proveedor aparecen en la documentación de modelos de Anthropic.
¿Sonnet 5.5 admite una ventana de contexto de 1M de tokens?
Sí. Anthropic indica una ventana de contexto de 1 millón de tokens y una salida máxima estándar de 128.000 tokens. La beta de Message Batches API puede admitir 300.000 tokens de salida con la cabecera beta documentada.
¿Qué cambia al migrar desde Sonnet 5?
Han cambiado el razonamiento adaptativo y el comportamiento de los bloques de respuesta; el uso forzado de herramientas puede generar errores, los parámetros de muestreo no predeterminados pueden devolver errores 400 y thinking: disabled debe sustituirse por el comportamiento compatible. Repite las pruebas del agente y del streaming antes del despliegue en producción.
Haz un piloto de una semana reproduciendo tareas con un nivel de esfuerzo medio/alto, mide el coste por cambio aceptado y deriva los casos fallidos a Opus.