 AIREITER
Anthropic presenta ahora Claude Opus 5.5 como la opción predeterminada para el trabajo de conocimiento en los planes de pago. Los resultados justifican en buena medida esa decisión, aunque hay una pega que se repite en las experiencias reales: la cuota de Pro, Max y Team se agota antes de lo previsto.
Opus 5.5 llegó el 22 de septiembre de 2026 como el primer modelo de la familia Claude 5.5. Anthropic afirma que rinde al nivel de Claude Fable 5.1 en la mayoría de tareas, con un coste de ejecución un 40% inferior al de Opus 5 (anthropic.com). El 12 de noviembre de 2026, su guía para usarlo a diario dejó clara la apuesta: empezar con Opus 5.5 en esfuerzo Medium para investigación, análisis, redacción, informes, hojas de cálculo y presentaciones, y escalar solo cuando haga falta (claude.com). Este análisis reúne esa documentación oficial, benchmarks independientes e informes de usuarios sobre las cuotas; no es una prueba de laboratorio de primera mano.
Veredicto rápido: déjalo por defecto y usa Medium
Mantén Opus 5.5 seleccionado y ejecútalo en esfuerzo Medium para el trabajo de conocimiento habitual. Antes de cambiar de modelo, aumenta el nivel de esfuerzo; pasa a Sonnet 5.5 o Haiku 5.5 cuando la velocidad o el volumen pesen más que el criterio.
No es una cuestión de fidelidad a la marca, sino de números. En las evaluaciones de programación y trabajo de conocimiento de Anthropic, Opus 5.5 en Medium igualó o superó a Opus 5 en High. Factory, citado en la guía de Anthropic para uso diario, observó asimismo que Medium igualaba a Opus 5 en High utilizando entre un 20% y un 25% menos de tokens de salida. Además, Medium es el ajuste predeterminado en las aplicaciones de Claude y Claude Code, así que la mayoría de suscriptores obtienen este comportamiento sin modificar nada.
La salvedad es importante: el límite real para suscriptores es la cuota, no el precio de lista de la API. La API cuesta $4 por millón de tokens de entrada y $20 por millón de tokens de salida, frente a los $5/$25 de Opus 5; las lecturas de caché cuestan $0.20 por millón. Sin embargo, los modelos más caros consumen los límites de suscripción más deprisa, según la guía de Anthropic para uso diario. Usuarios reales informan de ventanas de 5 horas agotadas en 15–30 minutos durante sesiones intensivas, además de límites semanales que se drenan mucho antes que durante la luna de miel de septiembre.
Qué cambió para Pro, Max y Team con el nuevo modelo predeterminado
Para los suscriptores, la clave está en cómo funciona la cuota con este nuevo ajuste por defecto. En el lanzamiento, Anthropic anunció que elevaría los límites de uso de cinco horas en Pro, Max, Team y Enterprise por asiento, y que permitiría guardar un reinicio de límite de frecuencia (anthropic.com), pese a los informes de usuarios de finales de octubre sobre un consumo más rápido que se detallan más abajo. La guía de Anthropic señala que Pro, Team estándar y los puestos Enterprise por asiento no suelen incluir Fable 5.2 dentro de los límites normales fuera de las ofertas de lanzamiento: Fable consume créditos de uso. Conviene contar con Opus como herramienta principal incluida y con Fable como excepción de pago medido.
Donde sí cumple como modelo diario: investigación, análisis y redacción
Informes de investigación que resisten una auditoría cifra a cifra
La prueba más exigente consiste en elaborar un informe con fuentes sobre el rendimiento de una empresa, cuando el comunicado de resultados se hizo deliberadamente difícil de encontrar y cualquier cifra o cita inventada invalidaba el informe completo. Opus 5.5 superó 16 de 18 informes entre distintos niveles de esfuerzo; Anthropic afirma que ni Fable 5.1 ni Opus 5 alcanzaron ese mismo nivel en ningún intento (claude.com). La comprobación externa de Walleye Capital, también recogida en la publicación de lanzamiento de Anthropic, aporta contexto: Opus 5.5 resolvió en gran medida su batería de pruebas con el ajuste de esfuerzo más bajo y, con más esfuerzo, detectó un error de indexación de una posición en las propias instrucciones del evaluador. Según Walleye, ningún modelo probado anteriormente había identificado ese fallo.
Para el uso cotidiano, esto se traduce en delegar investigaciones abiertas con un entregable definido y las fuentes adjuntas, y después revisar las cifras en lugar de centrarse en la prosa.
Análisis de hojas de cálculo, operaciones y gráficos densos
En una fusión ficticia entre dos compañías de software de RR. HH., Opus 5 y Opus 5.5 crearon un modelo de Excel y una presentación ejecutiva, llegando a la misma conclusión sobre la operación. Opus 5.5 terminó en 63 minutos frente a los 93 minutos de Opus 5, tuvo un coste de producción reportado un 50% inferior, entregó un modelo más completo y cometió menos errores menores (claude.com). En flujos de trabajo financieros más amplios, Hebbia informó de una cobertura de criterios del 86.6% para Opus 5.5, frente al 60.3% de Opus 5. Rogo, por su parte, reportó superar a Opus 5 en High en BigFinance Bench con aproximadamente un 60% menos de tokens de salida, según la publicación de lanzamiento de Anthropic.
La visión forma parte del mismo avance. Anthropic considera a Opus 5.5 su mejor modelo Opus para visión: documentos densos, valores en gráficos, capturas de pantalla y diagramas. También informa de que Opus 5.5, en su esfuerzo mínimo, leyó gráficos densos con mayor precisión que Opus 5 en su esfuerzo máximo (claude.com). La puntuación publicada en Chartography es 64.4% sin herramientas en el nivel evaluado más alto (claude.com) y 89.0% con herramientas en la tarjeta de resultados del lanzamiento. El Elo de trabajo profesional GDPval-AA alcanza 1846, frente a 1735 de Fable 5.1 y 1708 de Opus 5 (anthropic.com).
En la práctica, pide directamente la hoja de cálculo o la presentación terminada, adjunta la imagen del gráfico en vez de transcribir sus valores e indica la condición de cierre en el primer mensaje.
Redacción: documentos y presentaciones terminados, no simples esquemas
La promesa en escritura no se limita a un supuesto «mejor estilo»: trata de seguir instrucciones y de poder auditar el resultado. Anthropic sostiene que Opus 5.5 se mantiene dentro del alcance, empieza por las conclusiones, reduce la jerga, respeta las reglas de estilo proporcionadas y explica qué hizo, qué encontró y qué información necesita aún. Las evaluaciones independientes apuntan en la misma dirección: Hayz Labs otorga a Opus 5.5 una puntuación de 100 en redacción y 100 en programación, con 94 en investigación; en su revisión de octubre lo sitúa primero para WebDev y agentes, y segundo para escritura creativa en Arena.
El límite honesto: igualar exactamente un estilo editorial propio sigue requiriendo iteración.
El nivel de esfuerzo marca el coste
Opus 5.5 tiene cinco niveles de esfuerzo —Low, Medium, High, Very High/Extra High y Max—, según el desglose de esfuerzo de eesel. El razonamiento no se puede desactivar, según Hayz Labs. Frente a este dial, el precio por token apenas mueve la factura.
Los cálculos por tarea recogidos por el resumen de eesel de las cifras de Artificial Analysis sitúan una misma tarea difícil en aproximadamente $0.55 con Low, $1.34 con Medium y $5.98 con Max. Los valores del Intelligence Index rondan 42, 51 y 58, respectivamente. Una ejecución en Max puede generar del orden de 119,000 tokens de salida y, a $20 por millón de tokens de salida, ahí es donde se concentra el gasto. La visión de Pareto de Hayz Labs llega a cifras cercanas: una mediana de unos $1.61 por tarea de agente durante 14 días ($1.76 de mediana en la tabla principal), con High alrededor de $1.82.
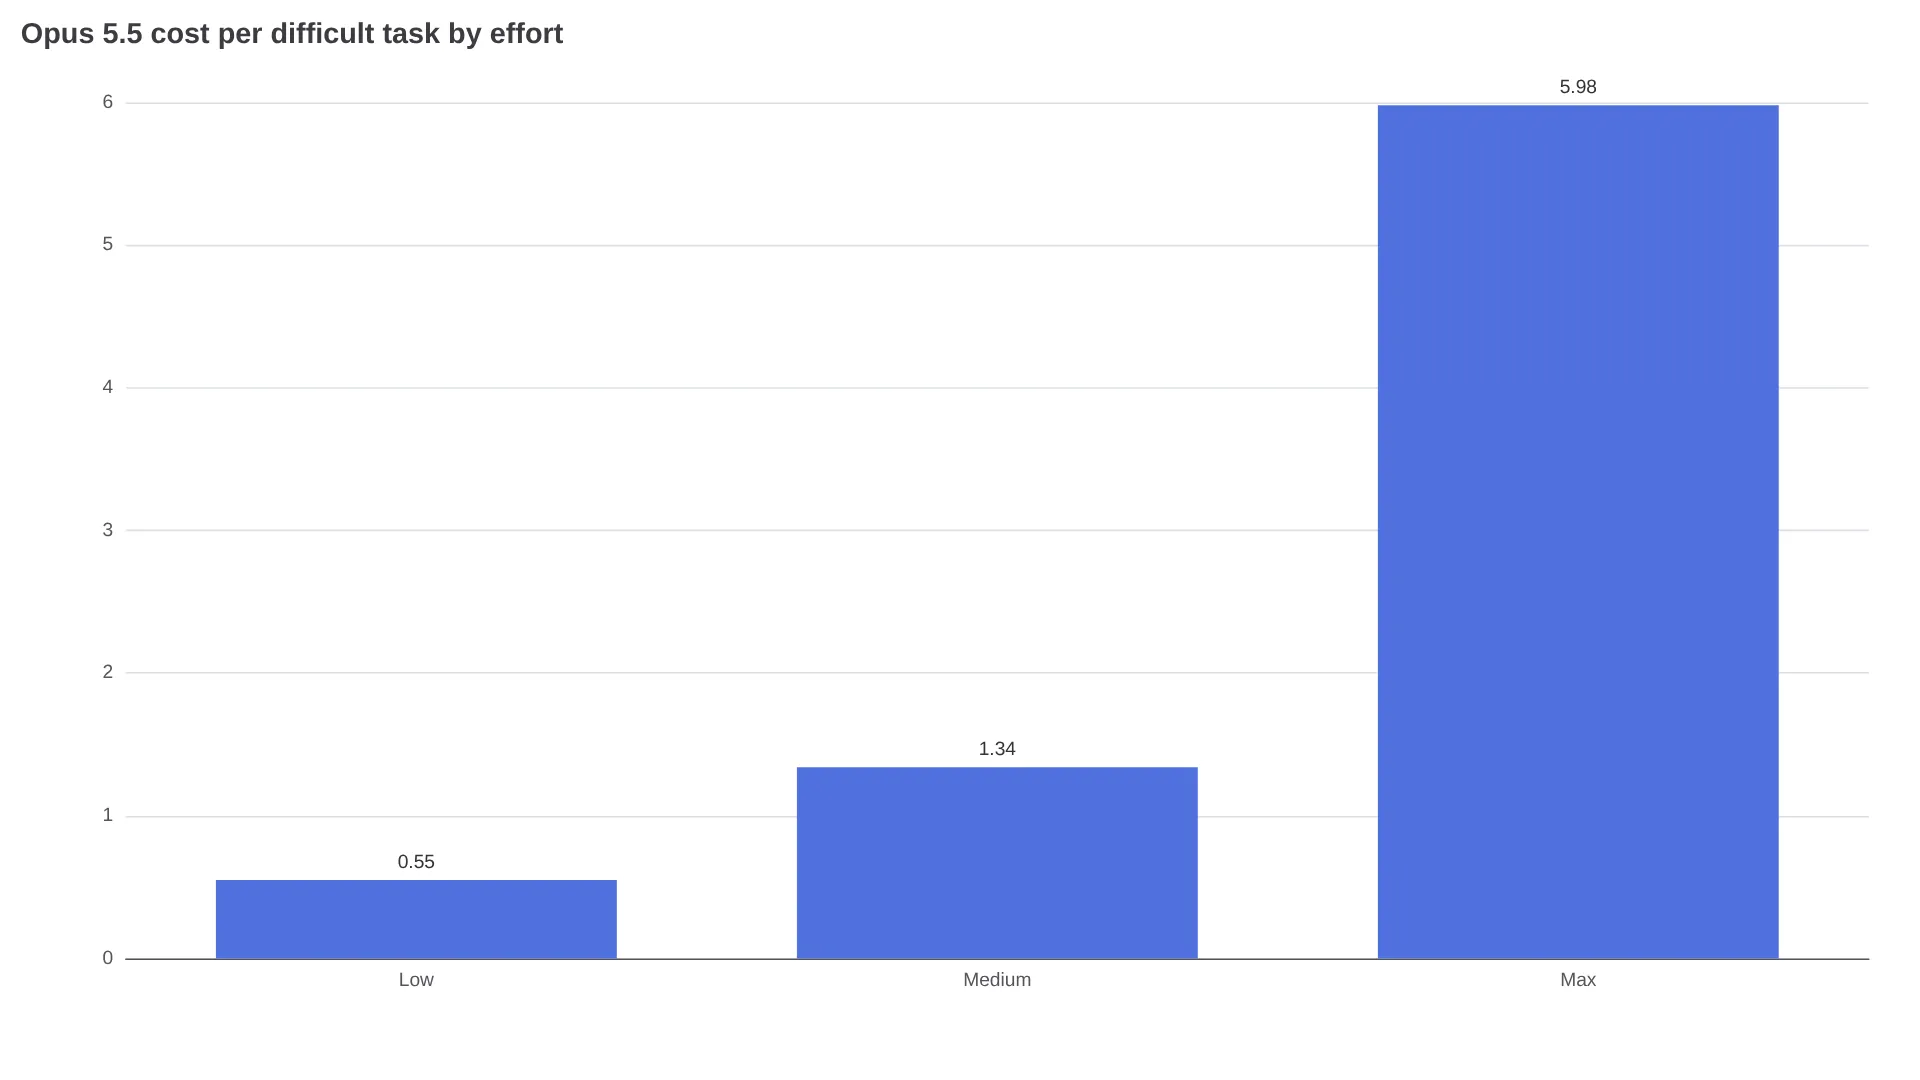
Un esfuerzo mayor tarda más y cuesta más, sin que el resultado mejore siempre. El consejo de Anthropic es eliminar frases como «piensa mucho»: el razonamiento ya está activado y la profundidad depende del ajuste de esfuerzo y de la tarea. Solo conviene subir de nivel cuando Medium se quede claramente corto.
La ventana de contexto es de 1 millón de tokens, con hasta 128,000 tokens de salida —300,000 en Batch— y visión nativa, según la ficha de especificaciones de eesel. No hay recargo por contexto largo, según el análisis de precios de eesel, un dato relevante para flujos de auditoría de documentos extensos.
Cómo repartir tareas entre Opus 5.5, Sonnet 5.5, Haiku 5.5 y Fable 5.2
La guía de Anthropic de noviembre y los análisis independientes de costes convergen en una regla: primero ajusta el esfuerzo y después cambia de modelo. Los precios siguientes proceden de la tabla de precios de la guía de Anthropic para uso diario.
| Modelo | Precio API por 1M (entrada/salida) | Úsalo para | Cámbialo cuando |
|---|---|---|---|
| Haiku 5.5 | $0.10 / $0.50 hasta 100K tokens | Consultas rápidas, resúmenes, clasificación y trabajo acotado de gran volumen | El análisis se alarga o exige mucho criterio |
| Sonnet 5.5 | $2 / $10 | Tareas claras y bien delimitadas, pulido de documentos y presentaciones a partir de un briefing definido | Llegas a Extra High o Max de forma habitual |
| Opus 5.5 | $4 / $20 | La mayor parte de la investigación, análisis, trabajo financiero y documentos terminados | Medium se queda corto tras un intento real en High |
| Fable 5.2 | $8 / $40 | Trabajo técnico abierto, ciencia, programación y finanzas con equipos de subagentes de larga duración | Es trabajo de conocimiento corriente; normalmente es excesivo |
La transición que conviene recordar: Sonnet 5.5 llevado a Extra High o Max puede costar casi lo mismo por tarea que Opus 5.5 y aun así quedar por detrás en criterio. Usuarios de planes de programación describen la misma mecánica desde el lado de la suscripción: en vez de dejar Sonnet por encima de Medium, es preferible mover la tarea a Opus 5.5 en Low (véase, por ejemplo, @cupid25157). Encaja con la jerarquía oficial de «esfuerzo antes que modelo» y con las cuentas de coste por tarea.
Fable es el techo, no su rival directo. El hilo de Anthropic sobre Fable 5.2 de noviembre presenta Fable y Mythos para el trabajo técnico abierto más ambicioso, mientras que Opus 5.5 es el modelo diario más potente para la mayoría de tareas de programación y conocimiento (@claudeai). En una suscripción, la diferencia es aún más clara: los puestos estándar Pro/Team suelen cargar Fable a créditos, por lo que usarlo de forma casual puede transformar el impulso de elegir «el mejor modelo» en una factura de créditos.
Cómo evitar que la ventana de 5 horas se evapore
Esta es la parte que los benchmarks oficiales pasan por alto y sobre la que más insisten los usuarios. La queja más concreta no apunta a la capacidad del modelo, sino al consumo de cuota.
"Los límites de Opus 5.5 están siendo DESTROZADOS esta noche. Varias personas informan de cuotas de 5 horas agotadas en SOLO 15-30 minutos durante sesiones normales. Los límites semanales se están drenando MUCHO más rápido" — @TekonBurns, sobre el consumo en sesiones de Claude Code
Algunos usuarios describen el cambio como el abrupto final de la luna de miel. @kgauravnm escribe que «la fase de luna de miel de Claude Opus 5.5 ha terminado oficialmente», citando comportamiento perezoso y un consumo semanal rápido. Informes de puestos Team, como el de @ps_ios_dev, describen un uso en Medium que «se dispara» incluso tras el reinicio semanal gratuito. Hay una cautela que merece la pena conservar: un análisis de 67,000 mensajes de registros de Claude Code realizado por @sonuv_dev encontró llamadas a herramientas, tasas de fallo y tasas de quejas prácticamente estables: «básicamente cero evidencia de un nerf». Esto sugiere que parte del problema responde a un uso predeterminado más intensivo y a un razonamiento más caro, no a una degradación secreta. La elección de modelo también importa en el límite superior: @mohitsharmadl informa de un caso en el que Fable 5.2 en Medium resolvió errores que Opus 5.5 en High no pudo resolver; usar «Opus para todo» desperdicia cuota cuando se necesita un techo distinto.
Una guía de supervivencia para la cuota que combina la recomendación oficial con lo que los usuarios dicen que funciona:
- Configura Opus 5.5 en Medium como predeterminado para todo; considera High un paso de escalada diagnosticado, no un rasgo de personalidad.
- Divide por subtareas: Haiku para recuperar y clasificar información, Sonnet para redactar y pulir encargos acotados, y Opus para criterio, auditoría y aprobación final.
- No dejes Sonnet habitualmente por encima de Medium: calcula el punto de transición y mueve la tarea a Opus en Low/Medium.
- Adjunta archivos y conecta repositorios en lugar de pegar una y otra vez el mismo contexto; reenviar contexto largo añade tokens en cada turno y aumenta el uso medido.
- Guarda el reinicio del límite de frecuencia para una semana con una fecha límite real, en vez de gastarlo en experimentación.
- Reserva Fable para la clase reducida de tareas en las que gana —técnicas, abiertas, de largo recorrido y con múltiples agentes— y confirma antes si tu puesto lo factura a créditos.
Preguntas frecuentes sobre usarlo a diario
¿Claude Opus 5.5 es suficientemente bueno como modelo de uso diario?
Sí, para cargas de investigación, análisis y redacción donde importen el criterio y la auditabilidad. Hayz Labs lo sitúa primero en agentes y WebDev, con puntuaciones máximas en redacción, y las comprobaciones empresariales citadas por Anthropic apuntan en la misma dirección. Aun así, conviene mantener conectado un modelo más económico para trabajo de volumen.
¿Opus 5.5 es mejor que Sonnet 5.5 para el trabajo cotidiano?
Sí, para trabajo ambiguo o de alto impacto. En tareas claras, bien delimitadas y de gran volumen, Sonnet en Low o Medium es más rápido: Anthropic clasifica a Sonnet como Fast frente a Opus como Moderate (claude.com) y su precio por token es aproximadamente la mitad. El error es ejecutar Sonnet en Extra High o Max por defecto, porque así desaparece el ahorro.
¿Cuándo debería usar Opus 5.5 en vez de Fable 5.2?
Usa Opus para la mayor parte del trabajo de conocimiento y las tareas de programación convencionales. Escala a Fable en proyectos técnicos abiertos, largos o muy orientados a agentes cuando Opus en High siga sin avanzar, y revisa primero la facturación del plan, ya que los puestos Pro/Team estándar suelen cargar Fable a créditos.
¿Funciona de forma fiable el contexto de 1 millón de tokens con documentos largos?
Para trabajo de auditoría con archivos adjuntos, es la configuración Opus más sólida que Anthropic ha lanzado, incluido el resultado de 16 de 18 informes con fuentes. Los trabajos muy largos siguen consumiendo cuota de suscripción rápidamente, así que conviene dejar la recuperación de información en Haiku y el criterio en Opus, en vez de ejecutar todo con el contexto más grande.
La contrapartida que hay que vigilar
Opus 5.5 es la elección predeterminada adecuada para trabajo de conocimiento con esfuerzo Medium. La incógnita es si el endurecimiento de cuota que los usuarios reportan desde finales de octubre será la nueva normalidad; si lo es, una parte mayor de cada semana seguirá ejecutándose en Sonnet de lo que sugería el mensaje de lanzamiento.
Lecturas relacionadas: análisis de precios de Claude Opus 5.5, análisis de Claude Opus 5.5 High, Claude Opus 5.5 vs GPT-6.1 Sol.