 AIREITER
Si tus agentes de programación trabajan todo el día, la comparación entre Gemini 4 Hydrogen y Claude Sonnet 5.5 se resume así: Hydrogen cuesta aproximadamente un 25 % menos con una combinación de entradas y salidas al 50 % (4,50 $ frente a 6,00 $ por millón), pero Sonnet 5.5 completa más tareas de terminal y uso del ordenador sin necesitar tanta supervisión. Ni el precio ni una tabla de benchmarks te dicen cuánto cuesta realmente terminar una tarea.
Tanto Gemini 4 Hydrogen como Claude Sonnet 5.5 ofrecen un contexto de 1 M de tokens para programación rápida y ciclos agénticos. Hydrogen añade además cuatro niveles de razonamiento ajustables.
¿Qué cambia si mañana sustituyes Sonnet 5.5 por Hydrogen?
Un equipo que ejecuta 200 tareas de agente al día nota el cambio en dos frentes: la factura y el número de intervenciones necesarias. Hydrogen reduce el precio por token y, según la muestra independiente de velocidad de LLM Leaderboard, genera alrededor de 198 tokens por segundo frente a unos 144 de Sonnet 5.5. Es el perfil del «ejecutor de volumen»: borradores rápidos, lecturas paralelas de archivos y reparaciones ágiles.
Sonnet 5.5 es el «finalizador cuidadoso». La tabla de lanzamiento de Google sitúa a Sonnet 5.5 por delante en los tres benchmarks centrados en terminal y uso del ordenador (Terminal-Bench 4.1, OSWorld 2.1 y Terminal-Bench-Science), detallados en la tabla siguiente. Son justo los escenarios en los que un agente tiene que recuperarse de un comando fallido o se queda bloqueado.
La conversación de lanzamiento en Reddit muestra la misma división a nivel de tarea:
«Hydrogen está bien, pero sinceramente no me parece mejor que Sonnet 5.5». — u/FewKey5274 en r/GeminiAI
Ese hilo no contiene un benchmark de programación controlado, así que conviene tomarlo como una señal de cautela: ganar en tareas aisladas no predice el rendimiento de un sistema completo. Prueba ambos modelos con el mismo flujo de trabajo antes de migrar.
La factura: los 4,50 $ frente a 6,00 $ combinados son solo el principio
Las tarifas oficiales de la API son sencillas. Hydrogen cuesta 1,50 $ por millón de tokens de entrada y 7,50 $ por millón de tokens de salida, sin cambios en toda la ventana de contexto, según el anuncio de Google. Sonnet 5.5 cuesta 2,00 $ por millón de tokens de entrada y 10,00 $ por millón de tokens de salida, según los precios de Anthropic y la comparativa directa de OpenRouter.
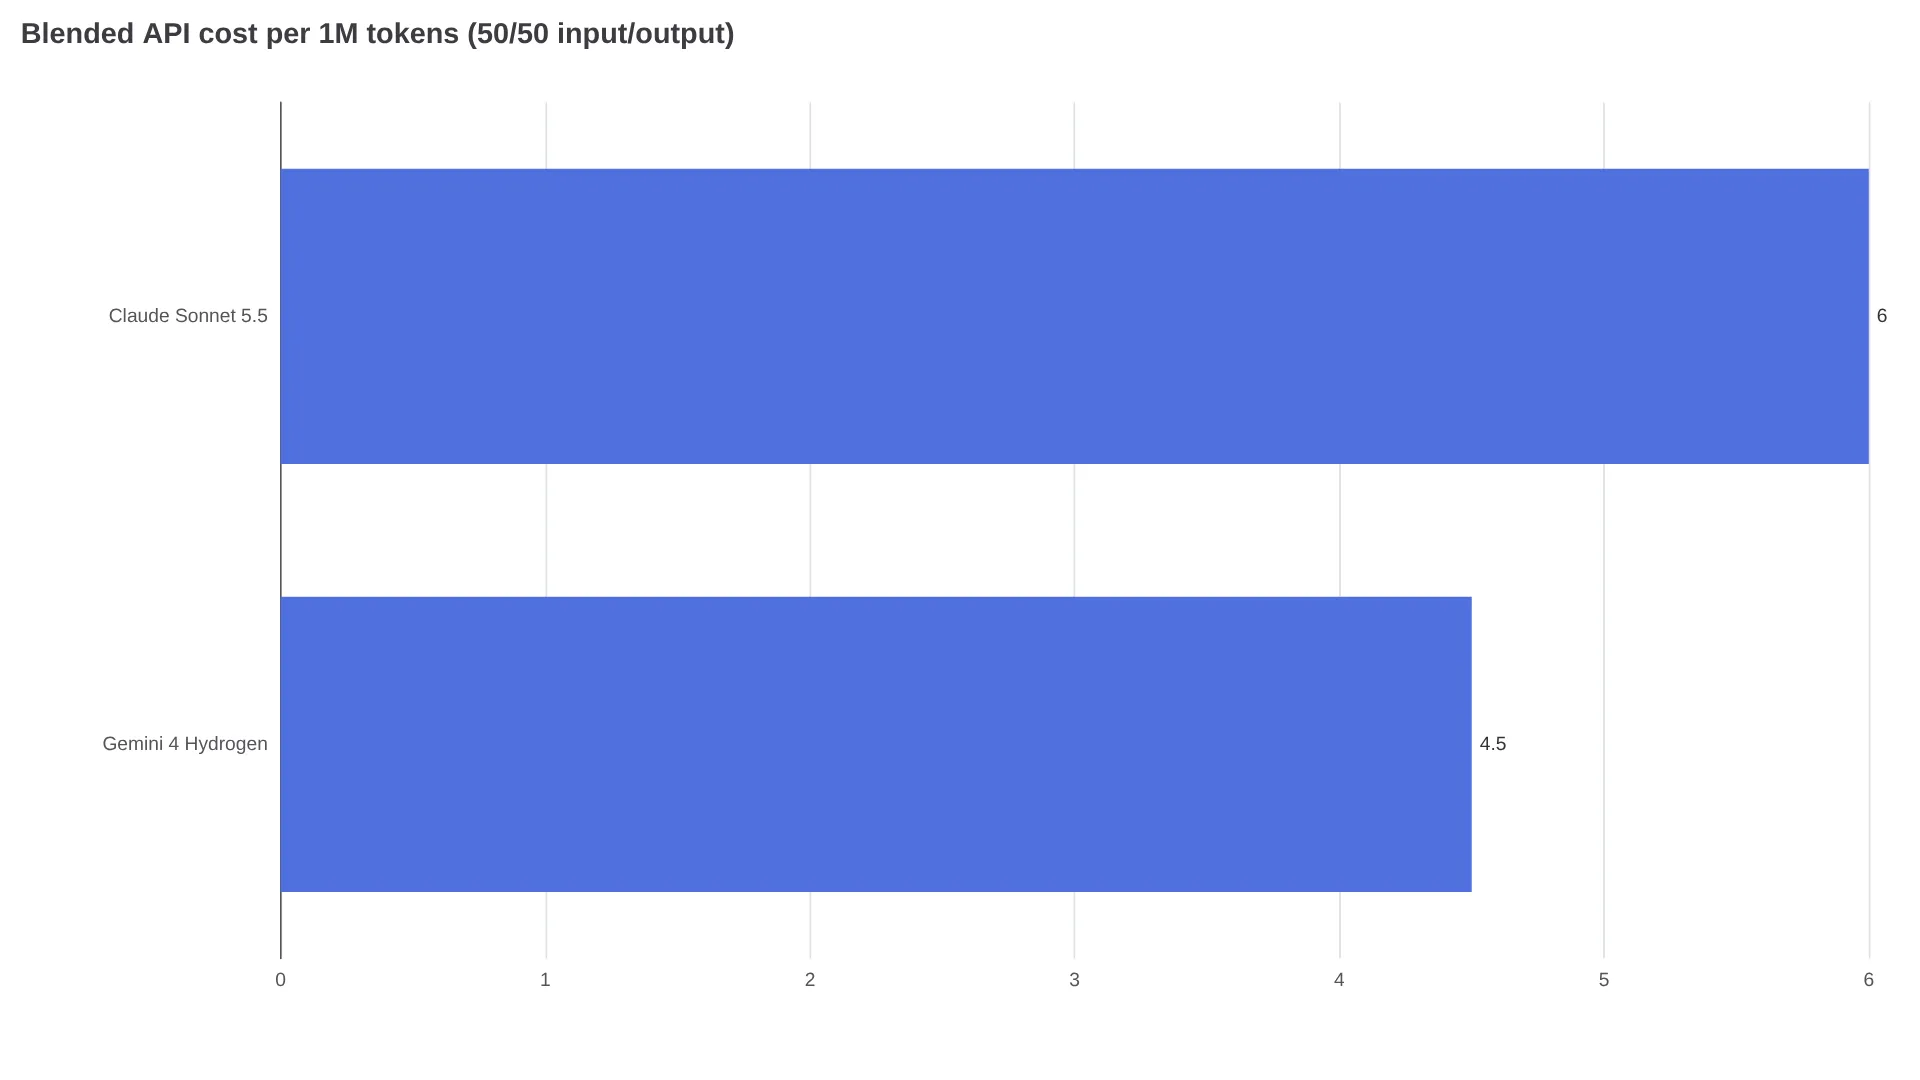
Con una combinación al 50 % —500.000 tokens de entrada más 500.000 de salida—, Hydrogen cuesta 4,50 $ por millón frente a los 6,00 $ de Sonnet 5.5. Esa diferencia del 25 % es real, pero hay tres factores que determinan si puedes conservarla:
- Los agentes que generan mucha salida amplían la diferencia. Los ciclos agénticos con trazas de razonamiento largas tienden a consumir más tokens de salida, donde el descuento de 2,50 $ por millón de Hydrogen tiene más peso.
- El almacenamiento en caché y las tarifas por lotes no están incluidos. Las lecturas de caché de prompts de Anthropic y los descuentos de su Batch API pueden mover la factura real varios puntos porcentuales. Además, LLM Leaderboard señala que su muestra de velocidad de Hydrogen no admitía caché explícita.
- Un ejemplo práctico ayuda a verlo claro. Si cada turno del agente promedia 10.000 tokens de entrada y 3.000 de salida, y ejecutas 1.000 turnos al día, el consumo será de 10 millones de tokens de entrada más 3 millones de salida: unos 37,50 $ diarios con Hydrogen frente a 50,00 $ con Sonnet 5.5 a tarifas oficiales. La diferencia sería de aproximadamente 275 $ al mes por agente concurrente durante 22 días laborables, antes de contar los reintentos.
Los reintentos son los que deciden el ganador real. El coste por tarea completada equivale al coste en tokens de cada intento dividido por la tasa de éxito, más el tiempo de corrección humana. Solo como ejemplo, un día de Hydrogen de 37,50 $ con una tasa de éxito al primer intento del 80 % cuesta unos 46,90 $ por cada 1.000 tareas completadas únicamente en tokens, mientras que un día de Sonnet de 50,00 $ con un 95 % cuesta unos 52,60 $. La diferencia se reduce rápidamente cuando cambian las tasas de éxito, así que mide durante dos semanas la tasa de merges al primer intento en lugar de fiarte de la tabla de cualquiera de los proveedores.
Los benchmarks se dividen por tipo de trabajo, no por un ganador absoluto
La tabla de lanzamiento de Google, publicada también en la ficha de modelo de DeepMind, compara Hydrogen, Sonnet 5.5 y GPT-6.1 Terra en diez evaluaciones. Hydrogen lidera siete de las diez frente a Sonnet 5.5, mientras que Sonnet 5.5 gana las otras tres. Las filas de los proveedores usan el sistema de evaluación propio de cada uno; las filas independientes proceden de nuevas ejecuciones de LLM Leaderboard.
| Familia de tareas | Benchmark | Gemini 4 Hydrogen | Claude Sonnet 5.5 |
|---|---|---|---|
| Programación en repositorios | SWE-sweep (proveedor) | 13,5 % | 3,1 % |
| Programación en repositorios | Terminal-Bench 4.1, ajustado por trampas (proveedor) | 57,0 % | 63,9 % |
| Automatización del conocimiento | Agents' Last Exam v1.1 (proveedor, sensible al sistema de evaluación) | 71,6 % | 60,4 % |
| Automatización del conocimiento | AutomationBench-AA (proveedor) | 76,1 % | 71,8 % |
| Automatización del conocimiento | Saldo final de Vending-Bench 2 (proveedor) | 14.549 $ | 11.165 $ |
| Uso del ordenador | Subconjunto offline de OSWorld 2.1 (proveedor) | 77,6 % | 83,9 % |
| Multimodal | MKA Climb WSR (proveedor; independiente 49,52 %) | 53,4 % | 52,0 % |
| Multimodal | Chartography (procedencia mixta) | 66,6 % | 61,6 % |
| Ciencia | Terminal-Bench-Science 0.1 (proveedor; independiente 49,52 %) | 51,4 % | 59,9 % |
| Razonamiento | HLE-Diamond (independiente, nivel xhigh) | 58,8 % | 53,3 % |
Las llamadas a herramientas deciden si un agente funciona o fracasa
Los benchmarks puntúan respuestas. Los agentes, en cambio, dependen de las llamadas a herramientas: agrupar lecturas, invocar la función correcta y recuperarse cuando una búsqueda no devuelve nada o falla un comando.
Google afirma que Hydrogen agrupa en paralelo las lecturas de archivos y las búsquedas, en lugar de revisar los archivos uno a uno, y que realiza cambios concretos en el repositorio sin reescribir archivos ajenos a la tarea. Los informes de socios incluidos en el artículo de lanzamiento hablan de un trabajo con grafos y SQL entre 2 y 2,8 veces más rápido, con entre un 12 % y un 23 % menos de tokens que Gemini 3.8 Flash, además de una finalización 2,5 veces más rápida con el razonamiento alto predeterminado. Son cifras seleccionadas por el proveedor y sus socios: marcan una dirección, no una garantía.
El contrapunto es la madurez del sistema de ejecución. Se aprecia en el hilo sobre Claude Code frente a Antigravity, donde varios usuarios mencionan problemas de disponibilidad de Antigravity y funciones de flujo de trabajo ausentes, como SSH, hooks reutilizables, skills y subagentes. Es una percepción de usuarios durante la semana de lanzamiento, no una medición controlada, y afecta al sistema de ejecución, no a los pesos del modelo.
Antes de mover un agente de producción, verifica tres aspectos: la fiabilidad de las llamadas paralelas a herramientas con el número de servidores MCP que utilizas, la tasa de recuperación tras fallar un paso de bash o del navegador y el comportamiento de los límites de permisos. Las pruebas internas de Google aseguran hasta un 81 % menos de extralimitación agéntica, un 79 % menos de servicio insuficiente y un 96,7 % de honestidad en su evaluación de honestidad de agentes. Compruébalo con una prueba propia de 50 tareas que incluya acciones bloqueadas y búsquedas sin salida.
Niveles de razonamiento: alto como punto de partida, xhigh solo cuando haga falta
Hydrogen incluye los niveles bajo, medio, alto y xhigh, con alto como opción predeterminada. Según la tabla de niveles de razonamiento de Google, el Artificial Analysis Intelligence Index v5.0.1 pasa de 27 a 41, 51 y 54 entre bajo y xhigh, con el nivel alto predeterminado (51) ligeramente por encima de Argon (50). En Terminal-Bench 4.0, la misma tabla sitúa el nivel alto en 54,0 %, por encima del 53,5 % de xhigh, mientras que AutomationBench-AA (del 60,5 % al 76,1 %) y HLE-Diamond (del 32,2 % al 58,8 %) mejoran de forma constante.
La regla para los ciclos agénticos es sencilla: empieza en alto y sube tareas concretas a xhigh solo cuando el cuello de botella sea el razonamiento —análisis, síntesis o investigación con varios documentos—. Después, comprueba cuánto ha aumentado el consumo de tokens. Según la ficha de modelo de DeepMind, Hydrogen puede consumir más tokens en los niveles de razonamiento superiores y su fecha de corte de conocimiento es marzo de 2026, así que cualquier trabajo sensible a la actualidad necesitará recuperación de información de todos modos.
La pregunta sobre el sistema de ejecución que debes resolver antes de migrar
Según la ficha de modelo de DeepMind, Hydrogen ofrece un contexto de 1.048.576 tokens y hasta 64.000 tokens de salida síncrona (hasta 1 M mediante una decodificación larga en segundo plano). Según la documentación de Anthropic, Sonnet 5.5 ofrece 1 M de tokens de entrada y hasta 128.000 de salida. Las cifras principales parecen equivalentes, pero en proyectos grandes decide la compactación: importa cuánto sobrevive después de 50 turnos, no lo que diga la ficha técnica.
| Gemini 4 Hydrogen | Claude Sonnet 5.5 | |
|---|---|---|
| Límite de contexto / salida | 1.048.576 tokens de entrada; 64.000 de salida síncrona (decodificación de 1 M en segundo plano) | 1.000.000 de tokens de entrada; 128.000 de salida |
| Dónde se ejecuta | Gemini API, AI Studio, Antigravity, aplicación Gemini, según Google | Claude API, Bedrock, Vertex AI, Microsoft Foundry, según Anthropic |
El hilo sobre Antigravity frente a Claude Code convierte la estabilidad del sistema de ejecución en un riesgo de migración mayor que la calidad del modelo: los usuarios cuestionan la supervivencia de la información tras la compactación, la persistencia de las cuotas y la disponibilidad. Ejecuta el mismo repositorio, commit, prompt y pruebas de aceptación en ambos sistemas, y compara las tareas completadas por ventana de suscripción y la tasa de merges al primer intento.
Elige en 60 segundos: tres perfiles de agente
No existe un ganador único para todos los agentes. Como criterio editorial basado en la división de los benchmarks anterior —no como resultado de una prueba propia—, asigna la ejecución paralela y repetitiva a Hydrogen, y el trabajo sensible a la recuperación y de horizonte largo a Sonnet 5.5. Las parejas planificador-ejecutor del mismo proveedor mantienen coherentes la autenticación y la compactación; combinar un planificador Claude con un trabajador Hydrogen merece una prueba, pero solo después de medir la línea base con un único proveedor.
| Tu agente | Elección | Motivo (nivel de evidencia) |
|---|---|---|
| Ejecutor de gran volumen: reparaciones masivas, código repetitivo, manipulación de datos, triaje multimodal | Hydrogen en nivel alto | Liderazgo en benchmarks del proveedor en AutomationBench, Agents' Last Exam y Vending-Bench; muestra independiente de velocidad de aproximadamente 198 frente a 144 tokens/s |
| Finalizador de horizonte largo: depuración intensiva en terminal, automatización de sistemas y navegadores, herramientas científicas | Sonnet 5.5 | Liderazgo del proveedor en Terminal-Bench 4.1, OSWorld 2.1 y Terminal-Bench-Science; valoración del ecosistema por los hooks y subagentes de Claude Code |
| Sintetizador de investigación: documentos extensos, gráficos, audio/vídeo y análisis intensivo en Sheets | Hydrogen en nivel alto; xhigh para las pasadas más difíciles | Liderazgo del proveedor en HLE-Diamond, Chartography y MKA; con la salvedad de que la repetición independiente de MKA obtuvo un resultado inferior, del 49,52 % |
¿Es Hydrogen realmente más rápido que Sonnet 5.5?
Hydrogen gana en rendimiento en la muestra de LLM Leaderboard (aproximadamente 198 frente a 144 tokens por segundo), pero el flujo p50 en directo de OpenRouter sitúa por delante a Sonnet 5.5 en latencia (2,08 s frente a 6,92 s de mediana), porque cambian el proveedor, la región y la carga. Mide ambos con tu propio proveedor.
¿Puede Hydrogen sustituir a Sonnet 5.5 dentro de Claude Code?
No basta con cambiar el identificador del modelo. Sonnet 5.5 funciona de forma nativa en Claude Code, donde los equipos dependen de hooks, skills y subagentes; Hydrogen se ejecuta mediante Gemini API, AI Studio, Antigravity y la aplicación Gemini. Sustituirlo implica migrar también el sistema de ejecución.