 AIREITER
Haiku 5.5 cuesta una vigésima parte de Sonnet 5.5 mientras el prompt no pase de 100.000 tokens. Al cruzar ese límite, la diferencia se reduce a 4x, y los bucles de agentes llegan ahí antes de lo que suelen prever los equipos. Para trabajo repetible y breve por API, Haiku 5.5 es suficiente; para depuración y programación en varios pasos, Sonnet 5.5 sigue justificando su precio.
La ventaja de precio dura hasta los 100K tokens
Claude Haiku 5.5 y Claude Sonnet 5.5 comparten unas especificaciones llamativas, pero la factura no tiene nada que ver. Ambos ofrecen una ventana de contexto de 1M de tokens y una salida máxima de 128K tokens; sus IDs de modelo son claude-haiku-5-5 y claude-sonnet-5-5. Sonnet 5.5 se lanzó el 28 de septiembre de 2026 y Haiku 5.5 el 7 de octubre de 2026, según los anuncios de Anthropic sobre Haiku 5.5 y Anthropic sobre Sonnet 5.5. La documentación de la plataforma Claude para Sonnet 5.5 recoge los mismos límites: 1M de contexto y 128K de salida.
| Especificación | Claude Haiku 5.5 | Claude Sonnet 5.5 |
|---|---|---|
| ID del modelo | claude-haiku-5-5 | claude-sonnet-5-5 |
| Lanzamiento | 7 oct 2026 | 28 sep 2026 |
| Contexto / salida máxima | 1M / 128K | 1M / 128K |
| Entrada / salida por debajo de 100K | $0.10 / $0.50 por 1M | $2 / $10 por 1M |
| Entrada / salida con prompt superior a 100K | $0.50 / $2.50 por 1M | $2 / $10 por 1M (sin tramo) |
| Lectura de caché | $0.01 por 1M | $0.10 por 1M |
| Esfuerzo predeterminado | medium | high |
Los precios son las tarifas de lista de Anthropic. Cuando los tokens del prompt superan los 100.000, Haiku 5.5 aplica el tramo superior a toda la petición, incluidas las lecturas y escrituras de caché, según el resumen de precios de Anthropic de APIKO.
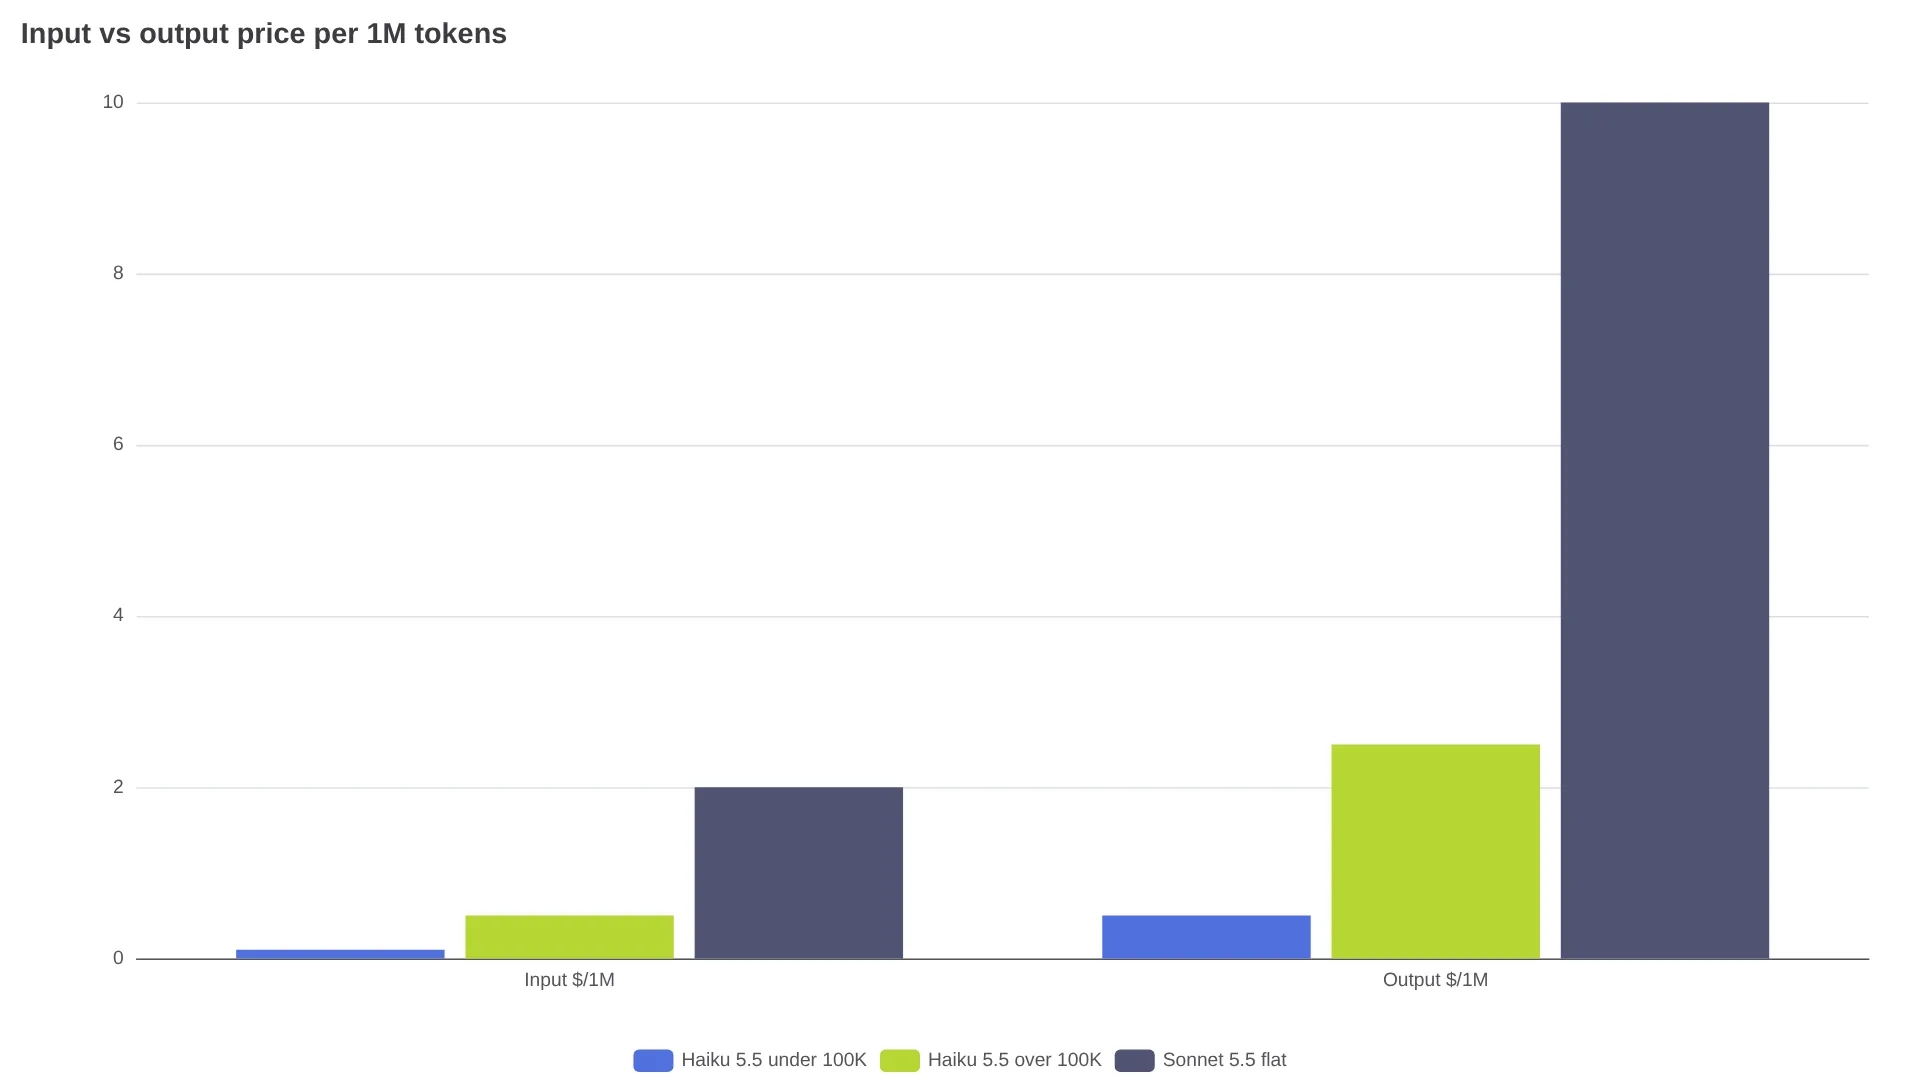
Para 1.000 documentos idénticos de 99K tokens con 1K de salida cada uno, el lote cuesta unos $10.40 a tarifa de lista (APIKO indica $4.54 para el mismo lote con sus tarifas). En cambio, 1.000 documentos de 101K tokens cuestan unos $53.00 a tarifa de lista: cinco veces más por apenas 2.000 tokens adicionales por documento. Sonnet 5.5 costaría unos $212.00 para el mismo lote de 101K. El cálculo es aritmética basada en los precios de lista recogidos en la prueba de Haiku 5.5 frente a Sonnet 5.5 de APIKO. Un lote modelado de 1.000 llamadas, con 10K de entrada y 1K de salida en cada una, suma $30.00 con Sonnet 5.5 frente a $1.50 con Haiku 5.5: una reducción del 95%, según la comparativa de precios de Sonnet 5.5 y Haiku 5.5 de Sim.
Los bucles de agentes alcanzan el umbral casi sin querer. En un hilo de r/ClaudeAI sobre el uso de tokens de Haiku 5.5, un usuario observó que las ejecuciones superaban los 100K hacia la vigésima llamada al modelo; 145 de las 164 llamadas siguientes se facturaron en el tramo superior porque se acumulan el historial y la salida de herramientas. Entre las soluciones propuestas en ese hilo estaban dividir el trabajo en tickets pequeños, limitar el alcance a archivos concretos, silenciar la salida de pruebas y crear subagentes nuevos en vez de mantener una conversación larga. Los trabajos cortos siguen siendo baratos con Haiku. Los flujos con contexto largo deben presupuestar Sonnet.
"El precio económico de Haiku 5.5 solo se mantiene por debajo de 100K de contexto. Con más de 100K tokens de entrada, el precio sube 5x; los trabajos pequeños, como traducciones y resúmenes, ahorran dinero, mientras que el trabajo de contexto largo debería usar Sonnet." — @zookmas1314
Consulta también los precios de la API de Claude Haiku 5.5 y la reseña y precios de la API de Claude Sonnet 5.5 para profundizar en cada modelo.
Qué revelan los benchmarks de Haiku 5.5 y Sonnet 5.5
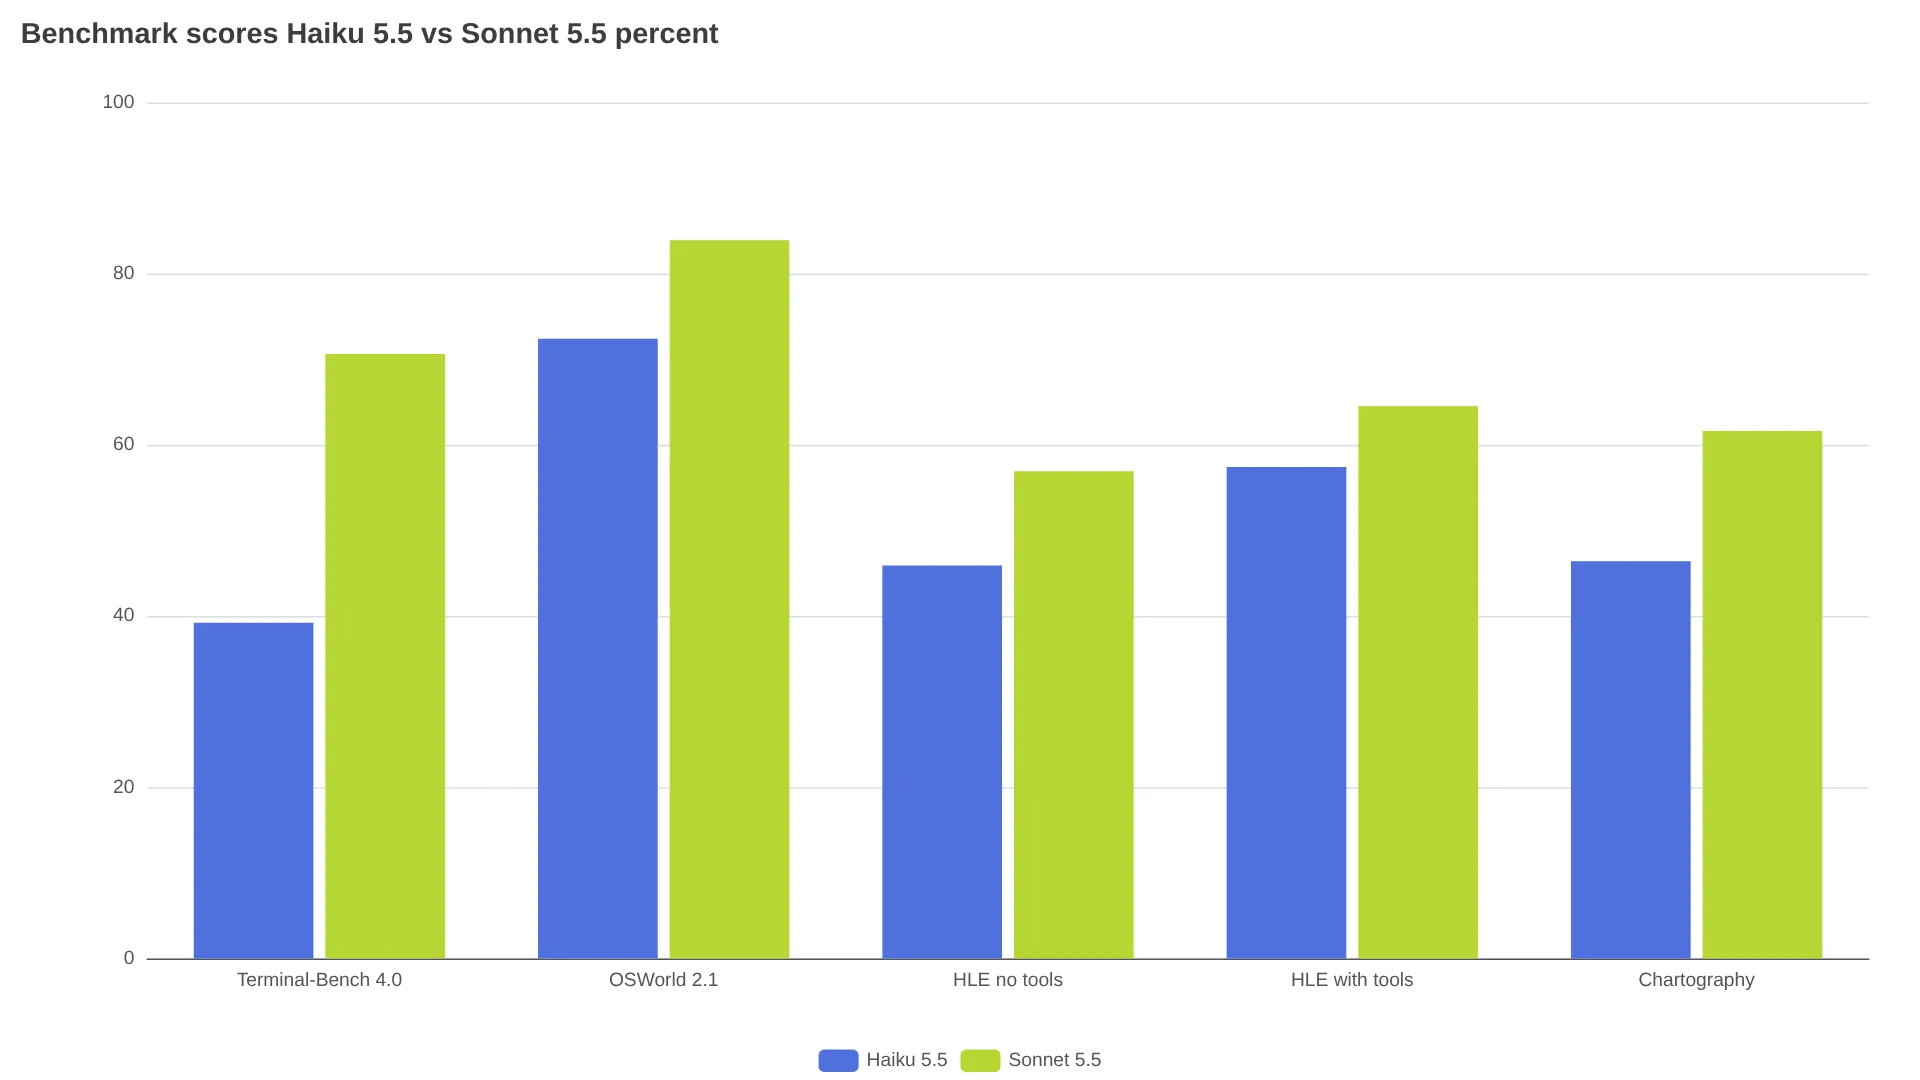
Los benchmarks publicados sitúan a Sonnet 5.5 por delante en todos los enfrentamientos directos comunicados por Anthropic. La mayor distancia aparece cuando los agentes escriben y ejecutan código. En programación agéntica, Terminal-Bench 4.0 da un 39.2% a Haiku 5.5 frente a un 70.6% a Sonnet 5.5. En uso de ordenador, OSWorld 2.1 está más igualado: 72.4% frente a 83.9%. Humanity's Last Exam sin herramientas marca 45.9% frente a 56.9%, y con herramientas 57.4% frente a 64.5%, según la tabla de benchmarks recopilada en la comparativa de APIKO.
Los ajustes de esfuerzo reducen o amplían esas diferencias. Los resultados de Artificial Analysis citados en la misma comparativa sitúan tanto a Haiku xhigh como a Sonnet medium en 41 puntos del Intelligence Index, con resultados casi idénticos en Terminal-Bench (29.3% frente a 29.8%). Sin embargo, Haiku xhigh costó $0.12 por tarea frente a $0.48 de Sonnet medium, aunque tardó 295 segundos frente a 122 segundos. Ninguna configuración de Haiku alcanzó en ese conjunto de datos la puntuación de 47 de Sonnet con su valor predeterminado high. Estos costes no incluyen el tramo de Haiku por encima de 100K, así que son un mínimo para trabajo con contexto largo.
La extracción y clasificación acotadas no necesitan la ventaja de Sonnet en programación. Sí la necesitan los agentes principales de código, los bucles largos de herramientas y el razonamiento visual, donde Chartography obtiene 46.4% frente a 61.6%. No conviene interpretar un único Elo o índice como una clasificación universal de calidad. Una prueba de Reddit encontró que Haiku-medium igualaba a Sonnet en una base de código mixta de Rust y código heredado por $0.08 frente a $1.68, mientras que Haiku-high hizo 385 peticiones sin mejorar la calidad en ese mismo flujo, según la prueba controlada de programación con Haiku 5.5 de r/ClaudeCode.
El ajuste de esfuerzo pesa más que la gama: Haiku low frente a Sonnet low
El esfuerzo predeterminado explica muchas quejas de que «Haiku es verboso». Haiku 5.5 usa medium por defecto y Sonnet 5.5 usa high; además, la configuración de pensamiento cambia según el modelo. Haiku desactiva el pensamiento con {"type": "disabled"}, mientras que Sonnet utiliza {"type": "between_tools"} con esfuerzo high e inferiores, y adaptive o pensamiento omitido en xhigh/max, como documentan las docs de la plataforma Claude y las notas de comportamiento de APIKO.
En la evaluación de APIKO del endpoint Messages, realizada el 10 de octubre de 2026 con 22 tareas y 528 peticiones, Haiku en low superó 65 de 66 ejecuciones, frente a entre 64 y 66 para Sonnet según la configuración, a aproximadamente una dieciochoava parte del coste de gateway en esas tareas cortas. Desactivar por completo el pensamiento redujo a Haiku a 56 de 66, con fallos concentrados en razonamiento y formatos estrictos, como una suma en CSV y el seguimiento de código. Haiku con el valor predeterminado medium superó las 66 de 66, pero emitió 4.4x más tokens de salida que Haiku en low, principalmente tokens de pensamiento.
Reglas prácticas derivadas de esos datos y de informes de usuarios:
- Empieza por Haiku
low: para tareas acotadas —clasificación, enrutamiento, extracción o JSON corto—, no por el valor predeterminadomediumde Haiku. - Sube Haiku antes de bajar Sonnet: prueba Haiku
highoxhighantes que Sonnetlowsi buscas mejor calidad manteniendo precios de Haiku. Según las cifras de Artificial Analysis citadas en la comparativa de APIKO, Haikumaxobtuvo 43 frente a 36 de Sonnetlow, con cerca del 60% del coste. - Reserva Sonnet para los casos exigentes: usa Sonnet
mediumo superior en depuración, implementaciones de varios pasos y secuencias largas de herramientas, donde la latencia adicional de Haiku-high no aporta más calidad. - Configura el pensamiento para cada modelo: en código compartido, una plantilla que envíe
between_toolsa Haiku odisableda Sonnet devuelve un 400 del upstream, según la prueba de gateway de APIKO.
"Opus/Sonnet como orquestador y revisor principal, y Haiku como trabajador de apoyo, con una instancia nueva de Haiku por funcionalidad." — u/ohrajaaa en r/ClaudeAI
Enruta según el coste de equivocarse en silencio, no según la dificultad
La pregunta útil para enrutar no es «¿es difícil esta tarea?», sino «¿qué ocurre si Haiku se equivoca de forma plausible y nadie lo detecta?». Varias pruebas de usuarios citadas reflejan la misma división: Haiku falla en silencio en tareas que exigen criterio, mientras que Sonnet compensa su coste cuando verificar el resultado sale caro.
| Si la tarea se parece a | Modelo principal |
|---|---|
| Clasificación de sentimiento, enrutamiento de tickets, permisos a JSON, resúmenes de logs, OCR y anotación, selección SQL, subagentes de compactación | Haiku 5.5 |
| Búsqueda en bases de código, ediciones de un archivo, procesamiento de documentos en un solo turno | Haiku 5.5 |
| Agente principal de código, depuración real, refactorizaciones de varios pasos, verificación de hechos, atribución documental | Sonnet 5.5 |
Los usuarios informan de una velocidad 3x mayor y grandes reducciones de uso en patrones de Haiku de alto volumen y un solo turno. Entre ellos hay un caso que procesó varios megabytes de documentos por un par de dólares, según r/ClaudeAI y su debate «What is Haiku 5.5 best suited for?».
Una comparación de subagentes en seis tareas encontró que Haiku era barato, pero notablemente menos fiable para investigación y juicio factual, con archivos omitidos que «parecen un resultado limpio», según la prueba de subagentes Haiku vs Sonnet vs Opus de r/ClaudeCode. La regla de seguridad de ese hilo es directa:
"Si la salida desencadena una acción… o se envía a un modelo más grande o un modelo más grande la revisa." — u/vladgladi en r/ClaudeCode
Una advertencia de producción: cumplir con salidas estructuradas no es gratis con Haiku. La evaluación de APIKO registró un fallo de formato estricto con low —etiquetas correctas dentro de un objeto JSON en lugar de un array sin envolver—, y usuarios de r/ClaudeCode informan de verificaciones omitidas y restricciones ignoradas con esfuerzo bajo, según la misma prueba controlada de programación.
Una arquitectura Haiku-first que aguanta en producción
El código de integración debe gestionar el pensamiento, la elección de herramientas y el historial específicos de cada modelo, según la prueba de gateway de APIKO del 10 de octubre con patrones documentados. Haiku acepta tool_choice forzado, mientras que Sonnet lo rechaza en el upstream —usa auto o salidas estructuradas—. Haiku tampoco puede leer bloques de pensamiento de Sonnet; Sonnet sí puede leer los de Haiku si el historial se mantiene solo por anexado. Reproducir bloques de Sonnet editados puede devolver un 400.
Un patrón Haiku-first al que los usuarios llegan de forma independiente una y otra vez:
- Primera pasada con Haiku: llama a Haiku 5.5 con esfuerzo
lowpara clasificar, extraer o redactar. Para desactivar por completo el pensamiento, usathinking: {"type": "disabled"}. - Valida antes de aceptar: acepta solo etiquetas permitidas o JSON válido frente al esquema; escala a Sonnet 5.5 con
mediumtodo lo incierto, inválido o relevante. - Mantén subagentes desechables: una instancia de Haiku por archivo o funcionalidad, en lugar de alargar una conversación por encima de 100K.
- Revisa las salidas que actúan: coloca Sonnet u Opus como revisor siempre que el resultado active una acción, envíe un mensaje o edite código de producción.
"Haiku es muy bueno si sabes qué hacer y cómo revisar su calidad." — u/Awric en r/ClaudeCode
Anthropic posiciona Haiku 5.5 como subagente para tareas de gran volumen, como resúmenes, junto a Sonnet u Opus, según @ClaudeDevs. Una configuración compartida usa enjambres de Haiku para buscar en repositorios mientras Sonnet mantiene los diffs y las pruebas, según @mirku21.
Preguntas frecuentes sobre Haiku 5.5 y Sonnet 5.5
¿Cuánto más barato es Haiku 5.5 que Sonnet 5.5?
A tarifa de lista, cuesta 20x menos por debajo de 100K tokens de prompt ($0.10/$0.50 frente a $2/$10 por 1M) y 4x menos por encima de 100K ($0.50/$2.50 frente a $2/$10). Las lecturas de caché cuestan $0.01 frente a $0.10 por 1M.
¿Haiku 5.5 y Sonnet 5.5 tienen la misma ventana de contexto?
Sí. Ambos anuncian una ventana de contexto de 1M de tokens y una salida máxima de 128K, según Anthropic y la documentación de la plataforma.
¿Haiku 5.5 es suficiente para uso de API en producción?
Para tareas acotadas, de gran volumen e inspeccionables, sí; normalmente con esfuerzo low y validación de esquema. Para programación con agente principal e investigación con mucho juicio, los usuarios reportan más fallos y falsos positivos que con Sonnet 5.5.
¿Qué modelo es mejor para agentes de programación?
Sonnet 5.5 para el agente principal y la depuración (Terminal-Bench: 70.6% frente a 39.2%). Haiku 5.5 para búsqueda, escritura y trabajo de subagente sobre un único archivo, con revisión de Sonnet u Opus.
¿Cómo puedo mantenerme bajo el umbral de 100K de Haiku?
Divide los documentos antes del umbral, limita los subagentes a archivos concretos, silencia las salidas verbosas de pruebas e inicia subagentes nuevos por tarea. El historial agéntico supera los 100K en alrededor de 20 llamadas.
¿Puedo pasar una conversación de Sonnet 5.5 a Haiku 5.5 a mitad de camino?
No de forma limpia. Haiku no puede leer bloques de pensamiento de Sonnet, así que debes continuar con Sonnet o reiniciar con Haiku. Pasar el historial de Haiku a Sonnet conserva el razonamiento si se ha mantenido solo por anexado.
La concesión que ningún enrutador puede evitar
| Si tu carga de trabajo se parece a | Elige | Motivo |
|---|---|---|
| Cientos de clasificaciones, extracciones, resúmenes y normalizaciones JSON | Haiku 5.5 en low | Tasas de acierto cercanas a Sonnet en tareas breves, a cerca de 1/18 del coste cuando se valida |
| Una gran base de código, bucles largos de herramientas, depuración que debe acertar | Sonnet 5.5 | Ventaja de 31 puntos en Terminal-Bench y menos fallos silenciosos |
| Documentos que rondan los 100K | Calcula ambos precios | El tramo 5x de Haiku borra gran parte de la diferencia; por encima del límite, Sonnet solo cuesta 4x más |
| Cualquier caso en el que un error silencioso llegue a producción | Borrador con Haiku y revisión con Sonnet | El coste por éxito verificado importa más que el precio nominal por token |
Haiku 5.5 gana en coste por intento. Sonnet puede salir más barato cuando la revisión y las repeticiones dominan el coste de tokens. Diseña el enrutador en torno a esa diferencia y ninguno de los dos modelos será una apuesta.