 AIREITER
Eine Million Tokens Kontext und ein Endpoint für 0 $ klingen nach einer einfachen Standardlösung. Bei der Nemotron 3 Ultra API gilt das aber nur für erste Tests: Für den Produktiveinsatz zählen die Zuverlässigkeit des Providers, der Umgang mit Daten und ein kostenpflichtiger Fallback.
Lohnt sich die Nemotron 3 Ultra API?
Die Nemotron 3 Ultra API ist einen Test wert, wenn es um lang laufende Text-Agenten, die Analyse großer Dokumente oder Coding-Workflows mit sehr langem Kontext geht. Für schnelle Standard-Chats, vertrauliche Prompts über einen protokollierten kostenlosen Endpoint oder einen Produktivdienst ohne Ausweichroute ist sie dagegen keine gute Standardwahl.
NVIDIA hat Nemotron 3 Ultra am 4. Juni 2026 veröffentlicht. Die offizielle Model Card führt den NVFP4-Checkpoint als Version 1.0 GA. Die Lizenz erlaubt die kommerzielle und nichtkommerzielle Nutzung gemäß OpenMDW 1.1.
| Entscheidungsfaktor | Bestätigter Wert | Warum das wichtig ist |
|---|---|---|
| Modellgröße | 550B gesamt, 55B aktiv | Sparse-Berechnung macht die vollständigen Gewichte nicht klein |
| Maximaler Kontext | Bis zu 1 Mio. Tokens | Provider können je nach Route niedrigere Limits setzen |
| Modalität | Text als Ein- und Ausgabe | Kein Verständnis von Bildern oder Videos |
| Offizieller NVFP4-SWE-Bench-Verified-Wert | 69.7 | Relevanter Hinweis für die Bewertung von Coding-Agenten |
| Offizieller NVFP4-RULER-1M-Wert | 94.0 | Stützt den Einsatz bei sehr langem Kontext |
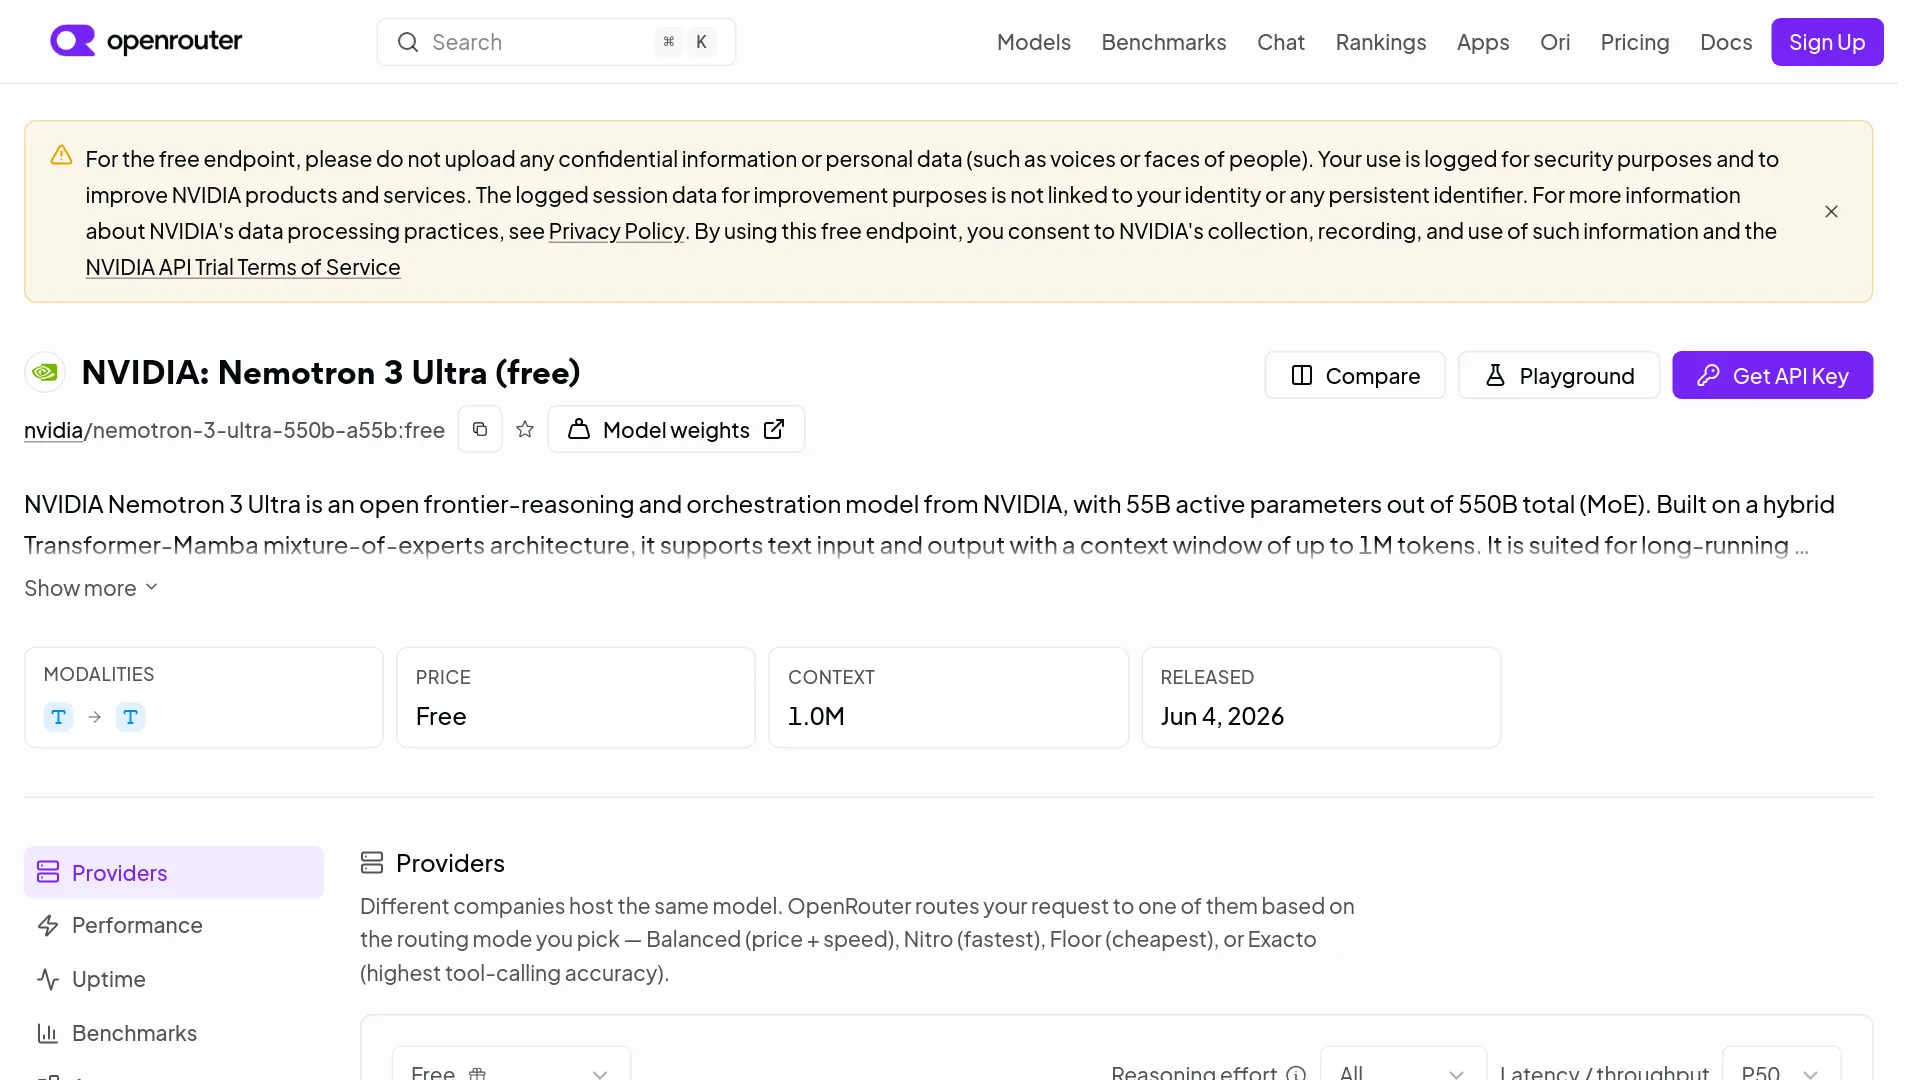
| OpenRouter-Preis kostenlos | $0 Input, $0 Output | Für Tests geeignet, aber kein SLA |
| Snapshot der kostenlosen OpenRouter-Verfügbarkeit | 84.07% erfolgreich über drei Tage | Erreichbarkeit bedeutete nicht immer Nutzbarkeit |
| Offizielles Minimum für Self-Hosting | 4x B200-Klasse oder 8x H100 | Kein typisches Workstation-Deployment |
Die oben genannten Benchmarkwerte stammen aus der Model Card von NVIDIA und sollten als Ergebnisse des Herstellers eingeordnet werden. Die OpenRouter-Verfügbarkeit ist eine dynamische Messung des Providers und keine dauerhafte Zusage.
Die kostenlose Nemotron-3-Ultra-API in fünf Minuten aufrufen
Der schnellste kostenlose Weg führt über OpenRouters OpenAI-kompatiblen Chat-Completions-Endpoint und die exakte Model-ID nvidia/nemotron-3-ultra-550b-a55b:free. Erstelle einen OpenRouter-Key, hinterlege ihn in einer Umgebungsvariable und schicke zunächst einen kleinen Test, bevor du einen Job mit langem Kontext startest.
- Erstelle einen API-Key in OpenRouter.
- Exportiere ihn als
OPENROUTER_API_KEY. - Rufe
/api/v1/chat/completionsmit der kostenlosen Model-ID auf. - Protokolliere bei der Evaluierung HTTP-Status, Latenz und leere Antworten.
- Ergänze vor dem Produktiveinsatz eine kostenpflichtige Route oder ein anderes Modell.
curl https://openrouter.ai/api/v1/chat/completions \
  -H "Authorization: Bearer $OPENROUTER_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nvidia/nemotron-3-ultra-550b-a55b:free",
    "messages": [
      {
        "role": "user",
        "content": "Return three risks in this migration plan as a numbered list."
      }
    ],
    "max_tokens": 500
  }'
Mit dem OpenAI-Python-Client funktioniert dieselbe Route, wenn du base_url und model anpasst:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["OPENROUTER_API_KEY"],
    base_url="https://openrouter.ai/api/v1",
)

response = client.chat.completions.create(
    model="nvidia/nemotron-3-ultra-550b-a55b:free",
    messages=[
        {
            "role": "user",
            "content": "Inspect this plan and list the three highest-impact risks.",
        }
    ],
    max_tokens=500,
)

print(response.choices[0].message.content)
Was die kostenlose Route tatsächlich zusichert
Die kostenlose Nemotron-3-Ultra-Route garantiert weder unbegrenzte Kapazität noch Verfügbarkeit für den Produktiveinsatz. Der OpenRouter-Eintrag kennzeichnet kostenlose Endpoints als rate-limitiert, veröffentlicht auf der Modellseite aber kein exaktes Kontingent. Der Snapshot vom 19. September zeigte über drei Tage eine Erreichbarkeit von 100 %, aber nur 84.07 % erfolgreiche Verfügbarkeit. Fehler und leere Antworten wurden dabei als Fehlschläge gezählt.
OpenRouter wies in diesem Snapshot 1 Mio. Tokens Kontext, maximal 65,536 Tokens pro Completion, Tool-Calling, eine mediane Latenz von 2.28 Sekunden und einen medianen Durchsatz von 29 Tokens pro Sekunde aus.
Außerdem gibt es eine Grenze auf Provider-Ebene: Der kostenlose OpenRouter-Eintrag unterstützte tools und tool_choice, setzte response_format aber nicht durch. Segmind dokumentiert für seine kostenpflichtige Route JSON-Schema-Ausgaben zu $0.625 pro einer Million Input-Tokens und $2.75 pro einer Million Output-Tokens. Code, der auf strikt validem JSON beruht, muss daher mit dem ausgewählten Provider getestet werden. Die Unterstützung lässt sich nicht einfach vom Basismodell ableiten.
Vertrauliche oder personenbezogene Daten gehören nicht in die kostenlose OpenRouter-Route. Laut Eintrag wird die Nutzung zu Sicherheitszwecken protokolliert und kann zur Verbesserung von NVIDIA-Produkten und -Diensten verwendet werden. Bei einem 429-Fehler, Timeout oder einer leeren Antwort solltest du eine begrenzte exponentielle Wartezeit verwenden und anschließend auf eine kostenpflichtige Route ausweichen. Eine Agentenaktion darf nicht endlos wiederholt werden.
Was 550B A55B in der Praxis bedeutet
Die Bezeichnung 550B-A55B bedeutet: Nemotron 3 Ultra enthält insgesamt 550 Milliarden Parameter, aktiviert pro Token aber etwa 55 Milliarden davon. NVIDIA kombiniert LatentMoE-Routing, Mamba-2, ausgewählte Attention-Layer und Multi-Token Prediction. Die sparse Aktivierung reduziert zwar die Berechnung pro Token, doch die vollständigen Gewichte müssen weiterhin gespeichert, verteilt oder ausgelagert werden. A55B macht daraus also kein 55B-Deployment.
Der Forschungsbeitrag von NVIDIA nennt bis zu 1 Mio. Tokens Kontext und vergleicht den Durchsatz anhand eines ungewöhnlichen Workloads mit 8.000 Input- und 64.000 Output-Tokens. NVIDIA behauptet gegenüber GLM-5.1-754B-A40B einen 5.9-fachen, gegenüber Kimi-K2.6-1T-A32B einen 4.8-fachen und gegenüber Qwen-3.5-397B-17B einen 1.6-fachen Durchsatz. Absolute Durchsatzwerte und Hardwaredetails fehlen auf der Seite. Diese Multiplikatoren sollten deshalb nicht in Erwartungen an die API-Latenz übersetzt werden.
Für die Deployment-Planung ist die offizielle BF16/NVFP4-Tabelle aussagekräftiger:
| Benchmark | BF16 | NVFP4 | Praktische Einordnung |
|---|---|---|---|
| SWE-Bench Verified | 71.9 | 69.7 | Quantisierung kostet bei diesem Coding-Test 2.2 Punkte |
| Terminal Bench 2.1 | 56.4 | 53.9 | Auch bei agentischen Terminal-Aufgaben gibt es einen Rückgang |
| TauBench V3 Durchschnitt | 70.9 | 70.3 | Der Durchschnitt bei Tool-Nutzung bleibt ähnlich |
| GPQA, ohne Tools | 87.0 | 87.9 | NVFP4 ist nicht durchgehend schwächer |
| RULER 1M | 94.7 | 94.0 | Die Suche in langem Kontext bleibt ähnlich stark |
| OmniScience, Nicht-Halluzination | 78.7 | 75.5 | Faktenqualität muss weiterhin geprüft werden |
Die Unterschiede hängen von der Aufgabe ab: Bei der Nicht-Halluzinationsmessung verliert NVFP4 3.2 Punkte, bei GPQA gewinnt es 0.9 Punkte.
Nach Aufgabe auswählen, nicht nach Parameterzahl
Nemotron 3 Ultra sollte anhand des Workloads verglichen werden, der tatsächlich produktiv laufen soll – nicht anhand der Modellgröße. Für diesen Leitfaden wurde kein Ergebnis unter einem identischen Harness erhoben, das einen universellen Sieger belegt. Die belastbare Vorgehensweise ist deshalb ein Testplan mit klar geprüften Grenzen.
| Aufgabe | Startpunkt | Vor der Entscheidung testen |
|---|---|---|
| Retrieval oder Dokumentensynthese mit einer Million Tokens | Nemotron 3 Ultra | Der offizielle NVFP4-RULER-1M-Wert liegt bei 94.0; teste die Retrieval-Genauigkeit und die Prefill-Latenz bei der tatsächlichen Prompt-Länge |
| Lang laufender Coding-Agent | Nemotron 3 Ultra oder DeepSeek V4 | Nemotron erreicht 69.7 bei SWE-Bench Verified und 53.9 bei Terminal Bench 2.1; vergleiche den Erfolg bei Repository-Aufgaben und die Gültigkeit von Tool-Aufrufen in einem gemeinsamen Harness |
| Automatisierung mit strukturierten Ausgaben | GLM 5.2, Qwen 3.8 Max oder ein Nemotron-Provider mit Schema-Unterstützung | OpenRouter Free erzwingt response_format nicht; miss Schema-Treue und Wiederholungen auf der konkreten Route |
| Viele kurze Anfragen | DeepSeek V4, GLM 5.2 oder Qwen 3.8 Max | Vergleiche die Kosten pro erfolgreicher Aufgabe und die p95-Latenz; die Größe von Ultra ist nicht automatisch ein Vorteil |
| Deployment mit offenen Gewichten auf NVIDIA-Hardware | Nemotron 3 Ultra | Vergleiche BF16 und NVFP4 anhand der Zielaufgabe und berechne anschließend die dauerhaft erzielbare Auslastung |
DeepSeek V4 und GLM 5.2 verfügen auf AIReiter über eigene API-Oberflächen, während Qwen 3.8 Max als gehostetes Chat-Modell verfügbar ist: DeepSeek V4 Pro API guide, GLM 5.2 API review und Qwen 3.8 Max API pricing. Das sind Alternativen für die Evaluierung – keine Behauptung, dass eines dieser Modelle jede Aufgabe gewinnt.
Lässt sich Nemotron 3 Ultra lokal betreiben?
Nemotron 3 Ultra kann selbst gehostet werden. „Lokal“ bedeutet hier allerdings Rechenzentrum-Hardware oder eine DGX Station, nicht einen Laptop. NVIDIA nennt 4x GB200, 4x B200, 4x GB300, 4x B300 oder 8x H100 als Mindestkonfigurationen für den normalen Deployment-Weg.
Die offiziellen vLLM-Beispiele in NVIDIAs Model Card verwenden 4-Wege-Tensor- und Expert-Parallelism, einen FP8-KV-Cache, Chunked Prefill und MTP-Spekulativ-Decoding. Ein Standardbeispiel ist auf 262,144 Tokens voreingestellt. Für 1,048,576 Tokens ist ein expliziter Override nötig. Der beworbene Kontext ist also nicht die Standardkonfiguration für das Serving.
NVIDIA dokumentiert außerdem ein spezielles Deployment auf einer einzelnen DGX Station. Dabei läuft der NVFP4-Checkpoint auf einer integrierten GB300-GPU, während bis zu 150 GiB kohärenter CPU-Speicher verfügbar gemacht und Expert-Gewichte ausgelagert werden. Dieses Rezept setzt vLLM 0.22.0, das Blackwell-spezifische NVFP4-Backend und die Speicherarchitektur der DGX Station voraus. Auf einen gewöhnlichen PC mit einer GPU lässt es sich nicht übertragen.
| Deployment | Die richtige Wahl, wenn | Wichtigste Einschränkung |
|---|---|---|
| Kostenlose OpenRouter-API | Prompts und Tool-Verhalten evaluiert werden sollen | Rate-Limits, Logging und schwankende Verfügbarkeit |
| Gehostete, kostenpflichtige API | Der Dienst live gehen soll, bevor sich eigene Hardware rechnet | Unterschiede bei Provider-Preis, Präzision, Kontext und Funktionen |
| 4x B200-Klasse / 8x H100 im Self-Hosting | Dauerhafte Auslastung, Datenkontrolle oder Modellanpassungen wichtig sind | Anschaffungskosten und Betrieb verteilter Inferenz |
| Einzelne GB300-DGX-Station mit Offloading | Genau dieses System mit kohärentem Speicher vorhanden ist | Offloading-Latenz und starke Hardwarebindung |
FAQ zur Nemotron 3 Ultra API
Ist die Nemotron 3 Ultra API kostenlos?
Ja. OpenRouter listet nvidia/nemotron-3-ultra-550b-a55b:free mit $0 für Input- und Output-Tokens. Der Endpoint ist allerdings rate-limitiert und wird protokolliert.
Unterstützt Nemotron 3 Ultra wirklich eine Million Tokens?
NVIDIA gibt ein Maximum von 1 Mio. Tokens an. Provider-Routen können jedoch niedrigere Standardwerte verwenden. NVIDIAs vLLM-Beispiel ist auf 262,144 Tokens voreingestellt, sofern der Betreiber nicht 1,048,576 aktiviert.
Unterstützt die API Tools und strukturiertes JSON?
Das Modell unterstützt Tools, die Durchsetzung hängt aber vom Provider ab: OpenRouter Free bietet kein erzwungenes response_format, während Segmind ein striktes JSON-Schema dokumentiert.
Darf ich Nemotron 3 Ultra kommerziell einsetzen?
NVIDIA erklärt, dass die Veröffentlichung unter OpenMDW 1.1 die kommerzielle und nichtkommerzielle Nutzung erlaubt. Prüfe die über die offizielle Model Card verlinkten Lizenzbedingungen zu Weitergabe und Deployment-Pflichten.
Kann ich das Reasoning abschalten?
NVIDIAs API-Dokumentation stellt enable_thinking=True/False bereit. Gehostete Provider können diese Steuerung anders abbilden. Prüfe deshalb den akzeptierten Parameter und die Token-Abrechnung für die ausgewählte Route.
Ist 550B A55B gleichbedeutend mit einem dichten 55B-Modell?
Nein. Pro Token sind zwar etwa 55B Parameter aktiv, aber alle 550B Parameter müssen weiterhin gespeichert, verteilt oder ausgelagert werden.
Eine Deployment-Entscheidung statt eines Benchmark-Pokals
Der beste erste Schritt ist die kostenlose Nemotron-3-Ultra-API mit nicht sensiblen Prompts und einem kleinen Evaluierungsdatensatz. Wechsle zu einem kostenpflichtigen Endpoint, sobald Fehler, Schema-Durchsetzung oder planbare Kapazität wichtig werden. Self-Hosting lohnt sich erst, wenn gemessene Auslastung, Datenschutz oder Anpassbarkeit mindestens vier aktuelle GPUs mit viel Speicher oder den dokumentierten DGX-Station-Weg rechtfertigen.
| Ergebnis nach dem Test | Nächster Schritt |
|---|---|
| Die Qualität ist stark, aber kostenlose Aufrufe schlagen fehl oder warten | Eine kostenpflichtige Nemotron-Route und eine Retry-Policy ergänzen |
| Retrieval mit langem Kontext ist der entscheidende Vorteil | Das größte reale Dokument testen und die Prefill-Zeit messen |
| JSON-Fehler dominieren | Einen Provider mit Schema-Durchsetzung verwenden oder GLM-/Qwen-Routen vergleichen |
| Kosten oder Latenz bei kurzen Aufgaben sind ausschlaggebend | Ein kleineres Modell bevorzugen und Ultra für Eskalationen reservieren |
| Daten dürfen das eigene Netzwerk nicht verlassen | Vor der Entscheidung das offizielle Multi-GPU-Deployment budgetieren |