 AIREITER
GLM-5.2 nimmt auf nahezu jedem Zugangsweg Anfragen im OpenAI-Format entgegen. Dahinter verhält sich jedoch kaum ein Endpoint wie der andere. Seit dem Launch am 16. Juni ist die GLM-5.2 API für preisbewusste Coding- und Agent-Workloads interessant — sofern man drei Schwachstellen selbst absichert: Tool-Call-Semantik, Retry-Stürme und Cache-Abrechnung. Der Listenpreis von $1.40/$4.40 pro Million Tokens stimmt. Was ein abgeschlossener Task tatsächlich kostet, ist eine andere Rechnung. Genau diese Differenz beleuchtet dieser Test.
OpenAI-kompatibel — aber nur bis zur Anfrage
Die offiziellen GLM-5.2-Dokumentation unterstützt das OpenAI Python SDK mit der Base URL https://api.z.ai/api/paas/v4/ und der Modell-ID glm-5.2. Eine einfache Chat-Integration ist damit tatsächlich mit drei geänderten Zeilen erledigt. Kompatibel ist aber vor allem das Anfrageformat. Response-Semantik, optionale OpenAI-Steuerfelder und die neuere Responses API gehören nicht dazu.
| Dokumentierter Vertrag | Wert |
|---|---|
| Modalität | Text rein, Text raus (keine Bildverarbeitung) |
| Kontextfenster | 1M Tokens |
| Maximale Ausgabe | 128K Tokens |
| Dokumentierte Funktionen | Thinking-Modus, Streaming, Function Call, Context Caching, Structured Output, MCP |
| Verbrauchsbasierter Endpoint | https://api.z.ai/api/paas/v4/ |
| Coding-Plan-Endpoint | https://api.z.ai/api/coding/paas/v4 |
| Anthropic-kompatibler Endpoint | https://api.z.ai/api/anthropic |
| Offizielle SDKs | zai-sdk (Python), Java, OpenAI SDK |
Die erste klare Grenze: Z.ai bietet überhaupt keine Responses API. „Codex only supports the Responses API format, which isn't available at Z.ai“, schreibt u/quinncom; andere Nutzer schalten deshalb ZenMux als Übersetzungsschicht dazwischen. Die zweite Grenze betrifft Claude Code: Über den Anthropic-kompatiblen Endpoint funktioniert es, doch Konfigurationshinweise von @armor_rust nennen zwei Fallen. Erstens muss AUTH_TOKEN statt API_KEY verwendet werden; letzteres löst eine Vertrauensabfrage aus, die nach einer Ablehnung dauerhaft verweigern kann. Zweitens unterscheiden sich die Base URLs für Abo und Pay-as-you-go. Die vollständige Anleitung steht in unserem Claude-Code-Setup-Guide.
Ein Entwickler fasst es treffend zusammen: „api compatibility stops at request shape; tool calling still needs provider-specific evals“ — @sebuzdugan.
Tool Calling: in kleinen Tests sauber, in langen Loops riskant
In kurzen, kontrollierten Tool-Loops liefert die GLM-5.2 API genau das, was die Dokumentation verspricht. Bei lang laufenden Agent-Schleifen berichten intensive Nutzer dagegen von beschädigten Aufrufsequenzen, die so lange kreisen, bis eigene Limits sie abbrechen. Beides kann gleichzeitig stimmen: Entscheidend ist, welche Art von Loop gebaut werden soll.
Der dokumentierte Umfang laut Z.ai-Dokumentation und dem Docker-Test von GLM52.ai mit 27 Requests: bis zu 128 Funktionsdefinitionen, Namen mit maximal 64 Zeichen nach ^[a-zA-Z0-9_-]+$, Parameter als JSON Schema, Argumente als JSON-String zur Validierung durch die Anwendung und dokumentiert ausschließlich tool_choice: "auto". Über die Coding-Plan-Route bestand die Suite alle 27/27 Requests: 4/4 exakte Treffer bei Tool und Argumenten, 3/3 korrekte Antworten ohne Tool, 4/4 zwei Bestellungen in zwei Top-Level-Calls und 5.3 Sekunden Median-Latenz.
Problematisch sind die Steuerfelder, deren Existenz OpenAI-Nutzer voraussetzen. Als GLM52.ai widersprüchliche Probes schickte, antwortete der Endpoint mit HTTP 200 — und ignorierte anschließend die Vorgaben:
| Gesendete OpenAI-ähnliche Steuerung | Beobachtetes Verhalten |
|---|---|
tool_choice: "required" + „do not use any tool“ | Beendet, keine Calls |
| Objekt zur erzwungenen Funktion + „never use this tool“ | Beendet, keine Calls |
parallel_tool_calls: false + Prompt mit zwei Bestellungen | Trotzdem zwei Calls zurückgegeben |
strict: true | Einmal akzeptiert; kein Beleg für Schema-Enforcement |
Ein akzeptierter HTTP-Request ist kein Vertrag über das tatsächliche Verhalten. In langen Loops werden diese Bruchstellen sichtbar.
Ein Entwickler, der etwa vier Milliarden Tokens durch das Modell geschickt hat, formuliert es unverblümt: „biggest issue with GLM 5.2 4bil tokens in was the lack of vision, some tool call confusion, tool call corruption death (it just spirals)“ — @RasputinKaiser. Dazu kommt ein einzelner, unbeantworteter Bericht, in dem das Modell einen zweiten Tool Call in den Argumenten des ersten kodierte. Das ist nur ein Fall, aber exakt die Fehlerklasse, gegen die ein clientseitiger Loop geschützt sein muss.
Die praxistaugliche Abwehr: Das Modell sollte die Orchestrierung nicht selbst steuern. Ein Entwickler betreibt NVIDIA NIM mit tool_call: false und überlässt dem Agent-Framework die gesamte Schleife. Der begrenzte Referenz-Loop deckelt Modellschritte auf vier, erlaubt maximal vier Calls pro Turn und validiert jedes Argument-JSON vor der Ausführung.
Streaming und Latenz: die kaum beworbenen Werte
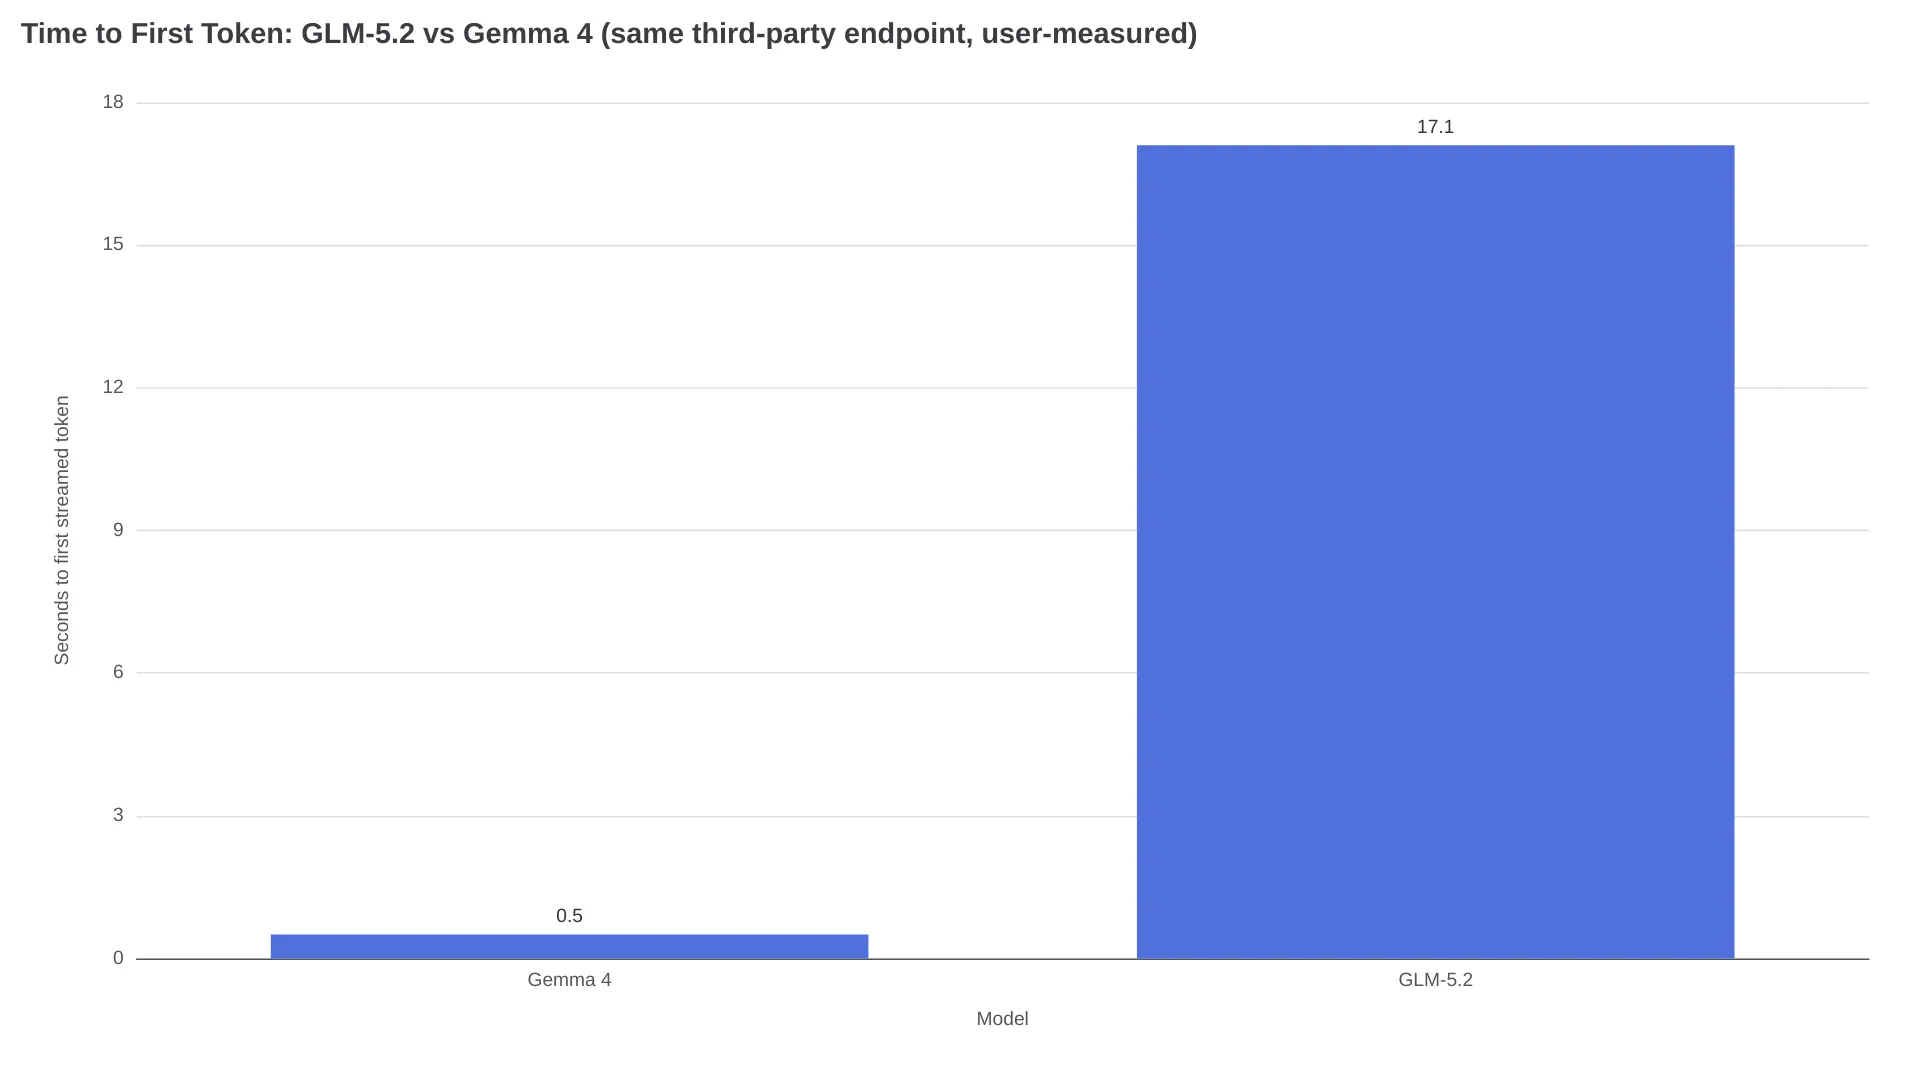
Die Time-to-first-token ist der schwächste gemessene Wert der API. In einem Endpoint-Vergleich auf Sarvam erreichte GLM-5.2 beim Streaming 148 Tokens pro Sekunde gegenüber 260 bei Gemma 4. Bei der Zeit bis zum ersten Token standen 17.1 Sekunden gegen 0.5 Sekunden zu Buche — „starts generating 33x sooner“, so @noctus91.
Auch bei der beworbenen Durchsatzrate zeigt sich dasselbe Muster:
„All these GLM 5.2 providers advertise 200+ tok/s. Yet you try them and get 50 tok/s“ — @tomgreenwald, der das „benchmaxxing but for providers“ nennt.
Von Abo-Routen werden zwei weitere Fehlerbilder gemeldet: Streams, die mitten in der Sitzung abbrechen — „the streaming just...stopped“, woraufhin ein GLM Pro Coding Plan-Nutzer ganz aufgab — sowie eine Verschlechterung bei großem Kontext: „when you reach 300k+ context the model getting slow“ (@mosh_Ontong). Zum Vergleich: Der ausgeführte Benchmark von DataLLM Lab mit neun Tasks auf dem eigenen Gateway brauchte durchschnittlich 12.3 Sekunden pro abgeschlossenem Task. Für die Latenz entscheidet der Endpoint stärker als das Modell.
Rate Limits und 429er: Retries gehören zum Betrieb
In der Modelldokumentation von Z.ai fehlt eine Tabelle zu Rate Limits. Entwickler lernen ihre Grenzen daher empirisch kennen — über 429er. Bei den Coding-Plan-Routen wirken Retries laut Community nicht wie ein Ausnahmefall, sondern wie Normalbetrieb. Die folgenden Threads beschreiben Fehlerbilder, keine Häufigkeitsraten, zeichnen jedoch ein konsistentes Bild.
Aus einem Thread zu Rate Limits in r/ZaiGLM:
- „Right now hitting 429/529 on coding max plan nearly for every second request. No concurrency...“ — u/A-B-user
- „Yes, almost every request is retried, but the results are very good“ — u/hyeluoh
- „It works fine (super slow but no errors) if I use single concurrency for glm52“ — u/evia89
Die Fehler hängen auch vom Client ab: Derselbe API-Key funktioniert in ZCode, wirft aber in OpenClaw 429er. Ein anderer Nutzer beschreibt das als „too busy“-Meldung. Abo-Schichten verschärfen die Lage zusätzlich: Chinesische Nutzer berichten, dass der Coding Plan 5.2-Workloads automatisch auf GLM-5.3 umstellt, was das Kontingent schneller verbraucht. Zudem sollen Drittanbieter-Reseller des Coding Plan bereits nach wenigen Calls drosseln.
Robuste technische Gegenmaßnahmen sind exponentielles Backoff mit Jitter, Idempotency Keys für alles mit Schreibzugriff, ein Retry-Budget pro Task statt pro Request sowie ein Degradationsmodus mit concurrency=1, der sich automatisch aktivieren lässt. Die Retry-Muster aus unserem OpenRouter-429-Guide lassen sich hier unverändert anwenden.
Die offene Frage zur Cache-Abrechnung bei Z.ai
Context Caching ist dokumentiert. Als wir am 13. Juli die Anbieterseiten prüften, wurde gecachter Input mit rund $0.26 pro Million Tokens gegenüber $1.40 für frischen Input aufgeführt. Der ungeklärte Vorwurf — die API-Beschwerde mit dem größten Engagement in den geprüften Community-Threads — lautet jedoch: Auf einigen Routen wird wiederholter Kontext offenbar trotzdem als frischer Input abgerechnet. Das vervielfacht die Kosten jedes Agent-Loops, der einen langen System Prompt erneut sendet.
„cached tokens are not working properly on GLM 5.2. The repeated context is being counted as normal input instead of cached tokens.“ — @Da7_Tech, der dies als „a serious billing/cache accounting problem“ bezeichnet.
Im zugehörigen Thread: Derselbe Task war mit Claude Opus 4.8 in weniger als 1.5M Tokens erledigt. Mit GLM-5.2 blieb er nach 53M Tokens unvollständig, das Fünf-Stunden-Kontingent stand bei 100 %, während der Zähler der Anwendung selbst etwa 1.67M anzeigte.
Zwei Monate später fasste derselbe Entwickler weiterhin zusammen: „plenty of users complain that cache hits appear to count against usage. If that happens to you, the value of the plan collapses.“ Bis Ende August gab es in diesen Threads keine offizielle Antwort.
Bis eine Behebung bestätigt ist, sollte der Preis für gecachten Input als Best Case gelten, der anhand der eigenen Rechnungen verifiziert werden muss: cached_tokens aus dem Usage-Objekt jeder Response protokollieren und wöchentlich abgleichen.
Reasoning Effort: ein Regler, drei Bezeichnungen
Die offizielle Schnittstelle nutzt thinking.type mit enabled/disabled sowie reasoning_effort mit den Werten high und max. Die eigenen Beispiele der Dokumentation verwenden reasoning_effort: "max". Laut Launch-Hinweisen von Z.ai maximiert max die Fähigkeiten, während high Leistung gegen Token-Effizienz abwägt; für Code wird max empfohlen.
Daraus folgen zwei Integrationsdetails. Erstens verwenden Coding-Routen standardmäßig max: „It defaults to max so you don't need to unless you want to scale it down“ (r/ZaiGLM). Reasoning Tokens werden zu Output-Preisen abgerechnet, wodurch der Standard die Ausgaben unbemerkt vervielfachen kann. Bei Coding Plans berichten Nutzer, die die Plan-Abrechnung dokumentiert haben, dass Calls mit maximalem Reasoning Effort im Pekinger Zeitfenster von 14:00–18:00 Uhr das Dreifache des Kontingents verbrauchen — zusätzlich zu einem Fünf-Stunden-Fenster und wöchentlichen Credits.
Zweitens erreicht der Regler das Backend oft gar nicht: OpenCode-Nutzer berichten, dass sich der Reasoning Effort für benutzerdefinierte Provider „currently ... does not let you tweak“ lässt. Einige Clients führen dieselbe Einstellung zudem unter einem dritten Namen, xhigh, den sie möglicherweise überhaupt nicht weiterreichen (r/opencodeCLI). Auch die Ausführlichkeit hängt an diesem Regler: Ein Entwickler, der täglich Vergleiche durchführt, stellte fest, ein Konkurrenzmodell sei „not as verbose as Opus-4.8 or GLM-5.2.“
Gleicher Modellname, andere Deployments: Endpoint Drift
glm-5.2 ist ein Modellstring, der auf deutlich unterschiedliche Deployments zeigen kann. Als Anfang August Ergebnisse zur Endpoint-Genauigkeit kursierten, bat ein Z.ai-Verantwortlicher die Community, „to test the official GLM-5.2 API as an additional reference point. It may score above 100%“ — @ZixuanLi_. Der von ihm genannte Referenzpunkt war die offizielle API, nicht die Drittanbieter-Endpoints aus dem gemessenen Bericht.
In der Praxis zeigt sich dieser Drift etwa durch zu niedrig gesetzte Output-Token-Limits, die Reasoning mitten im Stream abschneiden, durch nachlassenden Durchsatz nach dem Launch-Fenster — das oben beschriebene „benchmaxxing“-Muster — und durch je nach Host abweichende Kontextgrenzen. Together AI bietet GLM-5.2 mit 256K an, während die offizielle API laut Dokumentation 1M bereitstellt und die Aggregatoren aus unserem Juli-Vergleich das volle Fenster führen.
Die Preisunterschiede sind noch größer als die Verhaltensunterschiede: Gegenüber dem Z.ai-Listenpreis von $1.40/$4.40 führte OpenRouter im Juli-Anbietervergleich $0.42/$1.32. Die Preise für gecachten Input reichten von $0.14 bei Fireworks bis $0.26. Den Endpoint nach Workload auswählen und anschließend genau auf diesem Endpoint erneut testen: Ein bestandener Verhaltenstest auf einer Route lässt sich nicht übertragen.
Vor dem Go-live: Pre-Flight-Test in 30 Minuten
Jeder oben beschriebene Fehler lässt sich innerhalb einer halben Stunde erkennen, bevor ein Production-Workload festgelegt wird. Diese Tests sollten gegen exakt den Endpoint, Modellstring und das SDK laufen, die später produktiv eingesetzt werden:
- Tool-Vertrag mit Konflikten testen.
tool_choice: "required"zusammen mit der Anweisung, keine Tools zu nutzen, senden. Ebensoparallel_tool_calls: falsemit einem Prompt für zwei Bestellungen testen. Erwartet wird, dass beides ignoriert wird; hängt die Orchestrierung davon ab, hier stoppen. - Retry-Lasttest. 50 Requests mit der geplanten Concurrency senden und 429/529-Rate sowie den Anteil erfolgreicher Retries protokollieren. Übersteigen Retries ungefähr ein Drittel der Requests — ein konservativer betrieblicher Schwellenwert — Concurrency auf 1 senken und erneut messen.
- Cache-Abrechnung prüfen. Einen identischen Prefix mit 10K Tokens fünfmal erneut senden;
cached_tokensaus den Usage-Responses summieren und mit dem im Dashboard als Input abgerechneten Wert vergleichen. Eine Abweichung macht das Kostenmodell ungültig. - Latenztest mit realer Kontextgröße. Time-to-first-token und Hänger mitten im Stream bei repräsentativen Kontextgrößen messen, nicht nur mit einem Smoke Test über 1K Tokens. Andernfalls bleibt die Verlangsamung oberhalb von 300K unsichtbar.
- Route festlegen. Der Coding Plan ist für interaktive Coding-Tools gedacht. Berichte zur Plan-Abrechnung zufolge ist er nicht für Websites, Bots oder SaaS-Traffic lizenziert. Produkt-Backends gehören deshalb auf die verbrauchsbasierte API.
Der nicht auflösbare Trade-off: GLM-5.2 bietet einige der günstigsten leistungsfähigen Coding-Tokens am Markt. Der Preis dafür ist Wrapper-Engineering, das Frontier-APIs stattdessen in ihre Token-Kosten einpreisen.
GLM-5.2 API: Häufige Fragen
Kann ich das OpenAI SDK mit GLM-5.2 verwenden?
Ja, für Chat Completions: base_url auf https://api.z.ai/api/paas/v4/ setzen und glm-5.2 als Modell verwenden. Eine Responses API gibt es nicht. Die neuere OpenAI-Schnittstelle und Codex benötigen daher eine Übersetzungsschicht.
Unterstützt die GLM-5.2 API Streaming, Function Calling und Structured Output?
Alle drei sind dokumentierte Funktionen, ebenso Context Caching und MCP. Die Einschränkungen sind verhaltensbedingt: Die Streaming-Stabilität variiert je nach Endpoint, und OpenAI-Steuerfelder für Tools — tool_choice außerhalb von auto, parallel_tool_calls, strict — werden nicht beachtet.
Welchen Modellstring und welche Base URL sollte ich verwenden?
Für die offizielle verbrauchsbasierte Route: glm-5.2 unter https://api.z.ai/api/paas/v4/. Der Coding Plan verwendet eine andere Base URL; bei OpenRouter heißt das Modell z-ai/glm-5.2.
Warum ist GLM-5.2 langsam oder ungewöhnlich ausführlich?
Coding-Routen nutzen standardmäßig maximalen Reasoning Effort, der als Output Tokens abgerechnet wird. Community-Berichte sehen den anhaltenden Durchsatz eher bei 50 tok/s als bei den beworbenen 200+. Latenz und Ausführlichkeit sind meist Folgen aus Konfiguration und Endpoint, bevor sie echte Modellgrenzen sind.
Kann der GLM Coding Plan die API meiner Anwendung betreiben?
Nein. Berichte zur Plan-Abrechnung zufolge ist das Abo für interaktive Coding-Tools bestimmt und schließt das Ausliefern für Websites, Bots oder SaaS-Produkte aus. Die Pekinger Kontingent-Multiplikatoren zu Spitzenzeiten machen es zudem ungeeignet für gleichmäßigen Traffic.
Ist das Kontextfenster von 1M bei jedem Provider verfügbar?
Nein. Die offizielle API und die meisten Aggregatoren bieten 1M, Together AI begrenzt GLM-5.2 jedoch auf 256K. Das reicht aus, um die Architektur von Repo-weiten Workflows grundlegend zu verändern.
Weiterführende Artikel
- GLM-5.2 Review: Two Months After the Hype — Modellqualität, Benchmarks und für wen es geeignet ist
- GLM 5.2 API: Cheapest Access, Pricing & Free Keys — die vollständige Preisübersicht der Provider
- GLM-5.2 vs GLM-5.3 — ob der Nachfolger vom August die Rechnung verändert