 AIREITER
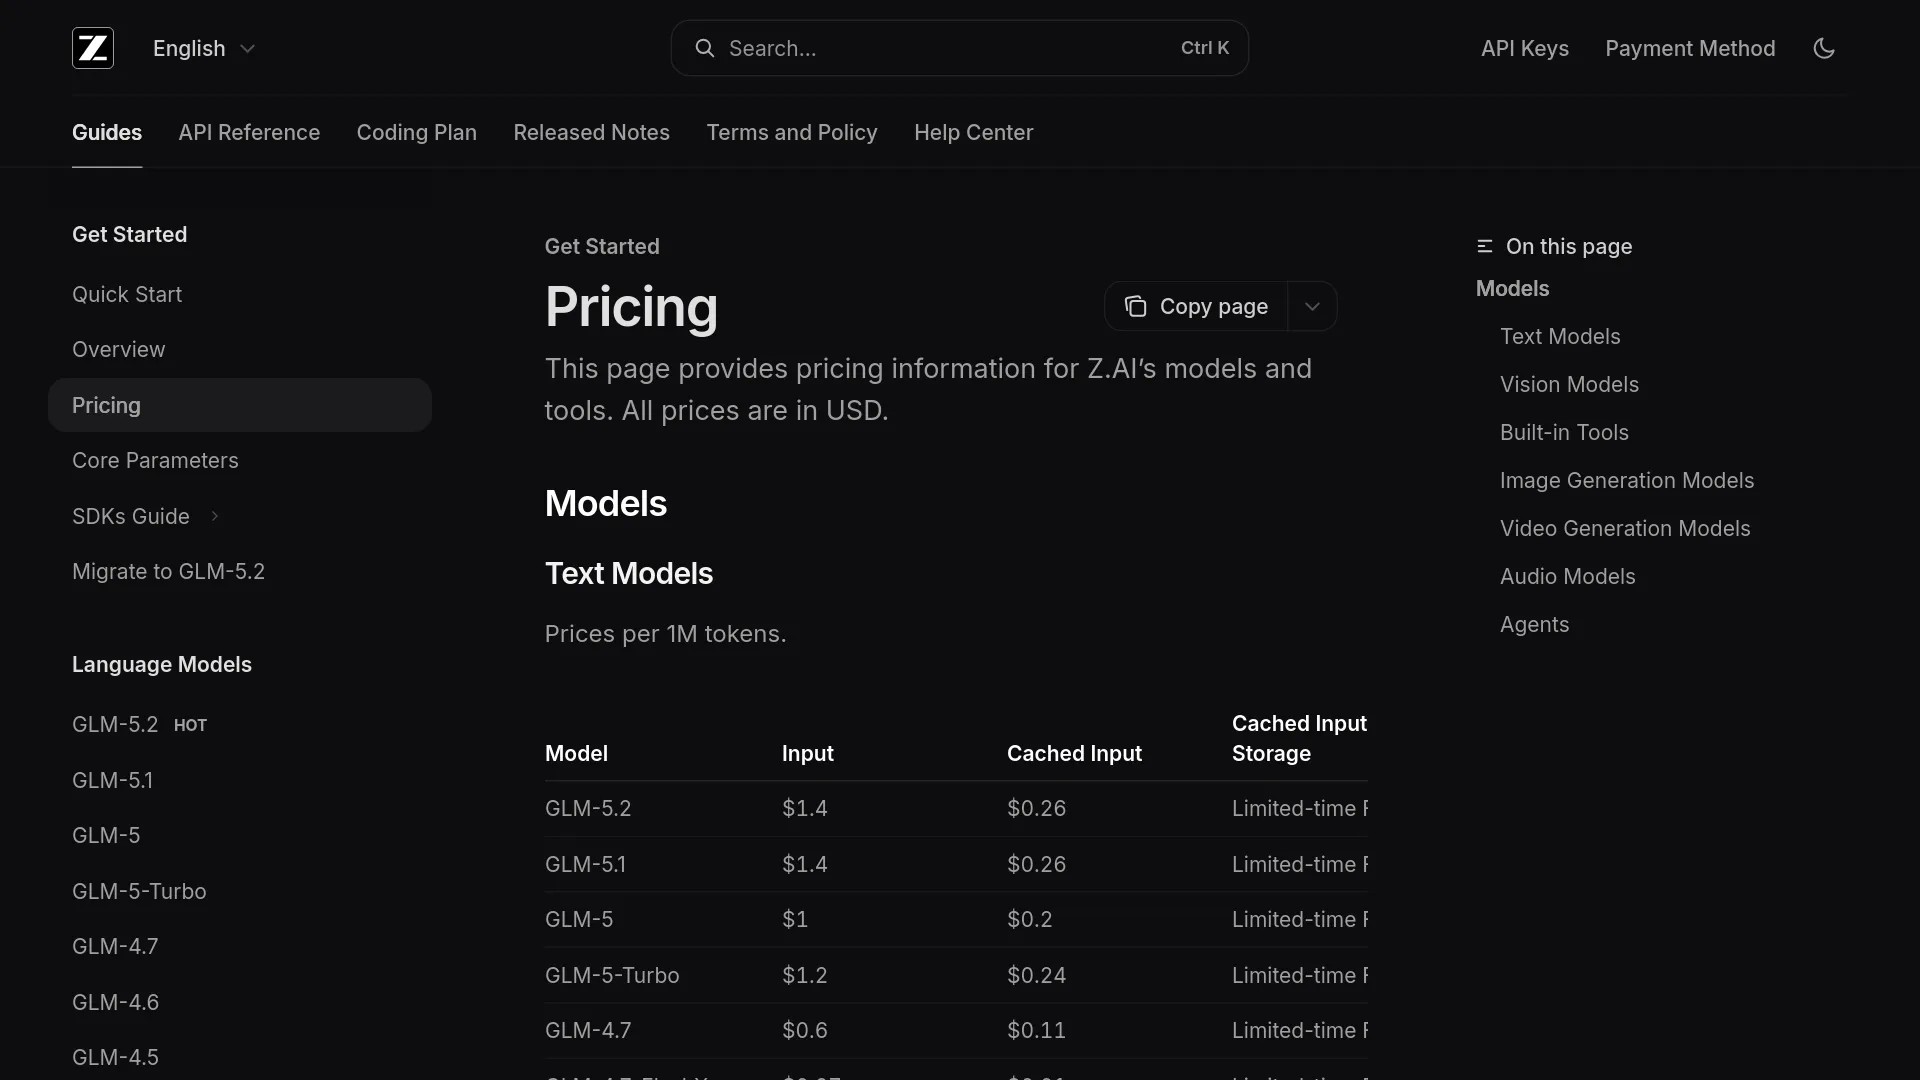
GLM-5.3 soll Coding deutlich besser beherrschen – belegt sind diese Fortschritte bislang jedoch nur durch die Ankündigung. In der am 14. August 2026 geprüften öffentlichen API-Referenz und Preistabelle von Z.ai erscheint weiterhin glm-5.2, nicht glm-5.3. Z.ai API reference Z.ai pricing
Kurz gesagt: evaluieren ja, Produktion vorerst nicht umstellen
Für anspruchsvolle Aufgaben mit Coding-Agenten ist GLM-5.3 einen kontrollierten Piloten wert – sobald ein verifizierter Zugangskanal das Modell anbietet. GLM-5.2 sollte aber der Produktionsstandard bleiben, bis Modell-ID, Betriebsbedingungen und bessere Resultate in den eigenen Akzeptanztests bestätigt sind.
Laut der in einer zeitgenössischen Release-Diskussion wiedergegebenen Ankündigung von Z.ai nutzt GLM-5.3 dieselbe Basis wie GLM-5.2 und gewinnt seine Fähigkeiten durch Post-Training. Z.ai spricht von 50% besseren Ergebnissen auf Z.ai Code Bench sowie führenden Open-Source-Ergebnissen bei Terminal-Bench 3.0 und Agents' Last Exam. Rohe Scores, Konfigurationen, Preise, Kontextfenster oder Lizenz nennt die zitierte Release-Diskussion allerdings nicht. GLM-5.3 release discussion
Worin sich GLM-5.2 und GLM-5.3 tatsächlich unterscheiden
GLM-5.2 ist ein dokumentiertes Textmodell mit produktionsreifer API. Z.ai führt ein Kontextfenster von 1M Token, maximal 128K Output-Token, Function Calling, strukturierten Output, Caching, MCP-Unterstützung sowie einen unter MIT lizenzierten Checkpoint auf Hugging Face auf. GLM-5.2 documentation GLM-5.2 model card
GLM-5.3 wird als Post-Training-Update für Coding und Cyberabwehr positioniert. Nach dem verfügbaren Release-Material bleibt das Basismodell gegenüber GLM-5.2 unverändert; Weights sollen nach Sicherheitsprüfung und Härtung folgen. Daraus lässt sich jedoch nicht ableiten, dass Kontextlimit, Outputlimit, MIT-Bedingungen oder die öffentliche API-Unterstützung von GLM-5.2 unverändert für 5.3 gelten. GLM-5.3 release discussion
| Entscheidungsfaktor | GLM-5.2 | GLM-5.3 |
|---|---|---|
| Beziehung zum Basismodell | Veröffentlichte Model Card für ein Open-Weight-Modell | Z.ai zufolge basiert es auf GLM-5.2; die Fortschritte stammen aus dem Post-Training |
| Belege für Coding-Leistung | Die Hersteller-Tabelle nennt 62.1 bei SWE-bench Pro und 81.0 bei Terminal-Bench 2.1 | Z.ai behauptet 50% bessere Ergebnisse im eigenen Code Bench; im Release-Material fehlt ein absoluter Score |
| Spezifikation für lange Kontexte | 1M Kontext und maximal 128K Output sind dokumentiert | Im Release-Material nicht spezifiziert |
| Öffentliche API-Dokumentation | glm-5.2 ist in der Chat-Completions-Referenz aufgeführt | glm-5.3 war in der am 14. August 2026 geprüften Referenz nicht gelistet |
| Direkter API-Listenpreis | $1.40 Input, $0.26 gecachter Input, $4.40 Output pro MTok | In der am 14. August 2026 geprüften öffentlichen Preistabelle nicht gelistet |
| Weights und Lizenz | Herunterladbare GLM-5.2-Weights unter MIT | Weights werden erst nach Sicherheitsprüfung erwartet; Lizenz nicht genannt |
Die Angaben zu GLM-5.2 sind dokumentiert. Bei GLM-5.3 bleiben API, Preise, Weights und Lizenz offen, soweit das Release-Material keine Details liefert. Z.ai API reference Z.ai pricing GLM-5.2 model card
Warum die Coding-Ankündigung für 5.3 noch kein Migrationssignal ist
Die Behauptung von 50% Fortschritt auf Code Bench verrät weder Task-Set noch Agent-Setup, Token-Budget oder absolute Scores. Damit lässt sich nicht vorhersagen, wie sich das Modell in den Akzeptanztests eines konkreten Repositorys schlägt. GLM-5.3 release discussion
„Das Harness ist weiterhin wichtiger als das Modell.“ Quelle: Semgrep Security Research
Das IDOR-Experiment von Semgrep mit GLM-5.2 zeigt, warum das relevant ist: In einem Datensatz und einem Durchlauf kam die reine Prompt-Konfiguration mit GLM-5.2 auf 39% F1, während das speziell entwickelte multimodale Harness mit GPT-5.5 61% erreichte. Die Autoren warnen davor, diese Reihenfolge über die getestete Aufgabe hinaus zu verallgemeinern. Ein GLM-5.3-Pilot sollte daher das bestehende Scaffold unverändert lassen. Semgrep methodology and results
Die berichteten Ergebnisse von GLM-5.2 bei FrontierSWE, DeepSWE und Terminal-Bench helfen bei der Auswahl von Testfällen. Die Model Card dokumentiert allerdings auch modellspezifische Harnesses, Token-Budgets und Evaluierungseinstellungen. GLM-5.2 model card
Der Engpass ist derzeit die Verfügbarkeit
Zum geprüften Zeitpunkt ist GLM-5.2 die einzige Version dieses Vergleichs mit einem klaren öffentlichen API-Vertrag. Die Z.ai-Referenz für Chat Completions verwendet glm-5.2 im Request-Beispiel, führt das Modell unter den verfügbaren Textmodellwerten und erklärt, dass reasoning_effort nur von GLM-5.2 unterstützt wird. Z.ai chat-completions reference
Berichte über Community-Zugang belegen keine unterstützte öffentliche API-Integration. GLM 5.3 community thread
Der Drei-Task-Check für ein Upgrade von GLM-5.2
Wer GLM-5.2 nutzt, sollte eine neue Version als Änderung am gesamten Agentensystem testen – auch wenn beide Modelle dieselbe Basis teilen. Prompt, Tools, Berechtigungen und Retry-Strategie bleiben beim ersten Vergleich unverändert.
- Drei typische Aufgaben festlegen. Nehmen Sie einen klar abgegrenzten Bugfix mit Test-Oracle, ein Refactoring über mehrere Dateien mit Prüfungen auf verbotene Änderungen sowie eine Review- oder Migrationsaufgabe mit langem Kontext. Repository-Commit, Aufgabentext, Tools und Akzeptanzkriterien werden eingefroren.
- Den 5.3-Zugang vor dem Traffic verifizieren. Dokumentieren Sie anhand der aktuellen Unterlagen des Anbieters Provider, exakte Modell-ID, Kontext- und Outputlimits, Token-Preis, Rate Limit, Bedingungen zur Datenverarbeitung und Fehlerverhalten. Diese Angaben dürfen weder aus GLM-5.2 noch aus einem Screenshot eines Coding-Plans abgeleitet werden. Z.ai API reference Z.ai pricing
- Akzeptierte Ergebnisse statt eines Einzelwerts vergleichen. Führen Sie dasselbe Scaffold gegen beide Versionen aus und erfassen Sie Akzeptanzrate, Testfehler, verbotene Änderungen, Laufzeit, Input-/Cache-/Output-Token, Retries und Zeit für menschliche Nacharbeit. GLM-5.3 sollte nur für die Aufgabenklasse geroutet werden, in der es mehr akzeptierte Ergebnisse liefert, ohne Kosten oder Zuverlässigkeit inakzeptabel zu verschlechtern. Semgrep methodology
Welche Version zu welchem Einsatzstand passt
| Ihre Ausgangslage | Jetzt wählen | Nächster Schritt |
|---|---|---|
| Produktiv-App mit der dokumentierten öffentlichen API von Z.ai | GLM-5.2 | Bestehenden Modell-String und Basiskennzahlen beibehalten |
| Bestätigter Zugang zu GLM-5.3 für schwierige Code-Agent-Aufgaben | Kontrollierter GLM-5.3-Pilot | Den Drei-Task-Check mit demselben Harness durchführen |
| Lokales oder privates Deployment | GLM-5.2 | Auf veröffentlichte GLM-5.3-Weights, Lizenz und Serving-Hinweise warten |
| Verständnis von Screenshots, PDFs oder Bildern | Keines der beiden Ergebnisse beantwortet den Bedarf | Ein dokumentiertes Vision-Modell evaluieren; GLM-5.2 ist Text-zu-Text |
5.3 gehört nur dann in den Piloten, wenn dokumentierter Zugang und bessere akzeptierte Ergebnisse den Ersatz der 5.2-Basis rechtfertigen. GLM-5.3 release discussion GLM-5.2 documentation
FAQ
Ist GLM-5.3 ein neues Basismodell?
Nach der Release-Aussage von Z.ai verwendet GLM-5.3 dieselbe Basis wie GLM-5.2; die Verbesserungen werden dem Post-Training zugeschrieben. Eine neue Architektur oder Parameter-Spezifikation enthält das zitierte Release-Material nicht. GLM-5.3 release discussion
Ist GLM-5.3 über die öffentliche Z.ai API verfügbar?
In der am 14. August 2026 geprüften öffentlichen Z.ai-Referenz ist glm-5.3 nicht aufgeführt. Prüfen Sie daher vor der Integration eines 5.3-Endpunkts die aktuellen Unterlagen des jeweiligen Providers. Z.ai chat-completions reference
Behält GLM-5.3 das 1M-Kontextfenster und die MIT-Lizenz von GLM-5.2?
Das geht aus dem zitierten Release-Material zu GLM-5.3 nicht hervor. Das 1M-Kontextfenster und die MIT-Lizenz von GLM-5.2 sind in dessen offizieller Model Card dokumentiert; eine gemeinsame Basismodell-Linie beweist keine identischen Veröffentlichungsbedingungen. GLM-5.2 model card GLM-5.3 release discussion