 AIREITER
Bei der reinen Benchmark-Leistung liegt Nemotron 3.5 Lightning laut NVIDIA hinter Qwen 3.6 35B-A3B: in 11 von 12 Tests. Dennoch soll das Modell Tokens bis zu 4x schneller generieren. Genau darauf zielt dieses 30B-Mixture-of-Experts-Modell ab: Pro Token sind nur 3B Parameter aktiv, sodass es die wiederkehrenden Ausführungsschritte in Agenten-Pipelines schnell und kosteneffizient erledigen kann. Der Haken: Die BF16-Gewichte in voller Präzision benötigen eine GPU mit 80 GB Speicher. Für den produktiven Einsatz empfiehlt NVIDIA den NVFP4-Checkpoint.
Warum Nemotron 3.5 Lightning kein gewöhnliches 30B-Modell ist
Nemotron 3.5 Lightning kombiniert Mamba-2-State-Space-Schichten, MoE-Routing und gezielt eingesetzte Attention-Schichten zu einer Hybridarchitektur, die NVIDIA als nemotron_h bezeichnet. Mamba-2 reduziert den Speicher- und Rechenaufwand von Attention bei langen Kontexten. Dadurch erreicht Lightning ein Kontextfenster von 1 Mio. Tokens; laut Model Card liegt die praktische Grenze auf einer einzelnen H100 80GB bei 256K. Ein reines Attention-Modell müsste dafür quadratisch steigende Kosten in Kauf nehmen.
| Spezifikation | Wert |
|---|---|
| Parameter insgesamt | 30B |
| Aktive Parameter pro Token | 3B |
| Architektur | Mamba-2 + MoE + Attention Hybrid |
| Kontextlänge | Bis zu 1 Mio. Tokens (256K auf einer einzelnen H100) |
| Präzisionsoptionen | BF16, NVFP4 |
| Lizenz | OpenMDW v1.1 (kommerziell nutzbar) |
| Sprachen | Englisch, Spanisch, Französisch, Deutsch, Italienisch, Japanisch + Code |
| Pre-Training-Korpus | 20T+ Tokens |
| Reasoning-Modus | Über enable_thinking im Chat-Template umschaltbar |
| Empfohlenes Sampling | Temperature 1.0, top-p 0.95 |
NVIDIA positioniert Lightning als das kleinste Modell der Nemotron-3-Familie. Es wurde laut NVIDIA gezielt auf Agent-Harness-Verhalten trainiert: Tool-Aufrufe, Validierung von Ausgaben, Ergebnisformatierung und Delegation an Subagenten. Die komplexe Planung übernimmt ein Frontier-Reasoning-Modell wie Nemotron 3 Ultra; Lightning bearbeitet die Routinearbeit, die sonst das Token-Budget eines teureren Modells aufbrauchen würde.
Benchmarks: Schnell ist Lightning, aber nicht überall besser
Die HuggingFace Model Card enthält 14 Benchmark-Zeilen, in denen Lightning mit Qwen 3.6 35B-A3B, Gemma 4 26B-A4B, Nemotron 3 Nano/Super und GPT-OSS 20B verglichen wird. Die zehn für die Entscheidung wichtigsten Ergebnisse:
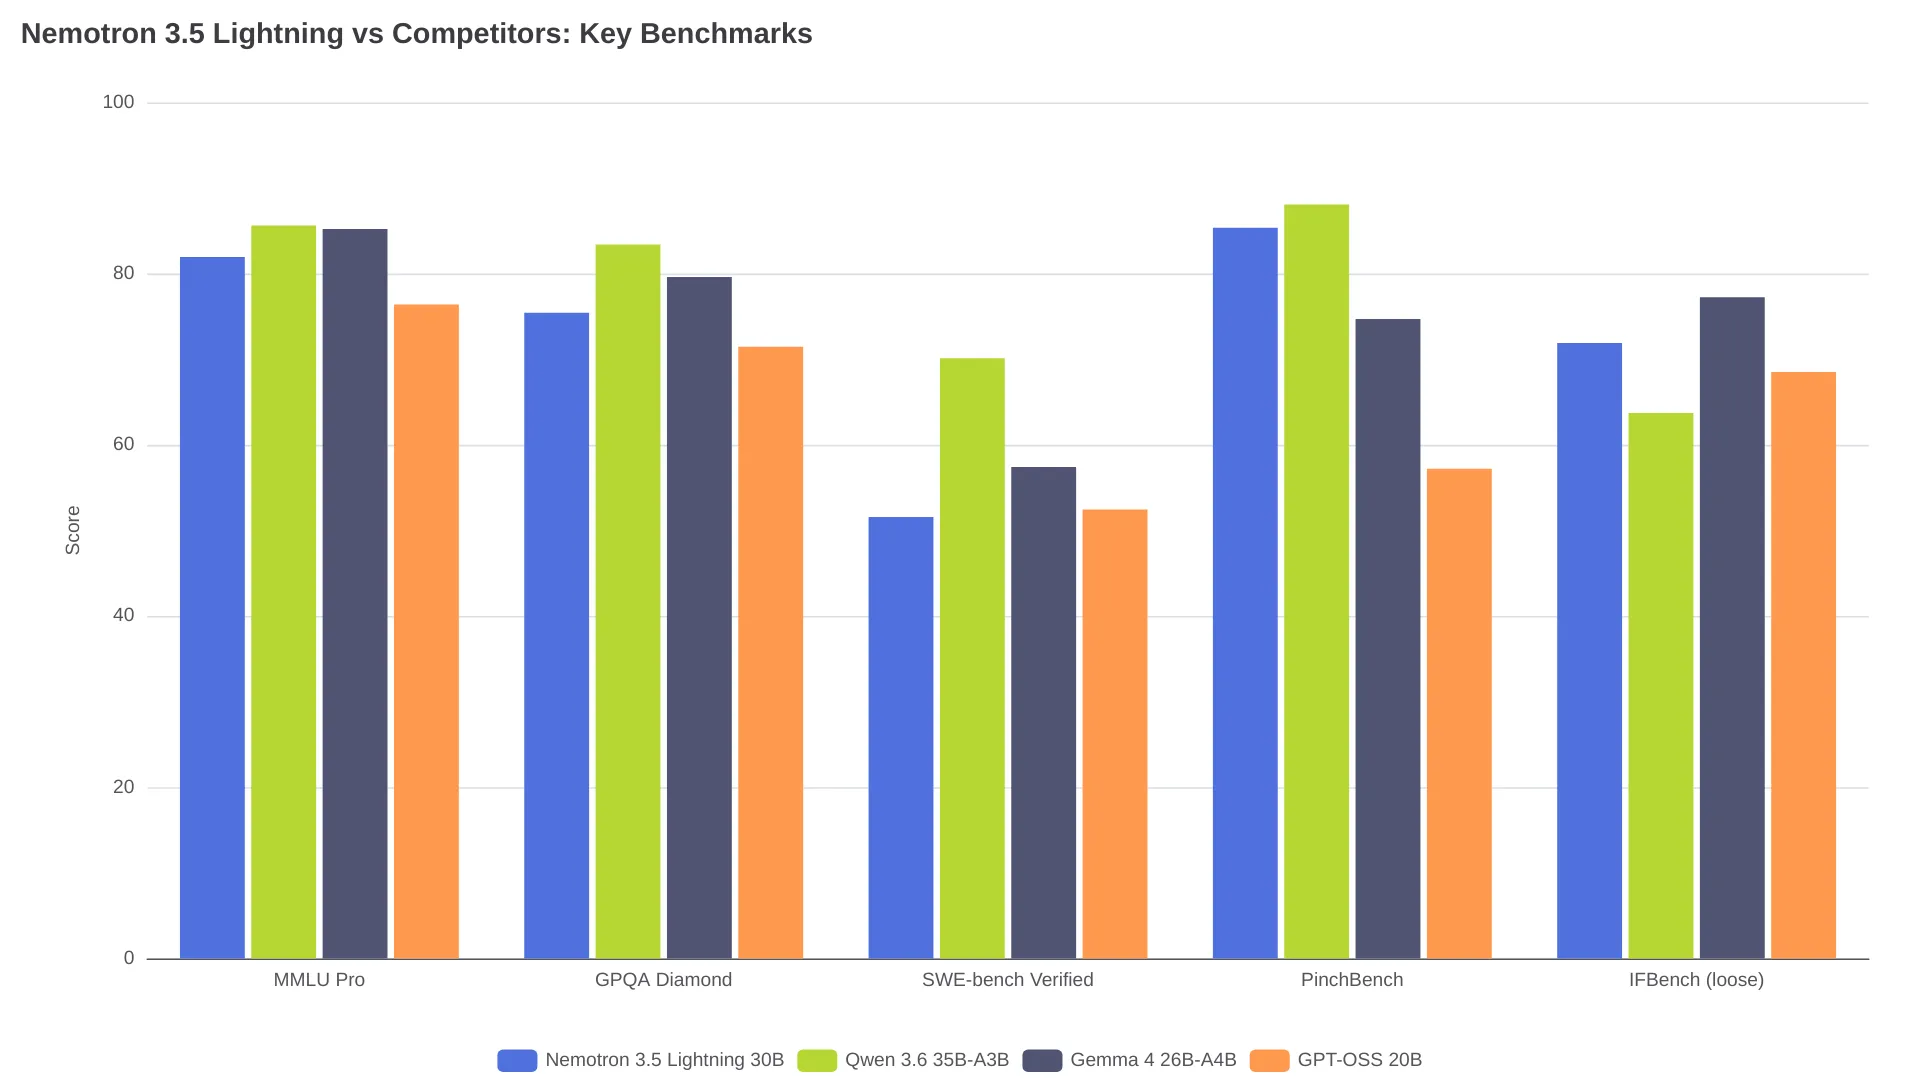
| Benchmark | Nemotron 3.5 Lightning | Qwen 3.6 35B-A3B | Gemma 4 26B-A4B | GPT-OSS 20B |
|---|---|---|---|---|
| MMLU Pro | 81.94 | 85.63 | 85.20 | 76.40 |
| GPQA Diamond (ohne Tools) | 75.44 | 83.40 | 79.61 | 71.46 |
| SWE-bench Verified | 51.56 | 70.12 | 57.40 | 52.44 |
| SWE-bench Multilingual | 39.33 | 63.40 | 43.40 | 41.93 |
| Terminal-Bench 2.1 | 24.58 | 44.38 | 37.22 | 15.17 |
| PinchBench | 85.37 | 88.07 | 74.70 | 57.20 |
| BrowseComp | 36.97 | 48.74 | 26.30 | - |
| IFBench (locker) | 71.88 | 63.71 | 77.25 | 68.50 |
| AA-LCR | 52.00 | 61.06 | 57.56 | 32.88 |
| SciCode | 32.60 | 35.33 | 40.28 | 38.63 |
In 11 der 12 direkt vergleichbaren Zeilen bleibt Lightning hinter Qwen 3.6 35B-A3B zurück. Die Ausnahme ist IFBench, also Instruction Following im lockeren Modus: Hier erzielt Lightning 71.88 gegenüber 63.71 bei Qwen, ein Vorsprung von 8 Punkten. Das passt zur Positionierung als Ausführungsmodell für Agenten. Bei Tool-Call-Formatierung und Ausgabevalidierung ist das präzise Befolgen von Anweisungen oft wichtiger als maximale Reasoning-Leistung.
Seinen eigentlichen Vorteil spielt Lightning beim Tempo aus. In NVIDIAs PinchBench-Auswertung mit 10.000 Agenten-Aufgaben, gemessen in H100-GPU-Stunden, erledigt Lightning die Last in rund 16.5 GPU-Stunden bei 86% Genauigkeit. Qwen 3.6 35B benötigt bei 87% Genauigkeit 23.5-24 GPU-Stunden, Gemma 4 26B bei 73% Genauigkeit 25-26 GPU-Stunden:
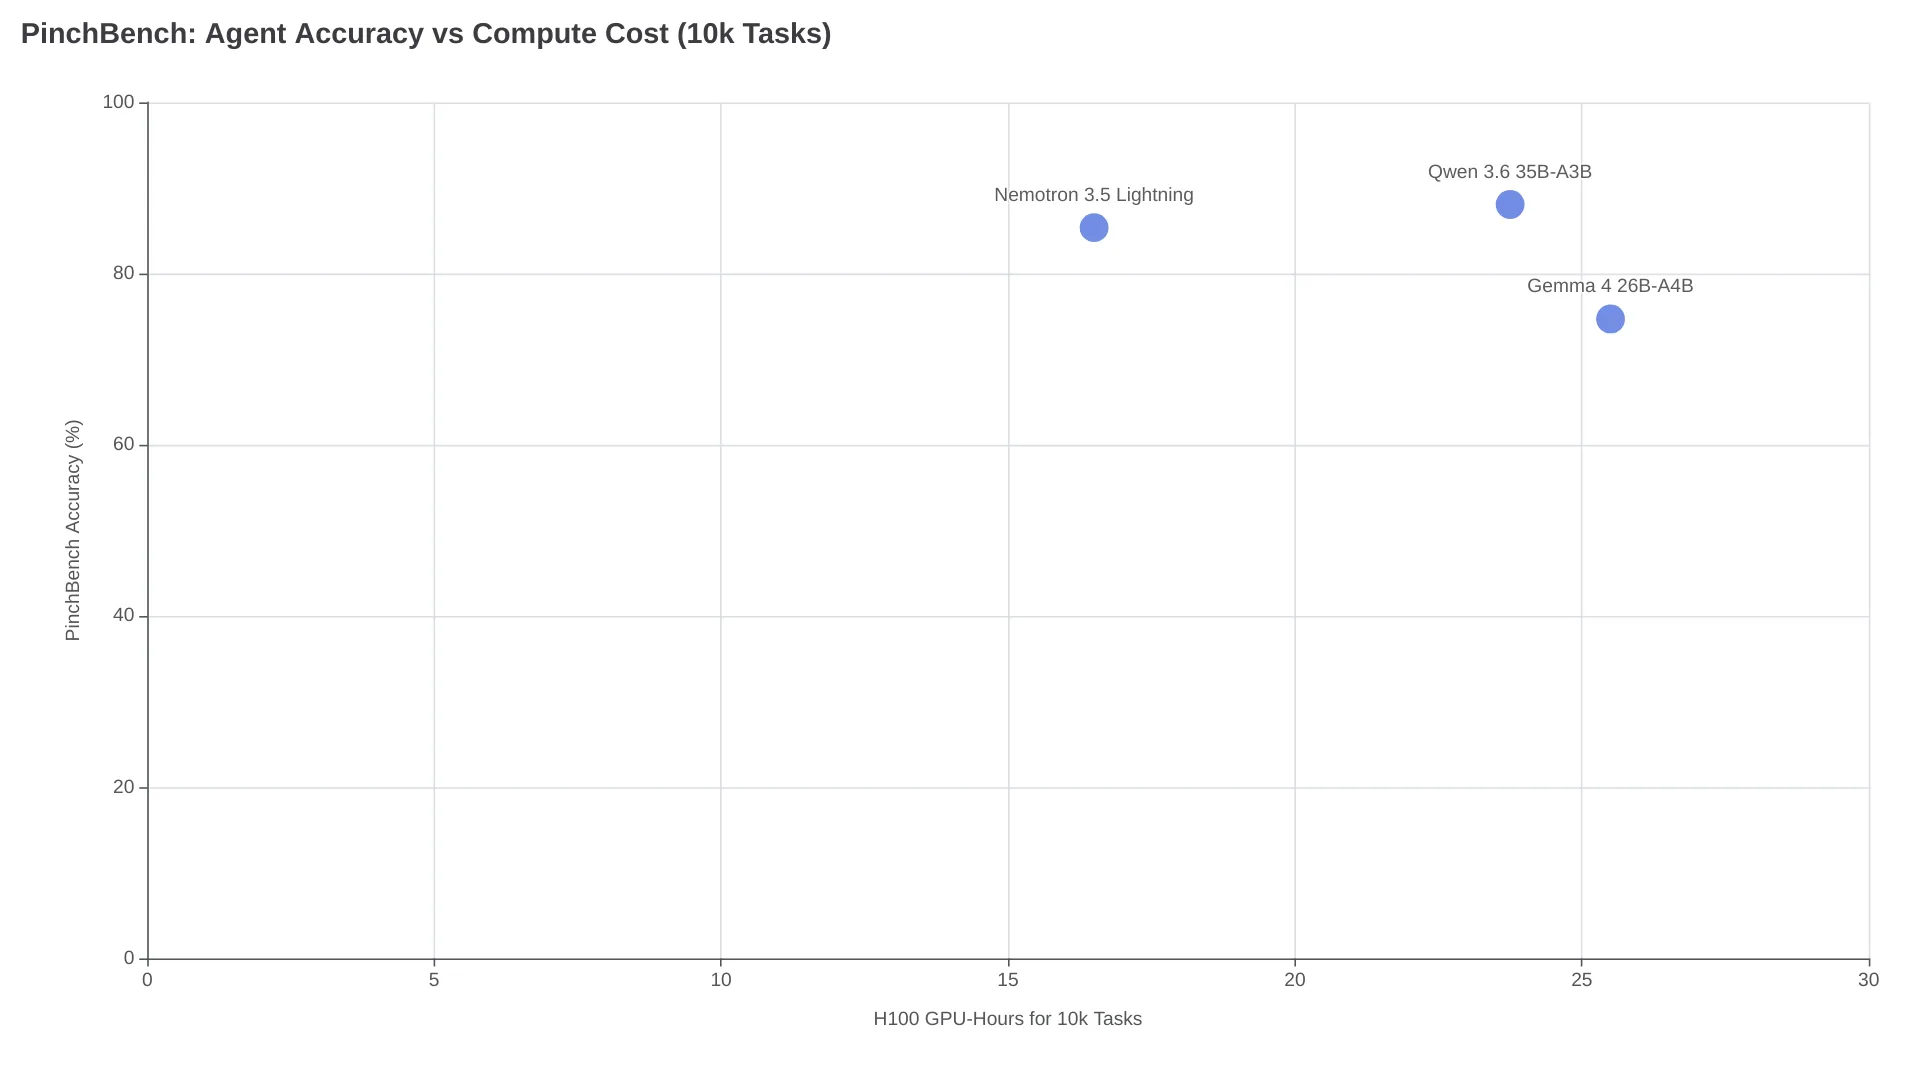
Das entspricht bei nahezu gleicher Genauigkeit etwa 30% weniger Rechenaufwand. Wer 10.000 Agenten-Schritte ausführt und GPU-Stunden bezahlt, spürt diesen Unterschied. NVIDIA nennt zudem rund 670 Output-Tokens pro Sekunde bei etwa 23-24 Intelligence-Index-Punkten auf dem Artificial Analysis Leaderboard. Damit liegt das Modell auf der Pareto-Grenze der Open-Weight-Modelle mit weniger als 40B Gesamtparametern.
Tests aus der Community auf r/LocalLLaMA bestätigen den Geschwindigkeitstrend: Ein Nutzer mit DGX Spark meldete beim NVFP4-Checkpoint 78.5 Tokens pro Sekunde ohne Speculative Decoding und 90.7 Tokens pro Sekunde damit. Ein anderer Nutzer ordnete die Qualität im zentralen Diskussionsthread „zwischen Gemma 4 26B und 31B, deutlich näher an 26B“ ein. Lightning laufe ungefähr 2x schneller als Gemma 31B, erzeuge aber viele Thinking-Tokens, was den praktischen Geschwindigkeitsgewinn relativiere. Frühe GGUF-Q4-Konvertierungen kamen auf Dateigrößen von 25 GB und meldeten ungenutzte Tensoren. Das deutet darauf hin, dass die hybride Mamba-2-Architektur noch nicht von allen GGUF-basierten Tools vollständig unterstützt wird.
Hardwarebedarf und Optionen für den lokalen Betrieb
Der BF16-Checkpoint mit den Referenzgewichten in voller Präzision benötigt für den Betrieb auf einer GPU 1x H100 80GB oder 1x A100 80GB. Die geshardete safetensors-Datei ist 65.8 GB groß. NVIDIA empfiehlt für Production Inference ausdrücklich die separate NVFP4-Version.
| Checkpoint | Dateigröße (ca.) | Minimale GPU | Am besten geeignet für |
|---|---|---|---|
| BF16 | 65.8 GB | 1x H100/A100 80GB | Fine-Tuning, Forschung, Erstellung quantisierter Varianten |
| NVFP4 | ~16 GB | RTX 5090, DGX Spark, Jetson (Blackwell/Hopper/Ampere) | Production Inference, Agenten-Deployment |
| GGUF Q4 | ~25 GB | 16 GB+ VRAM (aus der Community) | llama.cpp, Ollama, LM Studio |
Für Day-0-Support arbeitete NVIDIA laut eigenem Beitrag mit vier Local-Serving-Projekten zusammen: vLLM, SGLang, Ollama und llama.cpp. Auch LM Studio und Unsloth werden genannt. Das Modell unterstützt drei Strategien für Speculative Decoding:
- DSpark – empfohlen für DGX Spark und Data-Center-Inferenz mit geringer Parallelität
- DFlash – alternatives Draft-Modell, abhängig vom jeweiligen Workload
- MTP (Multi-Token Prediction) – im Modell integriert und am besten für mittlere bis hohe Parallelität geeignet
Ohne lokale Hardware ist Lightning über build.nvidia.com als NIM-Microservice sowie auf OpenRouter verfügbar. Der NVFP4-Checkpoint läuft auf GeForce RTX 5090, DGX Spark, OEM-GB10-Systemen und NVIDIA Jetson.
Das Routing-Muster für Agenten: Hier lohnt sich Lightning
NVIDIAs Open-Source-Routing-Bibliothek NeMo Switchyard weist jeden Schritt eines Agenten-Workflows anhand von Genauigkeit, Geschwindigkeit und Kosten dem passenden Modell zu. Planungsaufgaben gehen an ein Frontier-Reasoning-Modell, die Ausführung an Lightning. Laut NVIDIAs internem Benchmark hielt Switchyard die Aufgabenerledigung auf „Frontier-Niveau“ und senkte die Kosten auf etwa ein Drittel gegenüber dem alleinigen Einsatz von Opus 4.8. An Lightning geroutete Ausführungsaufgaben umfassen git pull, die Validierung von Tool-Ausgaben, Ergebnisformatierung und Routine-API-Aufrufe.
Auch der Praxiseinsatz liefert ein Beispiel. CodeRabbit veröffentlichte auf Reddit einen Real-World-Fall: Für das Routing bei Code Reviews post-trainierte das Team Nemotron 3.5 Lightning mit gezieltem SFT und RLVR (Reinforcement Learning with Verifiable Rewards). In einer eingefrorenen Auswertung mit 1.000 Aufgaben schlug das Modell den bisherigen Ausgangspunkt – bei Trainingskosten von unter $100. NVIDIA unterstützt diesen Workflow mit NeMo Automodel und NeMo Megatron Bridge für LoRA/SFT, NeMo RL und NeMo Gym für Reinforcement Learning sowie dem offenen Datensatz Nemotron-RL Agentic Terminal Pivot.
Für Teams, die Agenten-Pipelines bauen, lautet die praktische Frage: Lässt sich Lightning so fine-tunen, dass es den Großteil der Agenten-Schritte zu Kosten von 3B aktiven Parametern übernimmt und ein Frontier-Modell nur bei den wenigen wirklich anspruchsvollen Schritten zum Einsatz kommt?
Lohnt sich Nemotron 3.5 Lightning für Ihren Einsatz?
| Anwendungsfall | Empfehlung | Begründung |
|---|---|---|
| Agenten-Routing mit hohem Volumen (Tool Calls, Validierung, Formatierung) | Lightning NVFP4 | 3B aktive Parameter, 4x Token-Geschwindigkeit, ~30% weniger Compute bei ähnlicher Genauigkeit |
| Allgemeine Coding-Unterstützung | Qwen 3.6 35B-A3B | 70.12 gegenüber 51.56 bei SWE-bench Verified – Abstand von 19 Punkten |
| Komplexes Reasoning / Planung | Nemotron 3 Ultra oder Frontier-Modell | Lightning ist ausdrücklich nicht das Modell für Planung |
| Lokaler Chat auf Consumer-Hardware mit einer GPU | Lightning NVFP4 auf RTX 5090 | Funktioniert, aber GGUF-Konvertierungen sind noch unausgereift; vLLM/SGLang verlässlicher |
| Fine-Tuning für eine eng umrissene Agenten-Aufgabe | Lightning BF16 | 3B aktive Parameter = günstigeres Fine-Tuning; OpenMDW v1.1 erlaubt kommerzielle Nutzung |
| Instruction Following im großen Maßstab | Lightning | IFBench 71.88 gegenüber Qwen 63.71 – Vorsprung von 8 Punkten |
Lightning tauscht Spitzenleistung gegen Geschwindigkeit bei volumenstarken Ausführungsaufgaben. Über Hunderte Agenten-Schritte pro Sitzung summieren sich die 30% weniger Compute. Das Modell wurde jedoch erst am 11. August 2026 veröffentlicht, und das Ökosystem entwickelt sich noch. Wegen der Mamba-2-Hybridarchitektur unterstützen GGUF-basierte Tools das Modell möglicherweise noch nicht vollständig. Auf NVIDIA-Hardware sind vLLM oder SGLang mit dem NVFP4-Checkpoint derzeit der sicherste Deployment-Weg. Auf Apple Silicon oder in reinen GGUF-Setups sollte man warten, bis die Community die Konvertierungen stabilisiert hat.
Häufige Fragen
Läuft Nemotron 3.5 Lightning auf Consumer-Hardware?
Für Consumer-Hardware unterstützt NVIDIA nur den NVFP4-Checkpoint. Die BF16-Gewichte erfordern eine GPU mit 80 GB Speicher, also H100 oder A100. NVFP4 läuft auf GeForce RTX 5090, DGX Spark und NVIDIA Jetson. GGUF-Q4-Konvertierungen aus der Community für llama.cpp und Ollama existieren für Systeme mit 16 GB+ VRAM. Bei frühen Builds wurden jedoch Probleme mit ungenutzten Tensoren in der Mamba-2-Hybridarchitektur gemeldet.
Wie schneidet Nemotron 3.5 Lightning gegen Qwen 3.6 35B ab?
Qwen 3.6 35B-A3B übertrifft Lightning in 11 von 12 veröffentlichten Benchmarks; die größten Abstände gibt es bei SWE-bench Verified und Terminal-Bench. Lightning gewinnt bei IFBench für Instruction Following und erledigt Agenten-Workloads bei ähnlicher Genauigkeit rund 30% schneller. Qwen ist das stärkere Allround-Modell, Lightning das schnellere Modell für die Agenten-Ausführung.
Ist Nemotron 3.5 Lightning gut zum Programmieren?
Für reine Coding-Benchmarks: nein. Bei SWE-bench Verified erreicht Lightning 51.56, Qwen 3.6 dagegen 70.12. CodeRabbit konnte Lightning allerdings erfolgreich für das Routing von Code Reviews fine-tunen und übertraf für unter $100 Trainingskosten den eigenen Ausgangspunkt. Das Modell ist auf Anpassung ausgelegt: Wer es auf die Konventionen der eigenen Codebasis fine-tunt, kann Routineaufgaben im Code zu Kosten von 3B aktiven Parametern abwickeln.
Unter welcher Lizenz steht Nemotron 3.5 Lightning?
Das Modell steht unter OpenMDW v1.1 (Open Model Data Weight), die NVIDIA als Veröffentlichung „as permissively as possible“ beschreibt. Die Lizenz erlaubt die kommerzielle Nutzung, einschließlich Gewichten, Trainingsdaten und Recipes. Die vollständigen Lizenzbedingungen stehen in der HuggingFace Model Card.