 AIREITER
Wer nach Alternativen zu GLM-5-3-Flash sucht, braucht vermutlich keine weitere Erklärung zum Ox-Alpha-Leak. Gesucht ist ein Ersatz für einen günstigen, aber gelegentlich langsamen Agentenpfad, eine Möglichkeit, den 320B-Checkpoint nicht lokal betreiben zu müssen, oder eine Lösung für multimodale Workloads ohne kompletten API-Umbau. Welches Modell am besten passt, hängt davon ab, welches konkrete Problem du lösen willst.
Die Kurzfassung: Wähle nach dem Problem, das du beheben willst
DeepSeek V4 Flash ist die flexible Textoption, wenn Cache-Hit-Preise, ein optionaler Non-Thinking-Modus und hohe Parallelität wichtig sind. Das Modell bietet 1M Token Kontext, ein Limit von 2.500 gleichzeitigen Anfragen und offizielle Off-Peak-Preise von $0.22 pro Million nicht gecachter Input-Tokens sowie $0.66 pro Million Output-Tokens.
Qwen3.8-Flash ist die passende gehostete Option, wenn Bild- und Videoeingaben, API-Kompatibilität und integrierte Tools zählen. Der ausgewiesene Preis liegt bei $0.15 pro Million Input-Tokens und $0.47 pro Million Output-Tokens.
GLM-5.3 ist der Aufstieg innerhalb derselben Modellfamilie: Du bleibst bei Z.ai, wechselst aber auf das Flaggschiff für Textaufgaben. GPT-5.6 Terra und Claude Opus 4.8 sind Premium-Optionen für Aufgaben, bei denen ein erfolgreicher Durchlauf die mehrfach höheren Kosten rechtfertigt. Kimi K3 bietet ebenfalls 1M Token Kontext, ist aber kein günstiger Ersatz.
Die entscheidende Frage lautet nicht: „Welches Modell gewinnt?“ Entscheidend ist, ob du Token-Kosten, visuelle Eingaben, langfristige Coding-Aufgaben, lokale Kontrolle oder die Erfolgsquote abgeschlossener Aufgaben optimierst.
Der Ox-Alpha-Endpunkt ist weg – prüfe zuerst deinen Migrationsstand
In der offiziellen Ankündigung von Z.ai wurde die anonyme Ox-Alpha-Vorschau am August 26, 2026 als GLM-5.3-Flash identifiziert. Die öffentliche Veröffentlichung brachte einen benannten Checkpoint, veröffentlichte Preise, ein MIT-lizenziertes Hugging-Face-Modell und dokumentierten API-Zugriff. Die alte Vorschauumgebung sollte nicht als dauerhafte Modellvereinbarung betrachtet werden: Preview-Routing, Kontingente, Latenz und Richtlinienverhalten können von der veröffentlichten API abweichen.
Wenn eine Konfiguration noch stealth/ox-alpha aufruft, lautet die öffentliche OpenRouter-ID z-ai/glm-5.3-flash; direkte Z.ai-Anfragen verwenden die allgemeine Basis-URL https://api.z.ai/api/paas/v4. Z.ai dokumentiert außerdem einen separaten Coding-Plan-Endpunkt: https://api.z.ai/api/coding/paas/v4. Gehe deshalb nicht davon aus, dass Abonnementzugang und allgemeine API identische Abrechnung oder Limits haben.
„Für mich hat sich nichts geändert. Beide Modelle sind für mein System mit 32 GB RAM viel zu groß.“ – u/dampflokfreund, r/LocalLLaMA
Alternativen im Vergleich: Preis, Kontext und Bereitstellungsweg
Die folgenden Preise sind Anbieterangaben, geprüft am August 28, 2026. Es handelt sich nicht um eine einheitliche Aktion: DeepSeek unterscheidet zwischen Peak- und Off-Peak-Zeiten, während der Flash-Preis von Z.ai bis September 9, 2026 at 24:00 UTC+8 vorübergehend reduziert ist.
| Modell | Input / 1M Tokens | Output / 1M Tokens | Kontext | Input-Modalitäten | Warum es ein guter Ersatz ist |
|---|---|---|---|---|---|
| DeepSeek V4 Flash | $0.22 Off-Peak; $0.44 Peak | $0.66 Off-Peak; $1.32 Peak | 1M | Text | Cache-bewusstes Text-Routing und Non-Thinking-Modus |
| Qwen3.8-Flash | $0.15 | $0.47 | 1M | Text, Bild, Video | Gehostete Multimodalität und API-Kompatibilität |
| GLM-5.3 | $1.40 | $4.40 | 1M | Text | Gleicher Anbieter, leistungsfähigeres Modell derselben Familie |
| GPT-5.6 Terra | $2.00 | $12.00 | 1.05M | Text | Mehr Sicherheit bei schwierigen Agentenaufgaben |
| Claude Opus 4.8 | $5.00 | $25.00 | 1M | Text | Anspruchsvolles Coding und Reviews mit langem Kontext |
| Kimi K3 | $3.00 | $15.00 | 1M | Text | Leistungsfähige Aufgaben mit langem Kontext |
Z.ai führt GLM-5.3-Flash während der 50%-Aktion derzeit mit $0.075 für Input, $0.015 für gecachten Input und $0.25 für Output pro Million Tokens. Die Listenpreise betragen $0.15, $0.03 für gecachten Input und $0.50. Die Vergleichsgrafik verwendet statt des vorübergehenden Aktionspreises den Listenpreis. (Z.ai-Preise)
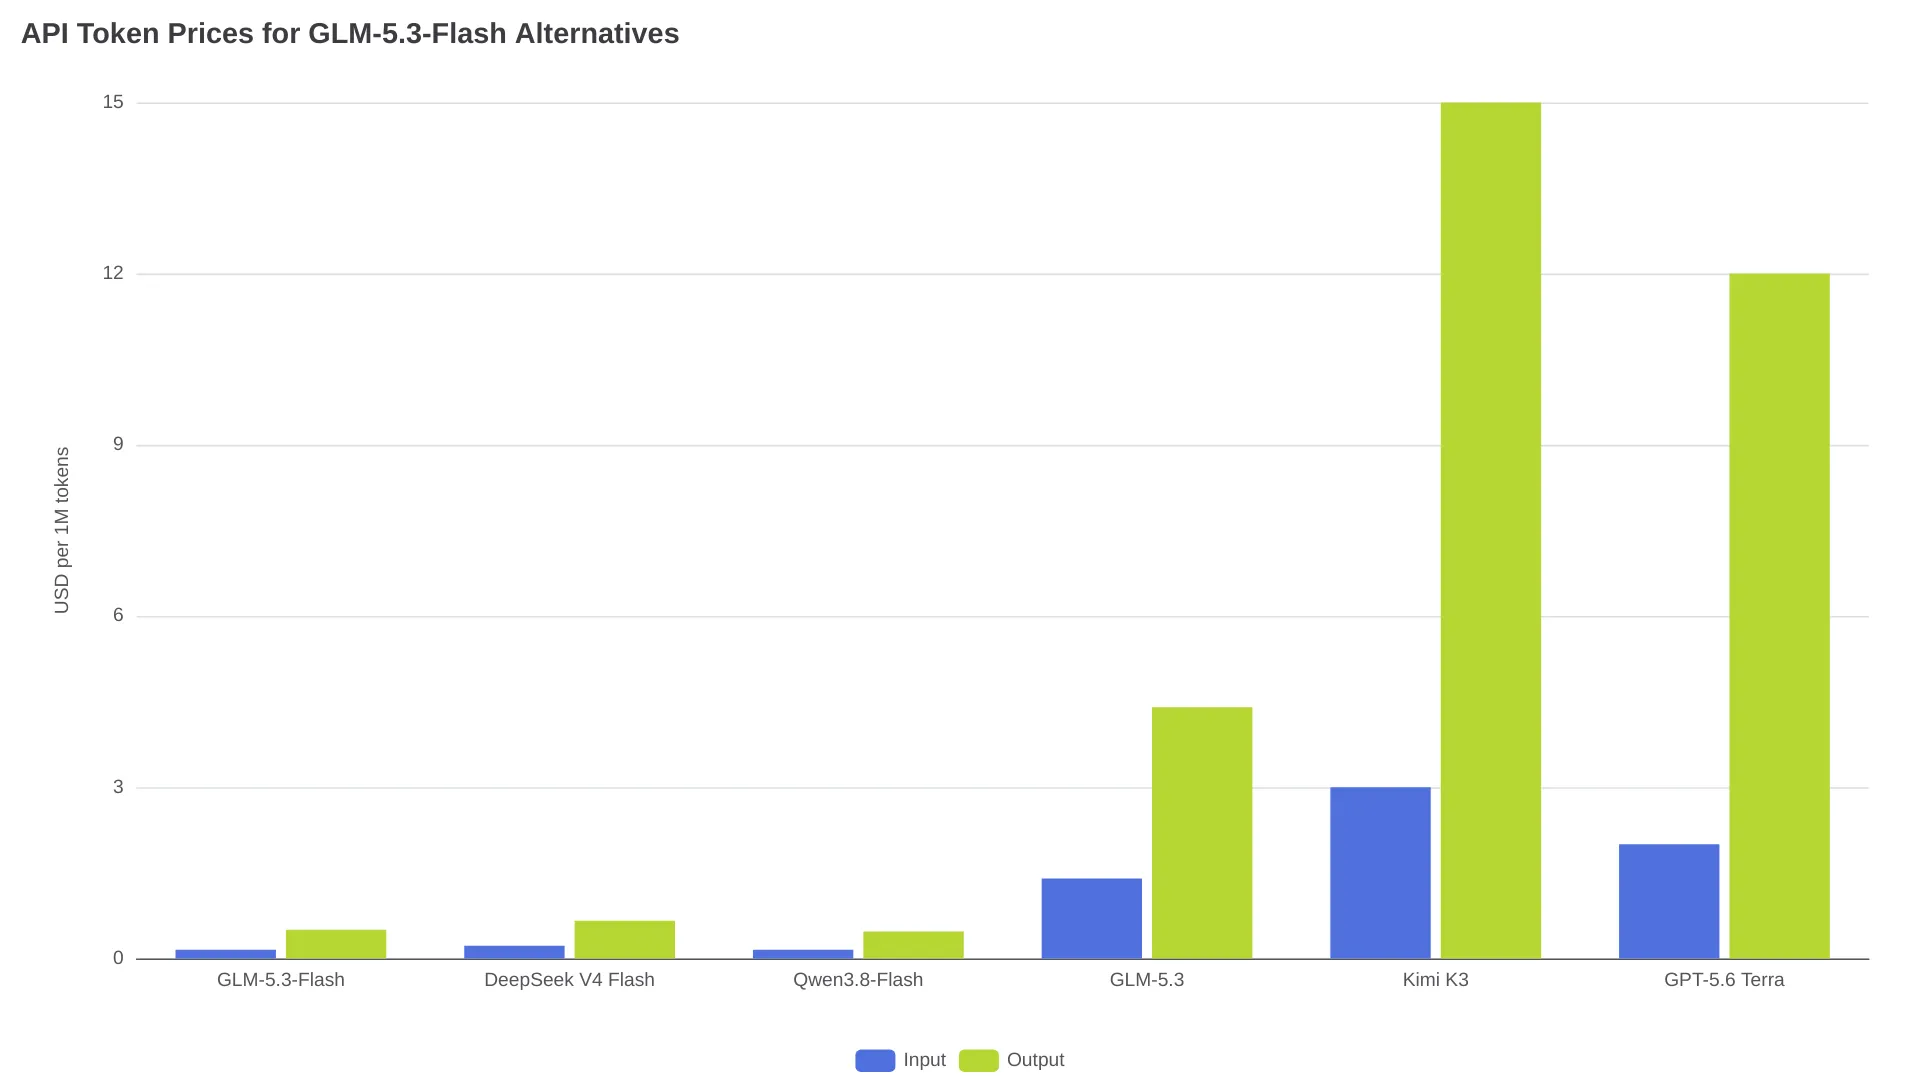
Preisgrundlage: Listenpreis von GLM-5.3-Flash, offizieller Off-Peak-Preis von DeepSeek V4 Flash und die aktuell von den Anbietern ausgewiesenen Preise der übrigen Modelle. Der Peak-Preis von DeepSeek ist doppelt so hoch wie der Off-Peak-Preis.
Die sechs realistischen Ersatzoptionen
DeepSeek V4 Flash: Text und Coding mit Cache-Fokus
DeepSeek V4 Flash sollte das erste Testmodell sein, wenn GLM-5.3-Flash für alltäglichen Textverkehr zu teuer ist. DeepSeek nennt 1M Token Kontext, maximal 384K Output-Tokens, JSON-Ausgabe, Tool-Aufrufe, die Responses API und einen Anthropic-kompatiblen Zugriff. Das offizielle Parallelitätslimit liegt bei 2.500 Anfragen.
Der Unterschied bei der Abrechnung ist entscheidend. DeepSeek trennt Cache-Hits von Cache-Misses und verdoppelt die Preise während der werktäglichen Peak-Zeiten von 01:00–04:00 und 06:00–10:00 UTC. Außerdem unterstützt das Modell Thinking- und Non-Thinking-Modi. Die Model Card von GLM-5.3-Flash dokumentiert dagegen niedrige, hohe und maximale Reasoning-Stufen statt eines einfachen No-Thinking-Modus.
DeepSeek V4 Flash eignet sich für Workloads mit wiederholtem Kontext, Retrieval-lastige Chats und textbasiertes Coding, bei dem Cache-Hits oder steuerbares Reasoning wichtig sind. Qwen3.8-Flash weist bei frischen Tokens niedrigere Preise aus – DeepSeek ist also nicht automatisch für jede Textanfrage die günstigste Wahl. Als visueller Drop-in-Ersatz taugt das Modell nicht: Bildeingaben laufen über den separaten Endpunkt deepseek-v4-flash-vision-exp, und aus Bildern abgeleitete Tokens werden als Input abgerechnet.
Qwen3.8-Flash: der ähnlichste gehostete Multimodal-Ersatz
Qwen3.8-Flash ist die naheliegendste gehostete Alternative, wenn dein Agent Screenshots, Diagramme oder Videos verarbeitet und du eine API-ähnliche Integration beibehalten möchtest. QwenCloud nennt Bild-, Text- und Videoeingaben, 1M Token Kontext, maximal 991K Input-Tokens und maximal 131K Output-Tokens. Unterstützt werden OpenAI- und Anthropic-kompatible APIs, Tools, strukturierte Ausgaben, Caching, Batch-Verarbeitung, Websuche und Fine-Tuning.
Der operative Haken liegt in der Cache-Struktur. QwenCloud nennt $0.016 pro Million Tokens für implizite Cache-Lesezugriffe, $0.20 für die explizite Cache-Erstellung und $0.47 für Output. Die veröffentlichten Limits liegen bei 2M Tokens pro Minute und 15.000 Anfragen pro Minute. Die Seite erklärt jedoch nicht, ob diese Limits pro Account, Key, Organisation oder Deployment gelten.
Qwen3.8-Flash ist die richtige Wahl, wenn visuelle Eingaben unverzichtbar sind oder der Preis für frische Tokens zählt. Auf der offiziellen Modellseite findet sich keine benannte Benchmark-Tabelle, keine Latenzmessung und keine Untersuchung zur Zuverlässigkeit langer Sitzungen. Validiere das Modell deshalb mit deinen eigenen Agenten-Traces, statt aus Funktionsgleichheit automatisch Verhaltensgleichheit abzuleiten.
GLM-5.3: der Aufstieg innerhalb derselben Familie
GLM-5.3 ist keine Budget-Alternative. Das Modell ist der sinnvolle nächste Schritt, wenn es bei textbasierten Aufgaben an Tiefe fehlt – nicht, wenn der Preis oder Multimodalität das Problem sind. Die Preisliste von Z.ai nennt $1.40 pro Million Input-Tokens, $0.26 für gecachten Input und $4.40 pro Million Output-Tokens. Damit liegt das Modell beim Listenpreis ungefähr eine Größenordnung über Flash.
Z.ai positioniert GLM-5.3 als Coding-Flaggschiff, während GLM-5.3-Flash das günstigere nativ multimodale Modell ist. Setze GLM-5.3 gezielt für schwierige, textorientierte Aufgaben ein. Der Wechsel kann den visuellen Workflow beseitigen, der Flash ursprünglich interessant gemacht hat.
GPT-5.6 Terra: für zuverlässigere Agentenausführung
GPT-5.6 Terra ist eine Premium-Option für Teams, denen das erfolgreiche Erledigen schwieriger Aufgaben wichtiger ist als niedrige Tokenpreise. OpenAI nennt $2 pro Million Input-Tokens, $0.20 für gecachten Input und $12 pro Million Output-Tokens bei einem Kontextfenster von rund 1.05M Tokens. In der veröffentlichten Benchmark-Tabelle von Z.ai erreicht GPT-5.6 Terra unter den dort genannten Setups 87.4 auf Terminal-Bench 2.1 und 69.6 auf DeepSWE v1.1. GLM-5.3-Flash kommt auf 84.3 beziehungsweise 63.4.
Diese Werte sprechen dafür, Terra zu testen, wenn ein fehlgeschlagenes Coding-Task teurer ist als eine höhere API-Rechnung. Sie belegen jedoch keine universelle Überlegenheit im Produktiveinsatz. Nutze Terra als Eskalationsstufe für wertvolle Änderungen an Repositories oder komplexe autonome Aufgaben.
Claude Opus 4.8: für schwieriges Coding und Reviews mit langem Kontext
Claude Opus 4.8 kostet nach Anthropic-Standardpreisen $5 pro Million Input-Tokens und $25 pro Million Output-Tokens. Anthropic nennt außerdem $0.50 pro Million Tokens für Cache-Lesezugriffe sowie Batch-Preise in Höhe der Hälfte der regulären Input- und Output-Preise.
In der Vergleichstabelle von Z.ai liegt Opus 4.8 bei Terminal-Bench 2.1, Agents’ Last Exam, HLE with Tools und NL2Repo vor GLM-5.3-Flash. Flash führt dagegen bei mehreren tool-lastigen und automatisierungsbezogenen Tests. Dieser Unterschied macht Opus eher zu einem gezielt eingesetzten Eskalationsmodell als zu einer universellen Standardeinstellung.
Kimi K3: für leistungsfähige Aufgaben mit 1M-Kontext, nicht für günstige Inferenz
Kimi K3 gehört in diesen Vergleich, weil es einen anderen Wechselgrund adressiert: Vielleicht brauchst du für langfristige Software-Engineering- oder Research-Workflows ein Modell mit 1M Token Kontext. Kimi nennt $0.30 pro Million gecachten Input-Tokens, $3 für Input und $15 für Output.
Bei diesen Preisen solltest du Kimi K3 nur wählen, wenn Kontextgröße und Leistungsprofil den Aufpreis rechtfertigen. Auf die Frage „Wie senke ich meine Tokenrechnung?“ ist es keine Antwort.
Wähle nach dem Workload, nicht nach dem Leaderboard
| Workload oder Einschränkung | Erstes Testmodell | Warum |
|---|---|---|
| Massenhafte Textklassifizierung oder Extraktion | Qwen3.8-Flash | Niedrigere ausgewiesene Preise für frische Input- und Output-Tokens als DeepSeek V4 Flash im Off-Peak |
| Lange Texte mit wiederholten Präfixen | DeepSeek V4 Flash | Cache-Hit-Preise und optionaler Non-Thinking-Modus |
| Lange Texte mit überwiegend frischem Input | Qwen3.8-Flash | Niedrigere Preise für frische Tokens |
| Screenshots, Diagramme oder Videos in einem API-Workflow | Qwen3.8-Flash | Native Bild-/Videoeingaben und vertraute API-Protokolle |
| Gleiches Z.ai-Ökosystem, aber anspruchsvolleres Text-Reasoning | GLM-5.3 | Der Anbieter bleibt gleich, die Modellstufe steigt |
| Coding, bei dem Fehler teuer sind | GPT-5.6 Terra | Premium-Eskalation mit besseren ausgewiesenen Coding-Scores |
| Sorgfältiges Code-Review oder Repository-Planung | Claude Opus 4.8 | Premium-Reasoning plus Cache- und Batch-Optionen |
| Lang laufende Aufgaben, bei denen Kontext wichtiger ist als der Preis | Kimi K3 | Positionierung als leistungsfähige 1M-Kontext-Option |
| Gewöhnlicher Laptop oder 32-GB-Workstation | Zuerst eine gehostete API | GLM-5.3-Flash ist ein Checkpoint mit insgesamt rund 320B Parametern, kein lokales 18B-Modell |
Die Einschränkung beim lokalen Betrieb ist erheblich. Der offizielle GLM-5.3-Flash-Checkpoint wird mit insgesamt rund 320B Parametern beschrieben. Im Deployment-Test von AIReiter wird ein FP8-Footprint von etwa 306 GiB und ein standardmäßiges vLLM-Deployment mit rund 386GB VRAM genannt. Quantisierung senkt die Anforderungen, macht daraus aber keinen normalen Laptop-Download.
Ein sichereres Migrationsmuster für Agenten
Halte den Provider-Adapter vom Task-Routing getrennt und bewerte den Ersatz anhand der Aufgaben, die für dich wirklich zählen.
- Behalte eine einheitliche Request-Schnittstelle. Bewahre die OpenAI-kompatible Schicht für Nachrichten, Tools und strukturierte Ausgaben dort, wo der jeweilige Anbieter sie unterstützt. Behandle Reasoning-Steuerung, Vision-Payloads, Tool-Aufrufe, strukturierte Ausgaben und Kontextlimits als Capability-Flags – nicht als universell verfügbare Felder.
- Teste abgeschlossene Aufgaben, nicht nur erzeugten Text. Erfasse, ob der Code baut, der Tool-Aufruf gültig ist, die visuelle Prüfung bestanden wird und die Aufgabe ohne erneuten Versuch endet. Eine günstige erste Antwort ist nicht zwingend günstiger, wenn danach zwei weitere Versuche in Repository-Größe nötig sind.
- Route nach dem Fehlerbild. Schicke Texte mit wiederholtem Kontext an DeepSeek V4 Flash, multimodale Anfragen an Qwen3.8-Flash und risikoreiche Coding-Aufgaben an GPT-5.6 Terra, Claude Opus 4.8 oder GLM-5.3 – abhängig von deinen Ergebnissen zur Erfolgsquote.
- Halte einen Fallback bereit. Der AIReiter-Test dokumentiert einen Community-Test über sieben Tage mit 30 erfolgreichen Builds bei 49 Versuchen und 14 Timeouts. Das ist keine allgemeingültige Ausfallquote des Anbieters, aber ein ausreichender Grund, keinen produktiven Agenten über nur eine Route laufen zu lassen.
- Plane mit regulären Preisen. Die Flash-Aktion von Z.ai endet am September 9, 2026. Bei DeepSeek ändern sich die Preise abhängig vom Zeitfenster. Qwen berechnet Cache-Erstellung und Cache-Lesezugriffe unterschiedlich. Eine Migration, die nur unter einem zeitlich begrenzten Preis funktioniert, ist kein stabiles Kostenmodell.
Ein sinnvoller erster Test besteht aus zehn routinemäßigen oder textlastigen Anfragen sowie zehn Coding-, Tool-Use- oder visuellen Aufgaben. Vergleiche die Erfolgsquote abgeschlossener Aufgaben, die gesamte Bearbeitungszeit, Wiederholungen und die gesamten Tokenkosten. Für viele Teams bedeutet das: DeepSeek V4 Flash für Text mit wiederholtem Kontext und Qwen3.8-Flash für multimodale Aufgaben testen und GLM-5.3-Flash als Fallback behalten, bis sich die neuen Wege als zuverlässig erwiesen haben.
FAQ
Was ist die beste kostenlose Alternative zu Ox Alpha?
In den hier geprüften offiziellen Quellen findet sich kein dauerhaft verfügbarer, anbieterneutraler kostenloser Ersatz. Anbieter können ihre Kontingente oder Aktionen ändern. Für eine Entscheidung im Produktiveinsatz solltest du daher die veröffentlichten Preise zugrunde legen und kostenlosen Zugriff als Bonus betrachten.
Welche Alternative unterstützt Bilder und Videos?
Qwen3.8-Flash führt offiziell Bild-, Text- und Videoeingaben auf. Der Standard-Endpunkt von DeepSeek V4 Flash unterscheidet sich vom Endpunkt deepseek-v4-flash-vision-exp. Teste deshalb den exakten Endpunkt, bevor du einen visuellen Agenten migrierst.
Welche Alternative kann ich lokal betreiben?
Zu den Open-Weight-Optionen gehören der GLM-5.3-Flash-Checkpoint und Qwen3.8-Flash-Next. GLM-5.3-Flash verfügt über insgesamt rund 320B Parameter. Die Dokumentation von Qwens Open-Weight-Modell Flash-Next beschreibt einen nativen Kontext von 262K, der sich mit YaRN auf 1M erweitern lässt. Keines der beiden Modelle sollte als passend für ein System mit 32GB angenommen werden.
Wie vermeide ich Überraschungen nach dem Anbieterwechsel?
Führe 20 repräsentative Aufgaben über zwei Routen aus und vergleiche die Erfolgsquote abgeschlossener Aufgaben, die gesamte Bearbeitungszeit, Wiederholungen und die gesamten Tokenkosten. Behalte die bestehende GLM-5.3-Flash-Route als Fallback, bis sich der Ersatz mit deinen eigenen Tools und Repositories als zuverlässig erwiesen hat.