 AIREITER
Claude Sonnet 5.5 verbindet einen Preis von 2 US-Dollar pro einer Million Input-Tokens mit einem veröffentlichten Terminal-Bench-4.0-Ergebnis von 70,6 Prozent. Bei Agentenläufen mit maximalem Effort können die tatsächlichen Kosten pro akzeptierter Änderung jedoch deutlich höher ausfallen. Für Teams, die ein Produktionsmodell für Coding-Aufgaben auswählen, ist Sonnet 5.5 die naheliegende Standardroute für einen Pilotbetrieb – aber kein automatischer Ersatz für Opus 5.5.
Das Produktionsfazit: Sonnet 5.5 als Standard für Coding-Aufgaben einsetzen
Startet mit Claude Sonnet 5.5 zunächst bei klar abgegrenzten Bugfixes, Refactorings, der Testgenerierung und Repository-Aufgaben mit Tool-Nutzung. Im von Anthropic veröffentlichten Terminal-Bench 4.0 erreicht Sonnet 5.5 70,6 Prozent. Damit liegt das Modell vor Claude Opus 5.5 mit 66,4 Prozent und Claude Sonnet 5 mit 10,3 Prozent im selben Vergleich.
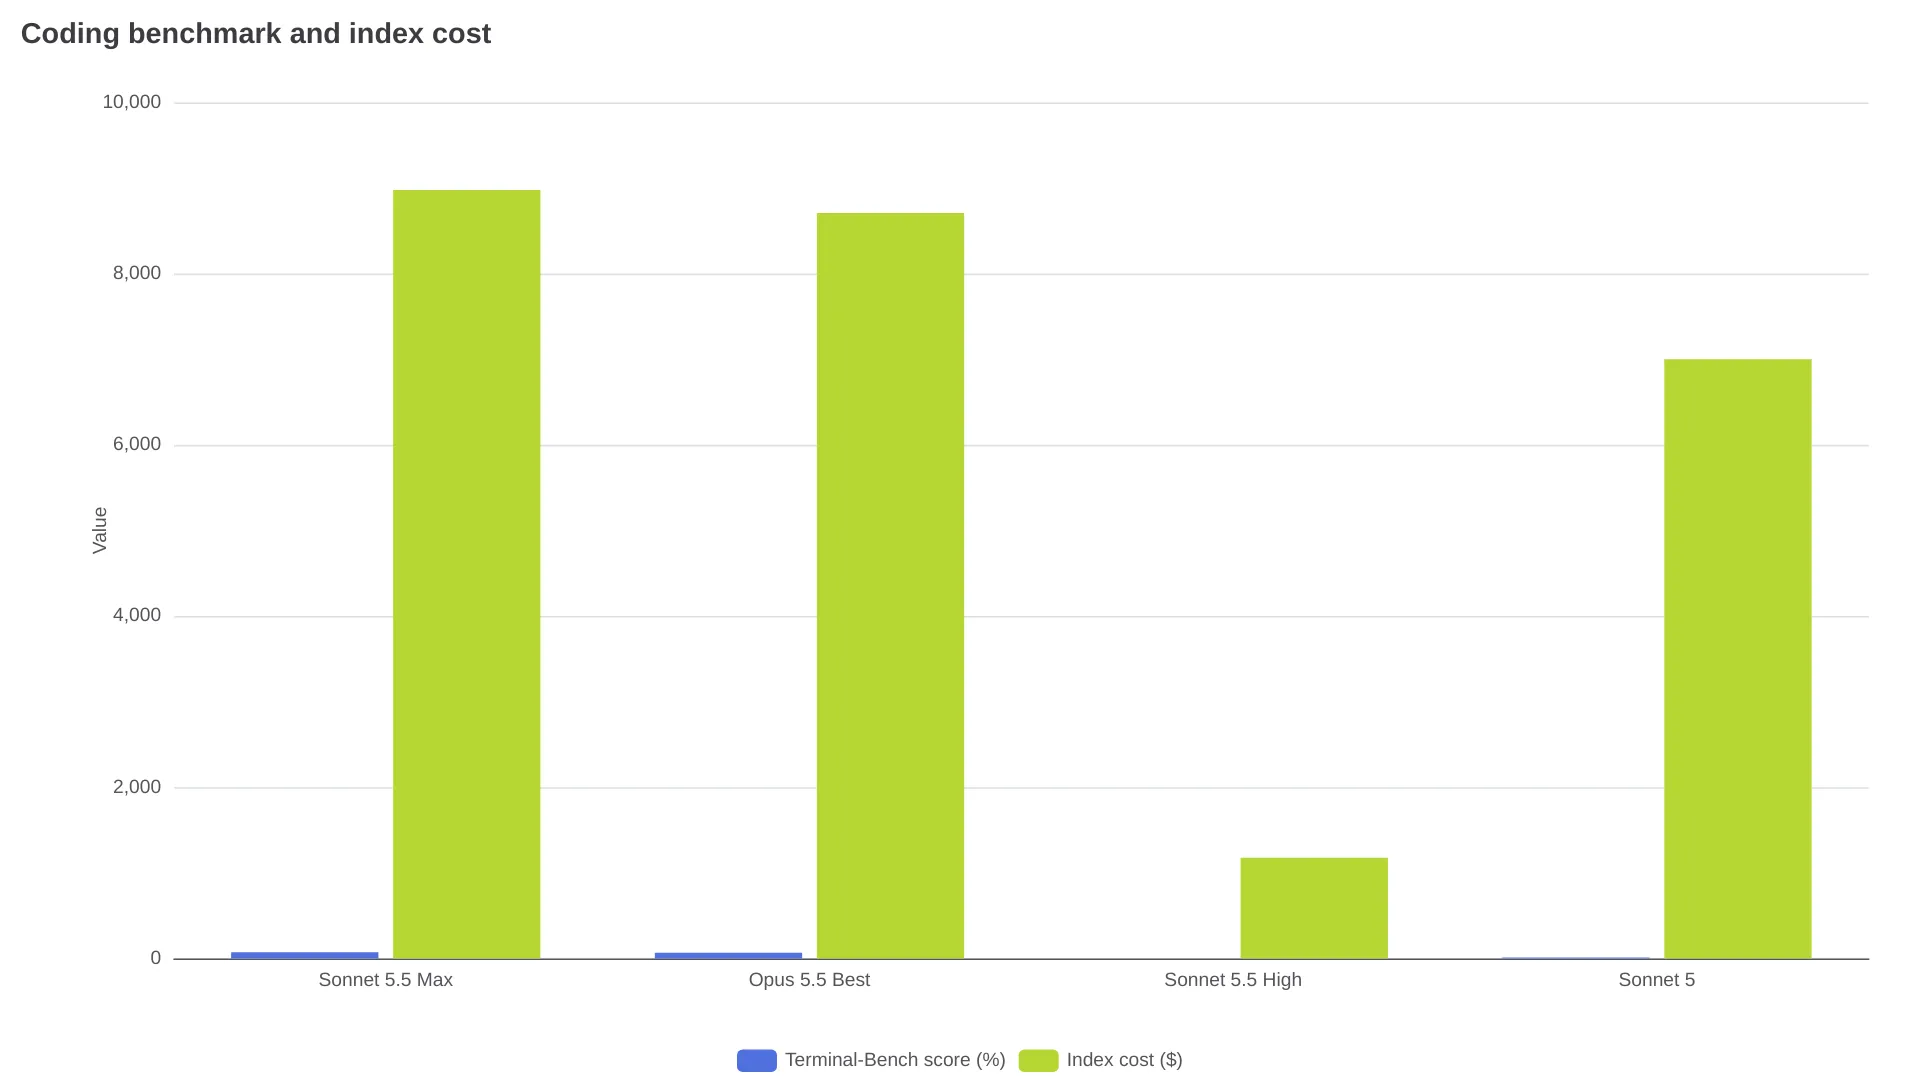
Eine wichtige Leitplanke bleibt: Effort und Ausgabelimits müssen explizit gesetzt werden. Unabhängige Kostenanalysen zeigen, dass Sonnet 5.5 bei maximalem Effort pro Benchmark-Aufgabe teurer sein kann als Opus 5.5 – trotz der niedrigeren Listenpreise von Sonnet.
Was Claude Sonnet 5.5 für API-Teams verändert
Claude Sonnet 5.5 wurde am 28. September 2026 veröffentlicht. Die offizielle Modelldokumentation nennt die Model-ID claude-sonnet-5-5, ein Kontextfenster mit 1 Million Tokens, eine standardmäßige maximale Ausgabe von 128.000 Tokens, adaptives Thinking und das standardmäßige API-Effort-Level high.
| Produktionsdetail | Claude Sonnet 5.5 |
|---|---|
| Veröffentlichungsdatum | 28. September 2026 |
| Model-ID | claude-sonnet-5-5 |
| Kontextfenster | 1M Tokens |
| Standardmäßige maximale Ausgabe | 128K Tokens |
| Maximale Ausgabe im Batch | 300K Tokens mit dem dokumentierten Beta-Header |
| Standardmäßiges API-Effort-Level | high |
Anthropic verpflichtet sich in der Dokumentation, das Modell nicht vor dem 28. September 2027 einzustellen. Das ist eine Mindestzusage für den Lebenszyklus, aber kein verbindlicher Termin für die endgültige Abschaltung.
Die API-Standardeinstellungen, die eure Coding-Kosten beeinflussen
Adaptives Thinking ist standardmäßig aktiviert. Teams, die von Sonnet 5 migrieren, sollten between_tools testen, wenn sie Thinking zu Beginn deaktivieren müssen. Laut offizieller Dokumentation führt erzwungene Tool-Nutzung inzwischen zu einem Fehler. Auch von den Standardwerten abweichende Einstellungen für temperature, top_p oder top_k lösen HTTP-400-Fehler aus.
Text, der zwischen Tool-Aufrufen generiert wird, kann in thinking-Blöcken eintreffen. Ein Streaming-Client, der bei jeder Zwischenmeldung einen gewöhnlichen Textblock erwartet, kann nach der Migration scheinbar keine Ausgabe mehr liefern. Aktualisiert daher zuerst den Parser, bevor ihr Sonnet 5.5 in einen bestehenden Coding-Agenten routet.
Terminal-Bench: Stark genug für die Standardroute
Der wichtigste Coding-Agent-Benchmark in diesem Vergleich ist Terminal-Bench 4.0. Er bewertet mehrstufige Aufgaben auf der Kommandozeile. Die von Anthropic gemeldeten Ergebnisse sehen Sonnet 5.5 bei 70,6 Prozent, gegenüber 66,4 Prozent für Opus 5.5 und 10,3 Prozent für Sonnet 5.
| Modell | Terminal-Bench 4.0 | GDPval-AA Elo | CursorBench 4.0 |
|---|---|---|---|
| Claude Sonnet 5.5 | 70,6 % | 1844 | 55,5 % |
| Claude Opus 5.5 | 66,4 % | 1846 | 57,8 % |
| Claude Sonnet 5 | 10,3 % | 1449 | 34,1 % |
Die obigen Benchmark-Werte stammen aus der Benchmark-Zusammenfassung von DataCamp, die die Evaluationsergebnisse dem Launch-Material von Anthropic zuschreibt. Sonnet 5.5 führt den Vergleich beim Terminal-Coding an. Bei CursorBench und mehreren breiteren Evaluierungen zu Reasoning und Wissensarbeit liegt Opus 5.5 jedoch weiterhin vorn.
Validiert das Modell mit Replays aus echten Repositories. Entscheidend sind bestandene Tests, Tool-Aufrufe und akzeptierte Änderungen – nicht nur die erzeugten Diffs.
Claude Sonnet 5.5 API: Preise unter realen Bedingungen
Die Preisliste von Anthropic ist übersichtlich. Ein Coding-Agent bezahlt allerdings möglicherweise für mehr als nur den sichtbaren Prompt. Thinking-Tokens werden als Output abgerechnet, und wiederholter Repository-Kontext kann sich über mehrere Turns hinweg als Cache-Read summieren.
| API-Posten | Preis von Claude Sonnet 5.5 |
|---|---|
| Input | 2 US-Dollar pro 1M Tokens |
| Output einschließlich Thinking | 10 US-Dollar pro 1M Tokens |
| 5-Minuten-Cache-Write | 2,50 US-Dollar pro 1M Tokens |
| 1-Stunden-Cache-Write | 4 US-Dollar pro 1M Tokens |
| Cache-Read | 0,20 US-Dollar pro 1M Tokens |
| Batch-Input | 50 % Rabatt, entspricht 1 US-Dollar pro 1M |
| Batch-Output | 50 % Rabatt, entspricht 5 US-Dollar pro 1M |
Die offiziellen Dokumente nennen einen cachebaren Prompt von mindestens 512 Tokens und erklären, dass Sonnet 5.5 adaptives Thinking verwendet. Laut der unabhängigen Preisanalyse von eesel nutzt Sonnet 5.5 denselben Tokenizer wie Sonnet 5. Eine Migration senkt die Tokenzahl also nicht automatisch.
Eine Anfrage mit 4.000 Input-Tokens und 700 Output-Tokens kostet vor weiteren Gebühren rund 0,015 US-Dollar: 0,008 US-Dollar für den Input plus 0,007 US-Dollar für den Output. Ein Coding-Agent mit 20 Turns, jeweils 3.000 neuen Input-Tokens und 2.000 Output-Tokens, würde vor Cache-Reads, Cache-Writes, Tools und Wiederholungen ungefähr 0,12 US-Dollar für den neuen Input und 0,40 US-Dollar für den Output verbrauchen. Das sind Rechenbeispiele für bestimmte Workloads, keine allgemeingültigen Preise pro Aufgabe.
Das Effort-Level steuert die Rechnung
Die Effort-Analyse von TokenCost, die auf Messungen des Artificial Analysis Intelligence Index basiert, meldete für Sonnet 5.5 folgende Ergebnisse:
| Effort | Score | Kosten für den vollständigen Index |
|---|---|---|
| Low | 35,8 | 544 US-Dollar |
| Medium | 40,7 | 701 US-Dollar |
| High | 46,7 | 1.176 US-Dollar |
| Xhigh | 51,9 | 2.738 US-Dollar |
| Max | 56,0 | 8.977 US-Dollar |
Der Max-Wert ist das entscheidende Warnsignal. In derselben Analyse kam Opus 5.5 bei Max auf 57,6 für 8.708 US-Dollar, während Opus 5.5 bei Xhigh 56,0 für 4.057 US-Dollar erreichte. Sonnet 5.5 erzeugte in diesem Test bei Max ungefähr 193.000 Output-Tokens pro Aufgabe.
Startet mit Medium oder High, begrenzt die Zahl der Output-Tokens und eskaliert nur fehlgeschlagene oder besonders kritische Aufgaben auf eine teurere Route. Übernehmt keine alte Max-Einstellung von Sonnet 5 für Sonnet 5.5, ohne Kosten und Qualität erneut zu evaluieren.
Migrations-Checkliste für ein Coding-Modell im Produktivbetrieb
claude-sonnet-5-5zunächst in der Staging-Umgebung fest verankern, statt global einen Alias umzustellen.- Repräsentative Bugfixes, Refactorings, Tests und Änderungen über mehrere Dateien aus euren Repositories erneut ausführen.
- Das Effort-Level explizit setzen und Output-Tokens, Cache-Reads, Tool-Aufrufe, Laufzeit sowie die Rate akzeptierter Änderungen protokollieren.
thinking: disabledgegebenenfalls durch das unterstützte Verhaltenbetween_toolsersetzen.- Annahmen zur erzwungenen Tool-Nutzung entfernen und das neue Verhalten bei der Tool-Auswahl testen.
- Den Streaming-Code so aktualisieren, dass er
thinking-Blöcke zwischen Tool-Aufrufen verarbeitet. - Sampling-Parameter außerhalb der Standardwerte erneut prüfen. Laut offizieller Dokumentation führen nicht standardmäßige Werte für
temperature,top_pundtop_kzu 400-Fehlern. - Ein Ausgabenlimit und eine Abbruchbedingung für ausufernde Ausgaben oder wiederholte Tool-Schleifen einbauen.
- Die Kosten pro akzeptierter Änderung vergleichen, nicht die Kosten pro Anfrage.
- Mit einem kleinen Anteil des Traffics starten. Sonnet sollte nur dann hochskaliert werden, wenn die Rate akzeptierter Änderungen innerhalb der vereinbarten Toleranz der bisherigen Lösung entspricht und zugleich die Kosten pro akzeptierter Änderung sinken.
Der Anthropic-Mitarbeiter @cjav_dev berichtete, dass Anfragen mit thinking: {"type":"disabled"} zunächst mit 400-Fehlern beantwortet wurden und stattdessen auf between_tools umgestellt werden sollten (Beitrag auf X).
Wann Sonnet 5.5, Opus 5.5 oder ein günstigeres Modell sinnvoll ist
| Workload | Erste Empfehlung | Warum |
|---|---|---|
| Abgegrenzte Bugfixes und Refactorings | Sonnet 5.5 mit Medium/High | Starkes Terminal-Ergebnis bei niedrigeren Tokenpreisen |
| Code-Klassifizierung in großen Mengen oder einfache Änderungen | Sonnet 5.5 mit Low/Medium oder ein günstigeres Modell | Keine unnötigen Reasoning-Kosten bezahlen |
| Lang laufender Repository-Agent | Sonnet 5.5 mit Caching und harten Budgets | Cache-Nutzung und Turn-Anzahl bestimmen die tatsächliche Rechnung |
| Uneindeutige Architekturentscheidungen oder abschließendes Review | Opus 5.5 | Breiteres Urteilsvermögen ist wichtiger als die niedrigste Preisliste |
| Offline-Codeanalyse ohne Zeitdruck | Sonnet 5.5 Batch API | Die API bietet 50 % Rabatt auf Input und Output |
| Terminal-Experiment mit maximalem Effort | Sonnet 5.5 erst nach einem internen Benchmark | Terminal-Bench ist eine Stärke, Max kann jedoch teuer werden |
Setzt Sonnet für klar definierte, messbare Aufgaben ein und gebt uneindeutige Architekturarbeit an Opus weiter.
Claude Sonnet 5.5 API: Häufige Fragen
Was kostet die Claude Sonnet 5.5 API?
Der Standardpreis liegt bei 2 US-Dollar pro einer Million Input-Tokens und 10 US-Dollar pro einer Million Output-Tokens. Cache-Reads kosten 0,20 US-Dollar pro einer Million Tokens. Cache-Writes kosten 2,50 US-Dollar für fünf Minuten oder 4 US-Dollar für eine Stunde. Die Batch API reduziert die Kosten für Input und Output um 50 Prozent.
Ist Sonnet 5.5 beim Coding besser als Opus 5.5?
Sonnet 5.5 führt den veröffentlichten Vergleich in Terminal-Bench 4.0 mit 70,6 Prozent gegenüber 66,4 Prozent für Opus 5.5 an. Bei mehreren anderen Evaluierungen liegt Opus weiterhin vorn. Teams sollten daher nach Aufgabentyp routen, statt das Coding-Ergebnis als allgemeingültiges Ranking zu interpretieren.
Wie lautet die Model-ID von Sonnet 5.5?
Verwendet claude-sonnet-5-5 mit der Claude API. Die anbieterspezifischen Kennungen stehen in der Modelldokumentation von Anthropic.
Unterstützt Sonnet 5.5 ein Kontextfenster mit 1 Million Tokens?
Ja. Anthropic nennt ein Kontextfenster mit 1 Million Tokens und eine standardmäßige maximale Ausgabe von 128.000 Tokens. Die Message Batches API kann in der Beta mit dem dokumentierten Beta-Header Ausgaben von 300.000 Tokens unterstützen.
Was ändert sich bei der Migration von Sonnet 5?
Adaptives Thinking und das Verhalten von Response-Blöcken wurden geändert. Erzwungene Tool-Nutzung kann zu Fehlern führen, nicht standardmäßige Sampling-Parameter können 400-Fehler auslösen und thinking: disabled muss durch das unterstützte Verhalten ersetzt werden. Führt vor dem Produktiv-Rollout erneut Agenten- und Streaming-Tests durch.
Führt einen einwöchigen Replay-Pilot mit Medium/High-Effort durch, messt die Kosten pro akzeptierter Änderung und eskaliert fehlgeschlagene Fälle an Opus.