 AIREITER
从官方公布的对比结果看,Qwen-UI-Agent 在移动端使用任务上表现最突出:真实设备测试 MobileWorld-Real 达到 92.2%,AndroidDaily 达到 97.5%。但支撑这些成绩的 27B 模型,目前既没有确认公开的权重,也没有 API 可用。现阶段,开发者能拿到的是技术报告、演示内容,以及其较小的前代模型 MAI-UI 权重。排行榜上的领先与实际可用性之间的落差,正是这次发布最值得关注的部分。本文汇总全部官方成绩,并逐项核查你现在究竟能获取什么。
Qwen-UI-Agent 官方成绩总览
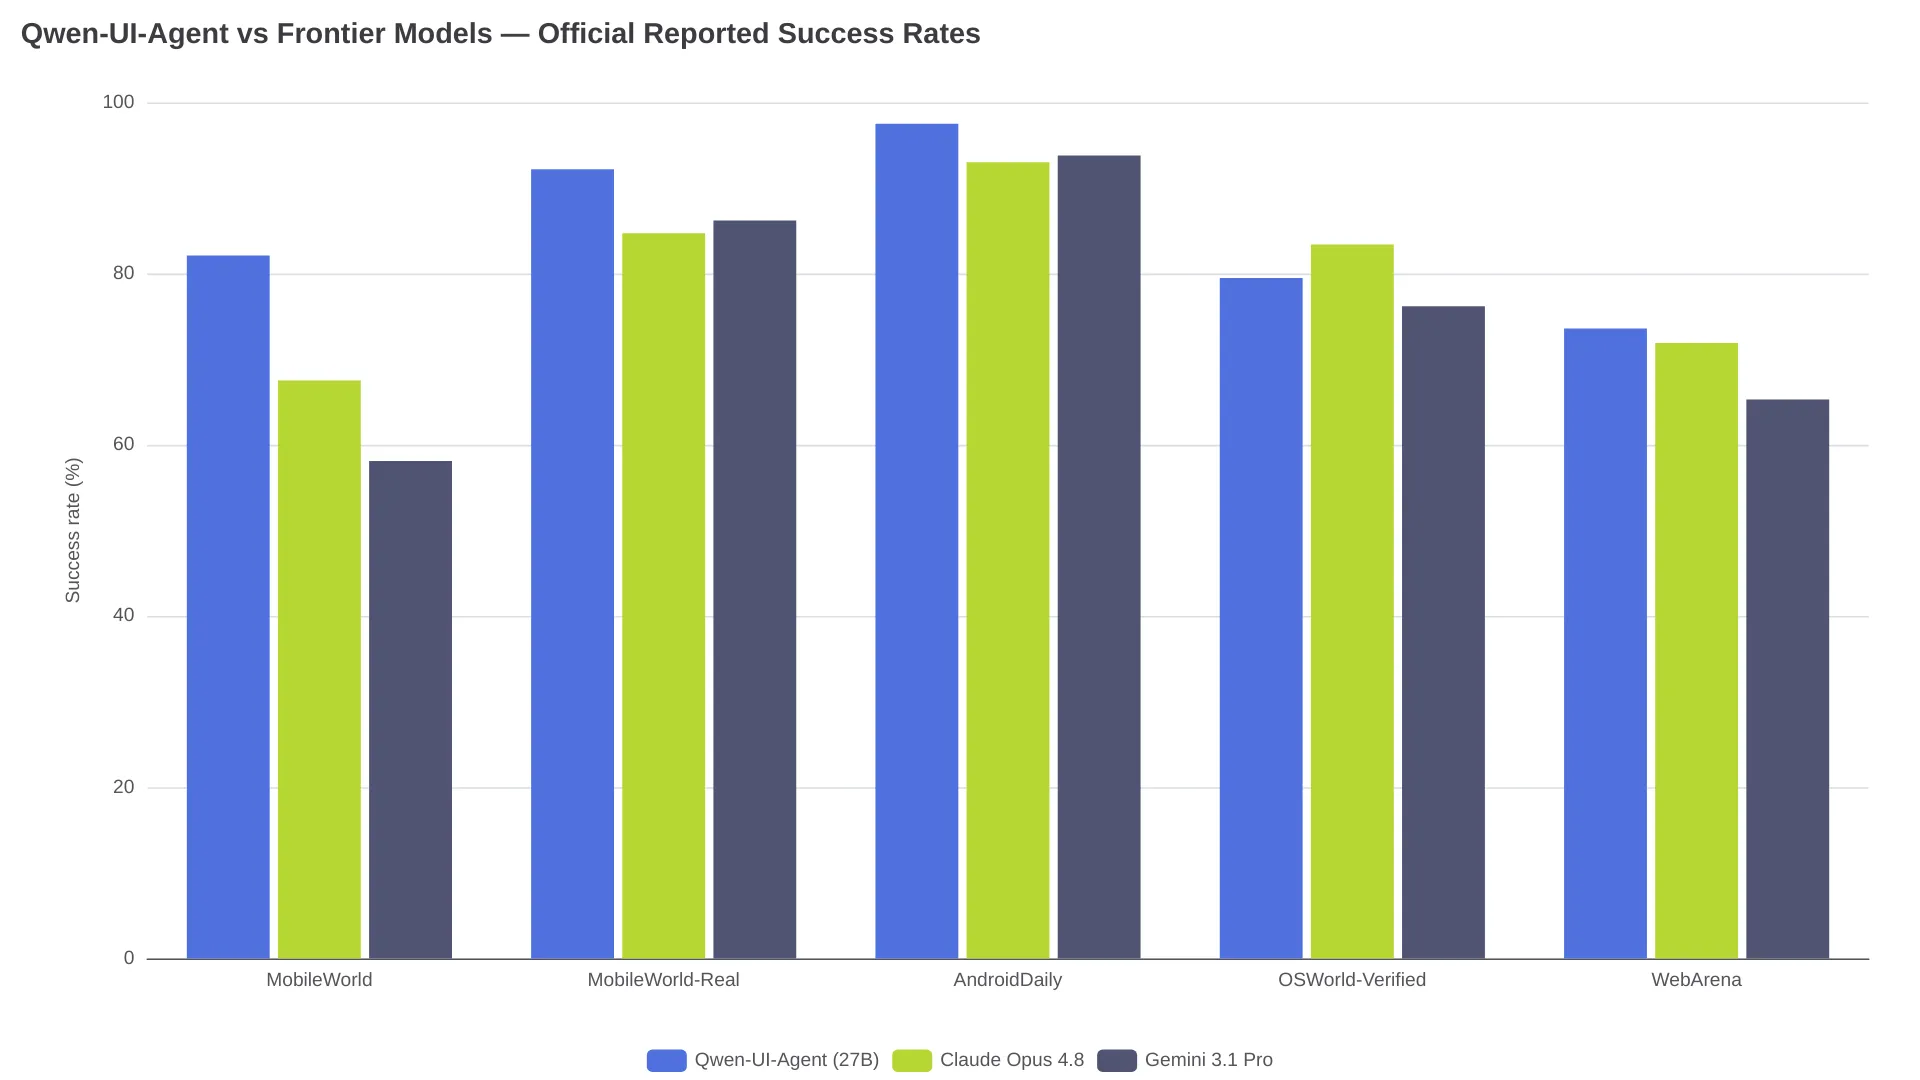
Qwen-UI-Agent 是阿里巴巴通义 MAI 团队发布的一款基础 GUI Agent,技术报告于 2026 年 7 月 30 日发布(arXiv 2607.28227)。同一个模型覆盖移动端、电脑操作、网页和 DeepSearch 环境,采用统一动作空间,支持 GUI 操作、CLI 执行及批量动作序列。根据官方结果页面,Qwen-UI-Agent 在展示的全部移动端和定位类基准中均排名第一;OSWorld-Verified 位列第二,长时程测试 OSWorld-v2 则排名第三。报告评测了 27B、35B-A3B 和 4B 三个版本,以下分数均对应旗舰 27B 模型。
移动端:领先优势最明显的战场
移动端是报告明确宣称达到业界最佳水平的领域,而且领先幅度相当显著。在 MobileWorld 的纯 GUI 划分中,Qwen-UI-Agent 取得 82.1%,比排名第二的通用模型 Seed 2.1 Pro(73.2%)高 8.9 个百分点;相较最强的专用 GUI Agent GUI-Owl-1.5-32B-Instruct(43.9%),则高出 38.2 个百分点。
| 模型 | MobileWorld(纯 GUI) | MobileWorld-Real | AndroidDaily |
|---|---|---|---|
| Qwen-UI-Agent(Alibaba) | 82.1 | 92.2 | 97.5 |
| Seed 2.1 Pro(ByteDance) | 73.2 | 88.7 | 95.2 |
| Claude Opus 4.8(Anthropic) | 67.5 | 84.7 | 93.0 |
| Gemini 3.1 Pro(Google) | 58.1 | 86.2 | 93.8 |
| Qwen 3.7 Plus(Alibaba) | 62.3 | 72.7 | 79.8 |
引用单独的“GPT”成绩前,需要留意官方表格的设置:移动端项目采用 GPT-5.6 Sol,分数为 70.1 / 85.4 / 92.6;桌面端项目使用的则是 GPT-5.5。
作为最核心的成绩,MobileWorld-Real 由作者团队自行构建:它包含 104 款真实 Android 应用中的 409 项端到端任务,覆盖七类日常使用场景;测试在真实设备上运行,使用真实账户,并纳入现实环境中的干扰因素,最终由五个 VLM 组成的多数投票评审器评分。
电脑操作:表现强劲,但并非第一
桌面端的表现更符合报告中“有竞争力”的表述。Qwen-UI-Agent 在 OSWorld-Verified 上取得 79.5%,排名第二,落后 Claude Opus 4.8 3.9 个百分点。长时程的 OSWorld-v2 上,其 40.0% 是部分进度得分,二元完成率为 13.9%;Claude Opus 4.8(54.8)和 GPT-5.5(49.5)都明显更高。
| 模型 | OSWorld-Verified | OSWorld-v2(部分进度) | OSWorld-v2(二元完成) |
|---|---|---|---|
| Claude Opus 4.8 | 83.4 | 54.8 | 未报告 |
| Qwen-UI-Agent | 79.5 | 40.0 | 13.9 |
| Seed 2.1 Pro | 78.8 | 未报告 | 未报告 |
| GPT-5.5 | 78.7 | 49.5 | 13.0 |
| MiniMax M3 | 未报告 | 22.3 | 未报告 |
不过,效率方面确有亮点。通过批量动作,每项任务的平均步数降至 135.8,MiniMax M3 为 326.7,Qwen 3.7 Plus 为 173.5;同时,它在部分进度上仍比所有开放权重模型至少高出 17 分。OSWorld-v2 中,CLI 命令占 Agent 操作的 50% 以上,GUI 与 CLI 混合执行的设计在这里确实发挥了可量化的作用。
浏览器任务与 DeepSearch
在 WebArena 上,Qwen-UI-Agent 以 73.6% 领先,超过 Claude Opus 4.8(71.9)、GPT-5.5(69.5)和 Gemini 3.1 Pro(65.3)。研究检索方面,BrowseComp 为 64.1,对比 Qwen3.5-27B 基线的 61.0;BrowseComp-ZH 达到 75.0,对比基线的 62.1。这表明 DeepSearch 训练带来的不只是界面点击能力提升。
GUI 定位:全部项目第一
GUI 定位任务要求模型根据视觉指令点击正确像素位置。按照官方结果页面,Qwen-UI-Agent 在所展示的每一项定位基准中均排名第一。
| 基准 | Qwen-UI-Agent | 最佳竞品 |
|---|---|---|
| ScreenSpot-Pro(无缩放) | 76.6 | 72.9(GUI-Owl-1.5) |
| ScreenSpot-Pro(放大) | 81.5 | 80.7(Seed 2.1 Pro) |
| SS-V2 | 97.5 | 96.6(Seed 2.1 Pro / Qwen 3.7 Plus) |
| MM-GUI-L2 | 92.6 | 91.3(MAI-UI) |
| OSW-G-R | 78.5 | 78.2(Qwen 3.7 Plus) |
| UI-Vision | 70.0 | 68.0(Qwen 3.7 Plus) |
通用能力的代价不大
专攻 GUI 的模型往往会牺牲语言模型能力,但 Qwen-UI-Agent 基本没有出现这种问题:MMLU-Pro 为 86.5,略高于 Qwen3.5-27B 的 86.0;IFEval 为 90.2,仅略低于后者的 90.4。与专用 GUI 模型相比,差距则十分悬殊。
| 基准 | Qwen-UI-Agent | Qwen3.5-27B | UI-Venus 30B-A3B | GUI-Owl 32B | OpenCUA-72B |
|---|---|---|---|---|---|
| Tau2-Bench | 89.9 | 89.2 | 22.7 | 6.1 | 14.4 |
| Terminal-Bench 2.0 | 50.1 | 41.1 | 3.2 | 0.0 | 9.0 |
| BFCL-v4 | 74.2 | 71.3 | 19.8 | 32.7 | 28.3 |
| BrowseComp | 64.1 | 61.0 | 未报告 | 未报告 | 未报告 |
| QwenClawBench | 44.2 | 48.5 | 6.4 | 5.1 | 11.4 |
相对自身基线,唯一明显落后的项目是 QwenClawBench:44.2 对 48.5。还应注意,官方页面将这些更广泛能力的成绩标为作者在其评测环境中复现所得。
Qwen-UI-Agent 的训练方式
技术报告显示,Qwen-UI-Agent 的训练数据来自真实设备集群:超过 100 部实体手机、覆盖 150+ 款应用。团队以此构建了由 Agent 驱动的数据飞轮,使模型能够自行生成并诊断任务。监督微调之后,还进行了多阶段 RL 训练,训练轨迹超过 100 轮,并在超过 10,000 个并发环境中展开。
这些排行榜成绩该如何看
官方页面直接给出了三项重要限定,任何引用其分数的人都应一并说明。第一,MobileWorld-Real 是作者团队自建的基准。第二,带匕首标记的基线成绩由作者在自己的环境中复现,测试框架、评审器、模拟器及任务子集可能与其他厂商的官方评测不同。第三,OSWorld-v2 的 40.0% 指的是部分进度,不是成功率。(来源:官方结果页注释及技术报告。)
“阿里巴巴的新 GUI Agent 赢下了手机端,却在桌面端受阻。”——X 上的 @Daily_AI_Brief,其同时指出:“阿里巴巴在自己的环境中评测了所有基线。”
X 上的独立解读得出了类似判断。@itarutomy 的日文解析指出其在真实设备移动端的领先,同时强调桌面端成绩为第二名。通义实验室 Pengxiang Li(@oliverlee1999)发布的官方公告帖,则是此次发布的一手来源。综合来看,MobileWorld-Real 应被视为一项有力、但仍等待独立复现的主张;OSWorld-Verified 则更适合作为跨环境比较依据,因为它并非由作者团队推出的基准。
现在如何获取 Qwen-UI-Agent
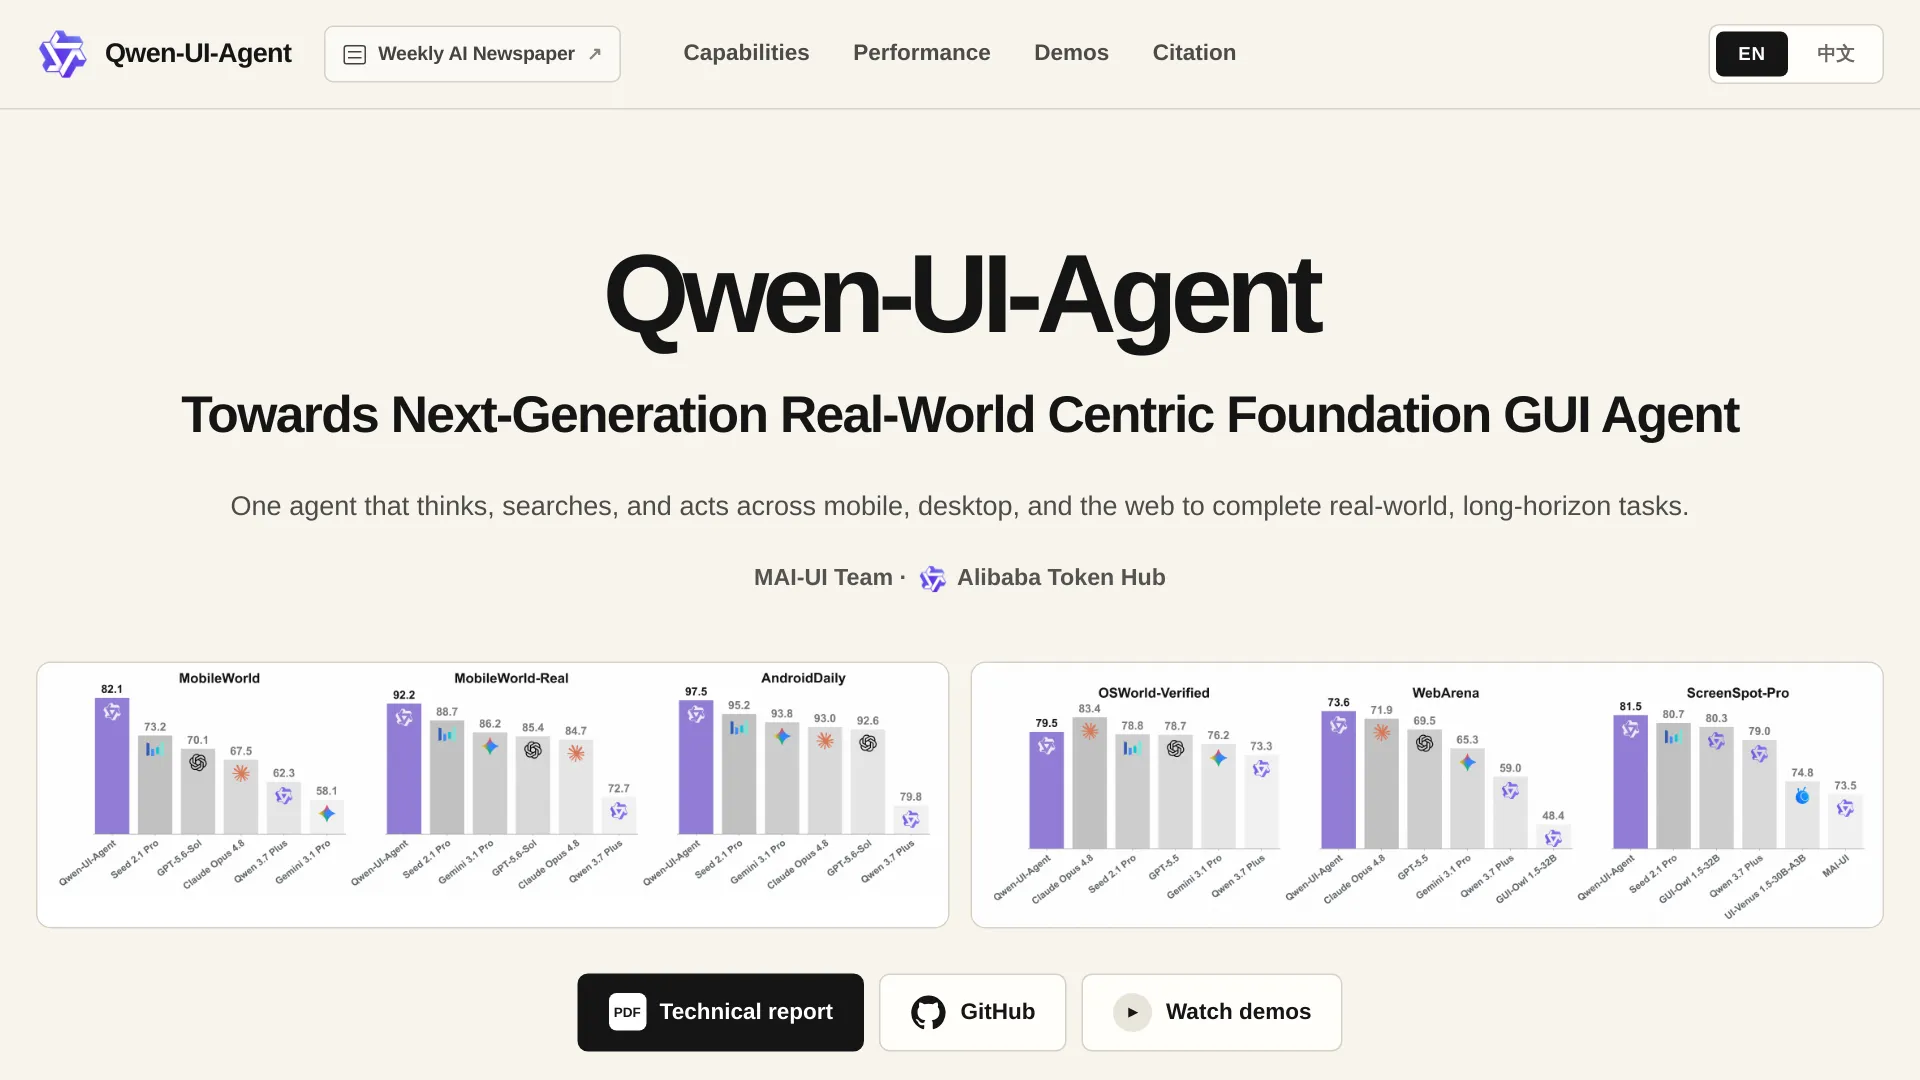
Qwen-UI-Agent 目前仍属于研究发布:有论文、项目页面和代码仓库,但模型本身没有确认公开的检查点。以下是各项公开资源实际包含的内容。
公开资源逐项核查
| 资源 | 链接 | 包含内容 |
|---|---|---|
| 技术报告 | arxiv.org/abs/2607.28227 | 完整论文,提交于 2026 年 7 月 30 日;提供 PDF、HTML 和 TeX 源文件 |
| 项目页面 | tongyi-mai.github.io/Qwen-UI-Agent | 能力演示、完整基准图表和引用信息 |
| MAI-UI 仓库 | github.com/Tongyi-MAI/MAI-UI | Apache-2.0 仓库,已改名用于 Qwen-UI-Agent;链接至 2025 年 12 月发布的 MAI-UI-8B 和 MAI-UI-2B Hugging Face 检查点 |
| Qwen-UI-Agent 仓库 | github.com/Tongyi-MAI/Qwen-UI-Agent | 仅包含网站源代码;仓库明确说明不含模型、训练代码或 Agent 实现 |
MAI-UI 仓库是这一产品线的官方延续阵地:它于 2026 年 7 月 30 日公布 Qwen-UI-Agent,目前也链接了这一谱系中仅有的可下载检查点。
权重实际开放到什么程度
目前仅可下载 MAI-UI-8B 和 MAI-UI-2B,它们是 2025 年 12 月发布的前代模型,可通过 MAI-UI 仓库中的 Hugging Face 引用获取。Qwen-UI-Agent 的 27B、35B-A3B 和 4B 检查点均没有确认公开。这里的可用性状态在 2026 年 8 月下旬依据官方仓库和项目页面核查,当时未发现任何模型发布。不要将 MAI-UI 检查点链接或仅含网站源代码的仓库误认为是 Qwen-UI-Agent 模型权重。
暂时没有 API,也无法自行部署
官方渠道中没有发现公开的 Qwen-UI-Agent API 端点、托管产品或 vLLM/Ollama 软件包。现阶段的实际选择很明确:如果你需要交付桌面自动化工作流,报告中的 OSWorld 成绩更倾向于 Claude Opus 4.8;如果你想试验开放权重 GUI 模型,可用路径是 MAI-UI 2B/8B 搭配自建测试框架——但那是 MAI-UI,不是 Qwen-UI-Agent。后续发布请关注官方 Tongyi-MAI 仓库和 Qwen 渠道。至于已提供 API 的通用 Qwen 产品线,AIReiter Qwen model catalog 会跟踪当前端点和价格。
Qwen-UI-Agent 在产品线中的位置
Qwen-UI-Agent 是阿里巴巴 GUI Agent 产品线的第三代:UI-TARS 在 2025 年率先探索基于 Qwen 的 GUI 路线;MAI-UI(arXiv 2512.22047,2025 年 12 月)引入面向真实世界的数据飞轮,并开源了 2B/8B 权重;Qwen-UI-Agent 则将这套方案扩展至 27B,并加入 GUI+CLI 混合执行。在上文表格所列的两项 OSWorld 指标中,Claude Opus 4.8 均居首位。
Qwen-UI-Agent 常见问题
Qwen-UI-Agent 是开源的吗?
代码仓库采用 Apache-2.0 协议,报告也已公开,但模型本身尚未确认以开放权重形式发布。目前可下载的只有前代 MAI-UI-8B 和 MAI-UI-2B 检查点(Hugging Face,2025 年 12 月)。截至本文撰写时,27B、35B-A3B 和 4B 的 Qwen-UI-Agent 检查点均没有确认公开发布。
现在能在本地运行 Qwen-UI-Agent 吗?
不能。目前没有经过验证的本地部署方案:没有检查点、没有 GGUF 或 Ollama 包,也没有 vLLM 配置方案。本地实验仅限于使用 MAI-UI 2B/8B 并自行搭建测试框架。
Qwen-UI-Agent 有 API 吗?
没有。官方尚未公布公开端点或托管产品。请关注 Tongyi-MAI 官方 GitHub 仓库及 Qwen 团队渠道的发布公告。
Qwen-UI-Agent 与 Claude Opus 4.8 的电脑操作能力如何比较?
Claude Opus 4.8 在 OSWorld-Verified 上以 83.4 领先 Qwen-UI-Agent 的 79.5,在 OSWorld-v2 部分进度上以 54.8 领先 40.0;而 Qwen-UI-Agent 在 WebArena 上以 73.6 领先 71.9,并在展示出的每项移动端基准中领先。当前的长时程桌面操作更偏向 Claude,Qwen-UI-Agent 报告中最强的则是移动优先场景。
MobileWorld-Real 是什么?
这是由 Qwen-UI-Agent 作者团队构建的真实设备 Android 基准:涵盖七类日常使用领域中 104 款在线应用的 409 项任务,由五个 VLM 组成的多数投票评审器评分。其结果为作者自报,仍有待独立复现。
哪些变化会改变当前判断
以下三个信号会实质性改变这一评估:
| 信号 | 重要性 |
|---|---|
| Tongyi-MAI 的 Hugging Face 页面出现 Qwen-UI-Agent 检查点 | 将研究发布转化为可构建的选择,并推动第三方跑分出现 |
| 阿里巴巴测试框架以外的 OSWorld-Verified 复现结果 | 可以确认 79.5% 是否能在作者环境之外成立 |
| 任何产品形态:API、Qwen 应用集成或预览版 | 让比较从论文表格进入实际生产取舍 |
在此之前,核心问题仍未解决:目前已发布对比中,移动端领先成绩属于自报结果,且使用的是同一团队自行构建的基准。
延伸阅读:关于阿里巴巴更新的通用旗舰模型及其开放权重状态,可参阅 Qwen3.8-Max open weights;端点成本详见 Qwen3.8-Max API pricing guide。