 AIREITER
百万 token 上下文加上 $0 接口,乍看之下,Nemotron 3 Ultra 很适合直接当默认模型。但实际并非如此:免费线路更适合评测,真正用于生产环境时,还要考虑供应商稳定性、数据处理方式,以及是否准备好付费备用线路。
Nemotron 3 Ultra API 值得用吗?
如果你的任务包括长时间运行的文本 Agent、大型文档分析,或需要超长上下文的编程工作流,Nemotron 3 Ultra 值得测试。对于低延迟的日常聊天、在公开记录的免费接口上处理机密提示词,或者没有备用方案的生产服务,它并不是理想的默认选择。
NVIDIA 于 2026 年 6 月 4 日发布 Nemotron 3 Ultra。官方模型卡显示,NVFP4 检查点为 1.0 GA 版本,采用 OpenMDW 1.1 许可证,允许商业和非商业使用。
| 决策依据 | 已验证数值 | 实际意义 |
|---|---|---|
| 模型规模 | 总计 550B,激活 55B | 稀疏计算不代表完整权重很小 |
| 最大上下文 | 最高 1M tokens | 不同线路的供应商限制可能更低 |
| 模态 | 文本输入与输出 | 不支持图像或视频理解 |
| 官方 NVFP4 SWE-Bench Verified | 69.7 | 可作为编程 Agent 评测的参考 |
| 官方 NVFP4 RULER 1M | 94.0 | 支持超长上下文场景 |
| OpenRouter 免费价格 | $0 输入,$0 输出 | 适合试用,不代表 SLA |
| OpenRouter 免费线路可用性快照 | 三天内成功率 84.07% | 能连通不等于始终可用 |
| 官方自托管最低配置 | 4x B200 级别或 8x H100 | 不是普通工作站能承担的部署 |
上表中的基准数据来自 NVIDIA 模型卡,应视为厂商一方的测试结果。OpenRouter 的可用性是动态供应商指标,并不是永久保证。
五分钟调用免费的 Nemotron 3 Ultra API
最快的免费方案是通过 OpenRouter 的 OpenAI 兼容 chat-completions 接口调用,模型 ID 必须使用 nvidia/nemotron-3-ultra-550b-a55b:free。先创建 OpenRouter 密钥并放入环境变量,再用一个小请求进行测试,不要一上来就提交超长上下文任务。
- 在 OpenRouter 中创建 API key。
- 将它导出为
OPENROUTER_API_KEY。 - 使用免费模型 ID 调用
/api/v1/chat/completions。 - 评测时记录 HTTP 状态码、延迟和空响应。
- 正式上线前,加入付费线路或其他模型作为备用。
curl https://openrouter.ai/api/v1/chat/completions \
  -H "Authorization: Bearer $OPENROUTER_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nvidia/nemotron-3-ultra-550b-a55b:free",
    "messages": [
      {
        "role": "user",
        "content": "Return three risks in this migration plan as a numbered list."
      }
    ],
    "max_tokens": 500
  }'
使用 OpenAI Python 客户端时也可以走同一线路,只需修改 base_url 和 model:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["OPENROUTER_API_KEY"],
    base_url="https://openrouter.ai/api/v1",
)

response = client.chat.completions.create(
    model="nvidia/nemotron-3-ultra-550b-a55b:free",
    messages=[
        {
            "role": "user",
            "content": "Inspect this plan and list the three highest-impact risks.",
        }
    ],
    max_tokens=500,
)

print(response.choices[0].message.content)
免费线路到底能保证什么
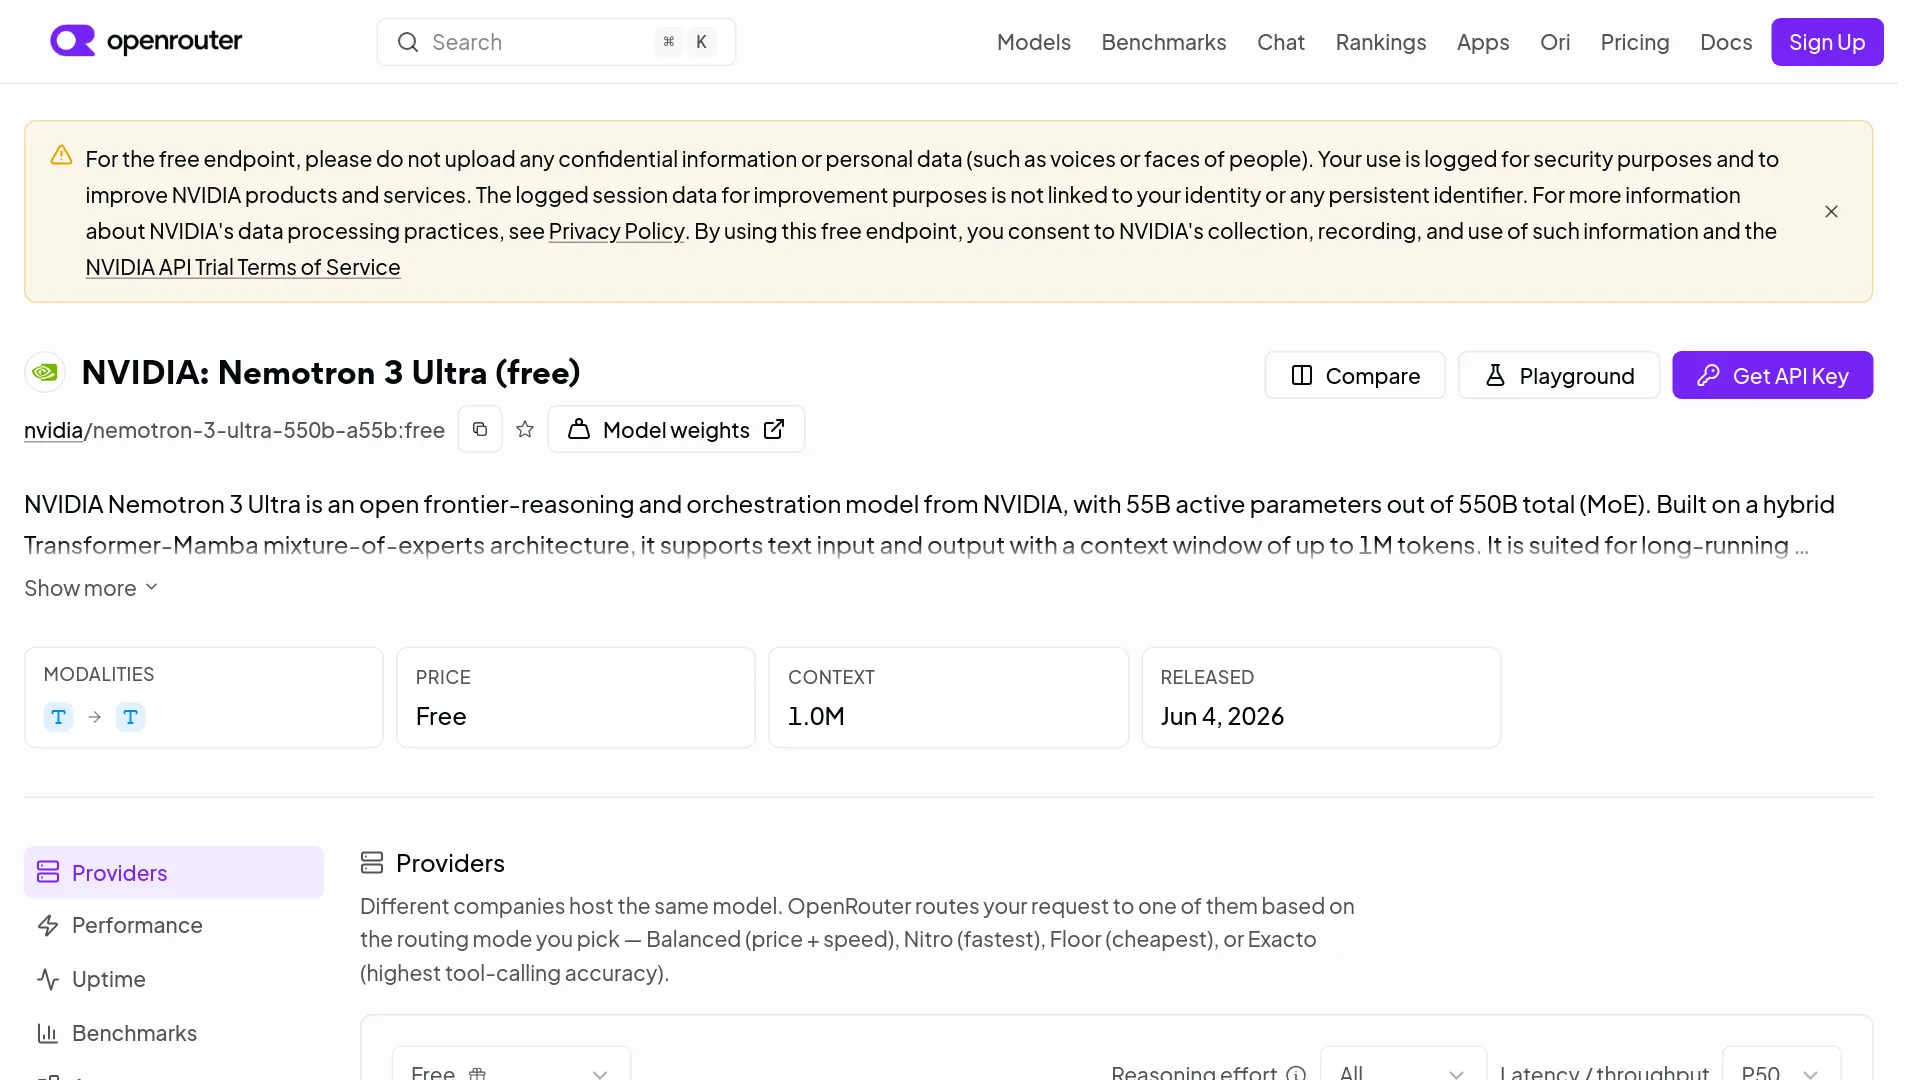
免费的 Nemotron 3 Ultra 线路既不保证无限容量,也不保证生产环境可用。OpenRouter 条目将免费接口标注为限流,但没有在模型页面公布明确配额;其 9 月 19 日的快照显示,三天内可达率为 100%,但成功可用率只有 84.07%,错误和空响应都会被计为失败。
在这份快照中,OpenRouter 展示了 1M token 上下文、65,536 token 最大输出、工具调用、2.28 秒中位延迟,以及每秒 29 token 的中位吞吐量。
此外,不同供应商之间还存在功能边界。OpenRouter 免费线路支持 tools 和 tool_choice,但不会强制执行 response_format。Segmind 的付费线路则以每百万输入 token $0.625、每百万输出 token $2.75的价格提供 JSON Schema 输出。凡是依赖严格 JSON 的代码,都应该针对实际使用的供应商进行测试,不能仅根据基础模型推断功能支持情况。
不要通过 OpenRouter 免费线路发送机密数据或个人数据。该线路说明会出于安全目的记录使用情况,并可能用于改进 NVIDIA 产品和服务。遇到 429、超时或空响应时,应采用有上限的指数退避,然后切换到付费线路;不要让 Agent 操作无限重试。
550B-A55B 架构在实际使用中意味着什么
550B-A55B 表示 Nemotron 3 Ultra 总共包含 5500 亿参数,但每个 token 大约只激活 550 亿参数。NVIDIA 将 LatentMoE 路由、Mamba-2、部分注意力层和 Multi-Token Prediction 结合在了一起。稀疏激活可以降低每个 token 的计算量,但完整权重仍然需要存储、分发或卸载;A55B 并不意味着它就是一个 55B 规模的部署。
NVIDIA 的研究发布页面给出了最高 1M token 的上下文长度,并在一个比较特殊的工作负载上测试吞吐量:输入 8,000 token,输出 64,000 token。NVIDIA 声称,其吞吐量是 GLM-5.1-754B-A40B 的 5.9 倍、Kimi-K2.6-1T-A32B 的 4.8 倍、Qwen-3.5-397B-17B 的 1.6 倍。但页面没有给出绝对吞吐量和硬件细节,因此不能把这些倍数直接换算成 API 延迟预期。
对于部署选择,官方的 BF16/NVFP4 对比表更有参考价值:
| 基准测试 | BF16 | NVFP4 | 实际解读 |
|---|---|---|---|
| SWE-Bench Verified | 71.9 | 69.7 | 在这项编程测试中,量化带来 2.2 分下降 |
| Terminal Bench 2.1 | 56.4 | 53.9 | Agent 式终端任务同样有所下降 |
| TauBench V3 平均值 | 70.9 | 70.3 | 工具调用平均成绩基本接近 |
| GPQA,无工具 | 87.0 | 87.9 | NVFP4 并非在所有任务上都更弱 |
| RULER 1M | 94.7 | 94.0 | 超长上下文检索能力仍然接近 |
| OmniScience 非幻觉率 | 78.7 | 75.5 | 仍需重视事实准确性检查 |
不同任务的变化并不一致:NVFP4 在非幻觉率上下降 3.2 分,但在 GPQA 上提高了 0.9 分。
按任务选择,不要只看参数量
Nemotron 3 Ultra 应该和 DeepSeek V4、GLM 5.2、Qwen 3.8 Max 在实际要上线的工作负载上比较,而不是单纯比模型大小。本指南没有收集到足以证明某个模型全面胜出的同一测试框架结果,因此更稳妥的做法是先制定测试方案,并验证各条线路的实际边界。
| 任务 | 优先开始测试 | 选择前需要验证的证据与指标 |
|---|---|---|
| 百万 token 检索或文档综合 | Nemotron 3 Ultra | 官方 NVFP4 RULER 1M 得分为 94.0;应在真实提示词长度下测试检索准确率和预填充延迟 |
| 长时间运行的编程 Agent | Nemotron 3 Ultra 或 DeepSeek V4 | Nemotron 在 SWE-Bench Verified 上得分 69.7,在 Terminal Bench 2.1 上得分 53.9;应在同一测试框架中比较代码仓库任务成功率和工具调用有效性 |
| 结构化输出自动化 | GLM 5.2、Qwen 3.8 Max,或支持 Schema 的 Nemotron 供应商 | OpenRouter 免费线路不会强制执行 response_format;应在实际线路上测量 Schema 遵循率和重试次数 |
| 高并发短请求 | DeepSeek V4、GLM 5.2 或 Qwen 3.8 Max | 比较每个成功任务的成本和 p95 延迟;Ultra 的规模并不会自动带来优势 |
| 使用 NVIDIA 硬件部署开放权重模型 | Nemotron 3 Ultra | 在目标任务上比较 BF16 和 NVFP4,然后计算持续利用率 |
DeepSeek V4 和 GLM 5.2 在 AIReiter 上都有专门的 API,Qwen 3.8 Max 则以托管聊天模型形式提供:DeepSeek V4 Pro API 指南、GLM 5.2 API 评测和Qwen 3.8 Max API 价格。这些是用于评估的替代方案,并不意味着某个模型在所有任务上都更强。
Nemotron 3 Ultra 能在本地运行吗?
Nemotron 3 Ultra 可以自托管,但这里的“本地”指的是数据中心硬件或 DGX Station,而不是笔记本电脑。NVIDIA 列出的常规部署最低配置包括 4x GB200、4x B200、4x GB300、4x B300 或 8x H100。
NVIDIA 模型卡中的官方 vLLM 示例使用了 4 路张量并行和专家并行、FP8 KV cache、分块预填充以及 MTP 投机解码。标准示例默认使用 262,144 token;要启用 1,048,576 token,必须显式覆盖配置。因此,宣传中的上下文长度并不是默认的服务配置。
NVIDIA 还记录了一种特殊的单台 DGX Station 部署方式。它在一块集成式 GB300 GPU 上运行 NVFP4 检查点,通过提供最高 150 GiB 的统一 CPU 内存来卸载专家权重。该方案要求 vLLM 0.22.0、Blackwell 专用 NVFP4 后端,以及 DGX Station 的内存架构,不能直接套用到普通单 GPU 电脑上。
| 部署方式 | 适合在什么情况下选择 | 主要限制 |
|---|---|---|
| OpenRouter 免费 API | 评估提示词和工具行为 | 限流、日志记录和可用性波动 |
| 付费托管 API | 在使用量足以支撑硬件之前先上线 | 供应商价格、精度、上下文和功能差异 |
| 4x B200 级别 / 8x H100 自托管 | 需要稳定吞吐、数据控制或模型定制 | 资本成本和分布式推理运维 |
| 单台 GB300 DGX Station 加卸载 | 你拥有这类统一内存系统 | 卸载延迟和硬件专属性 |
Nemotron 3 Ultra API 常见问题
Nemotron 3 Ultra API 是免费的吗?
是的。OpenRouter 将 nvidia/nemotron-3-ultra-550b-a55b:free 的输入和输出 token 价格都列为 $0,但该接口有限流,并且会记录使用情况。
Nemotron 3 Ultra 真的支持一百万 token 吗?
NVIDIA 规定的最大上下文为 1M token,但不同供应商线路可能提供更低的默认值;NVIDIA 的 vLLM 示例默认使用 262,144 token,除非运营方主动启用 1,048,576。
API 支持工具和结构化 JSON 吗?
模型支持工具调用,但具体执行方式取决于供应商:OpenRouter 免费线路不强制执行 response_format,而 Segmind 则记录了对严格 JSON Schema 的支持。
我可以将 Nemotron 3 Ultra 用于商业用途吗?
NVIDIA 表示,OpenMDW 1.1 许可证允许商业和非商业使用。如需了解再分发和部署义务,请查看官方模型卡中链接的许可证条款。
可以关闭推理吗?
NVIDIA API 文档提供了 enable_thinking=True/False。托管供应商可能以不同方式映射这一控制项,因此需要在选定线路上确认可接受的参数和 token 计费方式。
550B A55B 等同于一个稠密 55B 模型吗?
不等同。每个 token 大约只激活 55B 参数,但全部 550B 参数仍然需要被存储、分发或卸载。
这是一项部署决策,不是一场基准赛夺冠
最稳妥的第一步,是使用免费的 Nemotron 3 Ultra API,配合非敏感提示词和一小组评测任务。等失败率、Schema 强制执行能力或容量可预测性成为关键问题后,再切换到付费接口;只有当实际利用率、隐私要求或定制需求足以证明至少四块当前高显存 GPU,或足以支撑文档中的 DGX Station 方案时,才值得自托管。
| 测试后的结果 | 下一步行动 |
|---|---|
| 效果不错,但免费调用经常失败或排队 | 增加付费 Nemotron 线路和重试策略 |
| 超长上下文检索是主要优势 | 测试最大的真实文档,并测量预填充时间 |
| 主要问题是 JSON 输出失败 | 改用支持 Schema 强制执行的供应商,或比较 GLM/Qwen 线路 |
| 短任务成本或延迟更重要 | 优先选择更小的模型,将 Ultra 留给升级处理的任务 |
| 数据不能离开你的网络 | 在确定方案前,先为官方多 GPU 部署做好预算 |