 AIREITER
GLM-5.2 的各条接入路线都能接收 OpenAI 风格的请求,但请求进入服务端后,实际表现几乎没有哪两条路线完全一致。自 6 月 16 日发布以来,GLM-5.2 API 对成本敏感的编程和 Agent 工作流颇有吸引力,前提是你得自己补上三层防护:工具调用语义、重试风暴,以及缓存计费核算。标价确实是每百万 token 输入 $1.40、输出 $4.40;但一个任务最终会花掉多少钱,往往是另一回事。本评测关注的正是两者之间的差距。
OpenAI 兼容到底兼容了什么
官方 GLM-5.2 文档明确支持 OpenAI Python SDK:将 base URL 指向 https://api.z.ai/api/paas/v4/,模型 ID 设为 glm-5.2,基础聊天接入确实只需改几行代码。不过,它兼容的是请求格式,并不意味着响应语义、OpenAI 的可选控制字段,以及较新的 Responses API 也都兼容。
| 文档声明 | 参数 |
|---|---|
| 模态 | 文本输入、文本输出(不支持视觉) |
| 上下文窗口 | 1M tokens |
| 最大输出 | 128K tokens |
| 文档列出的能力 | 思考模式、流式输出、函数调用、上下文缓存、结构化输出、MCP |
| 按量计费端点 | https://api.z.ai/api/paas/v4/ |
| Coding Plan 端点 | https://api.z.ai/api/coding/paas/v4 |
| Anthropic 兼容端点 | https://api.z.ai/api/anthropic |
| 官方 SDK | zai-sdk(Python)、Java、OpenAI SDK |
第一个边界是,Z.ai 根本没有 Responses API。正如 u/quinncom 所说:“Codex 只支持 Responses API 格式,而 Z.ai 没有提供它。”因此也有人通过 ZenMux 这类转换层接入。第二个边界在 Claude Code:它可以走 Anthropic 兼容端点,但 @armor_rust 的配置说明指出了两个坑:应使用 AUTH_TOKEN 而不是 API_KEY;后者会触发信任确认,一旦拒绝,可能永久无法继续使用。此外,订阅制和按量付费的 base URL 也不同。完整步骤可参见我们的 Claude Code 配置指南。
一位开发者的总结很准确:“API 兼容性止步于请求格式;工具调用仍然需要针对不同供应商单独评估。”——@sebuzdugan。
工具调用:短链路没问题,长循环可能失控
在短小、可控的工具调用循环中,GLM-5.2 API 的表现符合文档承诺;但到了长时间运行的 Agent 循环,重度用户反馈出现过损坏的调用序列,模型会不断绕圈,直到你在客户端设置的上限将其拦住。这两种结论并不矛盾,风险取决于你要构建的是哪类循环。
根据 Z.ai 文档以及 GLM52.ai 的 27 请求 Docker 测试套件:最多可定义 128 个函数;函数名最长 64 个字符,且需匹配 ^[a-zA-Z0-9_-]+$;参数使用 JSON Schema;模型返回的 arguments 是 JSON 字符串,应用侧必须自行校验;文档只明确支持 tool_choice: "auto"。该套件在 Coding Plan 路线上 27/27 通过:4/4 工具与参数完全匹配,3/3 正确地未调用工具,4/4 在两个顶层调用中完成两笔订单,延迟中位数为 5.3 秒。
真正容易踩坑的是 OpenAI 用户习以为常的控制字段。GLM52.ai 发送冲突测试后,端点虽然返回 HTTP 200,却直接忽略了相关指令:
| 发送的 OpenAI 风格控制项 | 观察到的行为 |
|---|---|
tool_choice: "required" + “不要使用任何工具” | 停止,不产生调用 |
| 强制指定函数对象 + “绝不要使用这个工具” | 停止,不产生调用 |
parallel_tool_calls: false + 双订单提示 | 仍然返回两个调用 |
strict: true | 有一次被接受;没有证据表明执行了 Schema 强校验 |
HTTP 接收请求不等于行为有保障,而长循环正是这些接口缝隙最容易暴露的场景。
一位累计向该模型输入约 40 亿 token 的开发者说得很直接:“用到 40 亿 token 后,GLM 5.2 最大的问题是缺少视觉能力、工具调用混乱,以及工具调用损坏后直接死亡螺旋。”——@RasputinKaiser。此外,Reddit 上还有一则尚未获回复的报告,称模型把第二个工具调用编码进第一个调用的 arguments 中。这只是单一案例,但恰好属于客户端循环应当防御的故障类型。
实践中更可靠的做法,是不要让模型负责调度。一位开发者通过 NVIDIA NIM 配置 tool_call: false,将整个循环交给 Agent 框架控制;其受限参考循环将模型步骤限制在四次,每回合最多执行四次调用,并在执行前校验每一份 arguments JSON。
流式输出与延迟:宣传页不会告诉你的数据
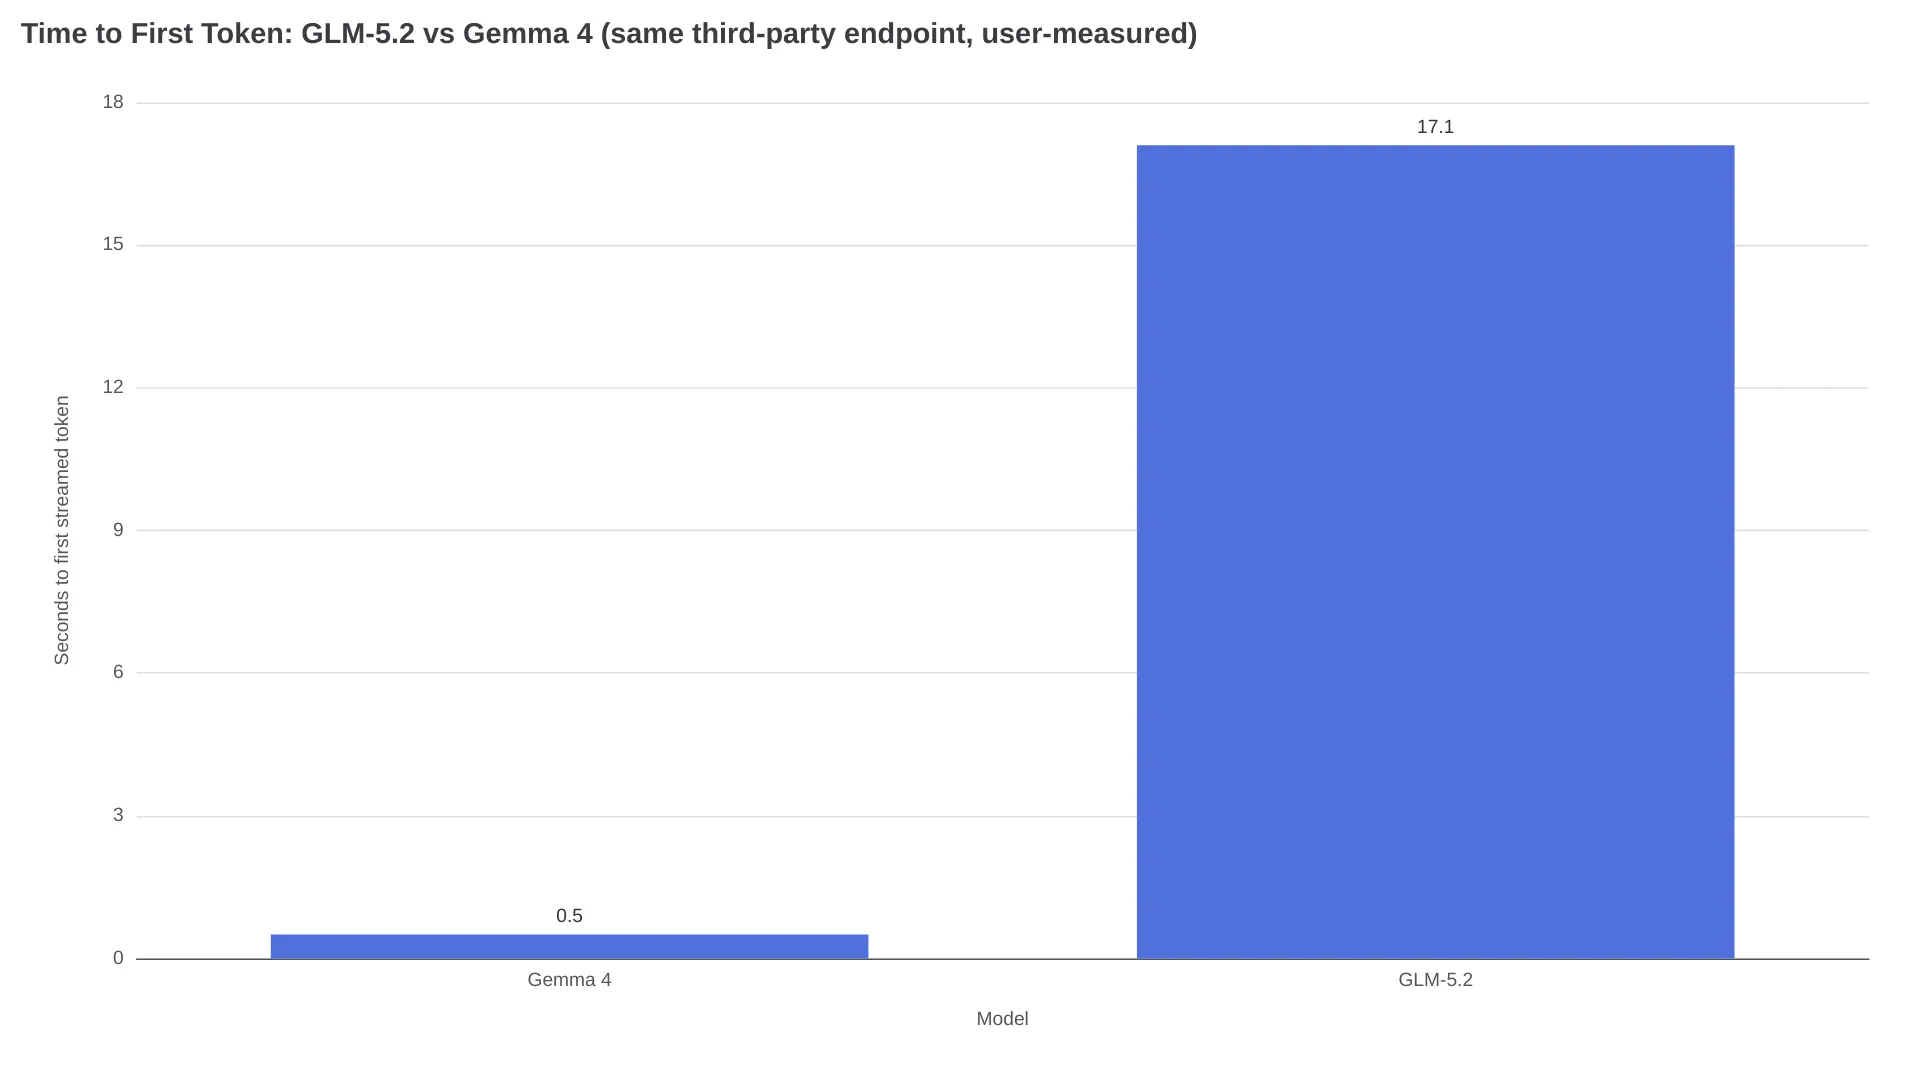
首 token 延迟是这套 API 目前测得最弱的一项指标。在 Sarvam 上进行的一次同端点对比中,GLM-5.2 的流式速度为 148 tokens/s,Gemma 4 为 260 tokens/s;GLM-5.2 的首 token 时间为 17.1 秒,Gemma 4 则是 0.5 秒。换句话说,Gemma 4“开始生成的速度快了 33 倍”。——@noctus91。
宣传中的吞吐量也有类似问题:
“这些 GLM 5.2 供应商都宣传 200+ tok/s,实际一用却只有 50 tok/s。”——@tomgreenwald,他将这种现象称为“供应商版 benchmaxxing”。
订阅路线还出现过另外两种故障形态:流在会话中途断掉,“流式输出就这样……停了”,一名 GLM Pro Coding Plan 用户随后彻底放弃使用;另一个问题则是上下文规模带来的性能衰减:“上下文达到 300k+ 后模型会变慢。”——@mosh_Ontong。作为对照,DataLLM Lab 在自家网关上执行的九任务基准中,平均每个任务完成时间为 12.3 秒。你的延迟表现,很大程度由端点决定,而不只是模型本身。
限流与 429:重试不是例外,而是日常
Z.ai 的模型文档没有公布限流表,因此开发者只能通过 429 实测自己的配额。在 Coding Plan 路线上,社区普遍认为重试属于正常运行状态,而不是异常分支。以下讨论无法说明故障发生频率,但反复出现的故障模式颇为一致。
摘自 r/ZaiGLM 的限流讨论帖:
- “现在 Coding Max Plan 几乎每隔一次请求就遇到 429/529,没有并发……”——u/A-B-user
- “是的,几乎每个请求都会重试,但结果非常好。”——u/hyeluoh
- “GLM52 设成单并发就能正常工作,虽然超级慢,但不会报错。”——u/evia89
错误还会因客户端而异:同一个 API key 在 ZCode 中可用,在 OpenClaw 中却会报 429;另一位用户将其概括为“太忙了”。订阅层的问题更复杂:中国用户报告 Coding Plan 会自动把 5.2 工作负载切换到 GLM-5.3,后者消耗配额更快;还有人反映第三方 Coding Plan 转售商在少量调用后就开始限流。
经得起实战检验的工程方案包括:带抖动的指数退避、对所有写操作使用幂等键、按任务而非按请求设定重试预算,以及可自动切换的 concurrency=1 降级模式。我们的 OpenRouter 429 修复指南中的重试策略可以原样用于这里。
Z.ai 尚未回应的缓存计费问题
文档确实支持上下文缓存;我们在7 月 13 日查看供应商页面时,缓存输入价格约为每百万 token $0.26,而新输入为 $1.40。尚未解决的争议,也是我们查看的社区讨论中互动最多的一项 API 投诉:部分路线上,重复上下文似乎仍按新输入计费。这会让每轮都重发长系统提示词的 Agent 循环成本成倍增加。
“GLM 5.2 的缓存 token 似乎没有正常工作。重复上下文被当成普通输入,而不是缓存 token 计费。”——@Da7_Tech,他称这为“严重的计费/缓存核算问题”。
在该讨论中,同一个任务由 Claude Opus 4.8 在不足 1.5M token 内完成;GLM-5.2 则在消耗 53M token 后仍未完成,五小时配额已经达到 100%,而应用自身的计数器仅显示约 1.67M。
两个月后,同一位开发者仍在总结:“很多用户抱怨缓存命中似乎也计入使用量。如果你遇到这种情况,这个套餐就毫无性价比可言。”截至 8 月下旬,相关讨论中未见官方回应。
在确认该问题已经修复前,应将缓存输入价格视为需要自行验证的最佳情况:记录每次响应 usage 对象中的 cached_tokens,并按周与账单核对。
推理强度:同一个开关,三套叫法
官方接口使用 thinking.type 控制启用或禁用思考,并通过 reasoning_effort 设置 high 或 max。官方示例本身就使用 reasoning_effort: "max"。Z.ai 的发布说明称,max 追求能力上限,high 则在性能与 token 效率之间平衡;代码任务推荐使用 max。
集成时有两个关键事实。第一,编程路线默认启用 max:“默认就是 max,除非你想调低,否则无需设置。”——r/ZaiGLM。推理 token 按输出价格计费,因此默认设置会悄然放大开销。对于 Coding Plan,记录过套餐计费规则的用户表示,在北京时间工作日 14:00–18:00,max 强度调用会消耗 3 倍配额;这一规则又叠加在五小时窗口和每周额度之上。
第二,这个设置经常根本传不到后端。OpenCode 用户称,自定义供应商“目前无法调整 reasoning effort”;部分客户端还将同一个设置命名为 xhigh,并且可能完全不会向后端透传。——r/opencodeCLI。输出冗长度也与该开关相关:一位每日进行对比的开发者提到,某竞品模型“没有 Opus-4.8 或 GLM-5.2 那么啰嗦”。
同一个 glm-5.2,不同端点可能像不同模型
glm-5.2 只是一个模型字符串,却可能指向差异显著的部署。当端点准确率测试结果在 8 月初流传时,Z.ai 的负责人请社区“将官方 GLM-5.2 API 也作为额外参考进行测试,它的得分可能超过 100%”。——@ZixuanLi_。他特意点名的是官方 API,而不是报告此前测试的第三方端点。
端点漂移在实战中的表现包括:输出 token 上限设置过低,导致推理在流中途被截断;发布初期的吞吐量随后衰减,也就是前文提到的“benchmaxxing”;以及不同主机的上下文上限不同。比如,Together AI 提供的 GLM-5.2 上下文为 256K,而官方 API 按文档为 1M,我们在 7 月对比过的聚合平台也提供完整窗口。
价格差距比行为差距更大:相较于 Z.ai 的 $1.40/$4.40 标价,我们在 7 月供应商对比中看到 OpenRouter 标为 $0.42/$1.32;缓存输入价格则从 Fireworks 的 $0.14 到 $0.26 不等。应先根据工作负载选择端点,再在该精确端点上重新测试。一个路线通过了行为测试,不代表结果可以迁移到另一条路线。
正式上线前,花 30 分钟做完这套检查
上述每一种故障模式,都能在投入生产工作负载之前的半小时内发现。请针对你实际要上线的端点、模型字符串和 SDK 执行以下测试:
- 测试工具控制冲突。发送
tool_choice: "required",同时要求模型不要使用工具;再发送parallel_tool_calls: false和双订单提示。预期两项控制都会被忽略。若你的编排依赖其中任一项,到此为止。 - 进行重试压测。以目标并发发送 50 个请求,记录 429/529 比例和重试成功率。如果重试请求超过总请求约三分之一——这是一个保守的运维阈值——就将并发降至 1 后重新测量。
- 核对缓存计费。连续五次重发完全相同的 10K-token 前缀;汇总 usage 响应中的
cached_tokens,再与控制台按输入计费的数值核对。若二者不一致,你的成本模型就不成立。 - 在真实上下文规模下测试延迟。测量具有代表性的上下文长度下的首 token 时间和流中断顿,而不是只做 1K-token 冒烟测试;否则看不到 >300K 时的变慢问题。
- 选择正确路线。Coding Plan 面向交互式编程工具;套餐计费说明显示,它不允许用于网站、机器人或 SaaS 流量。因此,产品后端应使用按量计费 API。
这里有一项无法消除的取舍:GLM-5.2 提供了市场上最便宜的一批高能力代码 token,而你付出的代价,是自己编写一层封装工程;前沿 API 通常会把这些成本直接折算进每 token 的价格里。
GLM-5.2 API 常见问题
GLM-5.2 可以使用 OpenAI SDK 吗?
可以,用于 chat completions。将 base_url 指向 https://api.z.ai/api/paas/v4/,模型设为 glm-5.2 即可。Z.ai 没有 Responses API,因此 OpenAI 较新的接口层以及 Codex 都需要转换层。
GLM-5.2 API 支持流式输出、函数调用和结构化输出吗?
三者都属于文档声明的能力,此外还包括上下文缓存和 MCP。但实际使用有行为层面的限制:流式稳定性因端点而异,而 OpenAI 的工具控制字段——除 auto 外的 tool_choice、parallel_tool_calls 和 strict——不会被遵守。
应该使用什么模型字符串和 base URL?
官方按量计费路线使用 glm-5.2,地址为 https://api.z.ai/api/paas/v4/。Coding Plan 使用不同的 base URL,而 OpenRouter 中的模型名为 z-ai/glm-5.2。
为什么 GLM-5.2 很慢,或者输出特别冗长?
编程路线默认使用 max 推理强度,而推理内容按输出 token 计费。社区反馈显示,持续吞吐量更接近 50 tok/s,而非宣传的 200+。在将问题归咎于模型能力前,延迟和冗长度通常首先是配置与端点造成的结果。
GLM Coding Plan 能为我的应用提供 API 服务吗?
不能。套餐计费说明显示,该订阅仅限交互式编程工具,不包括为网站、机器人或 SaaS 产品提供服务。北京高峰时段的配额倍增规则也不适合稳定流量。
每个供应商都提供 1M 上下文窗口吗?
不是。官方 API 和多数聚合平台提供 1M,但 Together AI 将 GLM-5.2 限制为 256K;这足以改变仓库级工作流的架构设计。
延伸阅读
- GLM-5.2 Review: Two Months After the Hype —— 模型质量、基准测试及适用人群
- GLM 5.2 API: Cheapest Access, Pricing & Free Keys —— 完整供应商价格矩阵
- GLM-5.2 vs GLM-5.3 —— 8 月推出的后继版本是否改变了选择逻辑