 AIREITER
Muse Spark 1.2 值不值得用:先说结论
Meta 于 2026 年 8 月 5 日推出 Muse Spark 1.2,并同步发布了为它打造、目前仍处于 beta 阶段的终端编程代理 Muse Code。相较 1.1,它在代码基准上确实有所进步;但在三项编程评测中,Claude Opus 5 依然全部领先。这也正是 Muse Spark 1.2 的核心矛盾:升级并非虚张声势,Meta 增加了编程训练算力,并让模型与 Muse Code agent 联合训练,成绩也随之上涨;不过,版本间的提升有一部分来自新 harness,而不完全是模型本身。在 Terminal-Bench、DeepSWE 以及 Meta 内部代码评测中,Anthropic 的模型仍领先 4 到 9 分。
不过,价格仍让它很有吸引力。标准价维持在每百万 token $1.25/$4.25,contributor 套餐还能再低约 12 倍。但代价也很明确:默认路径会将你的代码用于 Meta 的模型训练;而且在最高推理强度下,首 token 时间相比此前退化了约 9 倍。若准备把 Muse Spark 1.2 用于生产环境编程,这两点往往比排行榜名次更重要。
从 1.1 到 1.2,Meta 到底改了什么
Muse Spark 1.2 是 Meta 旗下前沿推理模型的一次面向编程的更新,于 8 月 5 日与终端编程代理 Muse Code 一同发布。Meta 将其定义为相对 Muse Spark 1.1 的“适度改进”。这个措辞相当克制,但它瞄准的正是编程 agent 最吃力的场景:跨多文件重构、长时间调试,以及远超单轮提示词长度的任务。
这次提升主要来自两项训练设计。其一,Muse Code 从第一天起就进入了训练闭环。Meta 使用经拒绝采样的 harness 轨迹,让模型与自身 agent 协同训练,使其在 Muse Code 内发挥最佳表现。公司表示训练覆盖了多个 harness,因此模型仍可泛化到其他编程工具。其二,Meta 建立了一套自我改进循环:由 Muse Spark 1.1 生成高难度编程环境和指令遵循模板,再对候选解答进行评分,进而构成 1.2 的训练数据集。Meta 认为,这一循环让 1.2 在执行复杂指令时有了可衡量的提升。
这次更新直指 Muse 系列此前最弱的一环。Muse Spark 在 2026 年 4 月首次发布时,agentic coding 表现落后:SWE-Bench Verified 得分为 77.4,Claude Opus 4.6 则为 80.8。如今,面向编程的专用 checkpoint 加上专门设计的 harness,就是对此的直接回应,同时也保持了通用 agentic 能力。
怎么看基准成绩,才不会被数字误导
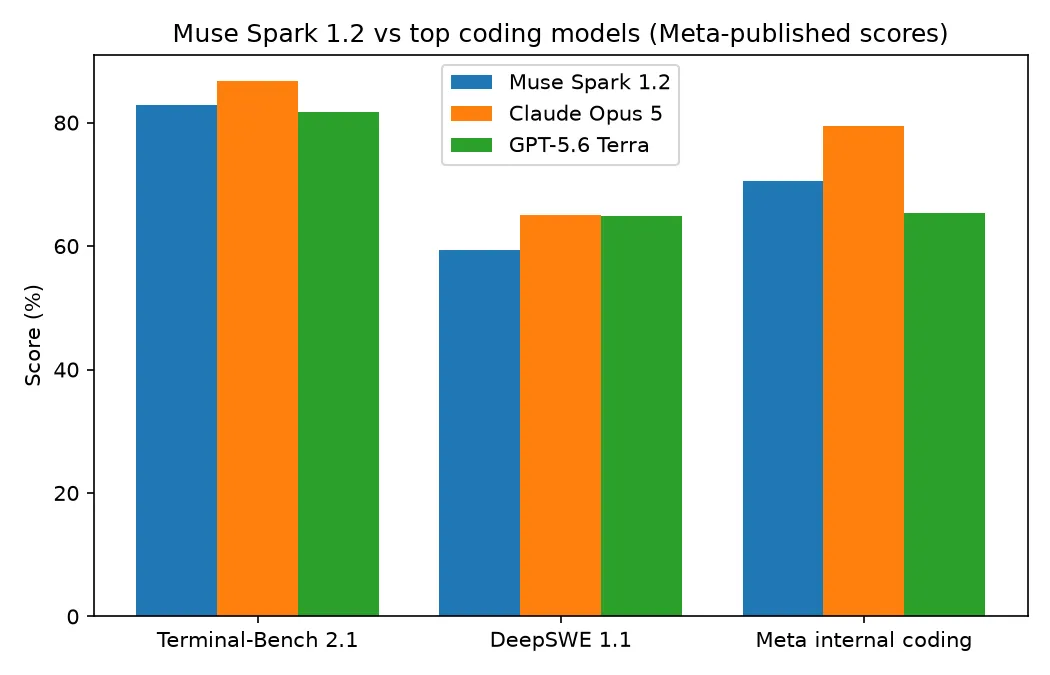
在 Terminal-Bench 2.1 上,运行于 Muse Code 中的 Muse Spark 1.2 得分 82.9%,略高于 Codex 中的 GPT-5.6 Terra(81.8%)和 Grok Build 中的 Grok 4.5(81.6%),但仍落后于 Claude Code 中以最高 effort 运行、得分 86.7% 的 Claude Opus 5。DeepSWE 1.1 上,它取得 59.3%,排名第三,低于 Opus 5 的 65.0% 和 GPT-5.6 Terra 的 64.8%。Meta 自己的内部代码评测最能说明差距:Muse Spark 1.2 的 70.6% 超过 GPT-5.6 Terra 的 65.4% 与 Gemini 3.6 Flash 的 63.9%,但仍比 Opus 5 的 79.4% 低近 9 分。三张图表的榜首,都是 Claude。
代际提升是真实存在的:相比 1.1,Muse Spark 1.2 在 Terminal-Bench 上提高 6.7 分,在 DeepSWE 上提高 6.3 分。但比较版本时,图表标签中有一个细节不能忽略。1.1 的成绩来自通用 mini-swe-agent harness,1.2 则运行在 Muse Code 中。因此,这部分涨幅应归功于新 harness,而不只是新模型。按 Artificial Analysis 的综合 Intelligence Index,1.2 得分为 54,在 186 个模型中排名第 14,而该类别中位数是 32;1.1 为 51。相比编程图表,这个增长显得更平缓。
与 Claude 和 GPT 的正面比较,正是潜在用户最常问的问题。在 1.2 的数据公布前,一位开发者在 Reddit 上直白地问道:
“有人用过 Meta 的 MUSE Spark 1.1 吗?我想知道它在推理、编程、速度、准确性和上下文处理上,与 Claude 和 GPT 相比表现如何。”
1.2 的基准结果首次为这个问题给出了较严格的答案:它具备竞争力,在编程上明确居于第二梯队,并且在大多数图表上领先 GPT-5.6 和 Gemini 选项。
生产环境绕不开的两个问题
决定 Muse Spark 1.2 能否融入实际工作流的,是两个排行榜上看不出来的细节。
xhigh 推理强度下,延迟明显恶化
Muse Spark 是推理模型,回答前会先进行思考,而且这一过程无法关闭。它通过 /effort 提供从 minimal 到 xhigh 的五档设置,思考 token 也会按输出 token 计费。最高档的代价不止体现在账单上。OrcaRouter 发布的独立测量显示,在 xhigh 下,首 token 时间从 1.1 的 2.90 秒升至 26.12 秒,约为原来的 9 倍;输出速度则从每秒 213.5 token 降至 165.0 token。运行 Artificial Analysis Intelligence Index 评测时,1.2 的成本为 $637.85,比 1.1 的 $548.07 高出 16%,原因完全在于模型思考得更多。对于开发者正在等待回复的交互式编程场景,最高推理强度往往是在用难以接受的延迟交换准确率。
contributor 套餐:用代码数据换低价
Meta 为 Muse Spark 1.2 提供两档价格,而它引导新用户使用的那一档附带条件。contributor 套餐的每百万 input/output token 价格为 $0.10/$0.20,标准套餐则是 $1.25/$4.25;前者的 input 约便宜 12 倍,output 约便宜 21 倍,缓存 input 更是低至 $0.002。相应交换条件也写得很清楚:你明确授权 Meta 使用你的 prompts 和 completions 训练未来模型。在上面的对比中,它是最便宜的费率;付出的代价是你的数据。
Muse Code 面向新用户的默认接入路径,落在的正是这一套餐。VentureBeat 报道的测试显示,一行安装命令可在 Mac mini 上正常运行,需要下载 97 MB 并登录;但该 agent 随后没有真正执行任务,显示没有可见模型,即便使用折扣套餐也仍要求添加付款方式。低价没错,但它不是免费的。该套餐的速率限制也更紧:每分钟 60 次请求,而标准套餐为 3,000 次。这很明显是面向个人用户和原型开发,而非生产环境。拥有专有代码库的团队,应主动切换到标准定价,或通过 Meta 销售团队申请零数据保留。
放到市场里看:Muse Spark 的价格位置
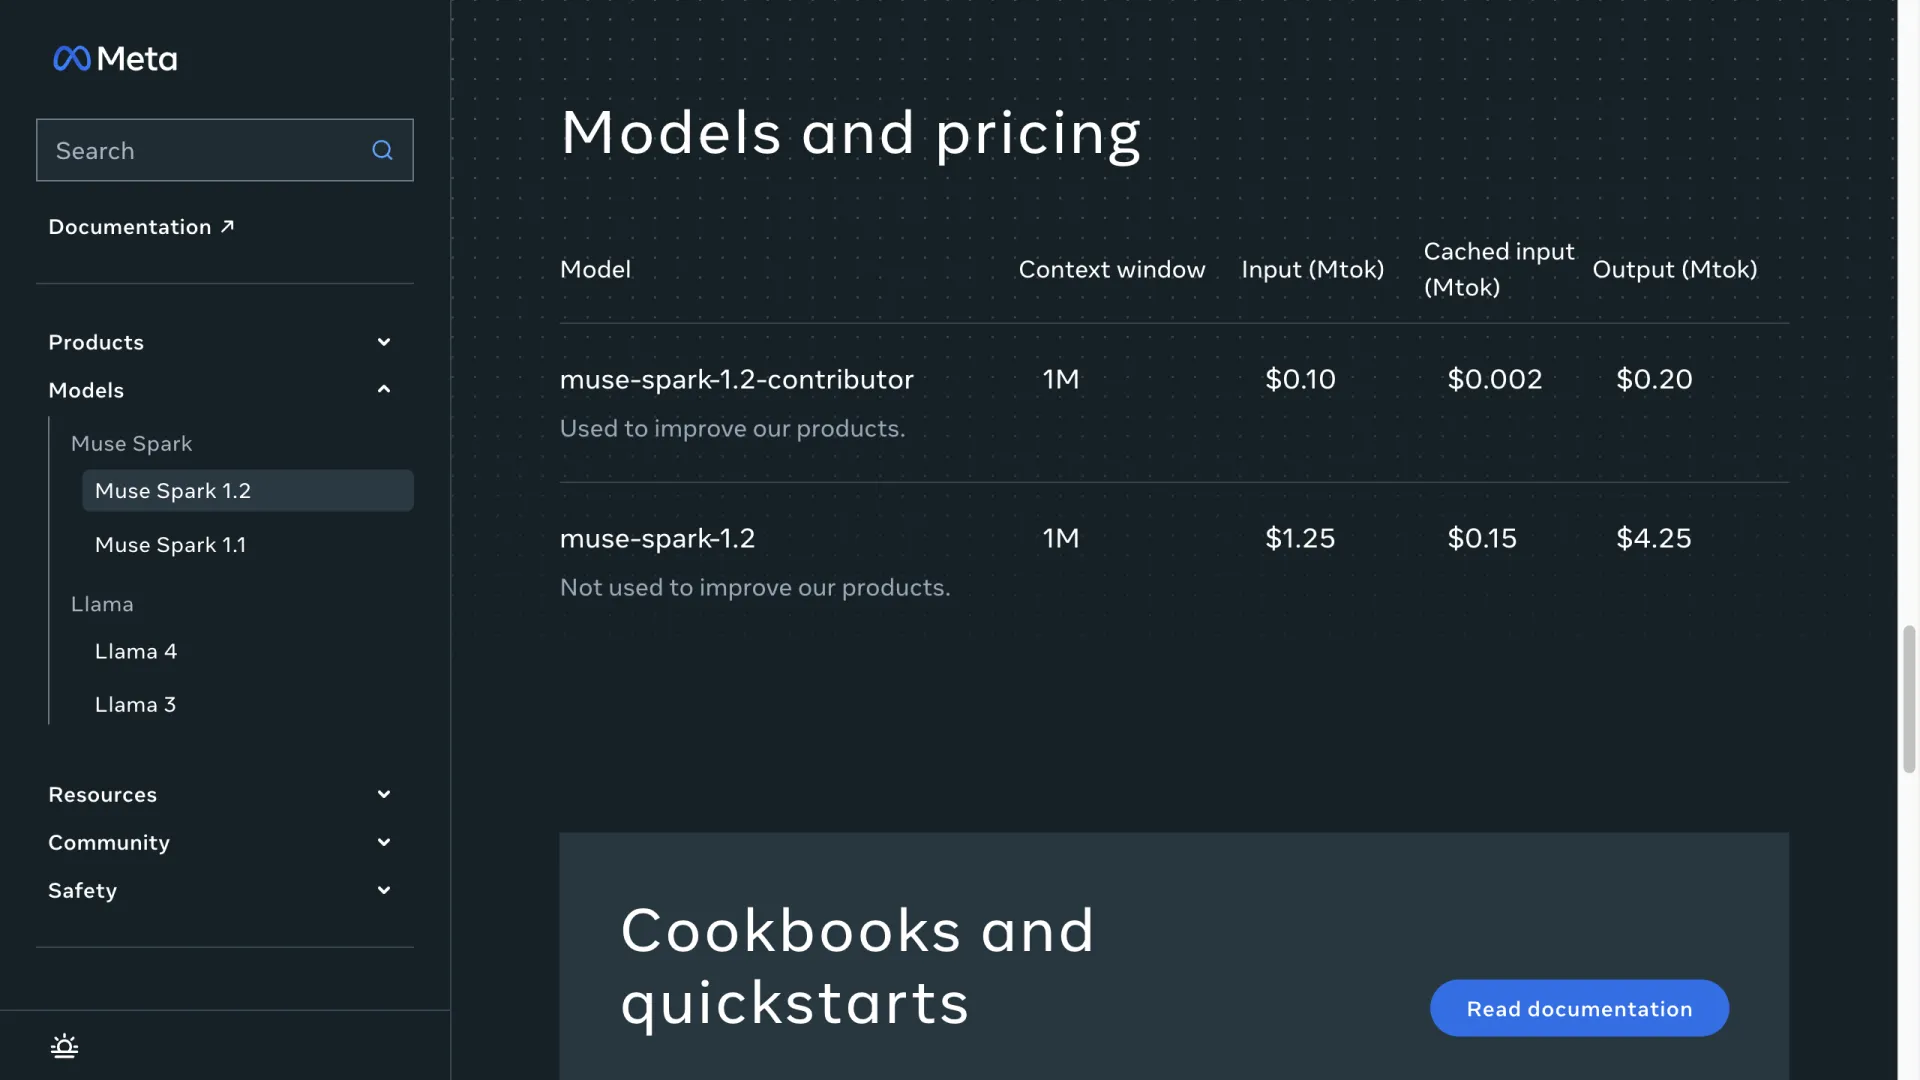
Muse Spark 1.2 的标准套餐为每百万 input $1.25、缓存 $0.15、output $4.25,提供 1M token 上下文窗口,且不收取长上下文溢价。在编程模型市场中,这属于中低价位。相较前沿编程榜首模型,它便宜得很明显:Claude Opus 5 的价格为 $5/$25,GPT-5.5 为 $5/$30,output 价格约高出 4 到 7 倍。它与 Z.ai 的 GLM-5.2 几乎处在同一价位,后者为 $1.40/$4.40;而 Grok 4.5 的 $2/$6 则高一个台阶。至于极低价市场,DeepSeek V4 Pro 的 $0.435/$0.87 多倍低于它,Muse Spark contributor 套餐同样如此。
| 模型 | Input $/M | Output $/M | 缓存 $/M | 上下文 |
|---|---|---|---|---|
| Muse Spark 1.2(标准) | 1.25 | 4.25 | 0.15 | 1M |
| Muse Spark 1.2(contributor)* | 0.10 | 0.20 | 0.002 | 1M |
| Claude Opus 5 | 5.00 | 25.00 | — | — |
| GPT-5.5 | 5.00 | 30.00 | — | — |
| GLM-5.2 | 1.40 | 4.40 | — | — |
| Grok 4.5 | 2.00 | 6.00 | — | — |
| DeepSeek V4 Pro | 0.435 | 0.87 | — | — |
\*contributor 套餐授予 Meta 使用你的数据进行训练的权利;限速为每分钟 60 次请求。
现在哪里能用,以及今天该选什么
Muse Spark 1.2 目前可通过三个渠道使用:Meta Model API、Muse Code 终端 agent 和 OpenRouter。它尚未登陆所有聚合平台——截至 2026 年 8 月 6 日,AIReiter 的目录中还没有它。如果你的技术栈依赖统一 API,又需要立即使用编程模型,只能从目前已接入的平台模型中选择。
目前最接近这一价格档位的选择是 GLM-5.2,价格为 $1.40/$4.40。2026 年 8 月 6 日,我通过平台 API 调用 glm-5.2,运行了一项单轮代码推理任务,想看看“今天就能用”的模型表现如何:一个 Python 取款函数缺少透支检查。GLM-5.2 在 3.2 秒内返回结果,使用了 85 个 prompt token 和 128 个 completion token;它正确识别出缺少余额校验,给出了修复代码(if amount > 0 and account_balance >= amount:),并写出了一个修复前失败、修复后通过的测试。这只是一个任务,不是基准测试;但它证明了在同一价位上,已有能立即调用的可用编程模型。DeepSeek V4 Pro、Kimi K3、Claude Sonnet 5 和 GPT-5.6 系列,则构成 AIReiter 目录中其他已可使用的编程模型选项。
到底该不该选 Muse Spark 1.2?
答案取决于你的优先级,大致可以分成三种情况。
选择 Muse Spark 1.2:如果你需要以较低成本大规模处理编程任务,例如大型跨文件重构、长时间调试或长链路 agentic 任务,并且愿意直接接入 Meta、Muse Code 或 OpenRouter。其 $1.25/$4.25 的价格,提供了接近前沿级别的编程能力;1M 上下文窗口和上下文压缩机制,也适合无法在单个提示词中完成的工作。除非任务能够接受 26 秒首 token 延迟,否则应避免使用 xhigh 推理强度。
选择 Claude Opus 5:如果你需要编程基准上的最高表现。它在 Muse Spark 1.2 参与的三项评测中均居首位。为了这份准确率优势,你需要支付高出 4 到 6 倍的每 token 成本。
选择聚合平台中已接入的模型:如果你今天就要上线,而所在平台尚未提供 Muse Spark。GLM-5.2 无需等待,且价格处于相同档位;若原始成本是首要因素,DeepSeek V4 Pro 还会更便宜。
FAQ
Muse Spark 1.2 的编程能力比 Claude Opus 5 强吗?
不强。Claude Opus 5 在 Meta 公布的三项编程基准——Terminal-Bench 2.1、DeepSWE 1.1 和 Meta 内部代码评测——中均领先,优势为 3.8 到 9 分。Muse Spark 1.2 明确位居第二,并在大多数图表中领先 GPT-5.6 Terra 和 Gemini 3.6 Flash。
Muse Spark 1.2 是开源模型吗?
不是。与 Meta 的 Llama 系列不同,Muse Spark 是专有模型:仅限云端使用,不提供可下载权重,也无法自行部署。Mark Zuckerberg 曾表示,对于可能的开源发布,他“将分享更多消息”;但 1.2 发布时并未提供权重或许可证。