 AIREITER
MuseTalk 可以在一块 4 GB 的笔记本 GPU 上运行:官方 README 记录显示,RTX 3050 Ti Laptop 以 FP16 处理一段 8 秒视频,大约需要 5 分钟。对 MuseTalk 唇形同步来说,真正需要判断的并不是“能不能跑”,而是“跑得够不够快”。这个差距还会进一步体现在输出分辨率、安装过程,以及下面的成本表中。
MuseTalk 会改动视频的哪些部分,又会保留什么
MuseTalk 会重绘现有视频中的嘴部和下半脸,让嘴唇动作匹配输入音频。头部位置、眼睛动作、面部表情、背景和镜头运动都不会重新生成,而是沿用原始视频。它更像是一次局部编辑,而不是完整的数字人生成:你首先得有一段人脸清晰可见的现成视频。
它之所以能做到较快处理,关键在于架构。这个由腾讯音乐 Lyra Lab 发布的项目,会用冻结的 sd-vae-ft-mse VAE 编码蒙版人脸,用冻结的 Whisper-tiny 模型提取音频特征,再通过交叉注意力,将两者融合进一个借用自 Stable Diffusion v1.4 的 UNet。它采用的是单步潜空间修复,而不是反复迭代的去噪循环;作者也正是据此宣称,在 NVIDIA Tesla V100 上可以达到 30 fps 或更高的速度。
1080p 原视频中的 256x256 人脸区域意味着什么
256x256 指的是可编辑的人脸区域,并不是最终输出分辨率。你的 1080p 视频仍会以原始分辨率和帧率输出,只是嘴部附近会先生成一个 256x256 的区域,再将它融合回画面。因此,人脸在画面中占比越小,结果通常越不容易露出破绽。真正的近距离特写中,嘴部的柔化会和周围清晰的人脸形成明显反差。
有两种补救办法,但都要付出代价。去掉 --use_float16 可以改善画质,不过会增加显存需求并延长运行时间。也可以在成片后使用 GFPGAN 或 CodeFormer 人脸修复,让嘴部区域更锐利;代价是多一道处理流程,而且可能会轻微改变人物的外观。
用数据看画质:MuseTalk 赢在哪里,Wav2Lip 又强在哪里
MuseTalk 的优势主要在图像质量,而不是纯粹的同步准确度。在 HDTF 数据集上,MuseTalk 技术报告给出的 FID 为 6.43,优于 DI-Net 的 7.27、VideoRetalking 的 10.93 和 Wav2Lip 的 11.21。
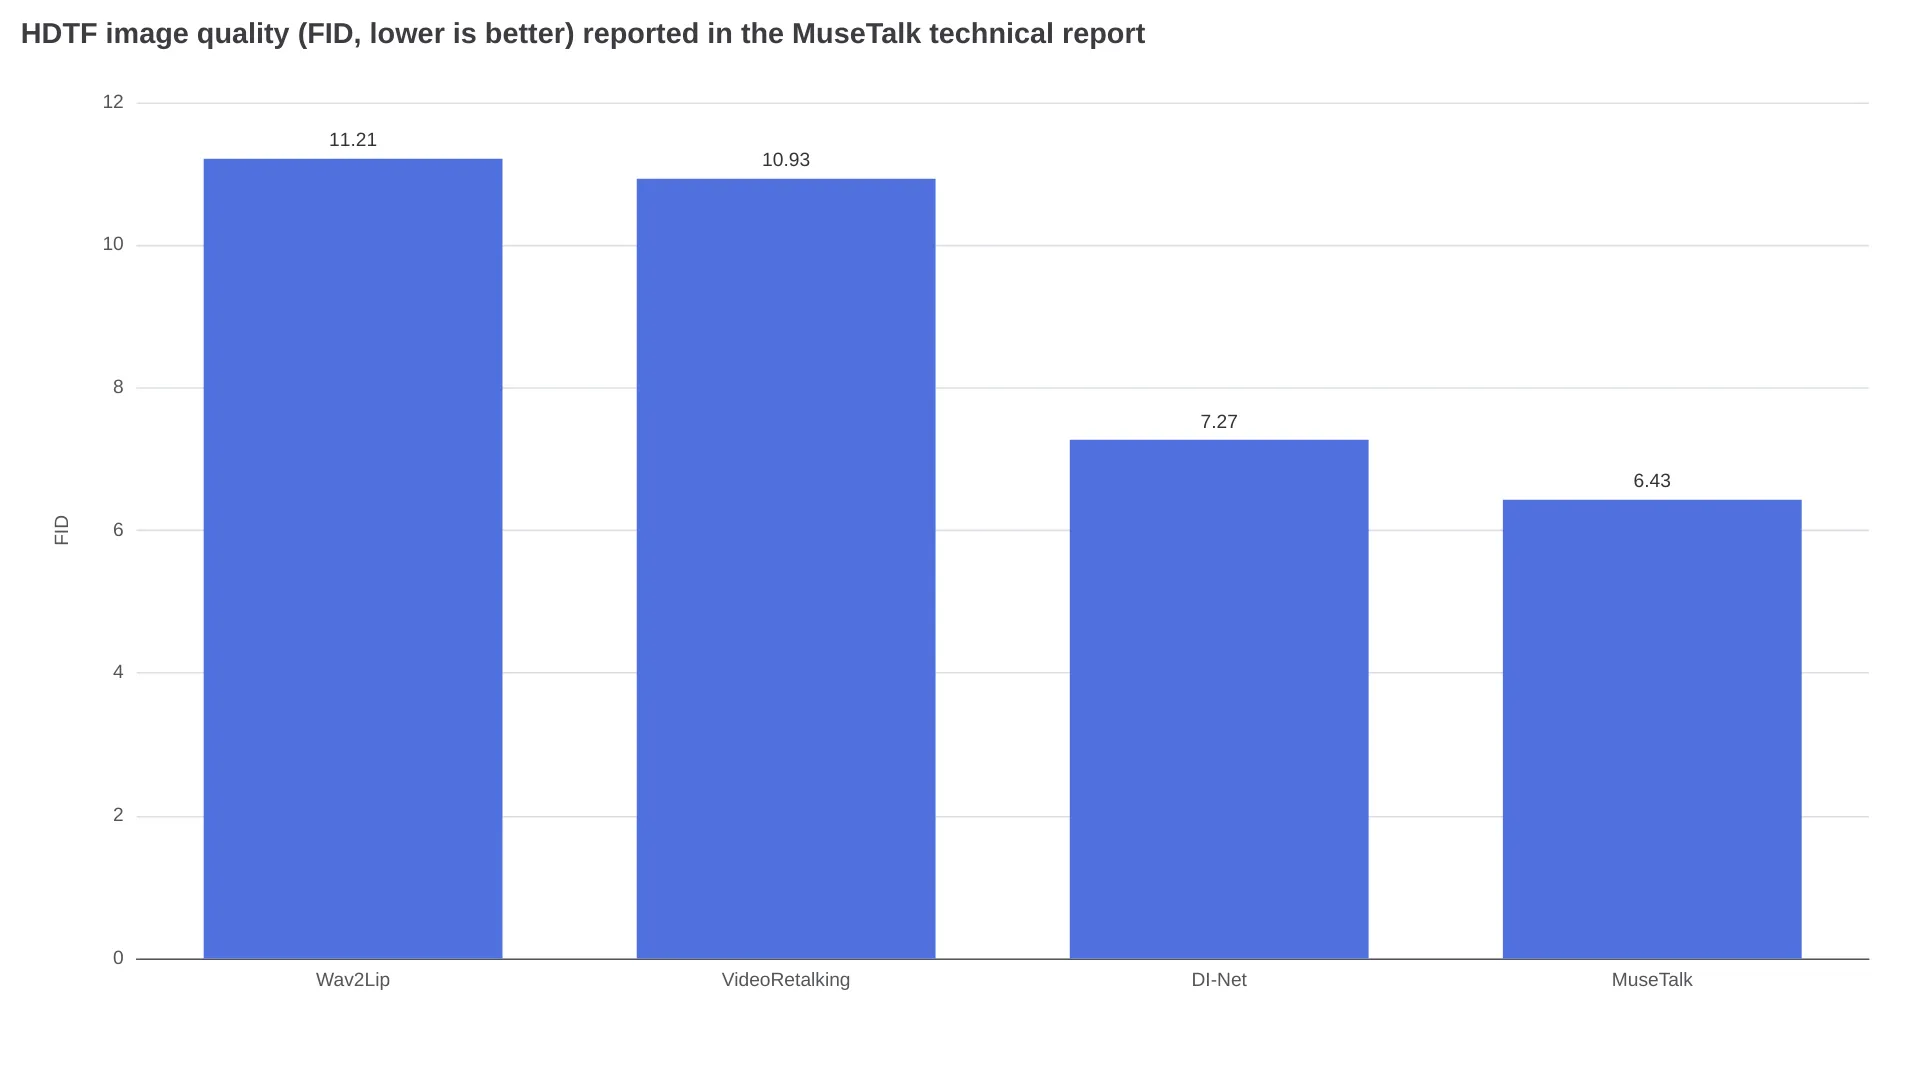
但换成同步指标,排名就变了。同一份报告中,Wav2Lip 的 LSE-C 为 7.46,MuseTalk 为 6.53;另一方面,MuseTalk 的身份相似度略高,CSIM 为 0.8225,对比之下 Wav2Lip 为 0.8184。简单说,较老的 GAN 模型在嘴唇跟踪上更强,MuseTalk 则带来更好的图像保真度。报告中的用户研究整体也只是中等水平:视觉质量 5 分制得分为 3.62,身份一致性为 3.55,唇形同步为 3.41。
结合 256x256 的限制来看,这些数字更适合被理解为:MuseTalk 能胜任有说服力的中景画面,但还经不起 4K 近距离特写的检验。
做一分钟唇形同步要花多少钱
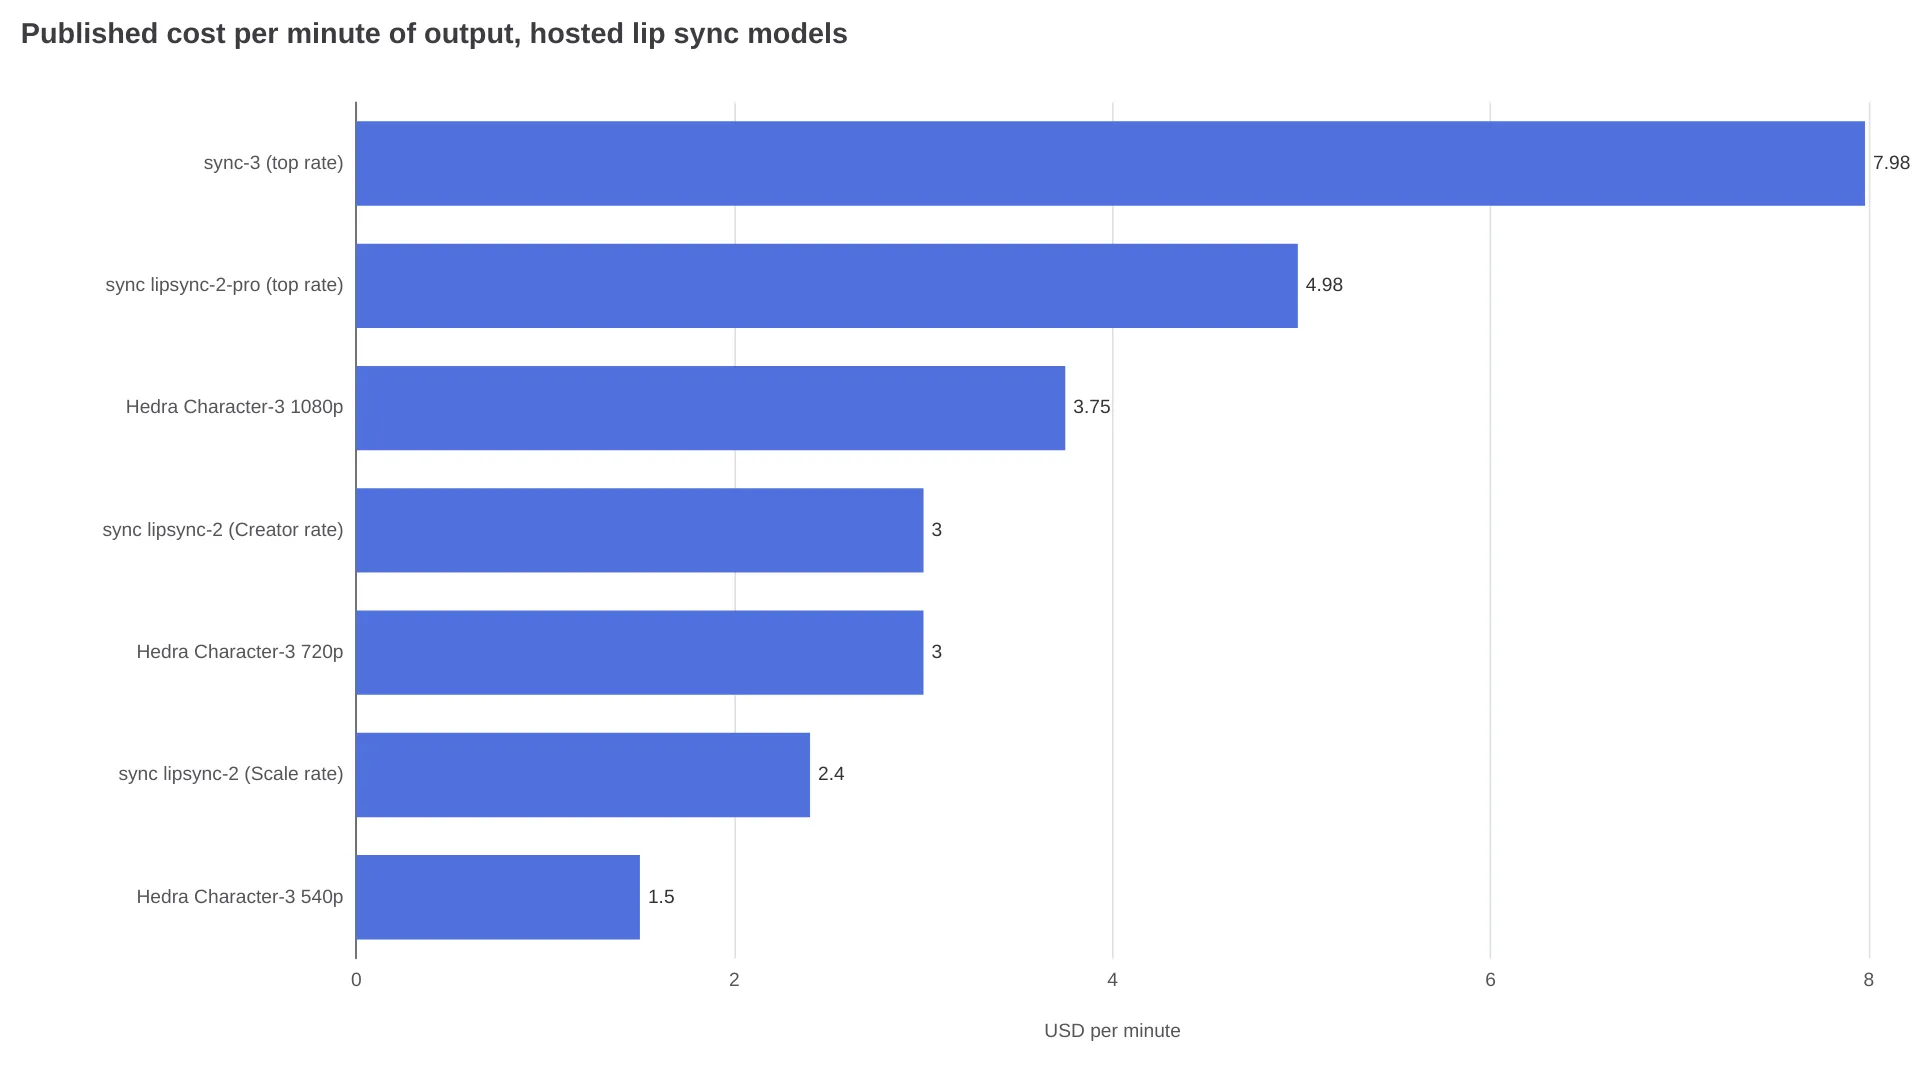
开源自托管方案的价值,主要就在这里。公开报价显示,托管式唇形同步模型的输出成本从每分钟 1.50 美元到接近 8.00 美元不等。
| 方案 | 公开价格(计费单位不同) | 每分钟输出成本 | 人脸分辨率 |
|---|---|---|---|
| MuseTalk 自托管,租用 Tesla V100 | 每 GPU 小时 0.188 美元 | 按每分钟视频消耗 2 GPU 分钟计算,约 0.006 美元 | 256x256 |
| Replicate 上的 MuseTalk | 每次运行约 0.052 美元;模型页面显示典型运行时间为 54 秒 | 按次计费,而非按分钟计费 | 256x256 |
| fal.ai 上的 MuseTalk | 按计算秒数计费 | 模型页面未公布 | 256x256 |
| Hedra Character-3 540p / 720p / 1080p——图生视频,并非现有视频的直接替代方案 | 每秒 2.5 美分 / 5 美分 / 6.25 美分 | 1.50 美元 / 3.00 美元 / 3.75 美元 | 不适用 |
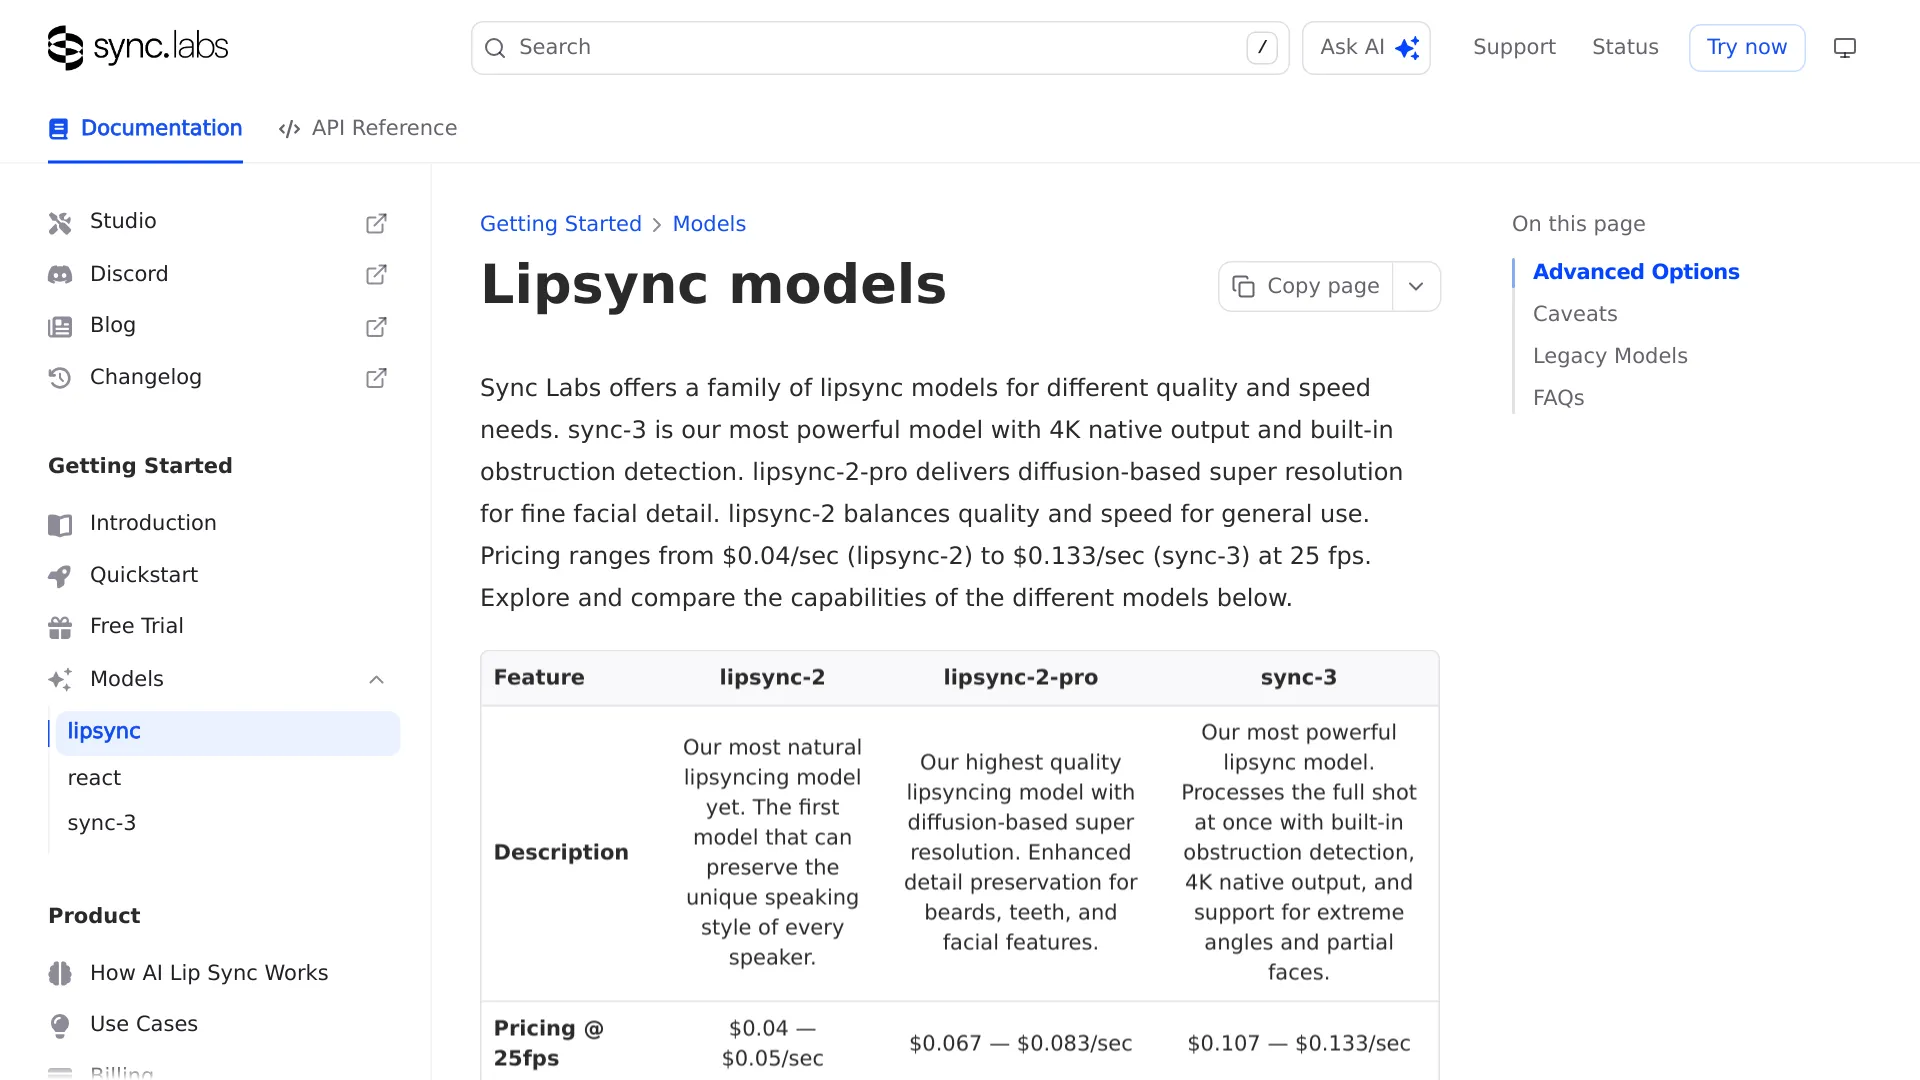
| sync lipsync-2 | 25 fps 时每秒 0.04–0.05 美元 | 2.40–3.00 美元 | 512x512 |
| sync lipsync-2-pro | 每秒 0.067–0.083 美元 | 4.02–4.98 美元 | 512x512 + 细节处理 |
| sync-3 | 每秒 0.107–0.133 美元 | 6.42–7.98 美元 | 原生 4K |
自托管成本来自 NexGPU 的成本测算。它按每分钟视频需要两分钟端到端 GPU 时间计算,其中包括推理、DWPose 检测、VAE 编解码和 FFmpeg 封装。在每小时 0.188 美元的 V100 上处理 100 段一分钟视频,计算成本约为 0.63 美元,另外还要加上约 0.09 美元的准备时间。这些只是 GPU 租用成本,不包含工程时间、存储和运维开销。
如果把规模扩大到本地化项目,差距会迅速拉开。500 分钟配音视频,通过自托管 MuseTalk 租用 GPU 的成本大约是 3 美元;如果按 Creator 价格使用 sync lipsync-2,则要花 1,200 美元。
免费方案从哪里开始不再免费
你为每分钟溢价买到的东西,主要集中在以下几方面:
- 人脸生成分辨率。 根据 sync 的模型文档,lipsync-2 和 lipsync-2-pro 以 512x512 生成人脸,区域尺寸是 MuseTalk 的两倍;sync-3 则原生输出 4K,并内置超分辨率。
- 复杂镜头。 同一份文档称,sync-3 原生支持侧脸、越肩构图和局部人脸,并能自动检测遮挡。MuseTalk 则是逐帧进行人脸检测,因此转头或手挡住嘴部,都是文档明确指出的失败场景。
- 多人视频。 sync 目前的三个模型都将活跃说话人检测列为可选功能;MuseTalk 没有对应的参数。
- 安装时间。 自托管部署需要自己承担这部分成本,而且并不算小。
fal.ai 的 MuseTalk 页面很好地说明了最后一点的价值:你只需要提供视频 URL、音频 URL,除此之外什么都不用配置。不需要 conda 环境,不需要锁定 CUDA 版本,也不需要手动准备权重目录。
如何安装 MuseTalk,少在依赖问题上浪费时间
真正运行过这个模型的人,反复抱怨的往往不是输出质量,而是 OpenMMLab 依赖栈。在 r/StableDiffusion 上,一位同时测试 MuseTalk 和 LatentSync 的用户这样总结:
“LatentSync 和 Musetalk 都能运行,表现也差不多……Musetalk 很难安装,因为它依赖 OpenMMLab 的库。”——u/Traditional_Tap1708,r/StableDiffusion
按照 README 锁定的版本安装,并使用 mim,不要直接用普通的 pip:
- 在全新的 conda 环境中使用 Python 3.10,并安装 PyTorch 2.0.1、torchvision 0.15.2 和 torchaudio 2.0.2。
mim install mmengine "mmcv==2.0.1" "mmdet==3.1.0" "mmpose==1.1.0"。mmcv 版本过新,是 mmdet 导入失败最常见的原因。- 将 FFmpeg 加入
PATH,通过ffmpeg -version确认;在 Windows 上也可以通过--ffmpeg_path显式指定路径。 - 执行
sh download_weights.sh下载完整权重目录。只有 UNet 还不够;这个脚本还会下载 sd-vae-ft-mse、Whisper、DWPose 的dw-ll_ucoco_384.pth以及 BiSeNet 人脸解析权重。缺少文件时,通常会表现为人脸检测或融合失败,而不是给出清晰的报错。 - 使用
ffmpeg -i input.mp4 -r 25 output.mp4将原视频转换为 25 fps。仓库建议输入视频使用 25 fps,因为模型就是按这一帧率训练的;帧率不匹配通常是出现时间漂移的原因。 - 在
configs/inference/test.yaml中指定视频和音频,然后运行python -m scripts.inference --inference_config configs/inference/test.yaml --result_dir results/test --unet_model_path models/musetalkV15/unet.pth --unet_config models/musetalkV15/musetalk.json --version v15。
如果要针对同一张脸反复生成内容,可以先在 configs/inference/realtime.yaml 中将 preparation: true 设置一次,让程序把 coords.pkl、latents.pt 和蒙版集合缓存到 results/v15/avatars/ 下,再改回 false。另外,加入 --skip_save_images 的效果比听起来更重要:将 PNG 写入磁盘,可能会让磁盘 I/O 取代模型本身成为瓶颈。
MuseTalk 1.5 还是 1.0:该下载哪个权重
选 1.5。仓库将它列为最新版本,发布日期为 2025 年 3 月 28 日,并表示它通过感知损失、GAN 损失和同步损失,以及两阶段训练,改善了清晰度、身份一致性和唇形与语音的对齐效果。
保留 1.0 的唯一主要理由是 bbox_shift,这个参数只适用于该版本。它会垂直移动蒙版边界:正值会让嘴巴张得更大,负值则会让嘴巴闭得更小。
先使用默认设置运行一次,脚本会打印出当前视频可调节的范围。README 中的示例范围是 [-9, 9],最终选择了 -7。在这个范围内重新渲染:如果嘴巴张得太夸张,就往负值方向调;如果几乎张不开,就往正值方向调。
你会遇到哪些失败情况,哪些可以靠调参解决
| 现象 | 原因 | 能否修复 |
|---|---|---|
| 运行中止,未检测到人脸 | 某一帧中人脸转向、被遮挡或完全缺失 | 可以。裁掉或剪掉出问题的片段 |
| 嘴巴几乎不动 | 人声被音乐盖住,或蒙版边界过高 | 可以。分离人声;在 v1.0 中使用正值 bbox_shift |
| 视频中途嘴形逐渐不同步 | 原视频不是 25 fps | 可以。处理前先转换帧率 |
| 嘴部相对清晰脸部显得模糊 | 人脸在画面中太小,256x256 区域不够用 | 部分可以。裁得更紧,关闭 fp16,并加入人脸修复 |
| 出现明显接缝,胡子无法保留 | 下半脸合成会替换部分身份细节 | 不可以。这属于模型限制 |
| 相邻帧之间出现抖动 | 每一帧都是单独生成的 | 部分可以。仓库将更好的一致性归因于 v1.5 的两阶段训练 |
| 卡通或风格化人脸效果失败 | 训练数据主要是真实人脸 | 不可以 |
| 音频情绪强烈,但人物表情和头部完全静止 | MuseTalk 不会处理头部运动或面部表情 | 不可以。需要重新拍摄或更换原始视频 |
一位进行低显存测试的用户报告称,MuseTalk 处理 7 秒音频需要“171 秒”,并补充说它“只适用于真实图像”(u/Bartholomheow,r/StableDiffusion)。至于“实时 30 fps”这个说法,指的是完成头像准备后的持续处理吞吐量,而不是端到端延迟。一位在 r/LocalLLaMA 上开发说话头像的开发者表示,对他们的交互式使用场景来说,MuseTalk 的“准备时间太长”(u/lonyPorgrammer)。
不同工作该选哪条唇形同步路线
| 方案 | 适合什么时候选 | 主要取舍 |
|---|---|---|
| 自托管 MuseTalk | 处理量大,视频条件理想:本地化初稿、同一张脸配合数千段音频生成交互式头像、内部培训视频 | 安装配置按小时计算,而不是几分钟;处理速度取决于你租用的 GPU |
| 托管版 MuseTalk(Replicate、fal.ai) | 只做少量视频,或者在正式部署前用自己的素材测试质量 | 同样受 256x256 限制,两个端点的接口定义中都没有头像缓存参数,并且按次计费 |
| 付费唇形同步模型(sync-3、lipsync-2-pro) | 面向客户的成片、大幅近景、侧脸、遮挡、多人说话以及 4K 交付 | 每分钟 4–8 美元,而且视频会离开你的基础设施 |
如果要复现官方吞吐量数据,可以租用 V100;如果要进行实时流式处理,则可以考虑 4090。关于托管端点方案,两大平台的更多信息可以参考我们的 Replicate 评测和 fal.ai 评测。
MuseTalk 唇形同步 FAQ
MuseTalk 能在 6 GB 或 8 GB 显卡上运行吗?
可以。README 记录了在 4 GB RTX 3050 Ti 笔记本 GPU 上使用 FP16 测试的结果,因此基础推理能够适应有限显存。实际更大的限制在于处理速度。
256x256 是最终输出分辨率吗?
不是。它指的是可编辑的人脸区域,处理后会融合回保持原始分辨率和帧率的视频中。
MuseTalk 支持卡通或动漫人物吗?
不可靠。模型是在真实说话人视频上训练的,测试风格化输入的用户也报告了结果不稳定。
“实时 30 fps”是否包含预处理?
不包含。这个数字描述的是 Tesla V100 在完成头像准备后的生成吞吐量。人脸检测、潜变量编码和首次缓存都发生在此之前。
MuseTalk 还是 LatentSync?
如果项目更看重延迟和处理量,可以优先考虑 MuseTalk,因为单步推理和头像缓存能减少大部分单个视频的处理成本。前面提到的那位 r/StableDiffusion 用户同时运行过两者,并认为它们的表现相近,因此最终决定因素更可能是吞吐量,而不是画质。
MuseTalk 可以用于商业项目吗?
仓库代码采用 MIT 许可证,但整个依赖链的许可并不统一。Whisper、VAE、DWPose、BiSeNet 人脸解析和 SyncNet 都各自采用不同条款,仓库也特别提示示例数据存在单独的限制。正式发布前需要逐项确认。
这个价位仍然没有解决的取舍
MuseTalk 基本不花什么钱,就能让你完成大部分工作。但它解决不了身份细节在高要求场景下的保持问题:胡子、精确的唇形、占满画面的人脸,以及说话过程中转头的人物。
对大多数团队来说,答案并不是只选一个工具,而是让 MuseTalk 负责大批量处理,再用付费模型处理那些会以全屏形式呈现的镜头。
相关文章
- Higgsfield AI 评测:价格与 API 访问对比
- Kokoro 82M TTS 本地部署指南,用于生成 MuseTalk 所需的音频轨道
- Wan 2.2 Animate 使用指南