 AIREITER
一位 Claude Code 用户按 API 官方价目表核算了一个月的 Max 计划工作量,结果 API 账单达到 7,470 美元,而订阅费用只有 200 美元。问题并不在于单个 Token 的价格有多离谱,而在于按量计费取消了订阅计划一直在默默提供的“封顶线”——更别说 Agent 工作负载会反复发送大量上下文,远超人类在聊天框里逐句输入的规模。
开发者为什么会报出这么大的差距
用户分享的比例虽然未经审计,但数字普遍很高,而且相当一致。一篇r/ClaudeAI 讨论根据 Claude Code 会话日志重建了使用量:一个月的 Max 使用量,如果按 API 官方价目表计算,约为 7,470 美元,而订阅费是 200 美元。另一篇规模较小的订阅与 API 对比讨论中,一位 200 美元套餐用户估算,同样的工作负载每月需要 5,000–20,000 美元。
这些都是用户自行估算的结果,但 Token 消耗最大的模式在两组案例中都一样:让 Agent 反复遍历代码仓库。
“我所在公司的 Claude Code 使用的是企业 API 计划。亲身体验是,在较大的项目上正常写代码,一次会话轻松就能烧掉 100–200 美元的 API 费用。”——u/andywidjaja,r/ClaudeAI
付费套餐和 API Key,本来就是两种产品
Anthropic 对此说得很直接。其帮助中心文章于 2026 年 3 月 16 日更新,明确表示 Claude 套餐与 Claude Console 是“面向不同用途设计的独立产品”,付费订阅“并不包含 Claude API 或 Console 的访问权限”。OpenAI 也是同样的模式,ChatGPT 和 API 平台使用两套独立的计费系统。
理解两者差异的关键,是看它们到底在卖什么:
| 付费聊天套餐 | API Key | |
|---|---|---|
| 计费单位 | 一个人类用户席位 | Token 吞吐量 |
| 使用上限 | 滚动 5 小时窗口加每周限制 | 不包含固定额度,但仍受速率和消费上限约束 |
| 使用方式 | 网页、桌面端和移动端应用 | 由你自己的代码调用 |
| 价格形态 | 固定月费 | 按 Token 浮动计费 |
| 为自己的产品提供能力 | 并非它的销售目标 | 这正是它的用途 |
Claude 的价格页面显示,Pro 套餐按月支付为 20 美元/月,按年支付则为 17 美元/月(一次性支付 200 美元);Max 套餐起价 100 美元/月,可在每个五小时会话中获得相当于 Pro 5 倍或 20 倍的使用量。Anthropic 没有为这些档位公布具体消息数量,因为实际消耗会随对话长度、模型和功能变化。因此,这里比较的是一个已经计量的数量和一个没有公开计量标准的数量。
同一页面还透露了另一个关键信息:Claude Enterprise 每个席位每月收费 20 美元,同时使用量仍按 API 费率计费。重度用户最终还是会回到按量计费的模式。
按官方价目表计算,20 美元订阅费能换来多少 Token
把套餐价格换算成 Token,差距就会变得非常直观。以下是Claude 平台定价文档和OpenAI API 价格页面公布的每百万 Token(MTok)官方价格,数据核对时间为 2026 年 10 月 1 日。
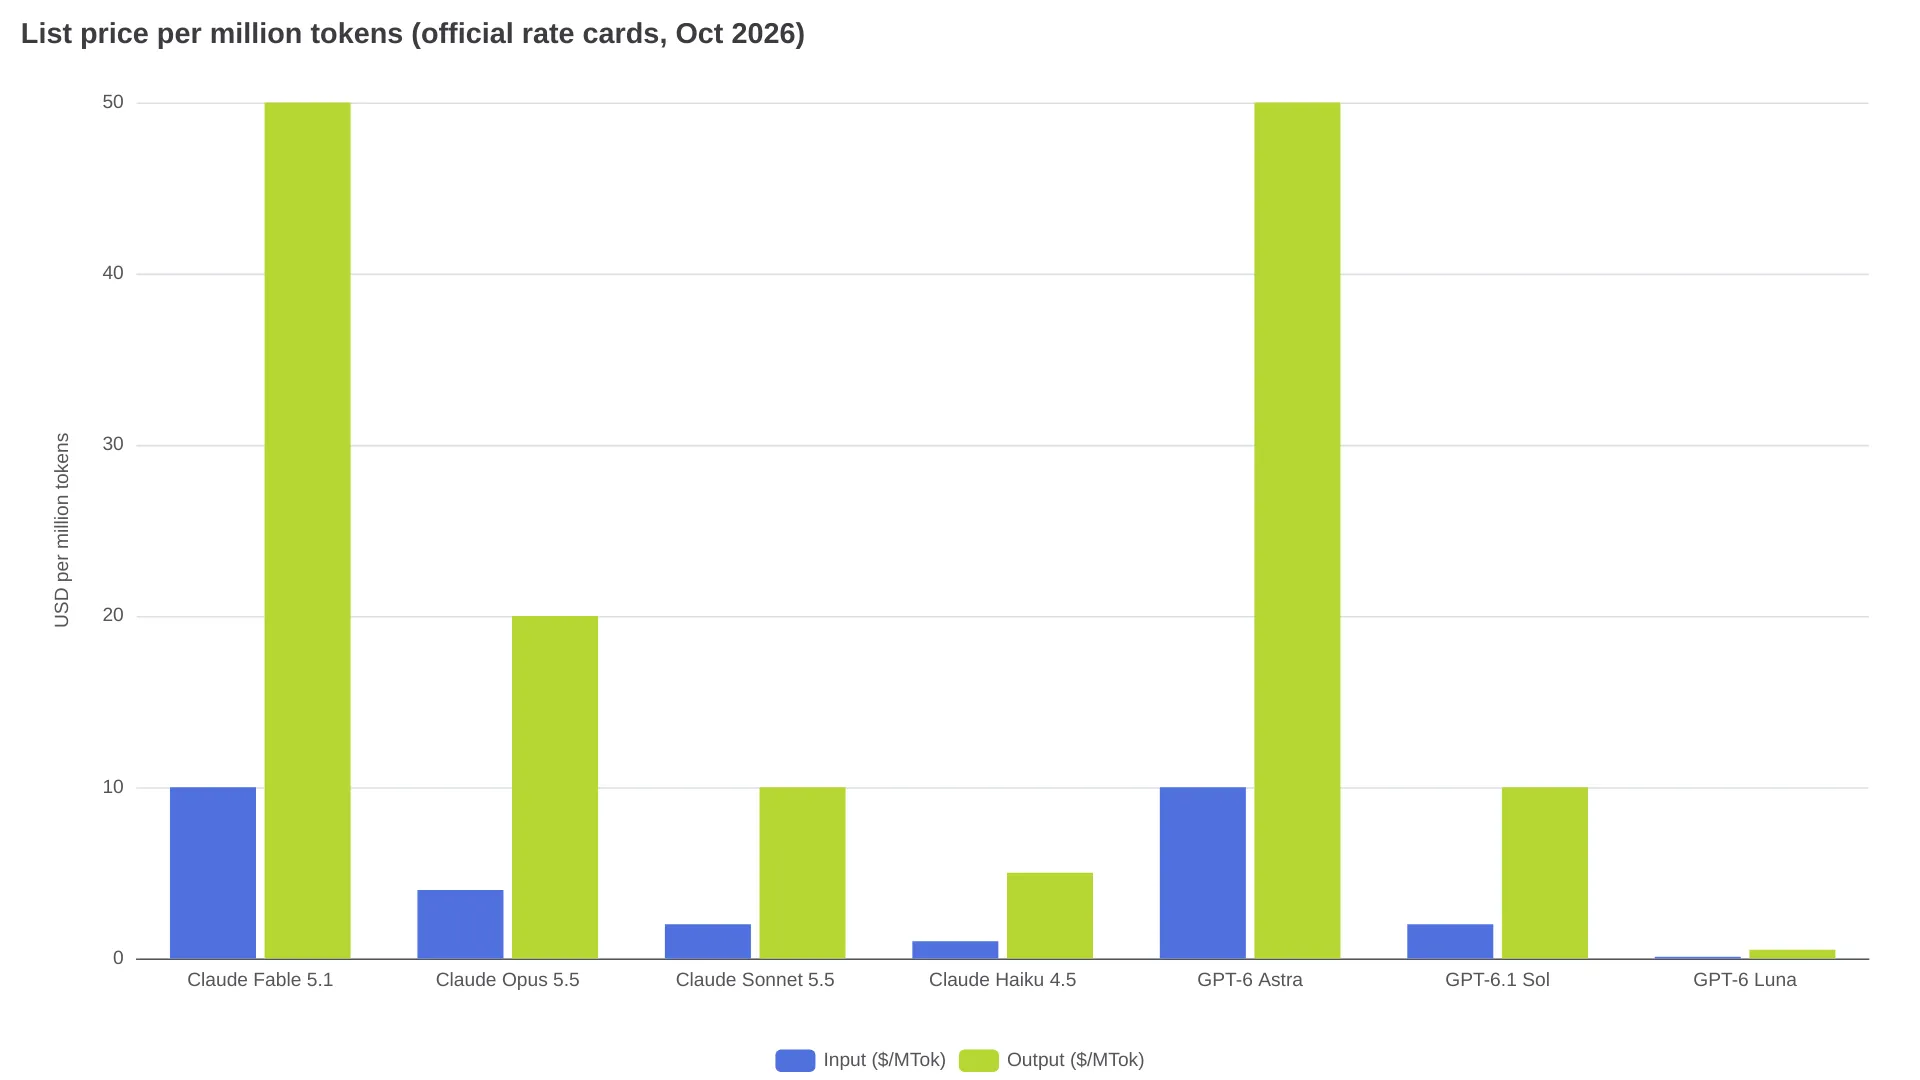
| 模型 | 输入 | 输出 | 缓存读取 | Batch(输入/输出) |
|---|---|---|---|---|
| Claude Fable 5.1 | $10 | $50 | $0.25 | $5 / $25 |
| Claude Opus 5.5 | $4 | $20 | $0.20 | $2 / $10 |
| Claude Sonnet 5.5 | $2 | $10 | $0.20 | $1 / $5 |
| Claude Haiku 4.5 | $1 | $5 | $0.10 | $0.50 / $2.50 |
| GPT-6 Astra | $10 | $50 | $1.00 | $5 / $25 |
| GPT-6.1 Sol | $2 | $10 | $0.10 | $1 / $5 |
| GPT-6 Luna | $0.10 | $0.50 | $0.01 | $0.05 / $0.25 |
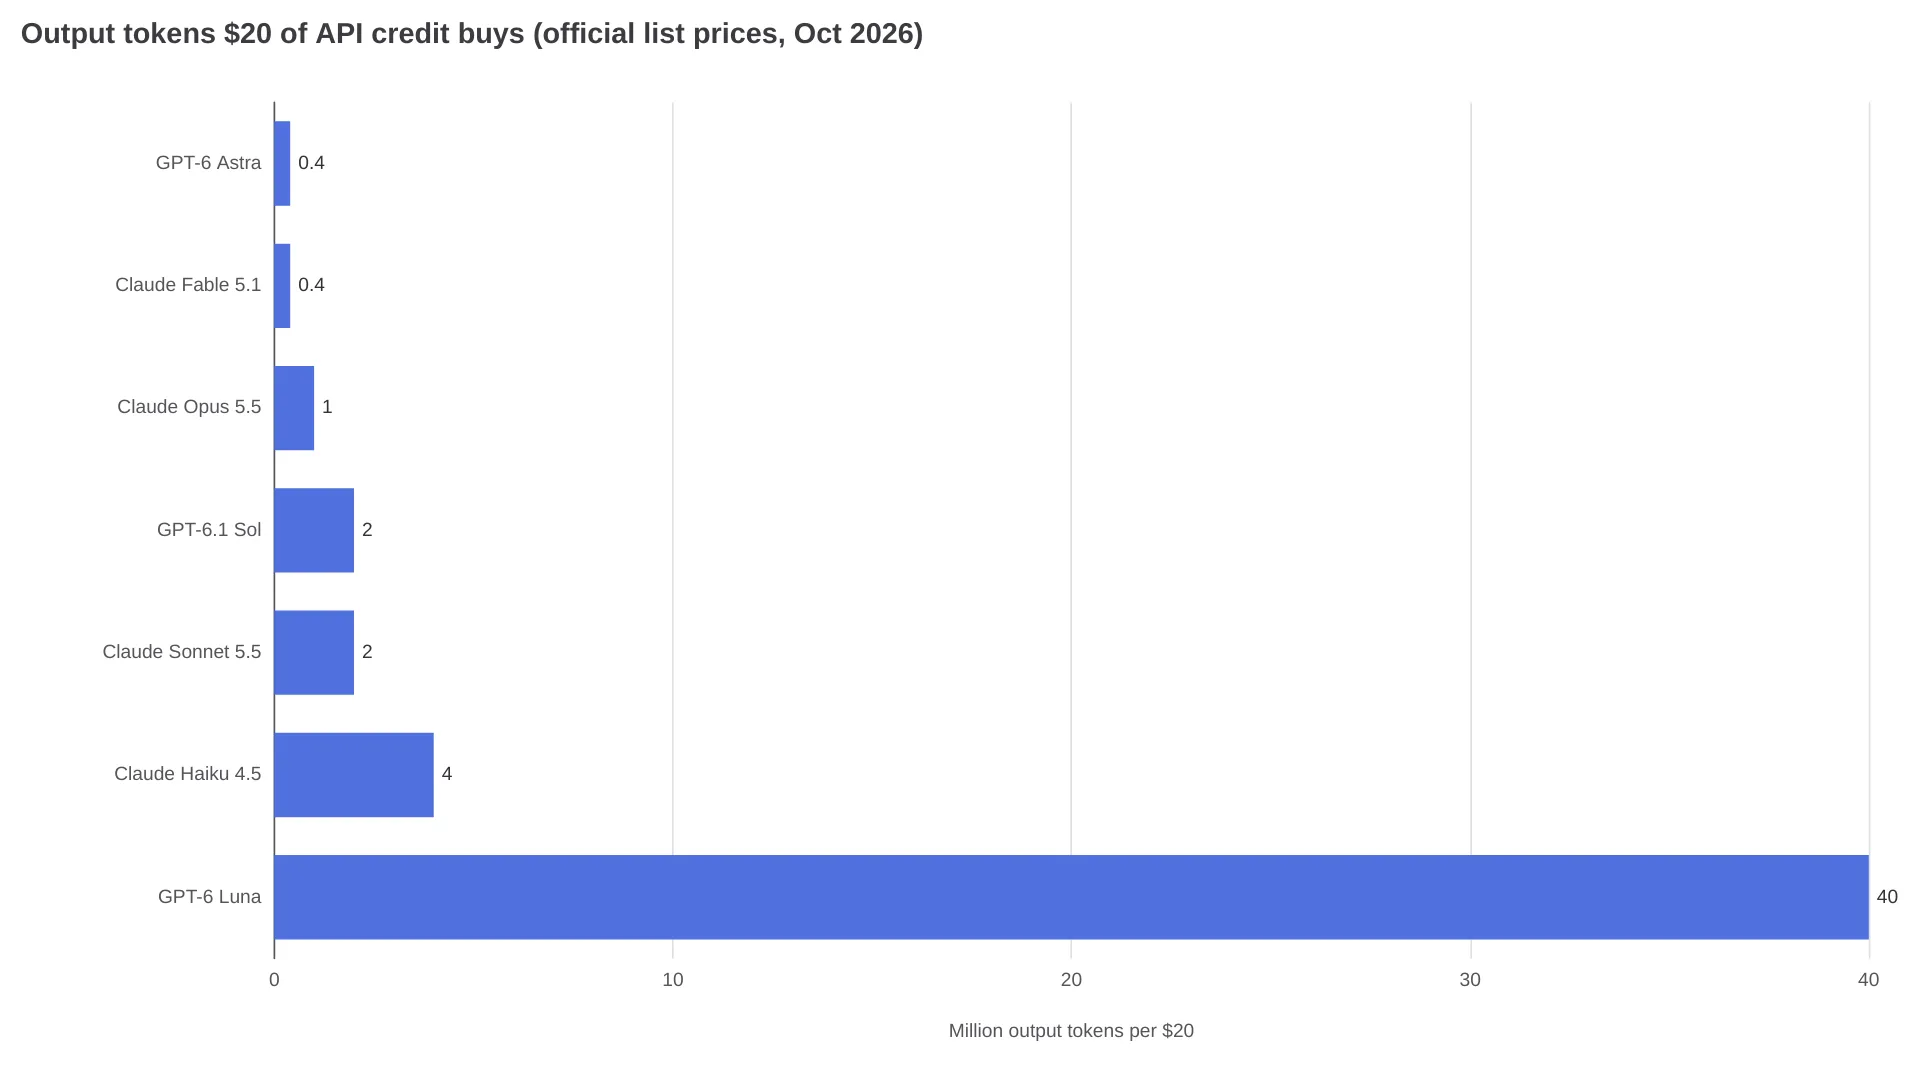
以聊天类工作负载为例:如果每次输入几千词的上下文,再返回几百词的内容,20 美元的 Sonnet 5.5 余额大约可以覆盖 1,000 万个输入 Token,或 200 万个输出 Token。你自己的准确账单,需要根据 API 响应中的四个字段计算:(fresh input × input rate) + (cached input × cache-read rate) + (cache writes × write rate) + (output × output rate),此外还要叠加 Batch、长上下文和区域等乘数。连续一周记录每个 endpoint 的这四项数据,就能得到一个月度数字,再拿它和单个席位的价格比较。
Token 到底消耗在了哪里
有四类常见的额外消耗,通常不会直接出现在价格表里。后面三类在LLM Cost Lab 对价格表之外成本的拆解中都有说明。
- 每轮都会重新发送的对话记录。在基于请求的聊天集成中,客户端会反复发送历史记录,因此第 20 轮请求会携带第 1 到第 19 轮的内容。如果每一轮都增加相近数量的上下文,输入量大致会随对话长度的平方增长。这也是为什么该分析估算一个 20 轮会话的成本为 0.163 美元,而按彼此独立的请求预算只有 0.063 美元,两者相差 2.6 倍。
- 每次调用都会重复发送的系统提示词。一个 2,000 Token 的系统提示词,如果被发送给 100 万次请求,在用户输入任何内容之前,就已经产生了 20 亿个输入 Token。
- 你看不到的推理 Token。对于将隐藏思考过程按输出计费的模型,这些 Token 可能比最终可见答案长数倍。只根据返回文本的字符数估算,就会低估实际账单。
- 工具结果、重试和被丢弃的生成结果。只要是模型生成的内容,就可能产生费用,包括被 JSON 校验器拒绝的响应,以及为了竞速而并行发起、最后被丢弃的请求。
便宜的 Token 也可能成为账单的主要部分,这正是很多人查看使用量面板时最困惑的地方。在那篇 7,470 美元的讨论中,有评论者发现缓存读取占总费用的 48%,尽管它是价格表中最便宜的 Token 类型。
“缓存读取已经是 API 上最便宜的 Token 类型了。如果按官方价格计算后它仍然占据主导,那就说明这个工作负载主要是在每一轮重新读取上下文。”——u/YoanEdwin,r/ClaudeAI
把 Opus 5.5 的价格代入一个 Agent 会话:每轮携带 150k Token 的代码仓库上下文,输出 2k Token,成本结构就很清楚了:
| Opus 5.5,60 轮会话,每轮 150k 上下文 + 2k 输出 | 成本 |
|---|---|
| 每轮都是新输入,没有缓存命中(150k @ $4) | $0.60 |
| 每轮使用缓存读取,而不是新输入(150k @ $0.20) | $0.03 |
| 每轮输出(2k @ $20) | $0.04 |
| 每个会话写入一次、缓存时长 1 小时(150k @ $8) | $1.20 |
| 会话总成本,未使用缓存 | $38.40 |
| 会话总成本,使用缓存 | $5.40 |
每天进行两次缓存会话,连续 22 个工作日,成本大约为 238 美元,已经超过 200 美元套餐。若完全不使用缓存,同样的月份成本会超过 1,600 美元。单价没有变化,变化的是 Token 数量。
其实不只是两档,而是三档
大多数对比只看套餐和 API,但实际上还存在第三档:当订阅额度用完后,在订阅产品内部购买额外使用额度。用户通常只有在配额耗尽后,才会遇到这一档。
r/codex上的用户报告显示,这一档的价格可能高于直接使用 API。一位 Pro 用户记录了通过购买额度消耗的约 1,600 万个 Token,花费约 40 美元;随后估算,同样的用量按 API 官方价格计算约为 12 美元。
“这些额度的定价已经接近掠夺性收费了。一个落地页就要 50 美元实在荒谬,因为直接调用 API 可能只要 2 美元。”——u/AbjectBug5885,r/codex
这些仍然只是用户估算,并不是适用于所有人的统一价格;不同供应商和套餐的充值价格也会不同。在上面的 Codex 案例中,额外额度这一档的价格大约是同等 API 官方价格的 3 倍。因此,在连续第二周购买额度之前,最好先用自己的实际数据核算一次。
真正能改变账单的五个杠杆
下面每个杠杆都有对应的官方价格,先对照供应商页面,再自己算一遍即可验证。
- 使用提示词缓存,但别忘了缓存写入成本。Anthropic 的定价文档显示,5 分钟缓存写入按基础输入价格的 1.25 倍计费,1 小时写入按 2 倍计费;缓存读取则为基础价格的 0.1 倍(Opus 5.5 为 0.05 倍,Fable 5.1 为 0.025 倍)。5 分钟写入只需一次读取就能回本,1 小时写入需要两次读取才能回本。如果写入后从未读取,反而比完全不使用缓存更贵。缓存不仅要打开,顺序也很重要:稳定内容放在前面,用户变化内容放在最后,否则前缀就无法匹配。关于命中率调试,可以参考这篇提示词缓存指南。
- 能延迟处理的任务,尽量使用 Batch。两家供应商都为异步处理提供 50% 的官方价格折扣:Opus 5.5 降至 $2/$10,Sonnet 5.5 降至 $1/$5。但其他模型的支持情况并不一致:LLM Cost Lab 统计的 83 个模型中,只有 26 个提供折扣后的 Batch 档位。因此,在围绕 Batch 设计架构前,先确认你的模型是否支持。具体机制可以查看我们的Batch API 定价指南。
- 根据任务选择模型档位。分类、路由和检索决策通常不需要最强的前沿模型。Haiku 4.5 的价格是 $1/$5,而 Fable 5.1 是 $10/$50;如果某个步骤只输出 10 个 Token,两者也存在 10 倍的价格差距。
- 限制输出内容,而不只是设置
max_tokens。上表中几乎所有模型的输出价格都是输入价格的 5 倍。禁止前导说明的 Schema,可能只增加少量结构开销,却能避免生成本来会被计费的大段文字。相比把max_tokens当成格式控制工具,它更适合作为安全上限,因为被截断的回答可能需要再次付费请求。 - 留意叠加在基础价格上的乘数。OpenAI 的长上下文档位会让短上下文输入价格翻倍,Fast mode 还会在此基础上再次将标准价格翻倍。Anthropic 对固定在美国区域的推理收取 1.1 倍费用,而其定价文档指出,Claude 4.7 及后续版本使用了新的 Tokenizer,同样的文本大约会产生多 30% 的 Token。你的提示词没有变,计费方式变了。
还有一个不属于上述清单的结构性选择:把程序化流量统一路由到一个按量计费的 endpoint,而不是让每个供应商各自建立一套计费关系。这正是AIReiter 的 Claude API endpoint所解决的问题。按官方价格计算,一个月额外使用 4,000 万个 Sonnet 级输入 Token 和 800 万个输出 Token,成本为 $80 + $80。把这个数字和再买一个席位的价格比较,通常只需要一分钟。
到底该买哪一种
| 你的使用场景 | 建议购买 | 原因 |
|---|---|---|
| 聊天、研究,以及偶尔在应用中写代码 | 只买付费套餐 | 支出有上限,包含应用,使用量明显低于套餐限制 |
| 个人 Agent 编程,只有一台机器 | 先买套餐,再用按量计费的 Key 处理超出部分 | 套餐承担大部分使用量,API Key 则能避免等待每周重置 |
| 要上线一个供其他人使用的产品 | 只用 API | 一个席位只覆盖一个人类用户,而你的用户需要自己的吞吐量 |
| 周期性批处理任务:评测、回填、分类 | 使用支持 Batch 档位的 API | 官方价格 50% 折扣,而且不在乎延迟 |
| 几乎每周都在购买额外额度 | 把超出部分与 API Key 的成本做比较 | 用户报告显示,额外额度的价格高于 API 官方价格 |
常见问题
付费 ChatGPT 或 Claude 套餐包含 API 额度吗?
不包含。Anthropic 帮助中心明确表示,付费 Claude 套餐“并不包含 Claude API 或 Console 的访问权限”;OpenAI 也通过两套独立系统分别为 ChatGPT 和 API 平台计费。两者都购买,就意味着账单上会出现两笔费用。
我看不到的推理 Token 也要付费吗?
如果模型支持思考或扩展推理,答案是要付费。这些 Token 按输出价格计费,却不会出现在响应正文中,因此应当查看 usage 对象。
每一轮都要为完整对话付费吗?
是的,除非重复的前缀命中了缓存。如果没有服务端状态功能,客户端就必须重新发送希望模型看到的历史记录。这些历史内容会按模型的价格作为新输入计费;如果前缀匹配,则按缓存读取价格计费。
失败或重试的请求也会产生费用吗?
根据 LLM Cost Lab 的计费拆解,只要请求已经到达模型并返回结果,即使应用在 Schema 校验失败或客户端超时后丢弃了结果,也仍然会计费。请求在生成前就被拒绝,则属于例外。
目前没人真正解决的取舍
套餐限制支出,但会限制使用;按量计费的 Key 则反过来。由于套餐配额没有公布对应的 Token 数量,要回答“哪种方式对我更便宜”,最可靠的做法是记录一周真实的、经过埋点的流量,再按照上面的价格表计算。