 AIREITER
OpenRouter 上线仪表盘时曾公布,全平台缓存命中率达到 82.8%(@OpenRouter)。但开发者社区里,另一种体验同样常见:缓存命中率不足 1%(@miolini),实际账单比预期高出 10–32 倍(r/openrouter)。OpenRouter 的 prompt caching 确实能显著降低输入成本,但前提是先排除四类典型故障;其中影响最大的一项,是让连续请求始终落到同一个已经预热的提供商上。还有一个硬性门槛:提示词低于提供商规定的最小 token 数,无论怎么配置,都不可能命中缓存。
OpenRouter 的缓存命中,到底命中了什么
Prompt caching 会复用提供商已经处理过的稳定提示词前缀。后续请求中重复出现的输入 token,会按折扣价而不是原价计费。缓存保存在最初处理请求的具体提供商端点上,因此路由策略和提示词结构同样关键。这与 response caching 不是一回事:后者会在请求路由前,直接免费返回一次完全相同的完整请求的结果。
| Prompt caching | Response caching | |
|---|---|---|
| 复用内容 | 任意请求中的稳定前缀 | 字节级一致的请求(规范化请求体的 SHA-256) |
| 启用方式 | 大多自动启用;Anthropic、Qwen、Gemini 可使用 cache_control | X-OpenRouter-Cache: true 请求头或预设 |
| 成本 | 缓存 token 按正常输入价的 0.1–0.5 倍计费 | 命中免费,未命中按正常价格计费 |
| 有效期 | 通常为 3–5 分钟,Anthropic 最长可达 1 小时 | 默认 300 秒,范围为 1–86,400 秒 |
| 失效条件 | 前缀变化、提供商切换、未达 token 门槛 | 任意 JSON 改动、API 密钥轮换、账户 ZDR |
Response caching 特别适合重试、单元测试,以及 Agent 工作流中的重复调用。不过 JSON 属性顺序本身就是缓存键的一部分,一次看似无害的序列化变化也会导致未命中。至于提供商侧的具体机制,可参考 OpenRouter 的 prompt caching 指南:
各家提供商怎么收 Prompt Caching 的钱
所有提供商都会对缓存读取给予输入价格折扣,但首次写入缓存未必免费。Anthropic 默认 5 分钟 TTL 的写入价格为正常输入的 1.25 倍,选择 1 小时则为 2 倍。只有当相同前缀被多次读取,节省下来的成本才能覆盖首次写入溢价;如果请求只出现一次,开启缓存反而可能更贵。以 Claude Sonnet 4.6 为例,依据 OpenRouter 给出的计算示例,缓存输入为 $0.30/M,未缓存输入则是 $3.00/M。
以下是同一来源整理的各提供商缓存写入与读取倍率:
| 提供商 | 缓存写入 | 缓存读取 | 备注 |
|---|---|---|---|
| Anthropic | 1.25 倍(5 分钟)/ 2 倍(1 小时) | 0.1 倍 | 可在每个断点单独选择 TTL |
| OpenAI,GPT-5.6 之前 | 免费 | 0.25–0.5 倍 | 从 1,024 tokens 起自动生效 |
| OpenAI GPT-5.6+ | 1.25 倍 | 0.25–0.5 倍 | 现已支持显式断点 |
| Google Gemini | 免费 | 0.25 倍 | 2.5+ 隐式缓存,TTL 约为 3–5 分钟 |
| Grok | 免费 | 0.25 倍 | 自动启用 |
| Moonshot | 免费 | 0.25 倍 | 自动启用 |
| Groq | 免费 | 0.5 倍 | 仅限 Kimi K2 模型 |
| DeepSeek | 1.0 倍 | 0.1 倍 | 写入按普通输入价格计费 |
| Alibaba Qwen | 1.25 倍 | 0.1 倍 | 必须显式设置 cache_control |
| Z.AI | 免费 | 约 0.2 倍 | 缓存存储标注为限时免费 |
OpenRouter 的教程以六轮对话中重复出现的 10,000 tokens 为例:不使用缓存时,成本是单轮的 6.0 倍;使用 Anthropic 的 5 分钟缓存并开启粘性路由后,降至 1.75 倍;在写入免费、读取为 0.25 倍的提供商上,则为 2.25 倍。该模型不计算持续增长的消息和输出 token。
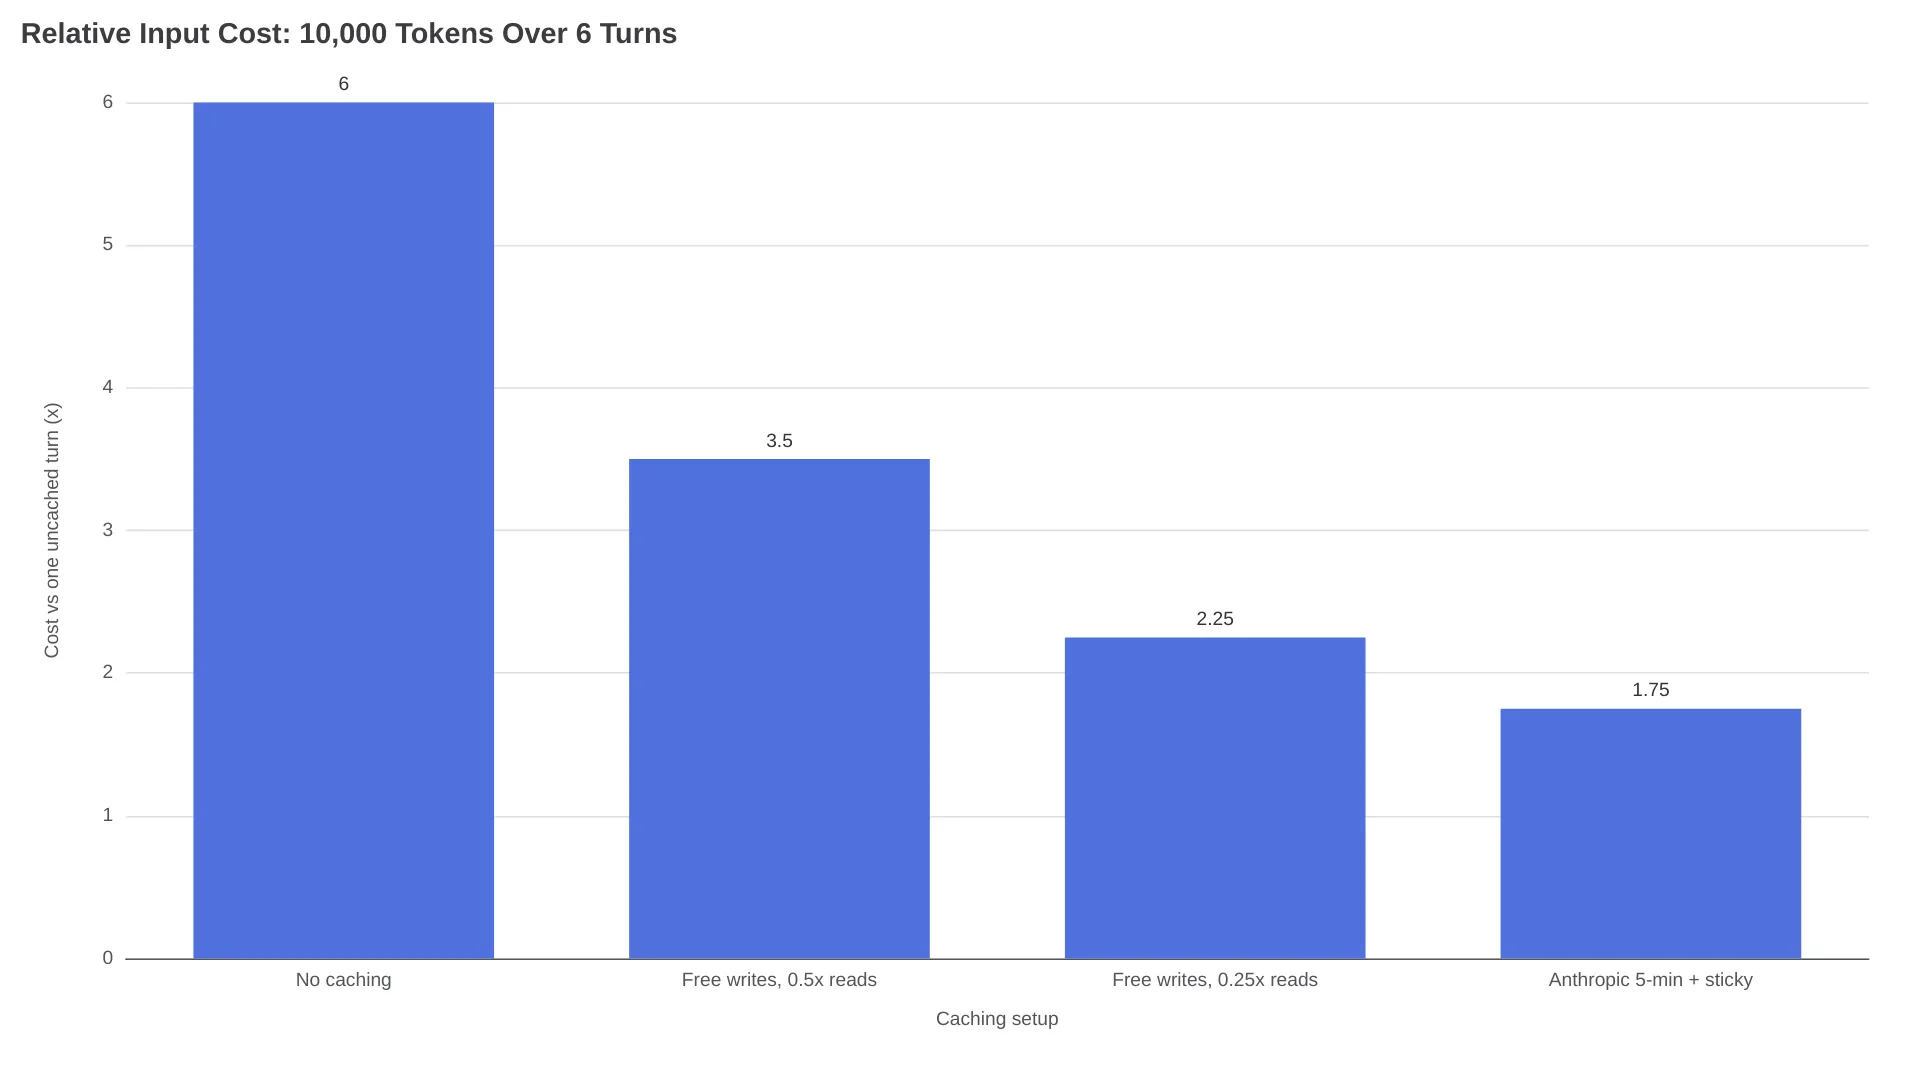
即使 Anthropic 的首次写入较贵,到了第六轮依然更划算,因为从第二轮开始,0.1 倍的读取价格就占据主导;轮次越多,差距越大。唯一会扭转这一结果的情况,是每轮之间都超过了 5 分钟 TTL。此时每次请求都要重新支付 1.25 倍写入成本,六轮总计达到 7.5 倍,比完全不用缓存还贵;而写入免费的提供商即使输入按 1.0 倍计费,也只是与未缓存的 6.0 倍持平。
先看数据:三个字段能确认是否命中缓存
每个 OpenRouter 响应都会在 usage 对象中给出答案:cached_tokens、cache_write_tokens 和 cache_discount,字段含义见 OpenRouter 的缓存指南。在改任何配置前,先读懂这三个数字,才能区分真正的缓存未命中和单纯的价格预期偏差。只要 cached_tokens 大于零,就说明请求命中了已预热的缓存;它为零,则代表没有命中,无论 Activity 仪表盘看起来如何。
"usage": {
  "prompt_tokens": 10339,
  "prompt_tokens_details": {
    "cached_tokens": 10318,
    "cache_write_tokens": 0
  }
}
这个响应的缓存命中率为 99.8%:10,339 个 prompt tokens 中,有 10,318 个来自缓存。cache_write_tokens 会出现在首次建立缓存的请求中;cache_discount 则显示节省金额。在 Anthropic 的缓存写入请求上,它甚至可能是负数,因为 1.25 倍写入溢价是实打实的成本,需要由后续读取来摊销。你也可以在 Activity 的 generation 详情页,或通过 /api/v1/generation 获取同样的数据;详情页位置可参见我们的 Activity 仪表盘指南。
原始元数据才是事实依据,不是 UI。就有一位 SillyTavern 用户追查了很久所谓的缓存问题,最后直接查看日志才发现真相:
“原始 OpenRouter 元数据直接写着
native_tokens_cached: 0[以及]usage_cache: null。”—— u/HauntingWeakness
如果连续多天这三个数字都是零,那多半是下面四种故障之一在让缓存失效。
缓存为什么会突然失效:四种常见原因
OpenRouter 文档与社区反馈都指向四类命中率崩塌的常见根因:提示词未达到最小长度、轮次之间缓存过期、前缀发生变化,以及请求漂移到其他提供商。它们在日志中的表现不同,对应的修复方式也不同。
1. 提示词没达到提供商的最低 token 门槛
支持 prompt caching 的提供商都会设定按模型划分的 token 下限。比如只有 900 tokens 的系统提示词,在任何 Claude 模型上都不会缓存;而 OpenRouter 教程也明确不建议用无意义文本硬凑长度:“不要为了强制启用缓存而给请求填充无用文本。”不同模型的门槛最高可相差四倍:
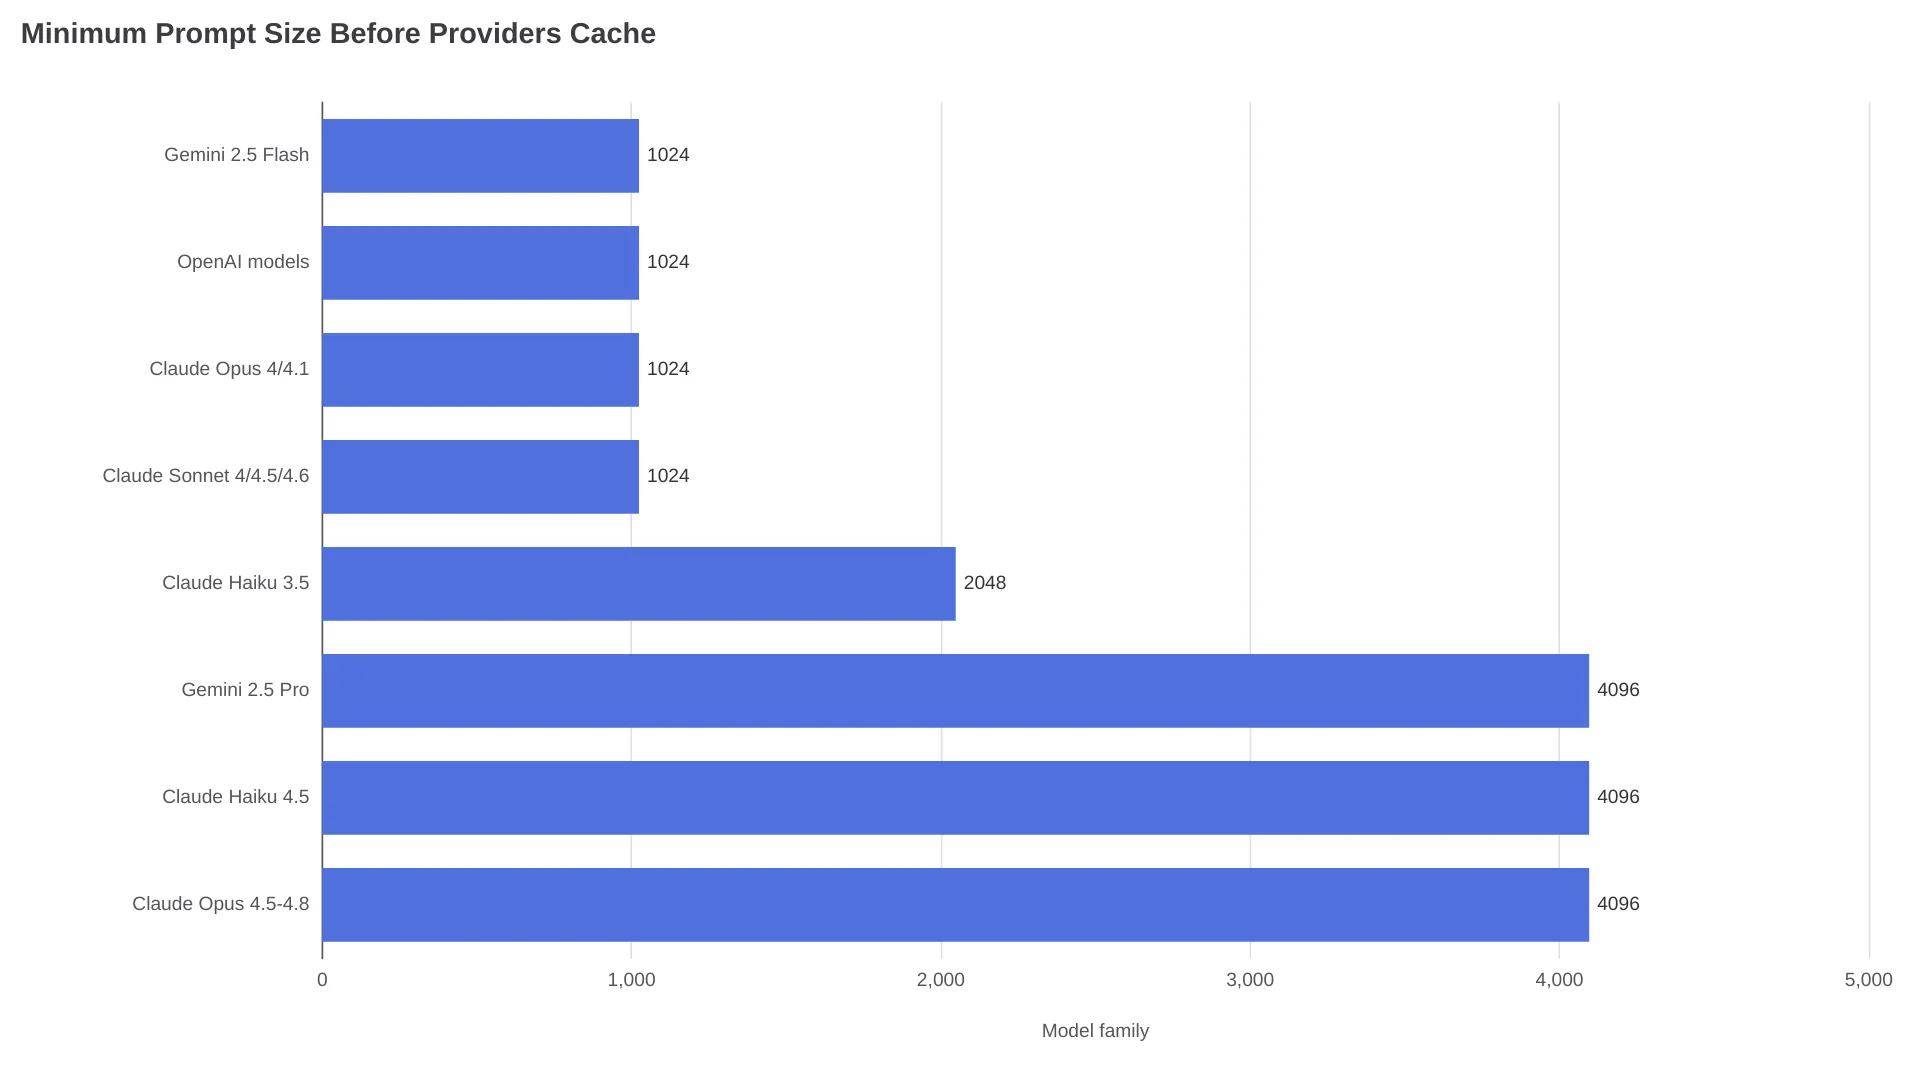
根据 OpenRouter 的提供商说明,Claude Opus 4.5–4.8 和 Haiku 4.5 需要达到 4,096 tokens 才会开始缓存;Sonnet 4/4.5/4.6 与 Opus 4/4.1 的门槛为 1,024;Gemini 2.5 Pro 为 4,096,Gemini 2.5 Flash 为 1,024;OpenAI 模型也从 1,024 开始缓存。对于 Opus 4.8 上的短提示词工作负载,缓存从结构上就不成立。解决办法是将工具 schema、参考文档、few-shot 示例等静态内容整合到同一个前缀中,或者换用门槛更低的模型。
2. 两轮请求之间,缓存已经过期
Anthropic 默认缓存生命周期为 5 分钟,1 小时 TTL 的写入成本则是 2 倍。Gemini 的隐式缓存约保留 3–5 分钟,而且根据 OpenRouter 的教程,读取缓存不会重置计时器。用于维持同一提供商的粘性会话,也会在 10 分钟无活动后失效。对于两次调用之间要思考 5–6 分钟的 Agent 循环来说,这些窗口都会被轻易耗尽:
“OpenRouter 很适合测试模型,但对生产环境 Agent 来说,悄悄地变得很糟糕。肮脏的秘密是:真实工作负载中的缓存几乎为零。”—— @ran_cohenn,描述了间隔 5–6 分钟的 Agent 请求如何让粘性亲和失效,并遭遇完整缓存未命中与昂贵的缓存写入
只要会话能在一小时内继续,Anthropic 的 1 小时 TTL、2 倍写入成本,仍优于每五分钟重新支付一次 1.25 倍写入费。但如果用户每隔二十分钟才操作一次,所有可选 TTL 都无法覆盖这种间隔,缓存只能在短时间密集交互的一组轮次中发挥作用。
3. 提示词前缀被悄悄改掉了
OpenRouter 默认会用第一条 system 消息和第一条非 system 消息的哈希值生成对话键。因此,只要提示词开头发生变化,缓存就会从变化处开始失效。常见元凶包括:把 RAG 上下文插到 system prompt 前面、在首条消息中写入时间戳或请求 ID、每次调用都重写工具定义,以及前端聊天应用在历史消息中间插入新内容。
“如果提示词开头的内容持续变化,缓存未命中率就会升高。”—— u/Exact_Law_6489
有时,改动来自你根本没写过的工具。“我发现 Claude Code 导致了我的缓存命中问题,我认为是它注入工具的方式造成的。”u/askchris 如此反馈。Gemini 还有两个额外陷阱:OpenRouter 只会采用你发送的最后一个 cache_control 断点;同时 system instruction 会被视为不可变的缓存内容,动态信息必须放到后续 user 消息里,不能接在 system prompt 后面。所有场景下的修复原则都一样:静态系统提示词、工具 schema 和参考文档放在前面;每次请求变化的内容放在最后。
4. 请求落到了没有缓存的提供商
OpenRouter 会在 70 多家提供商之间路由(依据其官方教程),而 prompt cache 只存在于最初写入它的端点上。粘性路由会将后续请求送回已有缓存的提供商,但前提是该提供商的缓存读取成本低于普通输入价格;同时,手动设置 provider.order 会完全覆盖粘性策略。提供商发生错误时,固定关系也会被释放。
社区数据很直观地展示了这个问题:
- @bruceforai 对比了不同提供商上的同一个模型名称,发现缓存命中率从 95.3% 一路降到 0%,而部分第三方的缓存价格是官方价格的 10 倍。
- @Bryan_1269 通过 OpenRouter 调用 GLM 5.2 时命中率极低,但用完全相同的提示词直连 Fireworks,命中率达到 85%+。
- @miolini 对经由 OpenRouter 的路由评价道:“缓存命中率非常差,低于 1%。”
OpenRouter 的官方说法是,固定机制确实有效:“当模型或提供商为你命中缓存后,在缓存过期前,你会一直被固定到它。”(@OpenRouter)这与文档描述一致,也意味着真正需要管理的是不同提供商之间的差异,而非固定机制本身。
cache_control 应该放在哪里,哪些环节会把它丢掉
OpenRouter 上的 Anthropic 模型有两种缓存模式:第一种是在顶层放置一个 cache_control 对象,它会随着对话增长自动向后推进,适合多轮聊天,也是 OpenRouter 推荐的做法;第二种是在单独的内容块上设置显式断点,最多四个,适用于工具 schema、RAG 文档、CSV 数据或角色卡等大型固定内容。顶层写法可用于 Anthropic 原生、Vertex、Azure 和 Bedrock;对于不接受顶层字段的 Bedrock API,OpenRouter 会将它转换为末尾断点。若要显式设置 TTL,必须使用 Chat Completions 或 Anthropic Messages API,不能使用 Responses。
{
  "role": "system",
  "content": [
    {
      "type": "text",
      "text": "<20k tokens 的工具 schema 和参考文档>",
      "cache_control": { "type": "ephemeral", "ttl": "1h" }
    }
  ]
}
OpenAI 的方式不同:从 1,024 tokens 起自动缓存;显式的 prompt_cache_breakpoint 标记仅适用于 GPT-5.6 及更新版本,应设置在 input_text 或 text 内容块上。如果请求 TTL,最短为 30 分钟。
根据 提供商说明,OpenRouter 会在不同方言之间转换:Anthropic 的 cache_control 标记会变成 OpenAI 断点;OpenAI 断点会变成 Anthropic 默认 5 分钟标记;但 TTL 值不会被转换。Qwen 必须使用显式 cache_control 标记,缓存时长为 5 分钟,且只支持特定模型,例如 qwen3-max、qwen-plus、qwen3-coder-plus 等;qwen3.5-plus-02-15 这样的快照版本不在支持范围内。
还有一种更隐蔽的失效方式:应用和 OpenRouter 之间的某些客户端或网关,会在转发前剥离非标准字段:
“在网关之后,anthropic prompt caching 降到零,通常是一个编组 bug。……
cache_control标记在转发到 openrouter 前被悄悄剥掉。你不能通过丢弃提供商的 schema 扩展来抽象提供商。”—— @SiddharthInk_
必须确认标记实际到达了 OpenRouter:检查 Activity generation 详情中的原始请求元数据,或者用 curl 发送一条中间没有任何组件干预的测试请求。某些工具会把多条消息压平成一个文本块,这会直接摧毁缓存断点,无论你原本放得多正确。OpenRouter 的 examples repo 提供了可运行的 TypeScript、Vercel AI SDK 和 Effect 示例,能够完整保留这些标记。
固定提供商:session_id 与 provider order
稳定的会话标识是最强的路由控制手段:session_id 会从第一条成功请求起,将后续请求固定到首次响应的提供商,甚至发生首次缓存命中之前也会生效。如果不传它,粘性只有在系统检测到第一次缓存命中后才开始;而默认身份是第一条 system 消息与第一条非 system 消息的哈希,前缀一旦变化,就会被静默重置,也就是前文的第三类故障。详细规则见 OpenRouter 的路由文档。
{
  "model": "anthropic/claude-sonnet-4.6",
  "session_id": "user-8801-thread-3",
  "messages": [ ... ]
}还有几点实现细节值得注意:session_id 可放在请求体中,也可通过 x-session-id 请求头传递;如果两者同时存在,以请求体为准。它最长为 256 个字符;如果两者都未提供,OpenRouter 会回退使用 OpenAI 风格的 prompt_cache_key。
文档还列出了两个限制:提供商出错会解除固定;Batch API 的各行会并发且乱序执行,因此某一行写入的缓存对下一行不可见。解决方式是让批处理共享一个 "ttl": "1h" 前缀,或者先发一条同步请求来预热缓存。(关于 Auto Router 对已解析模型的尽力复用,可参阅自动路由指南。)
如果只靠固定还不够,可以直接限制允许使用的提供商:
“我找到的解决方案,是设置一个按优先级排序的首选提供商列表。”—— u/nabil9506
将 provider.order 设为两到三家缓存读取便宜的提供商,是以更小的故障转移范围换取更好的缓存本地性;对于 Agent 工作负载,这是合理的取舍。u/welcome_to_milliways 将这种手动配置负担称为“OR 一个相当根本的缺陷”;是否认同另说,但这就是当前的使用规则。
哪些情况下,经由路由器做缓存不划算
在三类明确场景下,通过 OpenRouter 使用 prompt caching 会失去经济性:提示词始终达不到模型的 token 门槛;会话间隔长于所有可用 TTL;或者一次性请求没有后续的折扣读取来摊销写入溢价。还有第四类:你无法修改的工具会在 cache_control 到达路由器前将其剥离。@grapeot 点出了其中的成本影响:如果缓存卡在网关层,价格差距可能达到一个数量级,远远超过路由费用本身。
对于高度依赖缓存、且上述问题都无法修复的工作负载,固定单一上游通常比路由器更合适:缓存行为可预测,也无需管理固定关系。当提供商漂移无法消除时,使用 Anthropic 自身缓存的直连 Claude API endpoint,就是最直接的替代方案。
账户级 Zero Data Retention 会完全禁用 response caching;至于 ZDR 下的 prompt caching,可参考 OpenRouter 关于隐式缓存是否构成数据保留的分析。
推荐的排查顺序
按测量优先的顺序排查,能以最小改动找回大部分节省空间:先确认数据,再从提示词、路由到 TTL 逐层检查。
| # | 操作 | 能确认什么 |
|---|---|---|
| 1 | 查看几条真实请求中的 cached_tokens 和 cache_discount | 判断是命中率问题,还是价格预期问题 |
| 2 | 将提示词长度与模型 token 门槛对比 | 优先排除“永远无法缓存”的情况 |
| 3 | 固定前缀:静态 system prompt、schema、文档在前;时间戳和 RAG 在后 | 消除静默失效这一类问题 |
| 4 | 对同一对话中的每个请求都传入 session_id | 从第一轮就固定提供商,而不是等首次命中后 |
| 5 | 将 provider.order 设为两到三家缓存读取便宜的提供商 | 消除跨提供商漂移 |
| 6 | 添加 "ttl": "1h"(Anthropic),或为长会话切换至写入免费的提供商 | 应对轮次之间的缓存过期 |
步骤 1–3 用于清除代码层面可控的故障;步骤 4–6 则解释了为何有人报告命中率不足 1%,而 OpenRouter 的全平台数字却是 82.8%。延伸阅读:了解缓存 token 如何进入账单,可查看 OpenRouter 定价指南;了解模型固定行为,可查看自动路由指南;若要长期监控命中率,则可参考Activity 仪表盘指南。