 AIREITER
2026 年 8 月 17 日,OpenRouter 披露了一起颇具警示意义的内部案例:他们的某个 preview 模型一直在悄悄消耗成本,每月约 6.2K 美元,约为组织综合费率的 25 倍;其中 98% 的费用都来自一个批处理流水线 API 密钥。当天上线的 Activity 活动面板,就是为了让这类问题从几个月后才被发现,变成几分钟内就能定位。面板本身已经相当实用:支出、Token 数、缓存命中率和逐请求明细集中在一个页面里。底层的 beta Analytics API 则没那么成熟,下面会把它的使用方式和边界一次讲清楚。
一笔 6.2K 美元的教训:Activity 面板能抓住什么
发布公告中的内部案例,完整展示了这套工具要解决的问题。某个 preview 模型一个月处理了 2.5 亿 Token,产生 6,185 美元费用,折合每百万 Token 约 24.7 美元,缓存命中率只有 7.6%。按 API 密钥继续下钻后发现,其中一个名为 batch-pipeline 的密钥就占了 6,067 美元,对应 1.27 亿 Token 和 37,000 次请求——对于高吞吐、低复杂度的批处理任务来说,相当于每百万 Token 约 48 美元。最后的修复只需要改一行代码,换掉模型即可(成本控制 Cookbook 中有完整拆解)。
与面板一同推出的功能还包括:支持自定义查询的 Explore、用于发现变化的 Trends、用于查看提示词注入和敏感数据事件的 Guardrails、逐请求日志、beta Analytics API,以及 GitHub 上供编程代理安装的 openrouter-analytics skill。
Activity 的每个标签页,分别回答什么问题
OpenRouter Activity 面板不是按菜单组织,而是围绕问题来设计的。真正承担成本分析工作的主要有三个标签页,每个标签页关注的重点不同。
Overview:这段时间花了多少钱?
Overview 首先展示 5 个核心指标:总支出、请求数、Token 总量、缓存命中率,以及每百万 Token 的综合成本。每项指标都配有迷你趋势图和上一周期对比。往下看,还能看到使用量最高的用户和应用、按模型拆分的支出、OpenRouter 余额与预估 BYOK 支出的比例,以及提示词 Token 和补全 Token 的数量。如果你只想知道“到底花了多少钱”,这个页面就是起点。
Trends:相比上一周期,哪里发生了变化?
Trends 关注的是变化幅度,而不是绝对规模,会按模型、用户、API 密钥和应用排列变化情况。它适合用来发现失控的代理、新近走红的模型,或者某个突然从实验工具变成默认方案的内部应用。Overview 告诉你哪里贵,Trends 则告诉你哪里刚刚开始变贵。
Explore:我想自己拆开数据看,怎么查?
Explore 本质上是一个查询构建器。可选指标包括支出、请求数、多种 Token 分类、缓存命中率、每百万 Token 综合成本、BYOK 与余额支出,还包括 P50/P90/P99 延迟和吞吐量。
分组最多同时使用两个维度,可选项包括模型、提供商、API 密钥、应用、用户、工作区、国家、地区、上下文长度、会话、生成任务、自定义 ID 和分类器。时间聚合粒度从分钟到月份,图表支持柱状图、折线图和点图,任何图表都可以保存为个人可见或组织可见。需要注意两点:第三个分组维度会直接被拒绝;日志中的提示词和补全内容,只有在请求发起之前就启用了私有输入/输出日志,才会显示。
不用碰 API,也能导出 CSV 或 PDF
财务人员和表格用户不需要调用 API。Activity 页面可以直接把相同的聚合数据导出为摘要报告或详细报告,支持两种格式,全程无需写代码。官方的导出流程只有 5 步:
- 打开 Activity 页面。
- 选择时间范围和分组方式(模型、API 密钥或创建者)。
- 打开右上角的选项菜单。
- 选择 Export to…。
- 选择 CSV 或 PDF。
默认导出的是摘要报告,会同时包含支出、Token 和请求数。想要详细报告,需要先打开某个具体指标卡片,再执行导出;详细版本会按照你选择的分组,进一步拆解该指标。时间范围会自动决定子区间:
| 时间筛选 | 子区间 |
|---|---|
| 1 Hour | 按分钟 |
| 1 Day | 按小时 |
| 1 Month | 按天 |
| 1 Year | 按月 |
文档里还有两个容易被忽略的细节:报告中的 BYOK 支出只是按照提供商市场价格计算的预估值,不包含提供商专属折扣,因此可能与实际外部账单不同。推理 Token 已计入补全 Token,但会单独报告,所以账单中的“思考”部分既能看见,也不会被重复计算。
5 分钟跑通第一个 Analytics API 查询
Analytics API 通过两个端点,提供 Explore 使用的同一套数据。不过它明确处于 beta 阶段,所以正确的使用顺序应该是先发现能力,再写查询。
先过管理密钥这一关
Analytics 端点要求使用管理密钥,普通推理密钥会返回 HTTP 403。反过来也一样——根据 成本控制 Cookbook 的说明,管理密钥不能发起模型请求。这样即使密钥泄露,影响范围也会小一些,但它仍然能暴露组织完整的支出明细。Cookbook 的建议很直接:把它当作任何其他凭据一样保护。
先查 Meta,再发起查询
GET /api/v1/analytics/meta 会返回当前支持的指标、维度、筛选操作符和时间粒度。由于 beta 支持范围可能变化,每次运行自动化任务前都应该先查询它。真正执行分析的是 POST /api/v1/analytics/query。文档中的 cURL 示例:
curl -X POST https://openrouter.ai/api/v1/analytics/query \
  -H "Authorization: Bearer <management-key>" \
  -H "Content-Type: application/json" \
  -d '{
    "metrics": ["request_count"],
    "dimensions": ["model"],
    "granularity": "day",
    "limit": 100,
    "time_range": {
      "start": "2026-08-01T00:00:00Z",
      "end": "2026-08-08T00:00:00Z"
    }
  }'
响应会把数据行嵌套在 data.data 中,并附带 metadata 区块,其中包括 query_time_ms、row_count 和 truncated。Cookbook 中记录的示例查询,单行结果耗时 17 ms,因此这类调用本身很轻量;整个流程被描述为只读操作,除现有使用成本外不额外收费。文档列出的失败状态包括 400(查询错误)、401(未认证)、403(密钥类型错误)、408 和 500。
4 个用来揪出超支的查询
官方 Cookbook 提供了 5 个配方。把它们重新编排后,可以形成一套可重复执行的成本排查流程。
1. 哪个模型最烧钱? Cookbook 的第一个查询会按 model 分组,获取 total_usage、request_count、tokens_total 和 cache_hit_rate,再按支出从高到低排序:
{
  "metrics": ["total_usage", "request_count", "tokens_total", "cache_hit_rate"],
  "dimensions": ["model"],
  "order_by": { "metric": "total_usage", "direction": "desc" },
  "limit": 10,
  "time_range": { "start": "2026-07-01T00:00:00Z", "end": "2026-08-01T00:00:00Z" }
}
最值得计算的派生指标是每百万 Token 的实际成本:total_usage / tokens_total × 1e6。把它与组织综合费率比较——也就是不指定维度时用同一公式算出的结果——就能用上 Cookbook 中的经验判断:某个模型的价格如果达到综合费率的较大倍数,优先排查它最划算。那个 25 倍的 preview 模型异常,就是这样被发现的。
2. 哪个 API 密钥在制造问题? 针对准确的模型 slug 添加筛选条件,再按 api_key_id 分组。结果中会把 ID 解析为人类可读的名称,因此才能看到 batch-pipeline 这个密钥占用了问题金额中的 6,067 美元。分组时应使用 api_key_id,不要按解析后的密钥名称筛选;同时利用返回的 user_email,将支出与内部记录核对起来。
3. 这些钱具体买了什么? 把每天的支出拆成以下组成部分:
| 指标 | 含义 |
|---|---|
usage_upstream | 原始推理成本 |
usage_cache | 缓存节省金额(或写入缓存的成本) |
usage_data | 折扣,通常为负数 |
usage_web | 网页搜索附加费 |
usage_file | 文件处理附加费 |
提示词与补全比例如果接近 20:1,通常说明上下文过大;推理 Token 占比很高,则意味着你可能在为并不需要的思考过程付费。最适合优化缓存的,是提示词占比高但缓存命中率低的流量;如果缓存命中率已经很高,就该转而检查模型组合。提示词偏重其实是常态,不是异常:一项对 OpenRouter 公开编程类别数据的分析显示,其中 93.4% 的 Token 都是输入 Token。
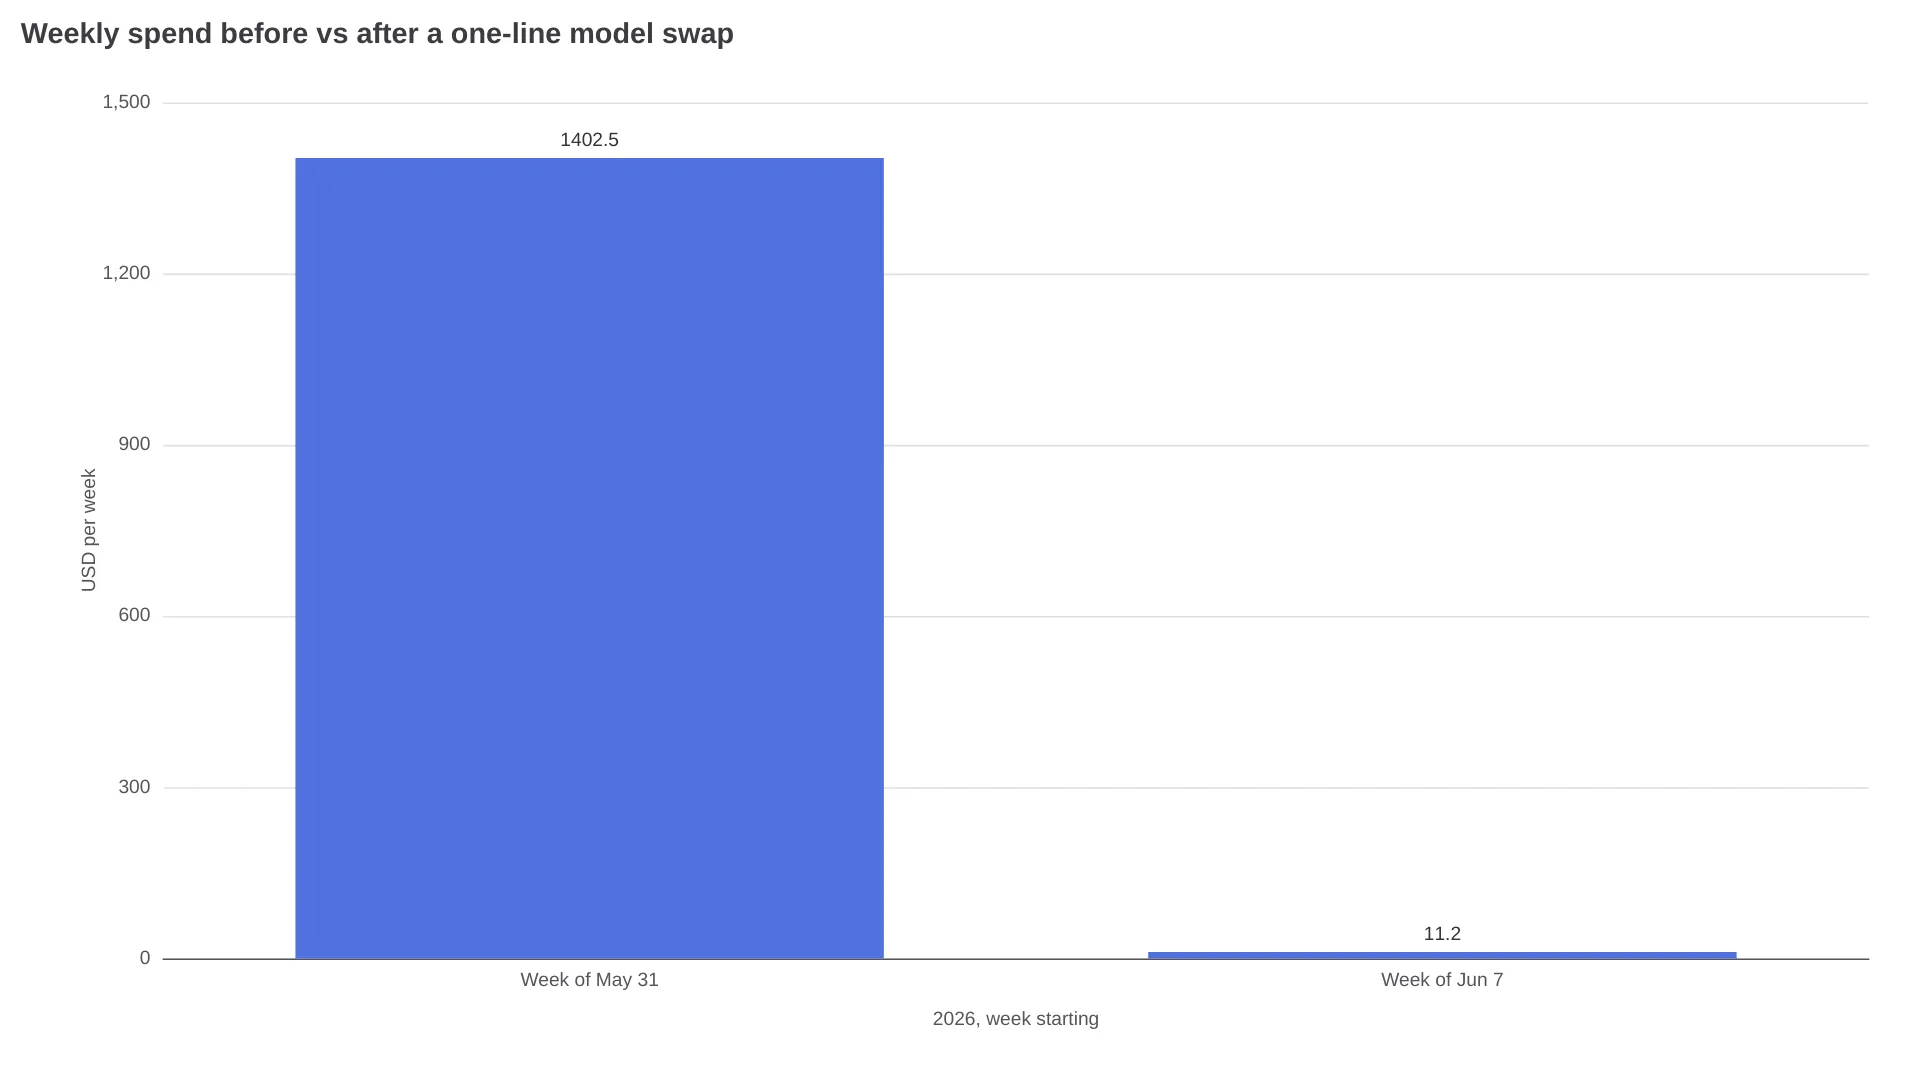
4. 修复真的生效了吗? 将查询 1 改成按周排列的时间序列,并按 api_key_id 分组。在官方示例中,batch-pipeline 密钥的周支出从 5 月 31 日当周的 1,402.50 美元降到了 6 月 7 日当周的 11.20 美元。模型切换成功时,图表应该像断崖一样下降,而不是缓慢下滑。
如果查询 1 的下一步是换用更便宜的模型,最终就会涉及 OpenRouter 自己的路由层。自动路由和固定路由各自的取舍,可以参考我们的 OpenRouter 自动路由指南。
文档没有完全说清的 6 个 beta 陷阱
查询写对之后,API 基本会按文档工作;下面这些失败模式其实也有记录,只是散落在 Cookbook 的脚注里。
- 三个维度会返回 400。 上限是两个;如果要查询
model × key × day,就得拆成多次查询,或者调整时间粒度。 group_limit可能让时间桶悄悄被截断。 不设置时,OpenRouter 会自动计算一个安全值;设置得太低,时间序列中的几周数据就可能消失。如果没有指定维度,它会被完全忽略。- 计数类指标有时会以字符串返回。 参考文档展示的是数字,但 API 也可能返回字符串,解析时要兼容两种类型。
- 时间序列的列名并不固定。 根据查询结构不同,同一个时间桶可能叫
date__day,也可能叫created_at__day。 - 未使用的成本组成部分返回的是
null,不是 0。 任何聚合脚本都应该先做空值检查。 metadata.truncated: true表示总数不完整。 提高limit(默认值为 1,000),或者缩小时间范围后重新查询。
该用面板、API,还是自己搭流水线?
原生工具足以应付账户层面的分析需求。只有超出这个范围,自建系统才真正值得投入:
| 你的需求 | 适合使用 |
|---|---|
| 快速查看支出、Token 和缓存命中率 | Activity Overview |
| 了解哪里发生变化、哪里正在飙升 | Trends |
| 临时切分数据并分享 | Explore + CSV/PDF 导出 |
| 定期报告、告警、内部数据面板 | Analytics API |
| 多提供商聚合、按用户设定预算、自定义异常检测 | 基于使用日志和 Webhook 的自定义流水线 |
自己搭建成本追踪系统并不罕见。一位 r/FinOps 用户写道:
“因为某个模型的价格一夜之间从几美分涨到 3 欧元,所以我在 Obsidian 里自己做了一个 AI 成本追踪器。”
这条讨论和 r/openrouter 上那篇“长上下文定价应该更透明”,其实指向同一个根源:路由、缓存、推理 Token 和长上下文定价,都会让本地估算逐渐偏离最终账单。Activity 面板记录的使用量才是权威数字;如果你选择自建系统,就应该拿它来对账,而不是只依赖自己维护的价格表。
还有一种更轻量的归因方法,来自一位使用该平台 6 个月的开发者:给请求加上 X-Title 请求头,这样每个应用或实验项目都会以自己的名称出现在 Activity 中。如果你的支出已经分散到多个提供商,而不是集中在一个路由器上,那么统一 API 方案(包括 AIReiter)可以在问题变复杂之前,先把聚合工作统一起来。
常见问题
使用 Activity 面板需要管理密钥吗?
不需要。面板在普通账户登录状态下即可使用;只有调用 Analytics API 端点(/api/v1/analytics/meta 和 /api/v1/analytics/query)时才需要管理密钥。
调用 OpenRouter Analytics API 要收费吗?
Cookbook 将 Analytics 的使用方式描述为只读且免费:你查询的是自己的使用记录,而不是按调用次数付费。当然,记录所对应的推理请求仍然需要付费。
OpenRouter 的 Activity 数据能追溯多久?
旧版 /api/v1/activity 端点覆盖此前 30 个已完成的 UTC 日期。新版 Analytics API 的文档没有说明保留期限(示例查询覆盖了一个月),因此长期历史数据的可用性仍未得到确认。需要长期保存的数据,建议导出 CSV。
为什么我在 Activity 日志里看不到提示词和回复?
只有在请求发起时就启用了私有输入/输出日志,才会保存提示词和补全内容——公告明确说明,如果此前没有启用,历史提示词内容无法找回。总量数据会被记录,但具体内容需要主动选择记录。
别忘了给这个取舍定价
上面介绍的功能现在都可以使用,仅查询 1 就足以证明花 5 分钟完成设置是值得的。真正需要留意的是变化风险:这是一个明确标注为 beta 的功能,支持的指标和维度可能会改变,OpenRouter 也要求自动化任务在信任 schema 之前重新读取 /meta。与其把字段名称硬编码进定时任务,不如在任务中加入 Meta 检查,这样即使 API 还在成长,面板带来的可见性也不会轻易失效。
相关阅读: OpenRouter 自动路由指南 · 适合编程的最佳免费 OpenRouter 模型 · OpenRouter 定价指南