 AIREITER
12 月 2 日调用 gemini-2.5-pro 不一定会报错,但返回结果的模型已经变了。Google 于 2026 年 11 月 2 日弃用了 gemini-2.5-pro 和 gemini-2.5-flash,从 2026 年 12 月 1 日起,Gemini Developer API 会将这两个 ID 自动路由到 gemini-3.8-flash 和 gemini-3.5-flash-lite,并按替代模型的价格计费。问题在于,这不只是换个模型名称,而是连模型层级和请求参数都发生了变化。继续依赖旧字符串,反而是更冒险的做法。
Google 对 12 月 1 日的具体安排
Google 已在 Gemini Developer API 中弃用 gemini-2.5-pro 和 gemini-2.5-flash。这两个标识符已经从 Google AI Studio 的模型选择器中消失,只有过去使用过对应模型的开发者仍可访问 API。从 2026 年 12 月 1 日开始,请求仍会成功,但实际运行的模型和计费价格都会改变。
具体映射关系来自 Google 的 Gemini API 弃用说明页面:
| 调用的旧 ID | 2026 年 12 月 1 日起实际响应的模型 | 12 月 1 日起的计费方式 |
|---|---|---|
gemini-2.5-pro | gemini-3.8-flash | Gemini 3.8 Flash 价格 |
gemini-2.5-flash | gemini-3.5-flash-lite | Gemini 3.5 Flash-Lite 价格 |
gemini-2.5-flash-lite | 保持不变,不会自动路由 | 保持不变 |
Google 将 2026 年 12 月 1 日列为两个稳定版 ID 的路由切换日期,通知则发布在 2026 年 11 月 2 日的 更新日志中。Google DeepMind 员工 Patrick Loeber 在 PSA 中给出了链接,并提醒使用高级集成的开发者需要按照迁移指南进行调整。
这项通知只涉及 Gemini Developer API 和 AI Studio。Vertex AI 使用的是独立的退役时间表,Google Cloud 为相同模型名称列出了 2026 年 10 月的日期;Firebase AI Logic 也维护着自己的支持模型列表。Vertex 用户应直接查看Cloud 控制台,不要默认认为 12 月 1 日适用于所有平台。
Google 曾在 9 月 18 日表示 2.5“尚未弃用”,随后又在 11 月 2 日宣布弃用。因此,12 月 1 日应按确定日期来准备。相关反复过程可查看更新日志历史。
自动切换后,12 月和明年 1 月要花多少钱
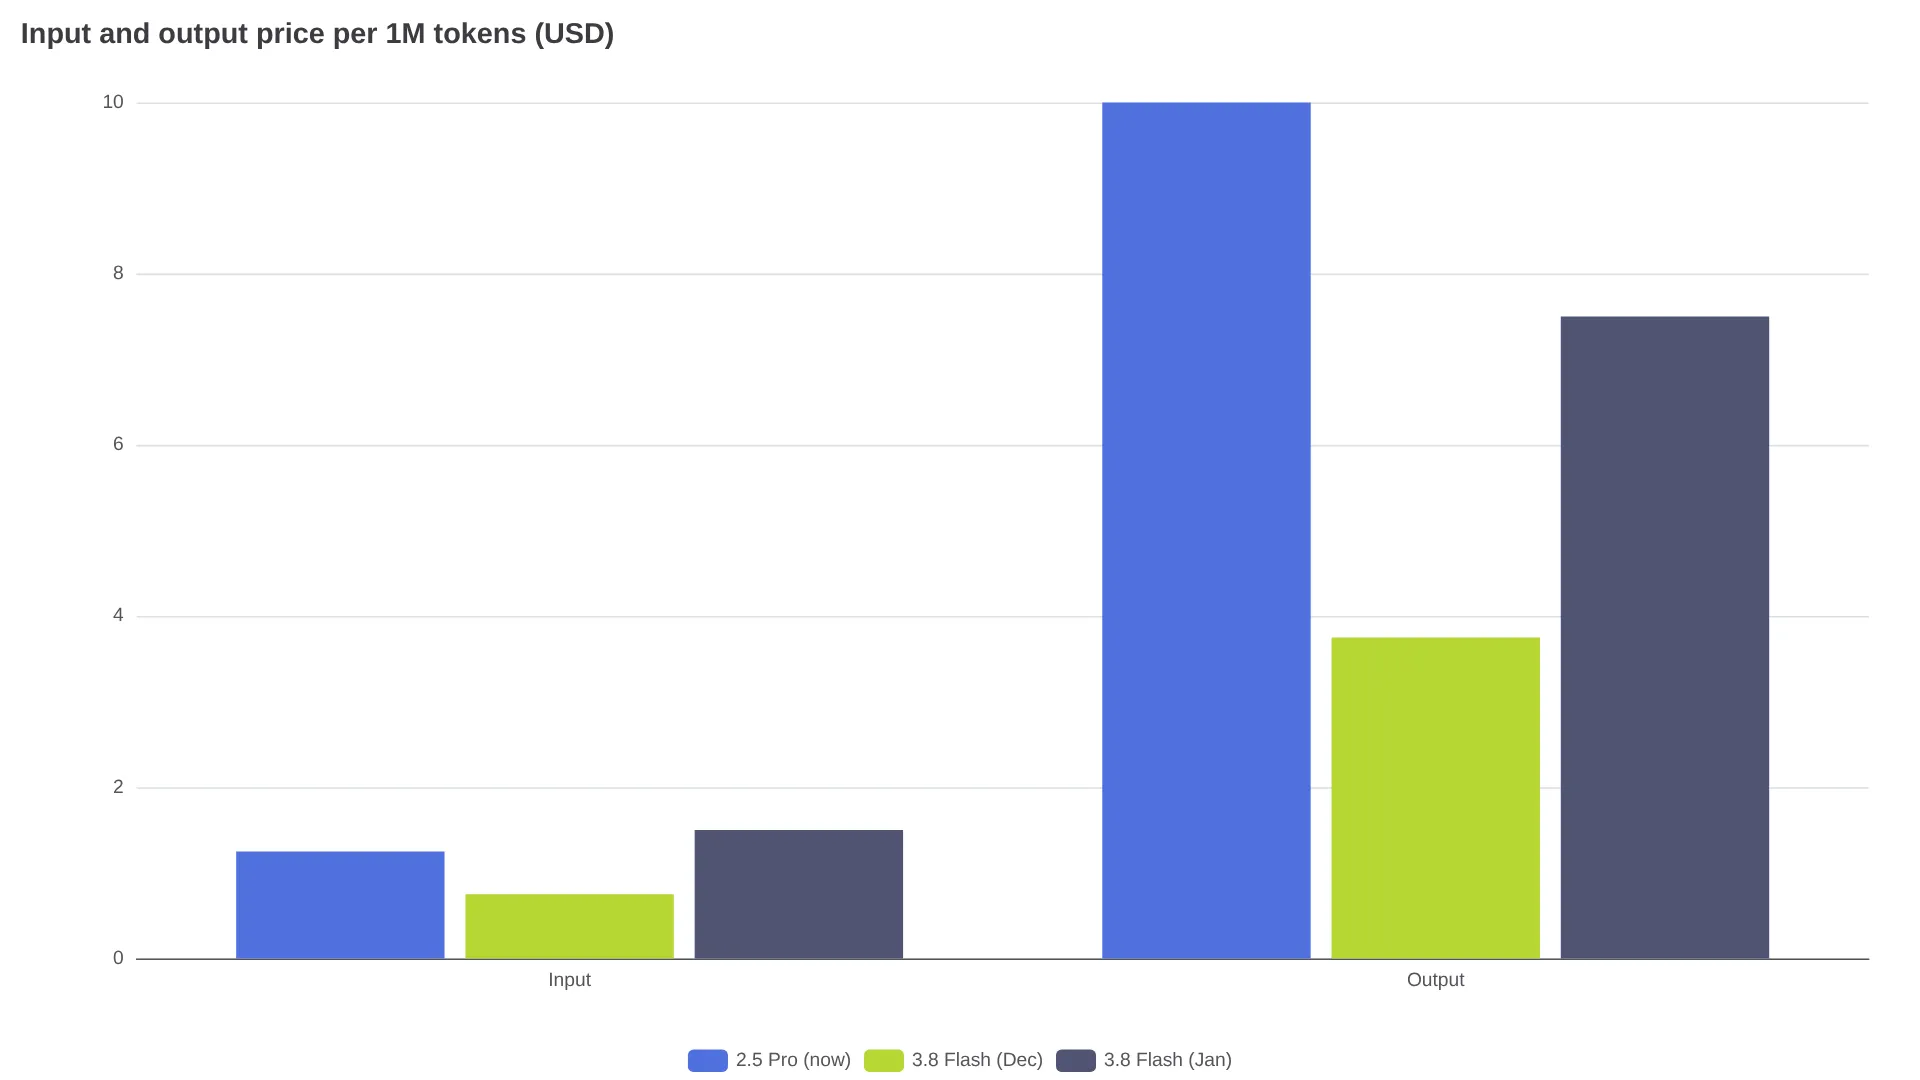
Gemini 2.5 Pro 流量在 12 月会变便宜,但到了 1 月,输入价格又会上涨。Gemini 2.5 Flash 的文本流量切换后价格不变,音频输入则会明显降价。以下均为 Google Gemini API 价格页面截至 2026 年 11 月 3 日所列的付费层级价格,单位为每 1M tokens。模型层面的详细背景,可参考 Gemini 3.8 Flash 价格分析和 Gemini 3.5 Flash-Lite。
| 模型与时间段 | 输入 / 1M | 输出(含思考) / 1M |
|---|---|---|
gemini-2.5-pro,提示词 ≤200k tokens,11 月 30 日前 | $1.25 | $10.00 |
gemini-2.5-pro,提示词 >200k tokens,11 月 30 日前 | $2.50 | $15.00 |
gemini-3.8-flash,2026 年 12 月 1 日至 31 日 | $0.75 | $3.75 |
gemini-3.8-flash,2027 年 1 月 1 日起 | $1.50 | $7.50 |
Gemini 3.8 Flash 不再按提示词长度分不同价格档位,因此超过 200,000 tokens 的长上下文任务降价幅度最大。以 300k 输入、4k 输出的长文档提示为例,按 $2.50/$15.00 计算,Gemini 2.5 Pro 的成本约为 $0.81;按 12 月的 $0.75/$3.75 计算,Gemini 3.8 Flash 约为 $0.24;按 1 月的 $1.50/$7.50 计算,则约为 $0.48。到了 1 月,只有短提示词、输入占比较高的聊天场景,账单才会接近原来的水平。
Flash 的变化相对简单:
| 模型 | 文本/图片/视频输入 | 音频输入 | 输出 |
|---|---|---|---|
gemini-2.5-flash,11 月 30 日前 | $0.30 | $1.00 | $2.50 |
gemini-3.5-flash-lite,12 月 1 日起 | $0.30 | $0.30 | $2.50 |
上下文缓存、批处理和优先级服务也遵循同样的规律:文本价格延续原有水平,音频价格下降。预算时还要注意一点:思考 tokens 会按输出计费,而替代模型在长任务中可能生成不同数量的思考 tokens,因此不能简单假设输出数量相同。锁定预算前,最好先比较真实流量中的 usage_metadata。
为什么模型字符串不变,代码仍可能出问题
自动路由会保留 HTTP 200 状态,但底层运行时已经换了。Gemini 3.x 对请求规则的要求比 Gemini 2.5 更严格,因此即使代码完全没有改动模型名称,12 月 1 日之后也可能报错,或者在不知不觉中改变行为。
Gemini 3.x 用 thinking_level取代了 thinking_budget。Gemini 3.8 Flash 接受 low、medium 和 high,但会拒绝 minimal;Gemini 3.5 Flash-Lite 的默认值则是 minimal。同时发送两个字段会返回 HTTP 400,而在两个替代模型之间共用一个 minimal 配置,也会让 3.8 Flash 路径出错。Google 建议在提取、路由和分类任务中使用 minimal;对于子代理、工具调用、代码执行和多步推理,则使用 medium 或 high,以免工具调用过早终止。
根据 Gemini 3 迁移指南,采样和历史记录控制也发生了变化。Gemini 3.x 目前会忽略 temperature、top_p 和 top_k,预计未来版本会对这些参数返回 HTTP 400。candidate_count 不受支持。如果请求最后一个非空轮次的角色是 model,也就是使用以 Translation: 结尾的经典预填充技巧,请求会返回 HTTP 400。Google 建议改用 system_instruction 和结构化输出。
函数调用的校验也更严格。Gemini 3.x 会验证 thought_signature,并要求每个 FunctionResponse 都携带匹配的调用 ID 和名称。如果丢弃签名,或重新构造模型轮次时没有保留签名,最终可能得到空的 STOP 响应或 MISSING_THOUGHT_SIGNATURE 结束状态,而不是清晰的错误提示。因此,回归测试不能只检查有没有抛出异常,还要断言响应文本。
公告发布后的几个小时内,真实用户就遇到了这种问题:
Google 刚刚给 Gemini 2.5 的终点定了日期,但真正需要注意的并不是弃用,而是自动路由。……所以你的代码不会抛出 404,而是会悄悄换一个模型回答。—— @VarunChopr17597
如果你的代理还在调用 gemini-2.5-flash,那么从 12 月 1 日起,它会运行在 Gemini 3.5 Flash-Lite 上,而该模型默认使用 minimal thinking。—— @MarMarLabs
11 月完成迁移:7 步检查清单
最稳妥的做法,是在 11 月明确替换模型 ID 并同步调整参数,然后与 12 月的替代模型进行并行评估。不要把自动路由当成迁移方案。
- 找出所有引用,包括预览版别名。搜索代码、配置、评测工具和文档中的两个受影响 ID,同时排除不受影响的 Lite 模型:
grep -rnE 'gemini-2\.5-(pro|flash)([^-]|$)' .
- 明确替换 ID。在分支中将
gemini-2.5-pro改为gemini-3.8-flash,将gemini-2.5-flash改为gemini-3.5-flash-lite,不要等到 12 月 1 日早上才动手。 - 修正思考配置。用
thinking_level替换thinking_budget,按模型分别设置(3.8 Flash 上的代理使用medium或high;Flash-Lite 工作负载则明确选择minimal、medium或high),不要让 3.8 Flash 共用minimal。 - 移除旧参数。测试前删除
temperature、top_p、top_k、candidate_count,以及预填充的末尾模型轮次。 - 更新 SDK 和工具调用链。升级到当前 SDK,保留包含
thoughtSignature的完整模型轮次,创建同时包含调用 ID 和名称的FunctionResponse,并端到端重新测试多轮工具调用。 - 在替代模型上重新跑基线。使用生产提示词比较质量、延迟、输出长度和
usage_metadata中的 token 数量;Flash 模型不可能在每项任务上都保持 Pro 模型的风格。 - 重新计算两次成本。12 月按 Pro 路由的 $0.75/$3.75 进行预算,1 月起按 $1.50/$7.50 进行预算,同时重新核对 Flash 路由中的音频和缓存费用。
已经使用 Gemini 3.x 或 gemini-2.5-flash-lite 的团队可以跳过这次迁移。其他团队应在 11 月 30 日前完成第 6 步,因为 12 月 1 日测试通过,可能只说明路由器仍能返回结果,并不代表原有行为被保留。
构建代理的开发者还应在为工具密集型工作负载设置思考级别前,阅读 Gemini 3.8 Flash 代理任务价格分析。
常见问题
Gemini 2.5 Pro 会在 2026 年 12 月 1 日关停吗?
不会。Google 将 2026 年 12 月 1 日列为 Gemini Developer API 的路由日期:gemini-2.5-pro 请求会改为路由到 gemini-3.8-flash,而不是返回错误。
自动路由后的请求按旧价格还是新价格计费?
按新价格计费。12 月 1 日之后以 gemini-2.5-pro 发送的请求,会按照 Gemini 3.8 Flash 的价格计费;以 gemini-2.5-flash 发送的请求,则按照 Gemini 3.5 Flash-Lite 的价格计费。
既然会自动路由,还需要改代码吗?
需要。Gemini 3.x 的思考配置、采样参数、预填充轮次和函数调用链都不同。原代码可能遇到参数被忽略、HTTP 400,或者推理行为在不知不觉中发生变化。
12 月 1 日的安排适用于 Vertex AI 吗?
不适用。12 月 1 日是 Gemini Developer API 的日期。Google Cloud 为 Vertex AI 和 Enterprise Agent Platform 上的 Gemini 2.5 分别记录了 2026 年 10 月的退役日期。
Gemini 2.5 Flash-Lite 会受影响吗?
不会。Google 表示 gemini-2.5-flash-lite 尚未弃用,并会继续提供,直到另行通知。
不同工作负载应该选择哪个替代模型?
先根据任务匹配模型,再通过评测确认。不要默认 Flash 模型能完全等同于旧 Pro 模型。
| 当前工作负载 | 明确指定的目标 | 注意事项 |
|---|---|---|
| 通用 Pro 提示词、编程、长文档 | gemini-3.8-flash,使用 medium+ | 这是从 Pro 到 Flash 的层级变化;需要重新评估质量、输出长度和 1 月输入价格 |
| 带工具的代理 | gemini-3.8-flash,使用 medium 或 high | 注意 thought_signature、响应 ID,以及使用 minimal 时过早出现 STOP |
| 分类、提取、路由 | gemini-3.5-flash-lite,使用 minimal | 成本最低;如果加入工具,再提高到 medium |
| 音频转写流水线 | gemini-3.5-flash-lite | 音频输入价格从 $1.00 降至 $0.30;重新核对缓存费用 |
11 月 30 日前该做什么
本周就替换两个模型字符串,修正思考配置和工具调用链,并趁 Gemini 2.5 仍能正常响应时,在替代模型上建立新的基线。12 月的自动路由能让服务继续运行,但只有在 11 月完成迁移,才能真正掌控行为和账单。