 AIREITER
Anthropic 已将 Claude Opus 5.5 定位为付费套餐中知识工作的默认模型。从能力表现看,这个定位大体站得住脚;但实际用户最在意的,往往是另一件事:在 Pro、Max 和 Team 套餐里,额度消耗得比预想快得多。
Opus 5.5 于 2026 年 9 月 22 日发布,是 Claude 5.5 系列的首款模型。Anthropic 表示,它在大多数任务上的表现达到 Claude Fable 5.1 水平,运行成本则比 Opus 5 低 40%(anthropic.com)。到 2026 年 11 月 12 日,Anthropic 在日常主力模型指南中明确了使用建议:研究、分析、写作、报告、表格和演示文稿,先用 Medium 推理强度的 Opus 5.5;只有不够用时再往上加(claude.com)。本文综合官方说明、独立基准测试及用户额度反馈,并非第一方实验室测试。
先说结论:默认用 Opus 5.5,推理强度锁定 Medium
把 Opus 5.5 留在默认位,日常知识工作使用 Medium 推理强度。遇到难题,先提高推理强度而不是立刻换模型;如果更看重速度或吞吐量,再降到 Sonnet 5.5 或 Haiku 5.5。
这不是品牌忠诚问题,而是算账问题。Anthropic 的编程和知识工作评测显示,Medium 强度的 Opus 5.5 能追平甚至超过 High 强度的 Opus 5。Factory 在 Anthropic 日常主力指南中表示,Medium 的表现可匹敌 High 的 Opus 5,同时输出 token 少 20%–25%。而且 Claude 应用和 Claude Code 默认就是 Medium,大多数订阅用户无需调整设置便会得到这一行为。
不过,真正的限制不是 API 标价,而是订阅额度。API 价格为每百万输入 token 4 美元、每百万输出 token 20 美元,低于 Opus 5 的 5 美元/25 美元;缓存读取则是每百万 token 0.20 美元。但根据 Anthropic 的日常主力指南,更高价的模型会更快消耗订阅限额。实际用户也反馈,在高强度会话中,5 小时窗口可能 15–30 分钟就被用完,周额度也比 9 月的“蜜月期”更早耗尽。
11 月默认模型调整后,Pro、Max 和 Team 用户真正要关注什么
对于订阅用户,关键在于新默认模型下的额度机制。尽管下文会提到 10 月下旬已有用户抱怨额度消耗加快,Anthropic 在发布时仍称将提高 Pro、Max、Team 和按席位计费 Enterprise 套餐的 5 小时使用上限,并允许订阅用户保存一次速率限制重置机会(anthropic.com)。Anthropic 的指南还指出,常规 Pro、标准 Team 及按席位计费 Enterprise 套餐通常不能在正常额度内使用 Fable 5.2,除非是在发布优惠期间;Fable 会消耗 usage credits。因此,规划上应把 Opus 当作套餐内的主力,而把 Fable 视为按量计费的例外。
日常主力的底气:研究、分析与写作
经得起逐项核查的研究备忘录
最有说服力的测试之一,是一份带来源的公司业绩报告:其中财报被刻意设置得难以找到,任何虚构数字或引语都会导致整份报告不合格。Opus 5.5 在不同推理强度下完成了 18 份报告中的 16 份;Anthropic 称,Fable 5.1 和 Opus 5 在同一标准下均未有一次通过(claude.com)。Anthropic 发布文章引用的 Walleye Capital 外部测试也提供了更多细节:Opus 5.5 在最低推理强度下就基本完成了整套测试;提高强度后,它还发现了评测器自身指令中的一个索引偏一错误。Walleye 表示,此前测试过的模型都没有发现这一问题。
放到日常使用中,这意味着你可以把目标和交付物说清楚,再附上来源,让它承担开放式研究;之后重点核查数字,而不是逐句审阅文风。
分析能力:表格、并购测算与复杂图表
在一个两家 HR 软件公司虚构合并的案例中,Opus 5 和 Opus 5.5 都完成了 Excel 模型和高管演示文稿,并得出相同的交易结论。Opus 5.5 用时 63 分钟,Opus 5 则为 93 分钟;前者的产出成本据报低 50%,模型更完整,细小错误也更少(claude.com)。更广泛的金融工作流中,Hebbia 报告称,Opus 5.5 的标准覆盖率为 86.6%,Opus 5 为 60.3%;Rogo 则表示,Opus 5.5 在 BigFinance Bench 上胜过 High 强度的 Opus 5,输出 token 约少 60%,以上数据见 Anthropic 的发布文章。
视觉能力也是这套能力的一部分。Anthropic 称 Opus 5.5 是其视觉能力最强的 Opus 模型,适合处理密集文档、图表数值、截图和示意图;并表示即便处在最低推理强度,Opus 5.5 读取复杂图表的准确度也高于最高强度的 Opus 5(claude.com)。公开的 Chartography 成绩为:最高评测设定下,无工具时 64.4%(claude.com);发布评分卡中,使用工具时为 89.0%。GDPval-AA 专业工作 Elo 为 1846,高于 Fable 5.1 的 1735 和 Opus 5 的 1708(anthropic.com)。
实用建议很直接:直接要求它交付完整表格或幻灯片;图表请直接上传图片,不必手工抄录数值;第一条消息就写清楚完成条件。
写作:直接交付成品文档和演示稿
这里所说的写作优势,不是笼统的“文笔更好”,而是更稳定地遵从指令,也更方便审核。Anthropic 表示,Opus 5.5 能保持任务边界、先给结论、减少行话、遵守提供的风格规则,并说明自己做了什么、发现了什么、还需要哪些输入。独立评分的方向也基本一致:Hayz Labs 给 Opus 5.5 的写作和编程均打出 100 分,研究为 94 分;截至其 10 月检查时,该模型在 Arena 的 WebDev 和 agents 项目中排名第一,在创意写作中排名第二。
但也要说清楚:想精确复刻特定的品牌文风,仍然需要反复迭代。
推理强度档位,才是实际价格标签
根据 eesel 对推理强度的拆解,Opus 5.5 有五档推理强度:Low、Medium、High、Very High/Extra High 和 Max;而 Hayz Labs 指出,thinking 无法关闭。与这个档位相比,每 token 的基础价格对总账单影响反而不大。
eesel 汇总的 Artificial Analysis 数据显示,同一项高难度任务在 Low 下约为 0.55 美元,Medium 约为 1.34 美元,Max 则约为 5.98 美元;对应的 Intelligence Index 大约是 42、51 和 58。一次 Max 运行可产生约 119,000 个输出 token,按每百万输出 token 20 美元计算,钱主要就花在这里。Hayz Labs 的帕累托视图也给出相近结论:14 天内每项 agent 任务的中位成本约为 1.61 美元,主表中位数为 1.76 美元,High 约为 1.82 美元。
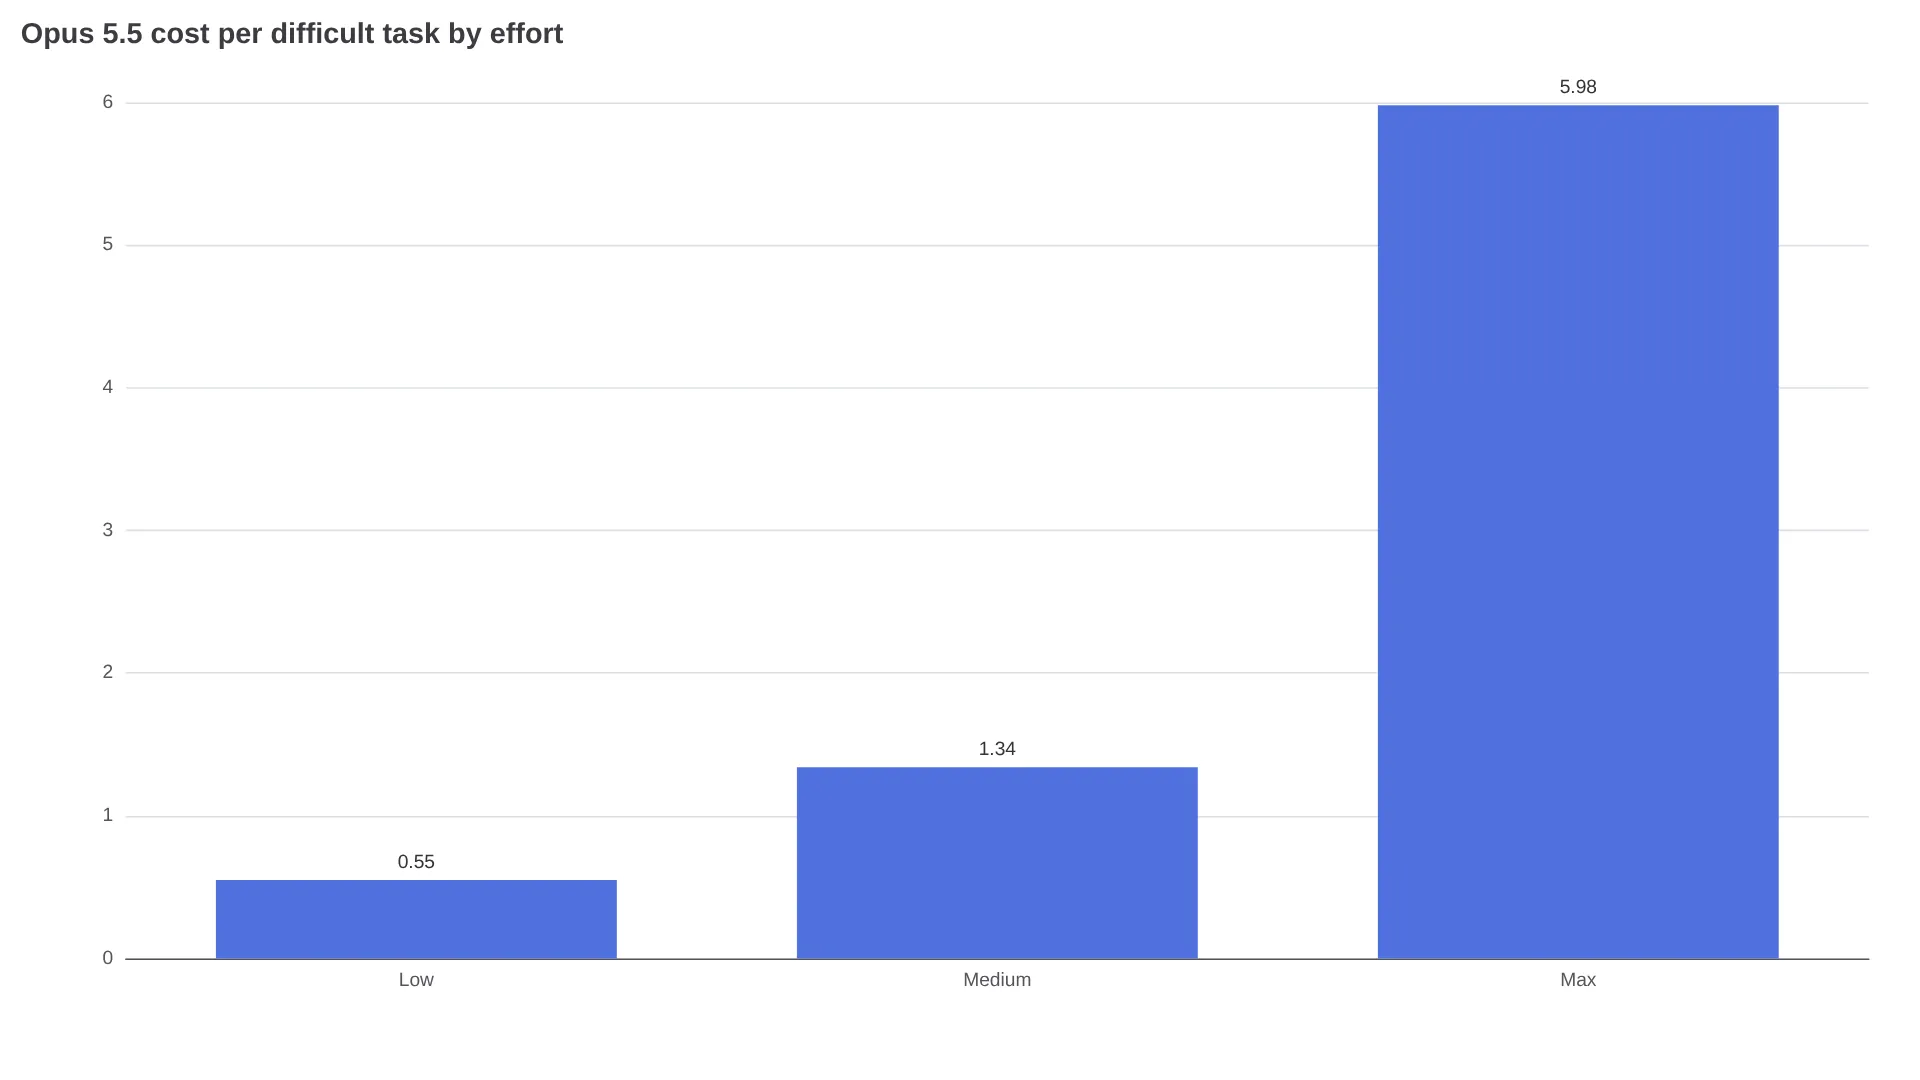
提高推理强度会拉长耗时并抬高成本,却不一定带来更好的结果。Anthropic 自己的建议是删掉“think hard”之类的措辞:推理本来就已启用,思考深度由推理强度和任务本身共同决定。只有 Medium 明确卡住时,才值得往上加一档。
根据 eesel 的规格表,上下文窗口为 100 万 token,最多可输出 128,000 token,Batch 中则为 300,000 token,并原生支持视觉输入。eesel 的价格评测称,长上下文没有额外附加费,这对长文档审计工作流尤为重要。
四模型怎么分工:Opus 5.5、Sonnet 5.5、Haiku 5.5 和 Fable 5.2
Anthropic 11 月指南和独立成本分析得出了同一条规则:先调推理强度,再考虑换模型。以下价格来自 Anthropic 日常主力指南中的定价表。
| 模型 | API 价格,每 1M(输入/输出) | 适合做什么 | 何时该换模型 |
|---|---|---|---|
| Haiku 5.5 | 100K token 以内 $0.10 / $0.50 | 快速查询、摘要、分类,以及高频但范围明确的任务 | 分析开始变长,或需要较强判断力时 |
| Sonnet 5.5 | $2 / $10 | 边界清晰的任务、文档润色、根据明确 brief 制作幻灯片 | 你经常需要用到 Extra High 或 Max 时 |
| Opus 5.5 | $4 / $20 | 大多数研究、分析、金融工作和成品文档 | Medium 在认真尝试 High 后仍然卡住时 |
| Fable 5.2 | $8 / $40 | 开放式技术工作、科学、编程、金融,以及需要长期运行子 agent 团队的任务 | 普通知识工作——通常属于性能过剩 |
需要记住的成本交叉点是:把 Sonnet 5.5 推到 Extra High 或 Max,每项任务的成本可能已接近 Opus 5.5,但判断力仍然落后。编程套餐用户从订阅额度角度也报告了相同规律:不要长期把 Sonnet 放在 Medium 以上,不如把任务切到 Low 强度的 Opus 5.5(例如 @cupid25157)。这与官方“先调强度、后换模型”的阶梯一致,也符合单任务成本测算。
Fable 是能力上限,不是日常竞争对手。Anthropic 11 月关于 Fable 5.2 的讨论中,将 Fable 和 Mythos 定位为最具雄心的开放式技术工作,而 Opus 5.5 则是大多数编程和知识任务中最强的日常主力(@claudeai)。从订阅角度看,这一区别更明显:标准 Pro/Team 席位使用 Fable 往往会计入 credits,随手选一个“更强模型”,很可能就变成一笔 credits 账单。
额度怎么撑住:5 小时窗口为何迅速见底
官方基准测试很少展开这一点,用户反馈却几乎都绕不开它。最具体、最常见的抱怨不是能力不够,而是额度消耗速度。
“今晚 Opus 5.5 的额度被打得稀碎!!多人反馈,正常会话下 5 小时额度仅 15–30 分钟就耗尽。周额度消耗也快得多”—— @TekonBurns,关于 Claude Code 会话额度消耗的反馈
有些用户把这种变化形容为蜜月期突然结束。@kgauravnm 写道,“Claude Opus 5.5 的蜜月期正式结束”,理由是模型变懒且周额度消耗很快;类似 @ps_ios_dev 的 Team 席位用户也称,即使免费周额度刚重置,Medium 强度的用量仍在“飞奔”。但有一个保留意见值得纳入:@sonuv_dev 对 67,000 条 Claude Code 消息日志的分析发现,工具调用量、失败率和投诉率大致持平,“基本没有模型被削弱的证据”。这说明至少一部分痛感,可能来自默认使用量变大和推理成本更高,而非秘密降级。模型选择也会影响能力上限:@mohitsharmadl 报告过一个案例,Fable 5.2 在 Medium 下解决了 Opus 5.5 High 无法解决的 bug;因此“所有任务都用 Opus”也可能把额度浪费在错误的能力上限上。
结合官方建议和用户有效经验,可以采用以下额度策略:
- 所有任务默认用 Medium 强度的 Opus 5.5;High 应是诊断后才采取的升级步骤,而不是个人偏好设置。
- 按子任务分流:检索和分类交给 Haiku,范围明确的起草和润色交给 Sonnet,判断、审计和最终把关交给 Opus。
- 不要习惯性把 Sonnet 停在 Medium 以上;先算清成本交叉点,再把任务改用 Low/Medium 的 Opus。
- 上传文件、连接代码仓库,不要在每一轮重复粘贴相同上下文;重复发送长上下文会在每轮增加 token,从而提高计量用量。
- 把速率限制重置机会留给真正有截止日期的一周,而不是用在试验上。
- Fable 只留给它真正擅长的少数任务:长周期、多 agent、开放式技术工作;使用前先确认你的席位是否会将其计入 credits。
FAQ:大家真正会问的日常主力问题
Claude Opus 5.5 够资格做日常主力吗?
对于重视判断力和可审计性的研究、分析、写作任务,答案是肯定的。Hayz Labs 将它在 agents 和 WebDev 中排在第一,写作评分也居首;Anthropic 引述的企业测试也指向相同结论。不过,仍应同时配置一个更便宜的模型来处理高吞吐量任务。
日常工作中,Opus 5.5 比 Sonnet 5.5 更好吗?
对于模糊或高风险的工作,是的。对于边界清晰、高频且量大的任务,Low 或 Medium 强度的 Sonnet 更快——Anthropic 将 Sonnet 评为 Fast,Opus 为 Moderate(claude.com)——且 token 价格约低一半。真正的错误是默认把 Sonnet 跑在 Extra High 或 Max,这会直接抹掉省下的成本。
什么时候该用 Fable 5.2,而不是 Opus 5.5?
大多数知识工作和常规编程任务使用 Opus 即可。只有开放式、长期运行或高度 agent 化的技术项目,并且 High 强度的 Opus 仍然卡住时,才升级到 Fable;同时先确认套餐计费,因为标准 Pro/Team 席位通常会将 Fable 计入 credits。
100 万 token 上下文能可靠处理长文档吗?
对于上传文件后进行审计式处理,这是 Anthropic 目前推出过的最强 Opus 配置之一,其中就包括前述 18 份带来源报告完成 16 份的结果。但超长任务仍会快速消耗订阅额度,因此更好的做法是让 Haiku 负责检索、Opus 负责判断,而不是把所有环节都跑在最大上下文上。
真正需要持续观察的取舍
对于 Medium 推理强度下的知识工作,Opus 5.5 是正确的默认选择;尚未确定的是,用户在 10 月下旬报告的额度收紧是否会成为常态。如果会,那么每周实际落到 Sonnet 上的工作量,仍将高于发布宣传所暗示的水平。
延伸阅读:Claude Opus 5.5 pricing review、Claude Opus 5.5 High review、Claude Opus 5.5 vs GPT-6.1 Sol。