 AIREITER
如果只看质量,Opus 5.5 胜出;如果只看标价,GPT-6.1 Sol 更便宜——但前提是每次请求的输入不超过 272K tokens。一旦越过这条线,Sol 的长上下文附加费会抹掉大部分价格优势。更麻烦的是,一些 Codex 用户表示,Sol 的实际等待时间反而更长。
两款模型如今都已上线。Anthropic 于 2026 年 9 月 22 日发布了 Claude Opus 5.5,这是 Claude 5.5 系列的首款模型;OpenAI 于 2026 年 9 月 29 日发布了 GPT-6.1 Sol,API ID 为 gpt-6.1-sol。但光看规格表还不够,真正决定账单的还有三个因素:长上下文费用断崖、推理强度设置,以及订阅套餐的配额消耗方式。
先给结论:30 秒看懂怎么选
如果错误补丁或过度改动的代价高,选 Claude Opus 5.5:它更适合长期迁移、多仓库审计和无人值守代理。若你的任务量很大、边界清晰,而且单次请求的输入低于 272K tokens,则选 GPT-6.1 Sol:工单自动化、PDF 提取和业务流程都属于它的舒适区。
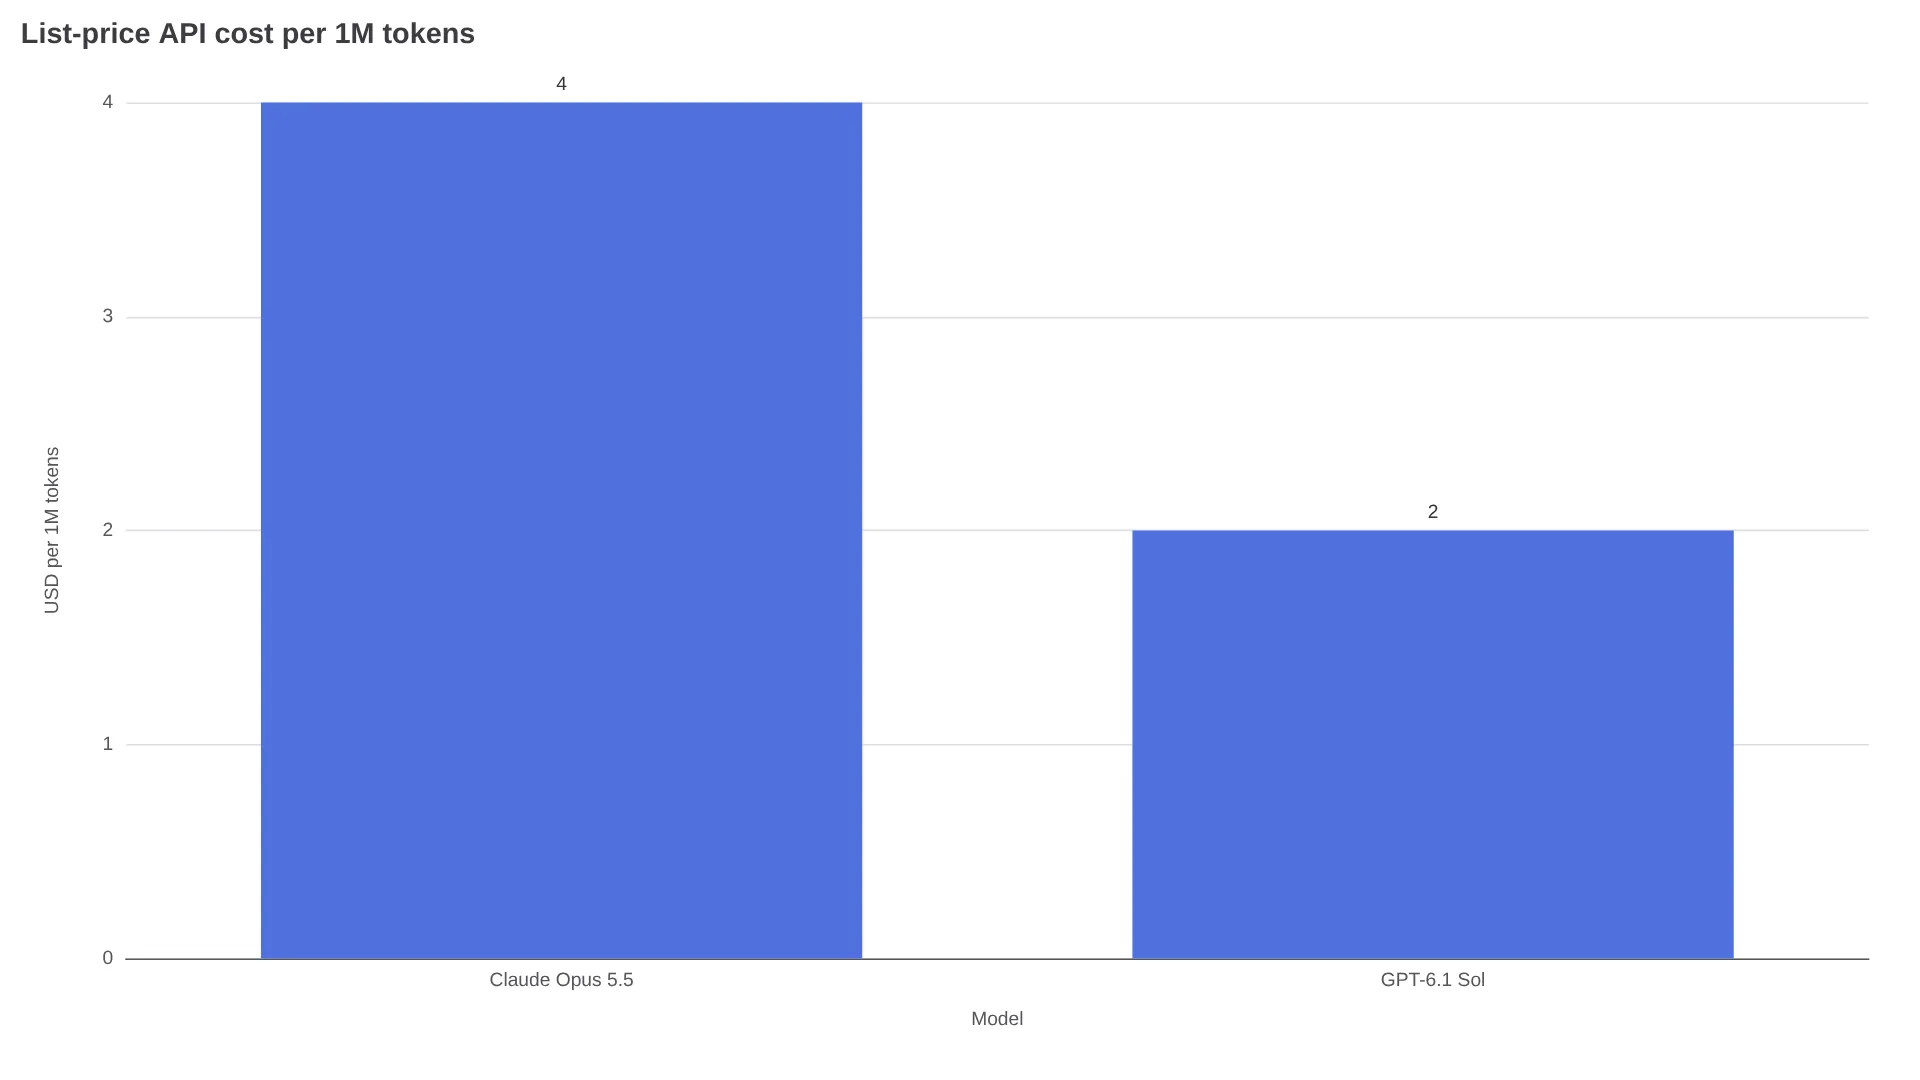
纸面规格差距其实不大:上下文窗口分别为 1M 和 1.05M,最大输出都是 128K;每百万输入/输出 tokens 的价格则是 $4/$20 对 $2/$10。真正拉开差距的是使用体验:Opus 5.5 在代理编程测试中成绩更高(Terminal-Bench 4.0 为 66.4%,FrontierCode v1.1 为 54.4%,CursorBench 4.0 为 57.8%);Sol 则凭借约一半的标价,以及 AutomationBench 中以三分之一任务成本获胜的表现应战。订阅用户还要注意另一点:Reddit 上的配额测试显示,Sol 消耗额度的速度可能比 API 价格所暗示的更快。
价格、上下文,以及调用渠道
| Claude Opus 5.5 | GPT-6.1 Sol | |
|---|---|---|
| 提供商 | Anthropic | OpenAI |
| 发布日期 | 2026 年 9 月 22 日 | 2026 年 9 月 29 日 |
| API ID | 大多数网关使用 claude-opus-5-5 系列 | gpt-6.1-sol |
| 每百万输入/输出 tokens | $4.00 / $20.00 | $2.00 / $10.00 |
| 每百万缓存输入读取 | $0.20 | $0.10 |
| 上下文窗口 | 1,000,000 tokens | 1,050,000 tokens |
| 最大输出 | 128K tokens | 128K tokens |
| 高速档位 | Fast mode:$8 / $40,速度最高提升 2.5 倍 | Codex 中 Ultrafast 最高提升 8 倍,约为标价的 2 倍 |
| 可用渠道 | Claude Code、API、Bedrock、Vertex、Foundry、OpenRouter | Codex、ChatGPT Work、API、Azure、Bedrock、OpenRouter |
| 不支持 | — | 发布时不支持普通消费者版 Chat |
两款模型都只需要修改模型字符串即可切换。通过 AIReiter 可以在同一个控制台调用二者,不必分别管理两家供应商的密钥。
真实工作负载下,最终到底要付多少钱
按标价计算,Sol 便宜 50%;但实际成本还取决于单次请求的大小和缓存比例。
OpenAI 对每次超过 272K 输入 tokens 的请求收取附加费:整次请求的输入和缓存价格翻倍,输出价格变为 1.5 倍。Anthropic 对完整 1M 上下文窗口仍按相同价格计费,目前没有披露按请求收取附加费。缓存读取价格为 $0.20 对 $0.10,因此缓存占比较高的循环任务仍能保留 Sol 的部分优势。
| 工作负载 | Opus 5.5 | GPT-6.1 Sol | 差距 |
|---|---|---|---|
| 均衡型助手:1M 输入 / 250K 输出,每次请求低于 272K | $9.00 | $4.50 | Sol 便宜 50% |
| 检索任务,请求低于 272K:10M 输入 / 1M 输出 | $60 | $30 | Sol 便宜 50% |
| 检索任务,每次请求都超过 272K:10M 输入 / 1M 输出 | $60 | 约 $55 | Sol 只便宜约 8% |
| 高缓存循环:写入一次 100K 前缀,随后循环 1,000 次(5K 新输入 + 100K 缓存读取 + 1K 输出) | 约 $60.50 | 约 $30.25 | Sol 便宜约 50% |
以上都是按标价计算的结果,没有考虑 tokenizer 差异。Sol 在短请求、高并发任务上优势最明显;面对单次超大规模检索时,优势则会大幅缩水。
订阅套餐的账并不等同于 API 账单。一项由用户进行的测试,用固定提示词对 GPT-6.1 Sol、GPT-6 Sol 和 Opus 5.5 完成了 128 个提示词的比较,结果显示 Sol 系列在订阅中的消耗高于其 token 价格所推算的水平。一位后续评论者说得更直接:
"my chatgpt just cited this. anyways they may be a match usage-wise but opus is way faster on the wall clock and i regret swapping this month." — u/ebrbrbr,r/ChatGPT 配额测试讨论
另一位 Codex 用户也报告了类似的额度消耗:
"I wouldn't mind using GPT 6.1 Sol if the usage was decent, but man, even though it's more 'efficient' I'm still getting drained on usage. It's unbelievable." — u/Longjumping_Stop6269,r/codex
预算上的经验法则是:如果你的请求中位数超过 272K,迁移前一定要把附加费算进去。如果你使用的是 $20 或 $100 的订阅席位,应该关注每个合并 PR 消耗了多少配额,而不是每一美元买到了多少 tokens。
编程与代理:基准成绩之外,再看两个实测任务
下面的第三方测试仅供参考,不同测试使用的 harness 和推理强度并不一致。数据来源包括:Anthropic、OpenAI、DataCamp 构建测试、OpenRouter 吞吐测试、SpringPrompt 基准汇总。
| 基准测试 | Opus 5.5 | GPT-6.1 Sol | 备注 |
|---|---|---|---|
| Terminal-Bench 4.0 | 66.4% | 未发布 | Anthropic 测试,xhigh |
| FrontierCode v1.1 Main | 54.4% | 与 Fable 5.1 持平,未公布具体数字 | 报告方不同 |
| CursorBench 4.0 | 57.8% | 未发布 | Anthropic 测试 |
| DeepSWE v1.1 | 未发布 | 与 Astra 持平,比 GPT-6 Sol 高 6.4 个百分点 | OpenAI 测试,最高推理强度 |
| AutomationBench(47 个工具) | 40.0% | 中等强度下比 Opus 高 2.2 个百分点,成本约为三分之一 | 独立测试,无 fallback;据 Anthropic 对 Zapier 测试的说明 |
| OSWorld 2.0 部分测试 | 81.8% | 离线集约 60.5% | 测试子集不同,厂商测试 |
| GDPval-AA v2.1 | 1,846 Elo | 在 GDP.pdf 上击败带 fallback 的 Opus,成本低于一半 | OpenAI 提供的跨厂商说法 |
Opus 5.5 公布了更完整的代理编程成绩;Sol 已有的最佳成绩则集中在业务流程和文档分析,而且任务成本更低。Anthropic 表示,其测试分数是在开启生产级安全防护的情况下取得的。
两项第三方任务测试让差异更具体:
- 单文件 Tetris 构建(DataCamp、OpenCode、相同提示词、高强度、单次尝试)。两款模型都通过了高难度的重力翻转逻辑。Sol 在机制、完整度和手感上的综合得分为 5.0,Opus 为 4.3;但 Opus 只用了 3 轮、2 次工具调用就完成,Sol 则用了 6 轮、9 次调用。最终成本分别为 $0.87 和 $0.26,Opus 消耗了 22.5K 推理 tokens,Sol 为 8.1K。
- 128 个提示词的配额测试(Reddit、固定提示词,记录配额和耗时)。在相同工作负载下,Sol 消耗的订阅配额多于 GPT-6 Sol,而 Opus 的实际完成时间更短。
用户反馈中反复出现的一个关键词是“克制”:
"The biggest win with Opus 5.5 for me isn't even raw coding speed, it's that it doesn't over-engineer simple fixes. Previous models would rewrite 4 files when you asked for a 3-line patch; 5.5 respects the existing architecture" — u/food_fatherr,r/ClaudeAI
但也有一个极端的过度生成案例:一名开发者称 Sol 为一个像素级还原请求写了 30,000 个测试,在被要求精简后也只删除了 25 个。
纸面速度,和你真正感受到的速度
如果只看解码速度,规格数据更偏向 Opus:根据 SpringPrompt 引用的 Artificial Analysis 数据,两者约为每秒 96 和 53 tokens;在 OpenRouter 上,中位吞吐量为 74 和 29。另一方面,SpringPrompt 的数据显示,Sol 的首 token 延迟略低:低强度下为 1.71 秒,对比 Opus 的 6.89 秒。但相关 Codex 报告描述了相反的端到端体验:简单任务也可能等待几分钟,长文档任务更是如此。
这两组结论并不矛盾:tokens/sec 测的是首段输出之后的解码速度,而实际耗时还包括推理、排队和运行 harness 的开销。
- Opus Fast mode 的价格为 $8/$40,是标准价格的 2 倍,速度最高提升 2.5 倍;Sol Ultrafast 则承诺在 Codex 中最高提升 8 倍,价格约为标准价格的 2 倍。
- 引用的 Codex 和 Work 报告关注的是延迟,而不是 API 解码速度。一次耗时 40 分钟的 PDF 任务只用了 5 小时窗口的 6%,这只是单个案例,不能视为典型速率。
- 如果你的工作流是交互式的(Cursor、Claude Code、Codex CLI),在做决定前,最好分别用两款模型处理三个真实工单。
真正决定账单的设置
默认配置往往比模型名更重要:
- Opus 从 Medium 或 High 开始。已有的用户报告显示,在普通补丁任务中,Extra High 和 Max 会消耗更多配额,但收益有限。
- 两款模型的思考开关并不一样。Opus 的思考无法关闭,强制工具调用会被拒绝;在较新的账户上,编辑过的上下文还可能返回 400(DataCamp API 说明)。Sol 则支持从
none到max的推理强度调节,并能在对话中途修改 effort 而不使缓存失效(DataCamp 推理控制说明),更适合有成本上限的循环任务。 - 安全防护可能改变实际调用的模型。在 Cyber Verification Program 之外,大多数 Opus 网络安全任务会转由 Opus 4.8 处理;生物学任务则需要加入 Life Sciences 计划(Anthropic)。这类任务可能出现与 fallback 相关的质量和配额变化。
按工作负载选择模型
| 如果你要做的是…… | 建议选择 | 原因 |
|---|---|---|
| 20 万行代码迁移、多仓库审计、持续 9 小时的代理任务 | Opus 5.5 | 代理测试成绩更高,意外重写更少,1M 上下文价格稳定 |
| 每天 10K 个工单,每个低于 272K,使用小分块 RAG | GPT-6.1 Sol | 标价只有一半,AutomationBench 和 GDP.pdf 的单位成本表现更强 |
| 每次请求都超过 272K 的超大单次检索 | Opus 5.5,或先分块再用 Sol | Sol 的附加费会让优势缩小到约 8% |
| 以 PDF 为主的金融和法律问答 | 先测试 Sol | 据称以低于一半的任务成本击败带 fallback 的 Opus;但仍需用你的文档验证 |
| $20 订阅席位、交互式 CLI | 两款都测试;已有报告更偏向 Opus | 用户称 Sol 的配额消耗比 token 价格推算的更快,而且体感更慢 |
没有绝对的赢家。Sol 更像是效率优先的选择,Opus 则更强调克制和自主完成能力。一个实用的组合是:用 Opus 做规划和审查,用 Sol 承担批量执行。
Opus 5.5 与 GPT-6.1 Sol 常见问题
通过 API 调用,哪款更便宜?
按标价看是 Sol($2/$10 对 $4/$20,缓存读取为 $0.10 对 $0.20)。但当每次请求的输入都超过 272K 时,差距会缩小到约 8%。
哪款更适合编程代理?
Opus 5.5 在已公布的 Terminal-Bench、FrontierCode 和 CursorBench 中领先;Sol 则在 DeepSWE 中达到 Astra 水平,并在 AutomationBench 上以三分之一的成本胜出。
实际使用时哪款更快?
解码速度偏向 Opus(约 74–96 tok/s 对 29–53 tok/s),首 token 延迟则略偏向 Sol。2026 年 10 月的 Codex 报告整体上认为 Sol 更慢。
API 模型 ID 是什么?
gpt-6.1-sol,以及大多数网关使用的 claude-opus-5-5 slug。
GPT-6.1 Sol 是否已经加入普通 ChatGPT?
在 9 月 29 日发布时还没有:最初支持 Work、Codex 和 API。如果访问权限很重要,请确认你的订阅席位。
应该使用什么推理强度?
Opus 5.5 建议从 Medium 或 High 开始,不要直接用 Max;Sol 可以从 medium 开始,只有重试次数上升时再提高。两款模型的推理 tokens 都按相同的 token 计费规则计算(DataCamp 计费说明)。
有些取舍,不是靠提示词就能解决的
Opus 5.5 更尊重现有代码仓库,但它的思考需要付费;Sol 的 tokens 更便宜,却可能生成大量需要你审查、也需要等待完成的工作。如果一次无声的遗漏可能把 bug 带上线,那就为 Opus 付费。如果错误成本低、任务量才是核心,而且请求低于 272K,就把 Sol 的低价优势利用起来。