 AIREITER
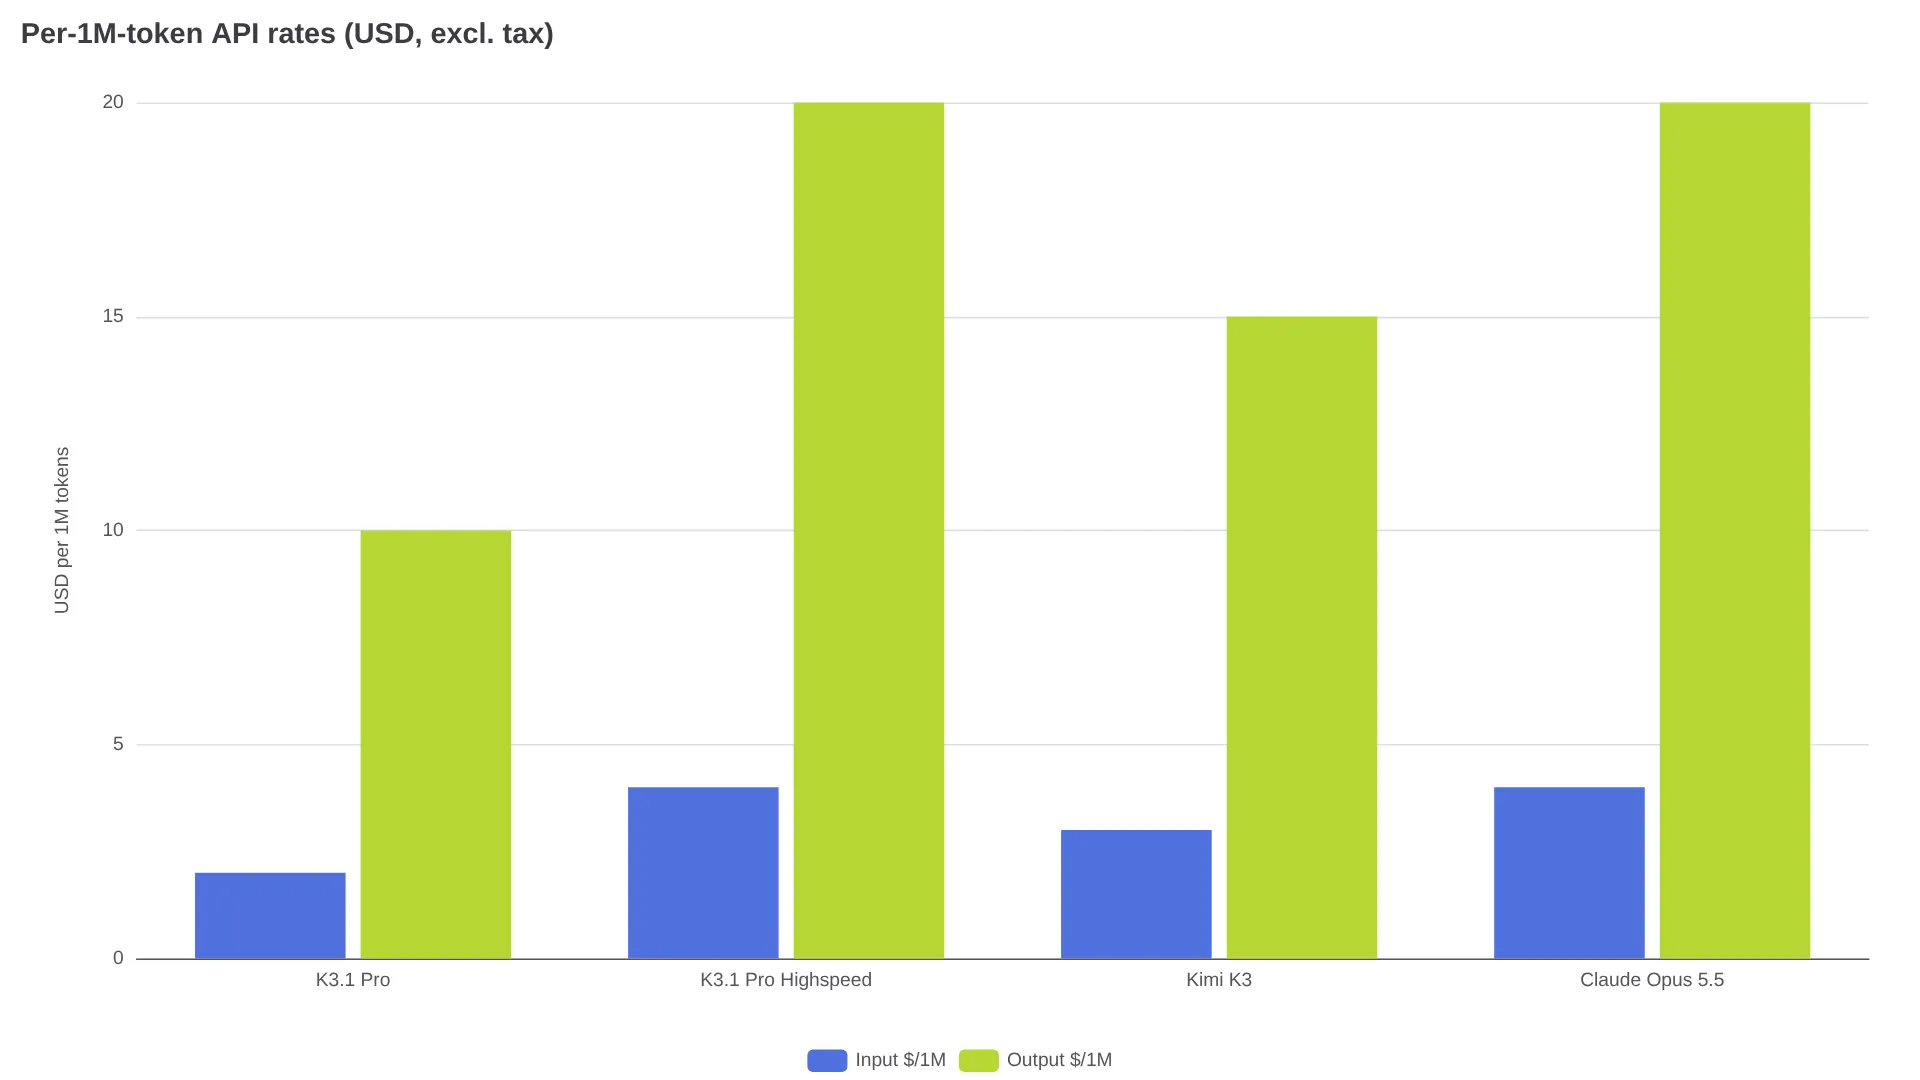
Kimi K3.1 Pro API 的账单,关键不只是 $2/$10 这组标价,还要看推理 token 和缓存命中情况。标准版输入每 100 万 tokens 收费 $2、输出收费 $10;Highspeed 为了换取更高速度,两个价格都翻倍。无论选择哪个版本,缓存命中读取都维持每 100 万 tokens $0.20(platform.kimi.ai)。
| 模型 | 输入 / 100 万 | 输出 / 100 万 | 缓存命中读取 / 100 万 | 缓存写入 5 分钟 / 100 万 | 缓存写入 1 小时 / 100 万 |
|---|---|---|---|---|---|
Kimi K3.1 Pro (kimi-k3.1-pro) | $2.00 | $10.00 | $0.20 | $2.00 | $4.00 |
Kimi K3.1 Pro Highspeed (kimi-k3.1-pro-highspeed) | $4.00 | $20.00 | $0.20 | $4.00 | $8.00 |
| Kimi K3(上一代) | $3.00 | $15.00 | $0.30 | $3.00 | $6.00 |
以上价格均为税前美元价格,按每 100 万 tokens 计算。根据 Kimi 官方定价资料,完整的 100 万上下文不会额外收取长上下文费用(kimi.ai)。
10 万上下文请求标价 $0.30,但实际账单还要算上这些
以一个典型请求为例:10 万个未缓存输入 token,加上 1 万个输出 token,按官方 $2/$10 的价格计算就是 $0.20+$0.10,总计 $0.30。真实请求可以套用下面的公式;如果使用 Highspeed,则输入、输出和缓存写入价格都要翻倍:
Total = (uncached_in x 2 + cached_read x 0.20 + write_5m x 2
  + write_1h x 4 + (visible_out + reasoning_out) x 10) / 1M
  + searches x 0.004
这个公式对应 Kimi 官方对未缓存输入、缓存命中、不同 TTL 的缓存写入以及输出的计费拆分(kimi.ai),另外还加上了每次 Web Search 调用 $0.004 的费用。API 按请求即用即付(kimi.ai),因此请求重试一次,计费也会重新走一遍。K3.1 Pro 始终开启推理,并按输出价格计费;也就是说,隐藏的推理过程和最终可见答案共用每 100 万 tokens $10 的输出预算。比如可见答案为 10,000 tokens、隐藏推理为 40,000 tokens,实际计费输出就是 50,000 tokens,即 $0.50。一位用户报告称,935 个输入 token 和 56,097 个输出 token 最终花费 $0.5628,这与每 100 万输出 tokens $10 的价格几乎完全吻合(x.com)。
缓存是另一个经常被忽略的账单项目。新的缓存前缀会产生缓存写入费用,而在有效期内复用未改变的前缀,读取费用会降至每 100 万 tokens $0.20。默认缓存有效期为 5 分钟,也可以在每次调用时选择 1 小时(kimi.ai)。如果上下文前段的前缀发生变化,后面的内容可能全部无法复用(kimi.ai)。要确认缓存是否真正命中,需要查看每个请求的用量明细,区分缓存读取和未缓存 token;仅仅是提示词措辞相似,并不能保证命中。
Kimi K3.1 Pro API 逐项价格:标准版和 Highspeed 怎么选
Highspeed 使用相同的模型能力和 100 万上下文,官方宣称速度约为标准版的 2-3 倍,但输入、输出和缓存写入价格也恰好翻倍(platform.kimi.ai)。Moonshot 的发布文章也给出了这一定位(kimi.ai)。
唯一没有翻倍的是缓存命中读取:两个版本都是每 100 万缓存输入 tokens $0.20。对于反复发送长系统提示词和工具定义的 agent 循环,这个差异很关键——缓存复用的折扣完全相同,但 Highspeed 的新 token 和推理成本都要翻倍。
估算费用时,先记住下面三点:
- API 采用即用即付,输入和输出分别计量,与 Kimi 会员和 Kimi Code 订阅完全分开;会员余额不能用于支付 API 调用(kimi.ai)。
- API 兼容 OpenAI,模型 ID 为
kimi-k3.1-pro和kimi-k3.1-pro-highspeed,访问地址是https://api.moonshot.ai/v1;通过网关调用时,OpenRouter 和 Vercel AI Gateway 使用的模型名为moonshotai/kimi-k3.1-pro。 - 可选的 Web Search 每次调用额外收费 $0.004;上传文件本身不收费,但解析后的内容会按输入 token 计费。API 访问需要至少充值 $1 才能解锁,并受分级速率限制影响(kimi.ai)。
什么时候值得为 Highspeed 多花一倍,什么时候只是在烧钱
只有当等待本身比 token 更贵时,Highspeed 才真正划算。交互式编程、实时助手和面向用户的演示,用户会盯着加载动画等待,这时延迟就是产品的一部分,$4/$20 可能值得。批处理、隔夜运行的 agent,以及没人需要实时等待的评测任务,则更适合使用标准版 $2/$10,按标价计算 token 成本大约只有一半。简单说,只有节省下来的等待时间价值高于额外 token 费用时,Highspeed 才有意义;对于输入占比较高的任务,额外费用大致相当于再付一遍标准版账单。
相比直接切换版本,先调低推理强度通常更省钱。API 支持 reasoning_effort 设置为 low、high 和 max,默认值是 max,Moonshot 公布的基准成绩也是在这一设置下取得的(datacamp.com)。对于简单任务,把探测请求从 max 调到 high,或从 high 调到 low,可以减少推理 token,而不必承担 Highspeed 溢价。建议一次会话固定一个级别,因为在会话中途修改推理级别会让上下文缓存失效(datacamp.com)。
社区中的实测也说明了这种取舍。一位日本用户在相近任务中对比发现,Opus 5.5 用时 14 分 32 秒,Kimi K3.1 Pro 用时 27 分 53 秒,输出质量相差不大,因此认为只有不着急等结果的任务才适合交给 Kimi:
本来应该是半价,但等待时间几乎翻倍了。……Opus 5.5 用了 14 分 32 秒,Kimi K3.1 Pro 用了 27 分 53 秒。说实话,完成质量非常接近。如果是我,只有能等的任务才会交给 Kimi。——@rutinelabo(x.com)
Reddit 用户描述了类似的差距:Highspeed 大约 80 tok/s,标准版大约 30 tok/s,同时也认为高速版本贵得离谱:
这个模型又一次推出了高速版本,价格贵得离谱,但速度快到人眼几乎看不清,能达到 80t/s;普通版本则看情况,可能只有 30t/s。——u/Kiverty(reddit.com)
经验法则很简单:默认使用标准版 K3.1 Pro,先降低 reasoning_effort,只有在人需要等待结果的会话中,才考虑购买 Highspeed。
11 月 4 日之后自托管:3T 级模型的现实成本
Moonshot 表示,完整的 Kimi K3.1 Pro 权重将在 2026 年 11 月 4 日前发布,并将其描述为 3T 级、支持 100 万 token 上下文的模型(kimi.com)。截至 11 月 2 日,Moonshot 的 Hugging Face 组织页面 huggingface.co/moonshotai 中仍看不到官方 K3.1 Pro 仓库,目前列出的还是 Kimi K3 及更早期模型,搜索结果里只有非官方分支。最终许可证、文件格式和量化选项也都尚未确认;第三方追踪者同样将这些信息标为未知,等待官方发布(ctrlaltorion.com)。
模型规模决定了自托管很难在这里击败 API 价格。K3.1 Pro 是 Kimi K3 的后训练版本,而 Kimi K3 是一个 2.8T 参数的混合专家模型;3T 级这一说法也指向相同的规模(datacamp.com)。MoE 的总参数量并不等于每个 token 实际激活的参数量,因此在现有信息下,还无法可靠计算单工作站所需的显存。
与其猜 GPU 价格,不如先用符号化的盈亏平衡公式:
API_month = monthly_tokens_1M x blended_$/1M (from formula above)
Self-host wins when cluster_monthly_cost < API_month at sustained utilization
按每 100 万输入 tokens $2、每 100 万输出 tokens $10 计算,10 亿输入 tokens 加上 1 亿输出 tokens,对应 $2,000+$1,000,也就是约 $3,000 的 API 用量费用。对于已经拥有合适集群、持续运行高并发推理,或必须让数据留在本地的团队,自托管可能更划算。没有现成集群、利用率也无法保持稳定的团队,通常还是按量付费的 API 更合适;在官方检查点和许可证发布前,不建议据此规划自托管。
用户反复踩到的两个计费陷阱
第一个陷阱是把推理当作输出计费,上面的公式已经体现了这一点。可以用 max_completion_tokens 限制单次运行,先从 low 开始探测,失败后再升级到 high,把 max 留给最终的高难度运行。
第二个陷阱是订阅额度的消耗速度,以及它和 API 费用可预测性之间的差异。多位付费用户表示,在高强度编程任务中,5 小时额度几分钟就可能耗尽;其中一位顶级套餐用户称月度额度在 6 小时内就被用完(reddit.com)。Moonshot 于 10 月 25 日承认了这一问题,为速率限制和不必要的额度消耗致歉,并一次性恢复 25% 的额度,同时减少重复的子 agent 调用和输出长度(x.com)。对于重度推理和编程任务,按每 10 万输入/1 万输出 tokens $0.30 计费的 API,通常比可能在一次任务中迅速耗尽的订阅额度更容易预估。
Kimi K3.1 Pro API 价格 FAQ
Kimi K3.1 Pro API 每 100 万 tokens 多少钱?
标准版每 100 万 tokens 收费:输入 $2.00、输出 $10.00、缓存输入读取 $0.20、5 分钟缓存写入 $2.00、1 小时缓存写入 $4.00,以上均为税前价格(kimi.ai)。
K3.1 Pro 和 Highspeed 有什么区别?
Highspeed 使用相同的模型能力和 100 万上下文,但速度约为标准版的 2-3 倍;输入每 100 万 tokens $4.00、输出 $20.00,缓存写入价格同样翻倍,缓存命中读取则保持 $0.20 不变(platform.kimi.ai)。
API 模型 ID 是什么?
在 Moonshot 的 OpenAI 兼容端点上,标准版使用 kimi-k3.1-pro,高速版使用 kimi-k3.1-pro-highspeed;各类网关中则列为 moonshotai/kimi-k3.1-pro(openrouter.ai)。
API 使用是否包含在 Kimi 会员中?
不包含。API 计费与 Kimi 会员及 Kimi Code 套餐分开管理,使用独立的密钥和余额,因此会员额度不能用于支付 API 调用(kimi.ai)。
能否关闭推理来降低成本?
不能。K3.1 Pro 始终会进行推理;控制成本需要调整 reasoning_effort(low、high、max,默认值为 max)和 max_completion_tokens,而不是关闭思考过程(datacamp.com)。
开放权重什么时候发布,现在应该等吗?
Moonshot 的目标日期是 2026 年 11 月 4 日前,但截至 11 月 2 日,官方 Hugging Face 仓库和最终许可证都尚未发布。现阶段可以先使用 API;等官方检查点和许可证正式出现后,再重新评估自托管。
相关阅读:Kimi K3.1 Pro API:价格、基准测试与 Highspeed 指南,了解完整的基准测试分析;Kimi K3 价格,查看上一代模型的费率;以及 Kimi K3 API 页面,了解如何用一个密钥调用 Kimi 模型。