 AIREITER
如果你的编程 Agent 全天都在跑,Gemini 4 Hydrogen 和 Claude Sonnet 5.5 的差别并不只是模型榜单上的几个百分点。按输入、输出各占 50% 计算,Hydrogen 每百万 token 的混合成本约低 25%:$4.50 对 $6.00;但在终端操作和计算机使用这类任务中,Sonnet 5.5 仍更常能独立完成任务,不必频繁人工接手。真正该看的,不是单价或单项跑分,而是每个已完成任务的成本。
Gemini 4 Hydrogen 和 Claude Sonnet 5.5 都主打适合快速编程和 Agent 循环的 1M token 上下文窗口;Hydrogen 还额外提供四档可调的思考等级。
明天把 Sonnet 5.5 换成 Hydrogen,会发生什么?
对于每天运行 200 个 Agent 任务的团队,这次替换主要会体现在两处:账单,以及人工介入频率。Hydrogen 的 token 单价更低;在 LLM Leaderboard 的独立速度样本中,它的生成速度约为每秒 198 个 token,而 Sonnet 5.5 约为每秒 144 个 token。它更像一名“批量执行员”:适合快速起草、并行读取文件和迅速修复问题。
Sonnet 5.5 则更像“谨慎收尾的人”。在 Google 的发布对比表中,Sonnet 5.5 在三项偏重终端操作与计算机使用的基准上领先:Terminal-Bench 4.1、OSWorld 2.1 和 Terminal-Bench-Science,详细数据见下表。这恰好是 Agent 遇到命令失败后能否恢复、还是会卡住的关键场景。
发布当周的 Reddit 讨论也呈现出类似分歧:
“hydrogen is alright but honestly i don't feel it's better than sonnet 5.5.” — r/GeminiAI 用户 u/FewKey5274
这条讨论并不是受控的编程基准测试,因此更适合作为一个提醒:单个任务上的胜负,未必能预测端到端 Agent 框架中的表现。迁移前,务必让两者在同一套工作流中实测。
账单对比:$4.50 vs $6.00 只是起点
官方 API 定价很直接。根据 Google 的公告,Hydrogen 输入每百万 token $1.50、输出每百万 token $7.50,且整个上下文窗口均采用统一价格。根据 Anthropic 的定价页与 OpenRouter 的横向对比,Sonnet 5.5 的输入和输出价格分别为每百万 token $2.00 与 $10.00。
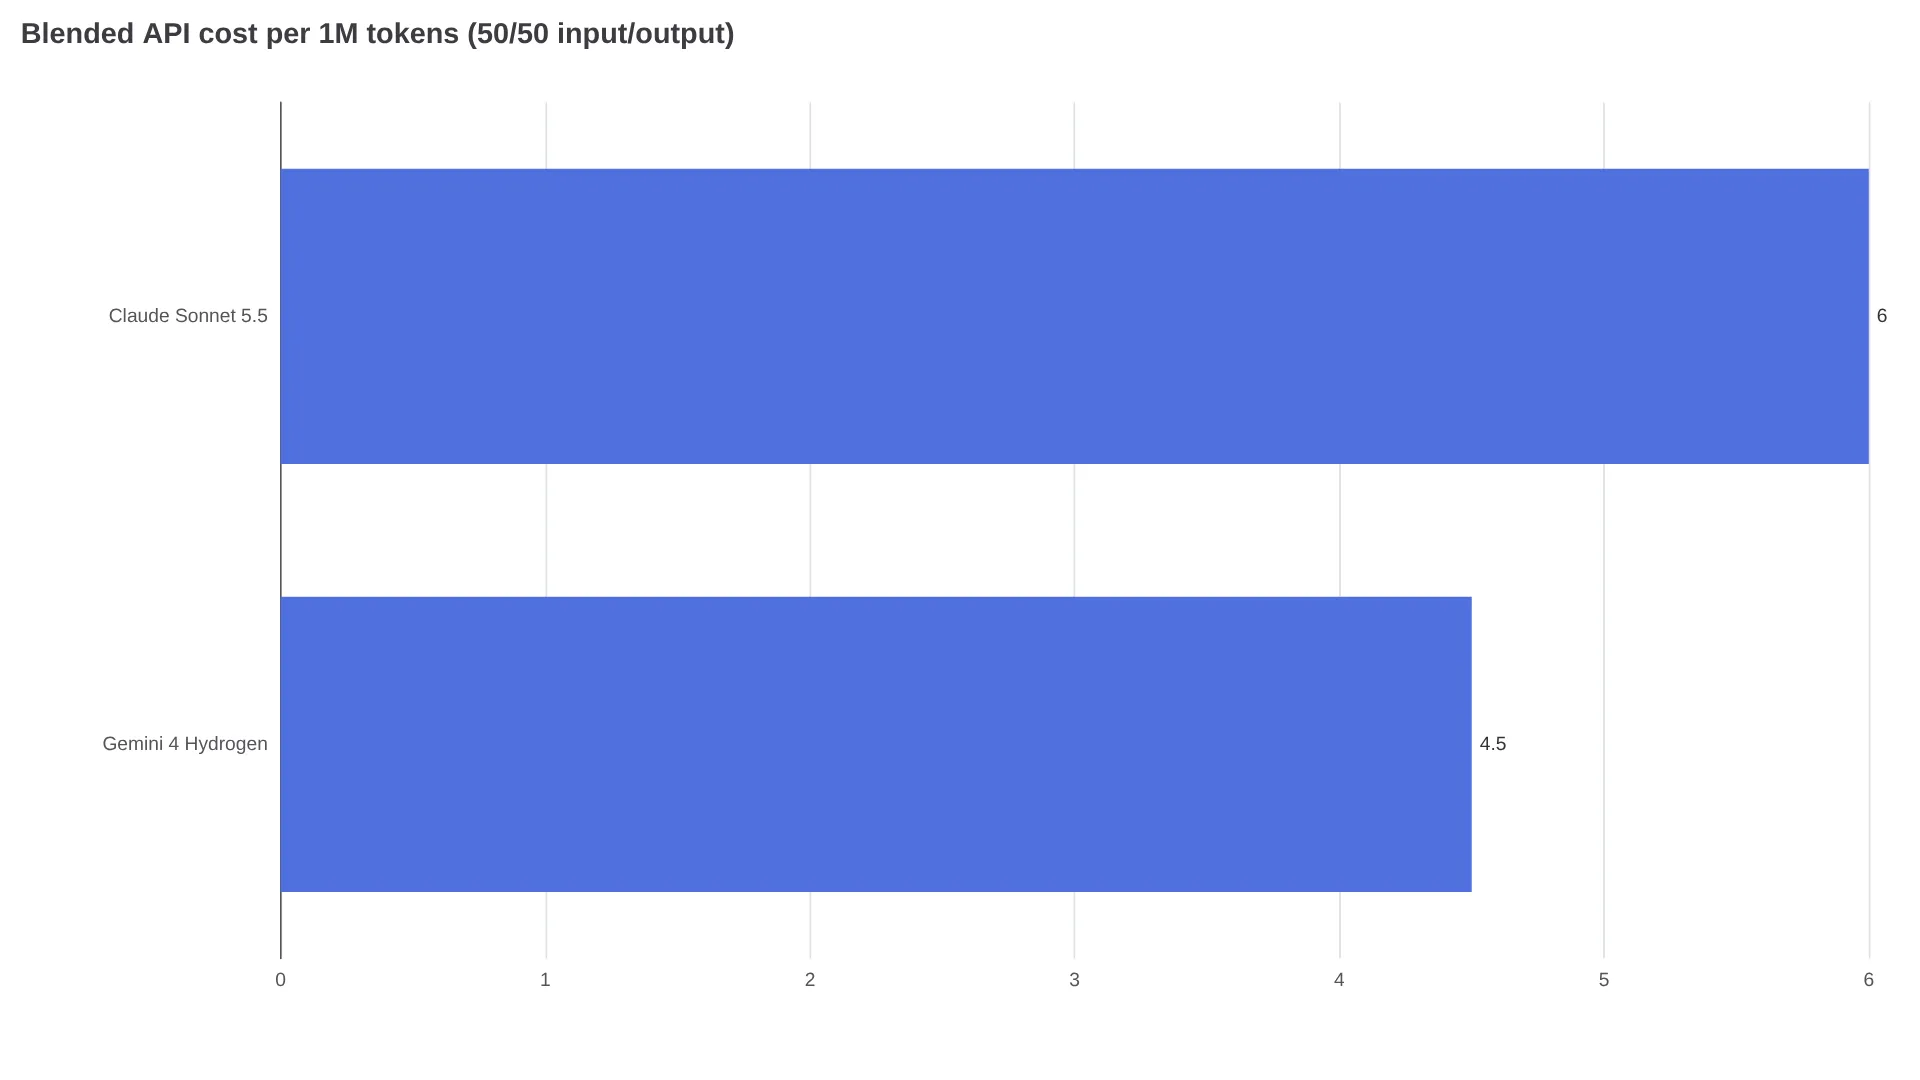
按 50/50 混合比例计算,也就是 50 万输入 token 加 50 万输出 token,Hydrogen 每百万 token 的成本为 $4.50,Sonnet 5.5 则为 $6.00。25% 的价差确实存在,但能否真正省下来,取决于三个细节:
- 输出占比高时,差距更大。带有长推理轨迹的 Agent 循环通常偏向输出密集型,此时 Hydrogen 每百万输出 token 便宜 $2.50 的优势最明显。
- 这里未计算缓存和 Batch 档位。Anthropic 的提示词缓存读取和 Batch API 折扣,可能让实际账单产生几个百分点的变化;LLM Leaderboard 指出,其 Hydrogen 速度样本不支持显式缓存。
- 用一个实际算例来理解。假设单次 Agent 调用平均消耗 10K 输入 token 和 3K 输出 token,每天运行 1,000 次,那么就是 10M 输入加 3M 输出:按目录价计算,Hydrogen 每天约 $37.50,Sonnet 5.5 约 $50.00。以 22 个工作日计,在重试成本之前,每个并发 Agent 每月约相差 $275。
最终谁更便宜,关键在重试次数。每个完成任务的成本,等于单次尝试的 token 成本除以成功率,再加上人工修复时间。仅作示例:Hydrogen 每天花费 $37.50、首轮成功率为 80% 时,单纯 token 成本下每完成 1,000 个任务约为 $46.90;Sonnet 每天 $50.00、成功率为 95% 时约为 $52.60。成功率一旦拉开,成本差距会很快缩小。因此,与其相信任意厂商的表格,不如连续两周跟踪首轮合并率。
基准测试没有总冠军,只有适合的任务类型
Google 的发布对比表以及 DeepMind 模型卡,在十项评测中比较了 Hydrogen、Sonnet 5.5 和 GPT-6.1 Terra。对比 Sonnet 5.5,Hydrogen 在十项中的七项领先,Sonnet 5.5 则领先其余三项。厂商评测行采用各自的测试框架,独立评测行则来自 LLM Leaderboard 的复跑结果。
| 任务类别 | 基准测试 | Gemini 4 Hydrogen | Claude Sonnet 5.5 |
|---|---|---|---|
| 代码库编程 | SWE-sweep(厂商) | 13.5% | 3.1% |
| 代码库编程 | Terminal-Bench 4.1,作弊校正后(厂商) | 57.0% | 63.9% |
| 知识自动化 | Agents' Last Exam v1.1(厂商,对框架敏感) | 71.6% | 60.4% |
| 知识自动化 | AutomationBench-AA(厂商) | 76.1% | 71.8% |
| 知识自动化 | Vending-Bench 2 最终余额(厂商) | $14,549 | $11,165 |
| 计算机使用 | OSWorld 2.1 离线子集(厂商) | 77.6% | 83.9% |
| 多模态 | MKA Climb WSR(厂商;独立结果为 49.52%) | 53.4% | 52.0% |
| 多模态 | Chartography(来源混合) | 66.6% | 61.6% |
| 科学 | Terminal-Bench-Science 0.1(厂商;独立结果为 49.52%) | 51.4% | 59.9% |
| 推理 | HLE-Diamond(独立 xhigh) | 58.8% | 53.3% |
Agent 成败,往往取决于工具调用
基准测试通常只评估答案,但 Agent 真正面对的是工具调用:能否批量读取信息、调用正确的函数,以及搜索无结果或命令失败后能否恢复。
Google 表示,Hydrogen 会并行批量读取文件和执行搜索,而不是按顺序逐个检查文件;它也会专注修改代码库中的相关部分,避免重写无关文件。根据发布文章中的合作伙伴报告,相较 Gemini 3.8 Flash,Hydrogen 在图分析和 SQL 工作上快 2 倍至 2.8 倍,token 消耗少 12% 至 23%;在默认高思考等级下,完成速度快 2.5 倍。这些都是厂商挑选的合作伙伴数据,应视为方向性参考,而非结果保证。
另一面是框架成熟度。在 Claude Code 与 Antigravity 的讨论帖中,用户提到了 Antigravity 的可用性问题,以及 SSH、可复用 hooks、skills、subagents 等工作流组件的缺失。这是发布当周用户的主观感受,不是受控测量,而且讨论的是框架而非模型权重本身。
将生产 Agent 迁移前,至少验证三件事:在你的 MCP server 数量下,并行工具调用是否稳定;bash 或浏览器步骤失败后能否恢复;以及权限边界行为是否可靠。Google 的内部检查声称,Hydrogen 的 Agent 过度越权最高可减少 81%,服务不足可减少 79%,在其 Agent 诚实度评测中的诚实度达到 96.7%。请用自己的一组 50 个任务进行金丝雀测试,覆盖被阻止的操作和无路可走的搜索。
思考等级:默认用 high,xhigh 留给少数难题
Hydrogen 提供 low、medium、high 和 xhigh 四档思考等级,默认值为 high。根据 Google 的思考等级表,Artificial Analysis Intelligence Index v5.0.1 从 low 到 xhigh 分别为 27 / 41 / 51 / 54,默认 high 的 51 分略高于 Argon 的 50 分。在 Terminal-Bench 4.0 上,high 的 54.0% 反而高于 xhigh 的 53.5%;但 AutomationBench-AA 从 60.5% 升至 76.1%,HLE-Diamond 从 32.2% 升至 58.8%,均呈稳定上升趋势。
用于 Agent 循环时,建议从 high 开始。只有在推理成为瓶颈时,例如分析、综合和多文档研究,再把单个任务升至 xhigh,随后检查 token 增量。根据 DeepMind 模型卡,更高思考等级下 Hydrogen 可能消耗更多 token;其知识截止日期为 2026 年 3 月,因此涉及时效性的信息,无论选哪款模型都需要接入检索。
迁移前,先测试 Agent 框架本身
根据 DeepMind 模型卡,Hydrogen 的输入上下文为 1,048,576 token,同步输出最高 64K token,通过后台长解码最高可达 1M;根据 Anthropic 文档,Sonnet 5.5 支持 1M token 输入和最高 128K token 输出。表面上看,两者的上下文窗口相当;但面对大型代码库,真正决定体验的是压缩机制。别只问规格表有多大,而要问连续 50 轮对话后还保留了多少信息。
| Gemini 4 Hydrogen | Claude Sonnet 5.5 | |
|---|---|---|
| 上下文 / 输出上限 | 输入 1,048,576 token;同步输出 64K(后台解码 1M) | 输入 1,000,000 token;输出 128K |
| 运行平台 | Gemini API、AI Studio、Antigravity、Gemini app,依据 Google | Claude API、Bedrock、Vertex AI、Microsoft Foundry,依据 Anthropic |
Antigravity 与 Claude Code 的讨论帖表明,比模型质量更大的迁移风险可能是框架稳定性:用户质疑上下文压缩后的信息保留、配额持续性和服务可用性。请在两套框架中使用相同代码库、相同 commit、相同提示词和相同验收测试,比较每个订阅窗口内完成的任务数以及首轮合并率。
60 秒选型:三类 Agent 怎么配
没有一款模型适合所有 Agent。基于前述基准测试差异得出的编辑判断,而非实测结论是:把并行、重复性的执行任务交给 Hydrogen;将对恢复能力敏感、执行链路长的工作交给 Sonnet 5.5。单一厂商的规划器—执行器组合能让认证和上下文压缩保持一致;只有先测出单一厂商方案的基线后,才值得测试 Claude 作为规划器、Hydrogen 作为执行器的混搭方式。
| 你的 Agent 类型 | 推荐选择 | 原因(证据等级) |
|---|---|---|
| 高吞吐执行器:批量修复、模板代码、数据处理、多模态分流 | Hydrogen,设为 high | 厂商基准在 AutomationBench、Agents' Last Exam、Vending-Bench 上领先;独立速度样本约为 198 vs 144 tok/s |
| 长链路完成器:重终端调试、OS/浏览器自动化、科学工具链 | Sonnet 5.5 | 厂商基准在 Terminal-Bench 4.1、OSWorld 2.1、Terminal-Bench-Science 上领先;Claude Code 的 hooks 和 subagents 生态判断更佳 |
| 研究综合器:长文档、图表、音频/视频、重度 Sheets 分析 | Hydrogen,默认 high;最难任务用 xhigh | 厂商基准在 HLE-Diamond、Chartography、MKA 上领先;但独立复跑的 MKA 结果较低,为 49.52% |
Hydrogen 真的比 Sonnet 5.5 更快吗?
在 LLM Leaderboard 的样本中,Hydrogen 吞吐量更高,约为每秒 198 个 token,对比 Sonnet 5.5 的 144 个 token;但 OpenRouter 的实时 p50 数据显示,Sonnet 5.5 的延迟更低,中位数为 2.08s,对比 Hydrogen 的 6.92s,因为服务商、区域和负载不同。请在你实际使用的服务商上测量两者。
能在 Claude Code 里直接用 Hydrogen 替换 Sonnet 5.5 吗?
不能只替换一个模型 ID。Sonnet 5.5 原生运行于 Claude Code,团队通常依赖其中的 hooks、skills 和 subagents;Hydrogen 则通过 Gemini API、AI Studio、Antigravity 和 Gemini app 运行。要完成替换,意味着连 Agent 框架也要一起迁移。