 AIREITER
到了 2026 年 8 月,Qwen 3.8 與 Kimi K3 該怎麼選,已經不能只用一句話回答。兩個系列的權重都可下載,旗艦模型也都已正式推出,但適合的部署場景截然不同:Kimi K3 仍握有最強的已驗證代理式程式開發紀錄;Qwen 3.8 Max 的 token 單價更低;而 Qwen 採 Apache-2.0 授權的 27B 模型,單張消費級 GPU 就能跑。Kimi 的限制也很現實:它標榜「開放」的旗艦 checkpoint 據報達 1.56 TB,權重開放不等於實務上就能輕鬆自架。
Qwen 3.8 與 Kimi K3 各自推出了什麼
Kimi K3(Moonshot AI)於 2026 年 7 月 16 日推出,策略是單一旗艦:一款總參數 2.8 兆、每 token 啟用 104B 參數的 MoE 模型,搭載 Kimi Delta Attention 與 Gated MLA,支援 1,048,576 token 上下文及原生視覺能力。權重與技術報告則在 7 月 27 日釋出,採自訂 Kimi K3 License;Emergent 的比較整理指出,該條款對大規模商業轉售商與月活躍使用者超過 1 億的產品附加了條件。
阿里巴巴的應對則是一整個產品家族,而非單一模型。Qwen 3.8 Max 先在 7 月 19 日預覽,8 月 3 日於 QwenCloud 正式上線,規格為 2.4T 總參數/約 95B 啟用參數;其權重約在 8 月 12 日登上 Hugging Face,模型為 Qwen/Qwen3.8-2.4T-A95B,使用自訂 qwen3.8-max 授權。數日後,Qwen/Qwen3.8-27B也隨之發布:這是一款採 Apache-2.0 的稠密 27B 視覺語言模型,原生支援 262K 上下文,透過 YaRN 可延伸至 1M;Yotta Labs 將其日期標為 8 月 13 至 14 日。
| Kimi K3 | Qwen 3.8 Max | Qwen3.8-27B | |
|---|---|---|---|
| 總參數/啟用參數 | 2.8T / 104B | 2.4T / ~95B | 27B 稠密模型 |
| 上下文 | 1,048,576 | 1M(991.8K 最大輸入) | 原生 262K,透過 YaRN 為 1M |
| 授權 | Kimi K3 License(自訂) | 自訂 qwen3.8-max 授權 | Apache-2.0 |
| 權重上線時間 | 2026 年 7 月 27 日 | 約 2026 年 8 月 12 日 | 約 2026 年 8 月 13 至 14 日 |
| 視覺輸入 | 文字 + 圖片(正式支援) | 透過 API 支援文字、圖片、影片 | 文字、圖片、影片 |
Moonshot 也曾在 K3 發布後 48 小時內,據報暫停接受新的消費者訂閱,原因是需求超過 GPU 容量。若打算把產品押在單一供應商上,這點值得記住。
基準測試怎麼看:先分清是誰測的
兩家廠商都發布了亮眼的 benchmark 表格,但測試框架並不一致。Kimi 自家的模型卡便註明,競品成績採用不同的代理測試框架,部分項目使用的還是 H20 而非 H100 硬體。因此,下方重疊項目應視為廠商自行報告,而不是經稽核的結果。
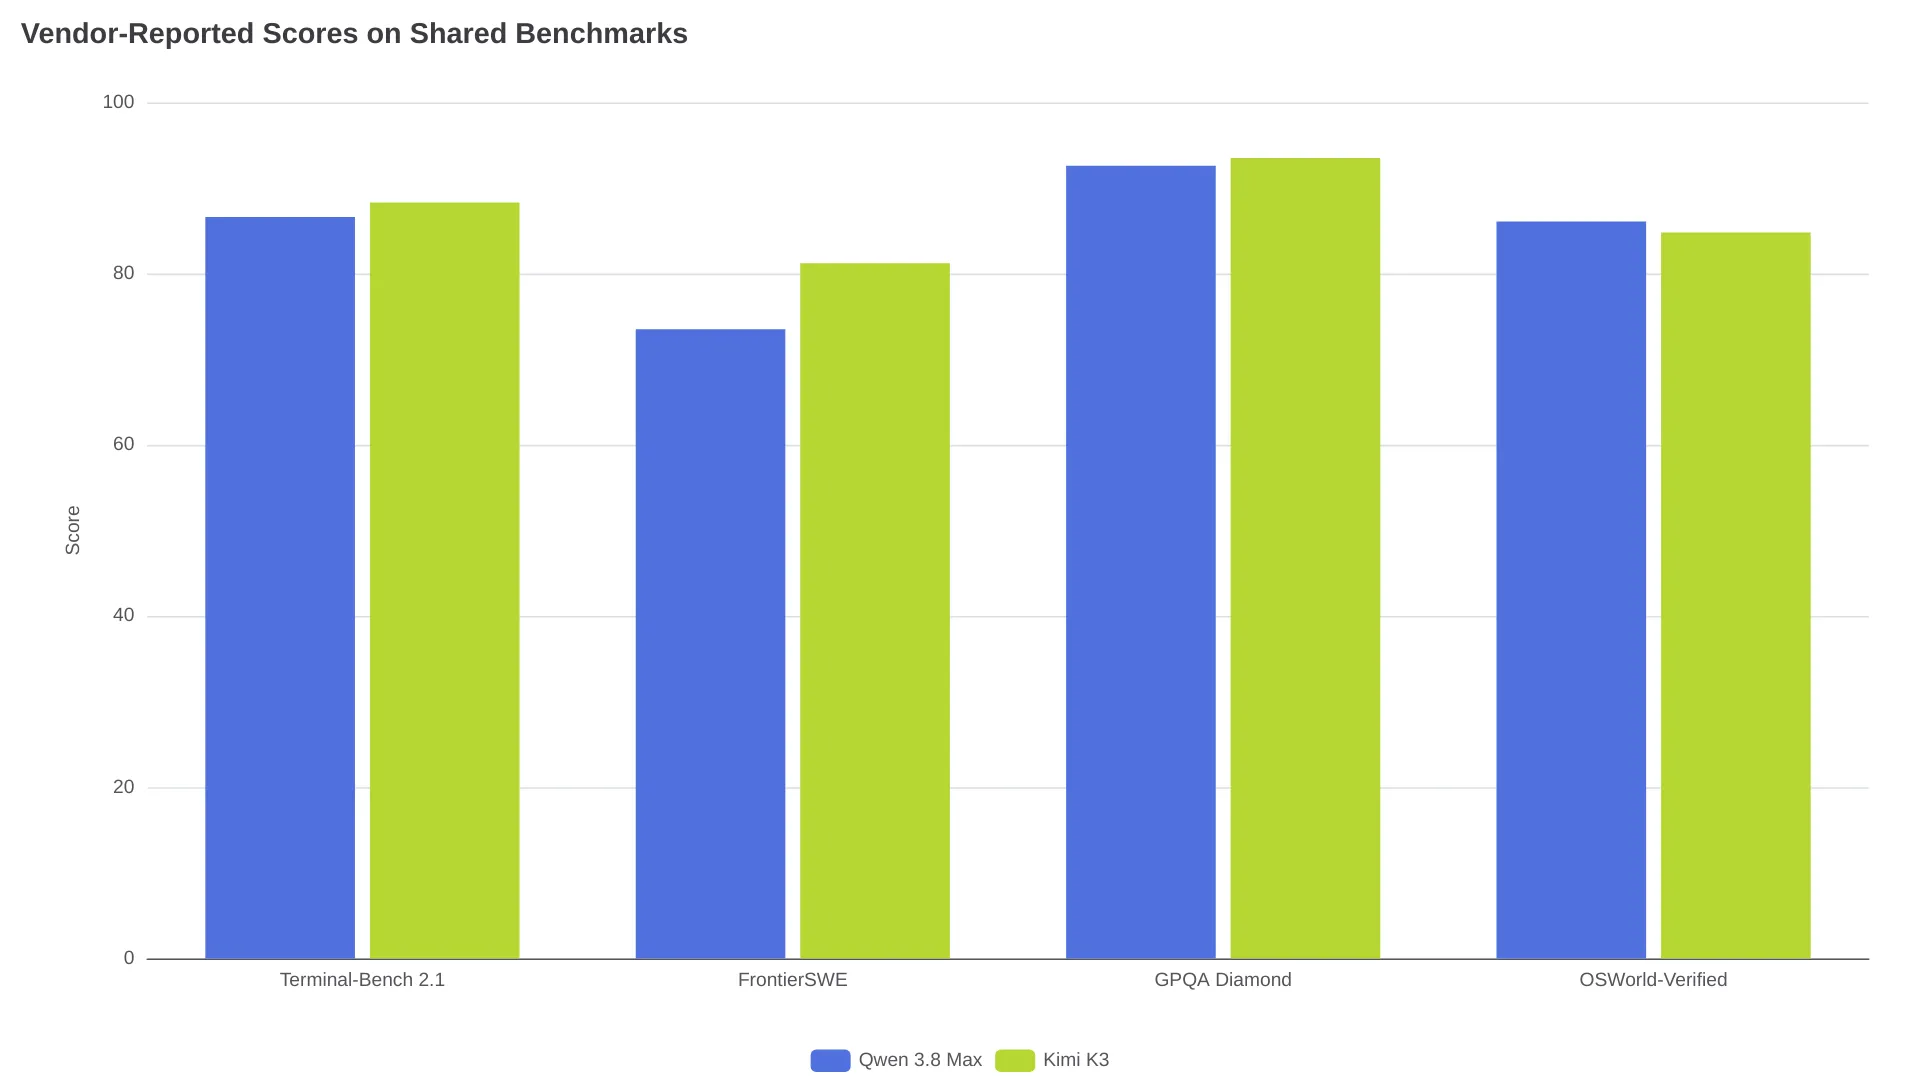
在這些共同項目中,Kimi K3 在代理式程式開發的核心測試領先。依其模型卡資料,FrontierSWE 為 81.2,優於 Qwen 的 73.5;Terminal-Bench 2.1 則為 88.3,對上 Qwen 的 86.6(Qwen 數據來自2.4T 模型卡)。Qwen 的發布資料宣稱 OSWorld-Verified 為 86.1,高於 K3 模型卡的 84.8;Qwen 的模型卡也有幾項單列亮點,包括 PaperBench 93.0、IFBench 82.8、SWE-bench Pro 67.7。至於 Qwen 未報告的項目,K3 則列出 SWE-Marathon 42.0、BrowseComp 91.2 與 MCPMark-Verified 94.5。
目前的獨立紀錄明顯偏向一方。Emergent 的追蹤資料顯示,Kimi K3 上市時 Artificial Analysis Intelligence Index 為 57,目前版本為 60,排名僅次於 Claude Fable 5 與 GPT-5.6 Sol;Orcarouter 的比較另補充,它以 1,679 Elo 拿下 Frontend Code Arena 第 1 名。Qwen 3.8 Max 上市時並未被獨立納入指數;cheapestinference.com的追蹤器報告其 Artificial Analysis 指數為 53,而社群聲稱後續升至 56 的貼文,至今仍未獲驗證。
唯一在相同任務上直接對決的測試,是 TrilogyAI 的 StackPerf 架構分析,並由Orcarouter 記錄。在預覽版 endpoint 上,K3 得分 83/100,Qwen 為 80/100。不過 Qwen 記錄到 354 次儲存庫引用,高於 Kimi 的 274 次;gateway 請求為 22 次,Kimi 則為 53 次;工具呼叫失敗次數也為 0,Kimi 為 2 次。
還有一項共同表格略過的重要數字:根據Qwen 自家模型卡,27B 在 OSWorld-Verified 拿到 84.3,幾乎貼近K3的 84.8。一款 27B 稠密模型在電腦操作能力上,與 2.8T 旗艦相差不到半分。它不在 K3 的程式開發等級——Terminal-Bench 為 73.0,對 K3 的 88.3——但 LiveCodeBench v6 的 90.3 與 SWE-bench Pro 的 61.7,足以讓它成為實用的主力模型。r/AISEOInsider 上一篇實測比較討論串也呈現相同趨勢:一次到位的建置任務,Qwen 勝出較多;但隨著上下文變長、反覆修訂加深,Kimi 會逐步拉開差距。
API 成本:$15 輸出價格與推理成本
標價的方向很明確,實際支出的差距通常更大。原因是兩款模型預設都會進行推理:K3 使用 reasoning_effort: max,Qwen 使用 xhigh,而推理 token 都按輸出 token 計費。
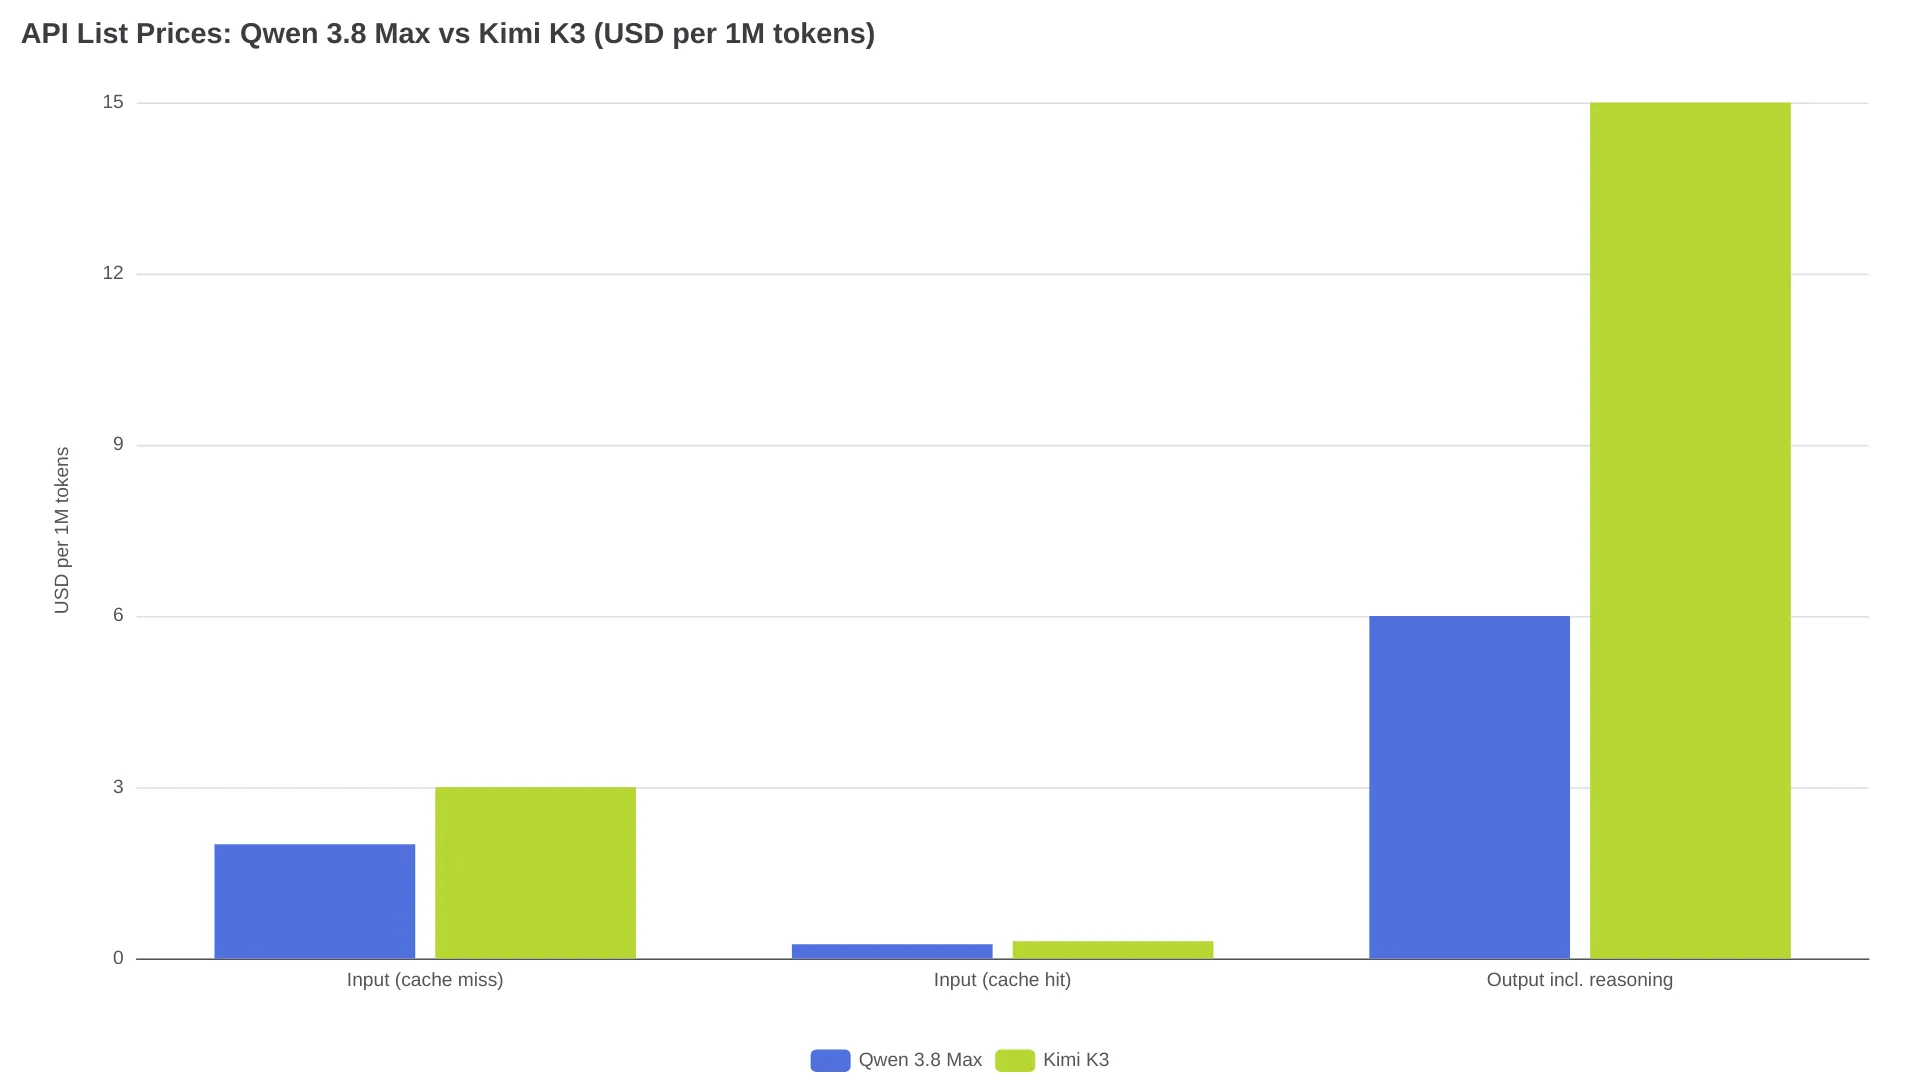
| 每 1M token | Qwen 3.8 Max(QwenCloud) | Kimi K3(Moonshot) |
|---|---|---|
| 輸入(未命中快取) | $2.00 | $3.00 |
| 輸入(命中快取) | $0.25 | $0.30 |
| 輸出,含推理 | $6.00 | $15.00 |
| 明確的快取建立/讀取 | $2.50 / $0.17 | — |
以下以 2026 年 8 月牌價試算兩種工作階段:
| 工作階段 | Qwen 3.8 Max | Kimi K3 | 差距 |
|---|---|---|---|
| 代理式程式開發:500K 輸入(60% 快取)、40K 輸出 | $0.72 | $1.29 | 1.8× |
| 全新上下文的文件管線:2M 輸入、100K 輸出 | $4.60 | $7.50 | 1.6× |
這組數字自然導出一條路由規則:只有當 K3 在你的工作負載上的驗收率,比 Qwen 高出超過約 1.8× token 成本差距時,才該把任務送往 K3。Moonshot 自己也提供了預算型替代方案:Kimi K2.7 Code 在 256K 上下文下,輸入 $0.95、輸出 $4.00;所以 Kimi 系列中最便宜的程式開發路線並不是 K3。若目前正要串接 K3,這裡列有其API endpoint與 Moonshot 公告費率;兩邊更深入的計價細節,則可參考Qwen3.8-Max 定價分析與Kimi K3 定價指南。
自架成本:1.56 TB 對上一張 RTX 4090
兩者雖然都屬於開放權重模型,但實際自架門檻相差約兩個數量級。
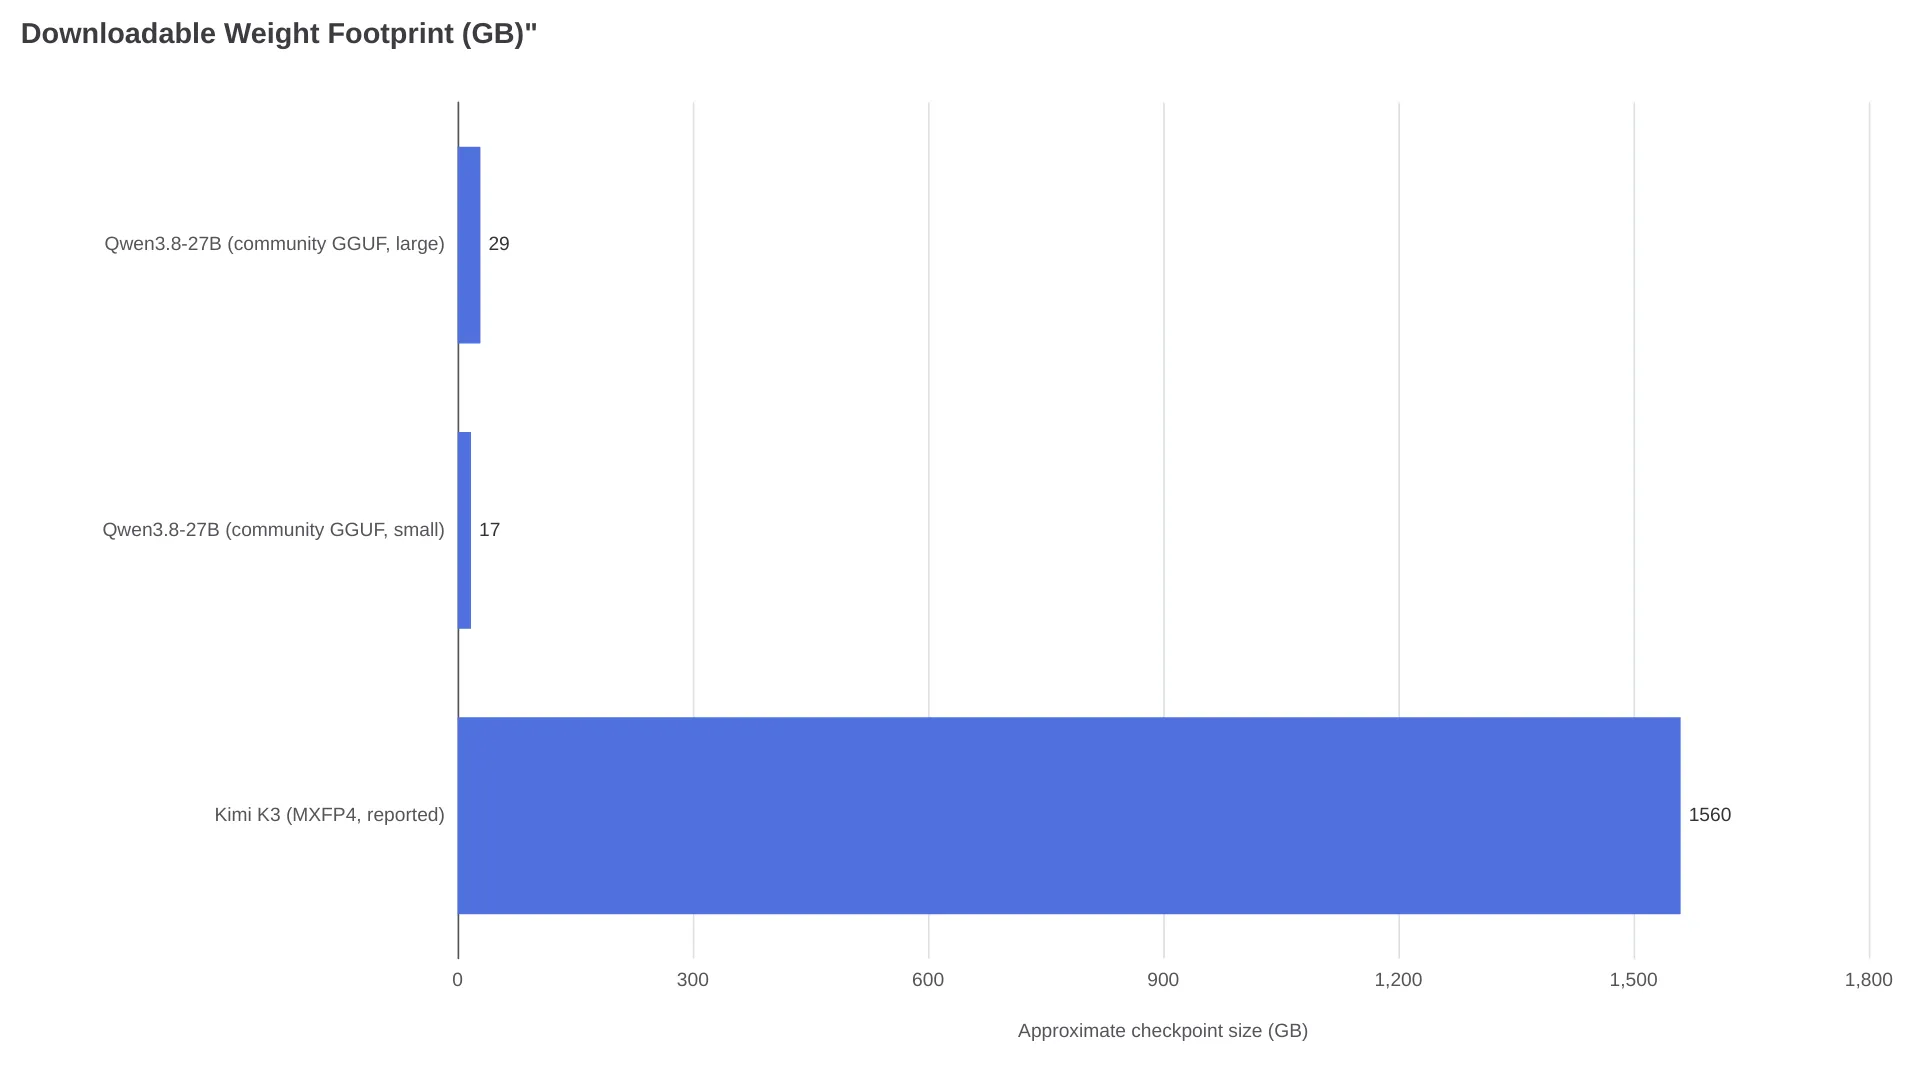
K3 提供量化感知的 MXFP4 權重(模型卡),但 checkpoint 據報達 1.56 TB,本質上仍是叢集專案;同一來源建議透過 vLLM 使用至少 64 張加速器。即使採租用方式,在產生第一個 token 前,這已是一筆實實在在的成本,還要加上授權對大規模使用的條件。
27B 則完全是另一種故事。社群製作的 GGUF 版本約落在 8.5 GB 至 28.9 GB,Unsloth 的 dynamic GGUF 與 NVFP4 版本最低約可塞進 17 GB,官方也提供適合伺服器部署的 FP8 版本。它能跑在許多人已經擁有的硬體上:
「Qwen3.8-27B 在單張 RTX 4090 上跑 160K 上下文——47–57 tok/s,全量 GPU offload」——r/Qwen_AI 部署貼文
Max 權重則介於兩者之間:Qwen3.8-2.4T-A95B及其 FP8 同系版本可依自訂 qwen3.8-max 授權下載,但公開 artifact 僅支援文字,而且推理功能無法關閉。視覺輸入、非推理模式與預設 1M 上下文都屬於 QwenCloud API 層,而非 checkpoint 本身。若想了解 27B 在各量化版本下能做與不能做什麼,可查閱含執行環境與 VRAM 表格的Qwen3.8-27B 實戰指南;K3 的權重發布細節則整理於Kimi K3 開放權重說明。
會左右代理專案成敗的整合細節
以下三項模型卡層級的行為,若等到正式上線才發現,很可能讓你多花一天除錯。
| 模型 | 行為/限制 | 實作影響 |
|---|---|---|
| Kimi K3 | 推理永遠啟用;多輪與工具使用客戶端必須重新傳送完整的先前 assistant 訊息,包含 reasoning_content 與 tool_calls(模型卡) | 省略推理軌跡會使代理迴圈表現下降;保留它,成本會隨迴圈長度增加 |
| Qwen3.8-27B | 預設啟用 preserve_thinking;reasoning_effort 可降至 medium/low;超過 262K 的 YaRN 為靜態縮放(模型卡) | 支援按請求關閉;模型卡提醒,降低推理強度不一定會縮短端到端時間,因重試可能吃掉省下的時間;只有長任務才應開啟 YaRN |
| Qwen 3.8 Max 與 K3 的上限 | Max:991.8K 輸入/131.07K 輸出(QwenCloud);K3:1,048,576 輸入/預設 131K 輸出,最高可趨近 1M | 兩者的「1M 上下文」都不代表能輸出 1M 有效 token;一項第三方針測試在 248K 找回 18/18 項事實,未測試更高範圍 |
常見問題
Qwen 3.8 寫程式比 Kimi K3 好嗎?
以現有證據來看,並非如此。Kimi K3 在關鍵的代理式程式開發項目領先,例如 FrontierSWE 81.2 對 73.5、Terminal-Bench 2.1 的 88.3 對 86.6,並且擁有唯一的獨立指數成績。Qwen 3.8 Max 在終端機工作上很接近,且每 token 與試算工作階段的成本都較低;27B 則完全是不同的權重級距。
Qwen 3.8 和 Kimi K3,哪個比較便宜?
Qwen 3.8 Max 在每一項牌價都更低:輸入 $2 對 $3,輸出 $6 對 $15。由於兩款模型都將預設啟用的推理按輸出計費,任務越困難,Kimi 的劣勢越明顯——以上述計算的快取代理工作階段來說,約為 1.8×。
兩者都能自架嗎?授權條件是什麼?
可以,三個 checkpoint 都可下載。Qwen3.8-27B 採 Apache-2.0 授權,量化後可放進單張 24 GB GPU;Kimi K3 的約 1.56 TB MXFP4 checkpoint 需要叢集級硬體,且採自訂 Kimi K3 License;Qwen3.8-Max 權重則以 Qwen3.8-2.4T-A95B 公開,使用自訂 qwen3.8-max 授權。
兩者的 1M 上下文是真的嗎?
大致上是。Kimi K3 標示為 1,048,576 token;Qwen 3.8 Max 標示 1M,最大輸入為 991.8K;27B 原生僅支援 262,144,只有透過會犧牲短上下文品質的 YaRN 縮放才能達到 1M。目前獨立驗證僅做到 248K 層級。
最終建議,以及什麼情況會改變它
| 你的使用場景 | 建議選擇 | 原因 |
|---|---|---|
| API 程式代理,以品質優先 | Kimi K3 | FrontierSWE 81.2、Terminal-Bench 88.3、AA 已驗證 60 |
| 重視成本的 API 工作、文件/視覺任務為主 | Qwen 3.8 Max | 輸出 $6 對 $15、OSWorld 86.1、明確快取讀取費為 $0.17 |
| 在自有硬體上自架 | Qwen3.8-27B | Apache-2.0、約 17–29 GB 量化版本、單張 RTX 4090 可跑 160K 上下文 |
| 自架前沿旗艦模型 | Kimi K3 | 這裡唯一擁有獨立前沿級成績的開放 checkpoint——預算請按叢集規模編列 |
有兩件事可能改變這張表的部分結論:Qwen 3.8 Max 獲得獨立評測,以及公布自訂 qwen3.8-max 授權條款。前者目前僅有追蹤器報告的 53,對比 K3 已驗證的 60,證據仍相當薄弱。在這兩件事發生前,想深入看 API 對決,可閱讀Qwen 3.8 Max vs Kimi K3 API 正面比較。
延伸閱讀: Qwen3.8-27B:已確認的資訊,以及 17GB 實際能跑什麼 · Kimi K3 開放權重 · Qwen 3.8 Max vs Kimi K3:API 版