 AIREITER
Qwen3.8-Max genel kullanıma açıldı: milyon girdi tokenı başına $2, milyon çıktı tokenı başına ise $6. Çıktı fiyatı, Claude Opus 4.8, Claude Fable 5 ve GPT-5.6 Sol'un dörtte biri ya da daha altında kalıyor. Ancak reasoning_effort varsayılan olarak xhigh ile geliyor; dolayısıyla etiket fiyatı ile ilk isteğinizden itibaren oluşan fatura aynı şey olmayabilir.
Qwen3.8-Max token fiyatları
Alibaba'nın Qwen3.7-Max'in yerini alan amiral gemisi Qwen3.8-Max, toplam 2,4 trilyon parametreli bir mixture-of-experts model. Modelin her token için 95 milyar aktif parametresi bulunuyor. Alibaba model sayfasında, "Updated: Aug 2, 2026" ibaresiyle yayımlanan fiyatlar şöyle:
| Kalem | 1 milyon token fiyatı |
|---|---|
| Girdi | $2.00 |
| Çıktı | $6.00 |
| Girdi (örtük önbellek) | $0.25 |
| Açık önbellek oluşturma | $2.50 |
| Açık önbellek okuma | $0.17 |
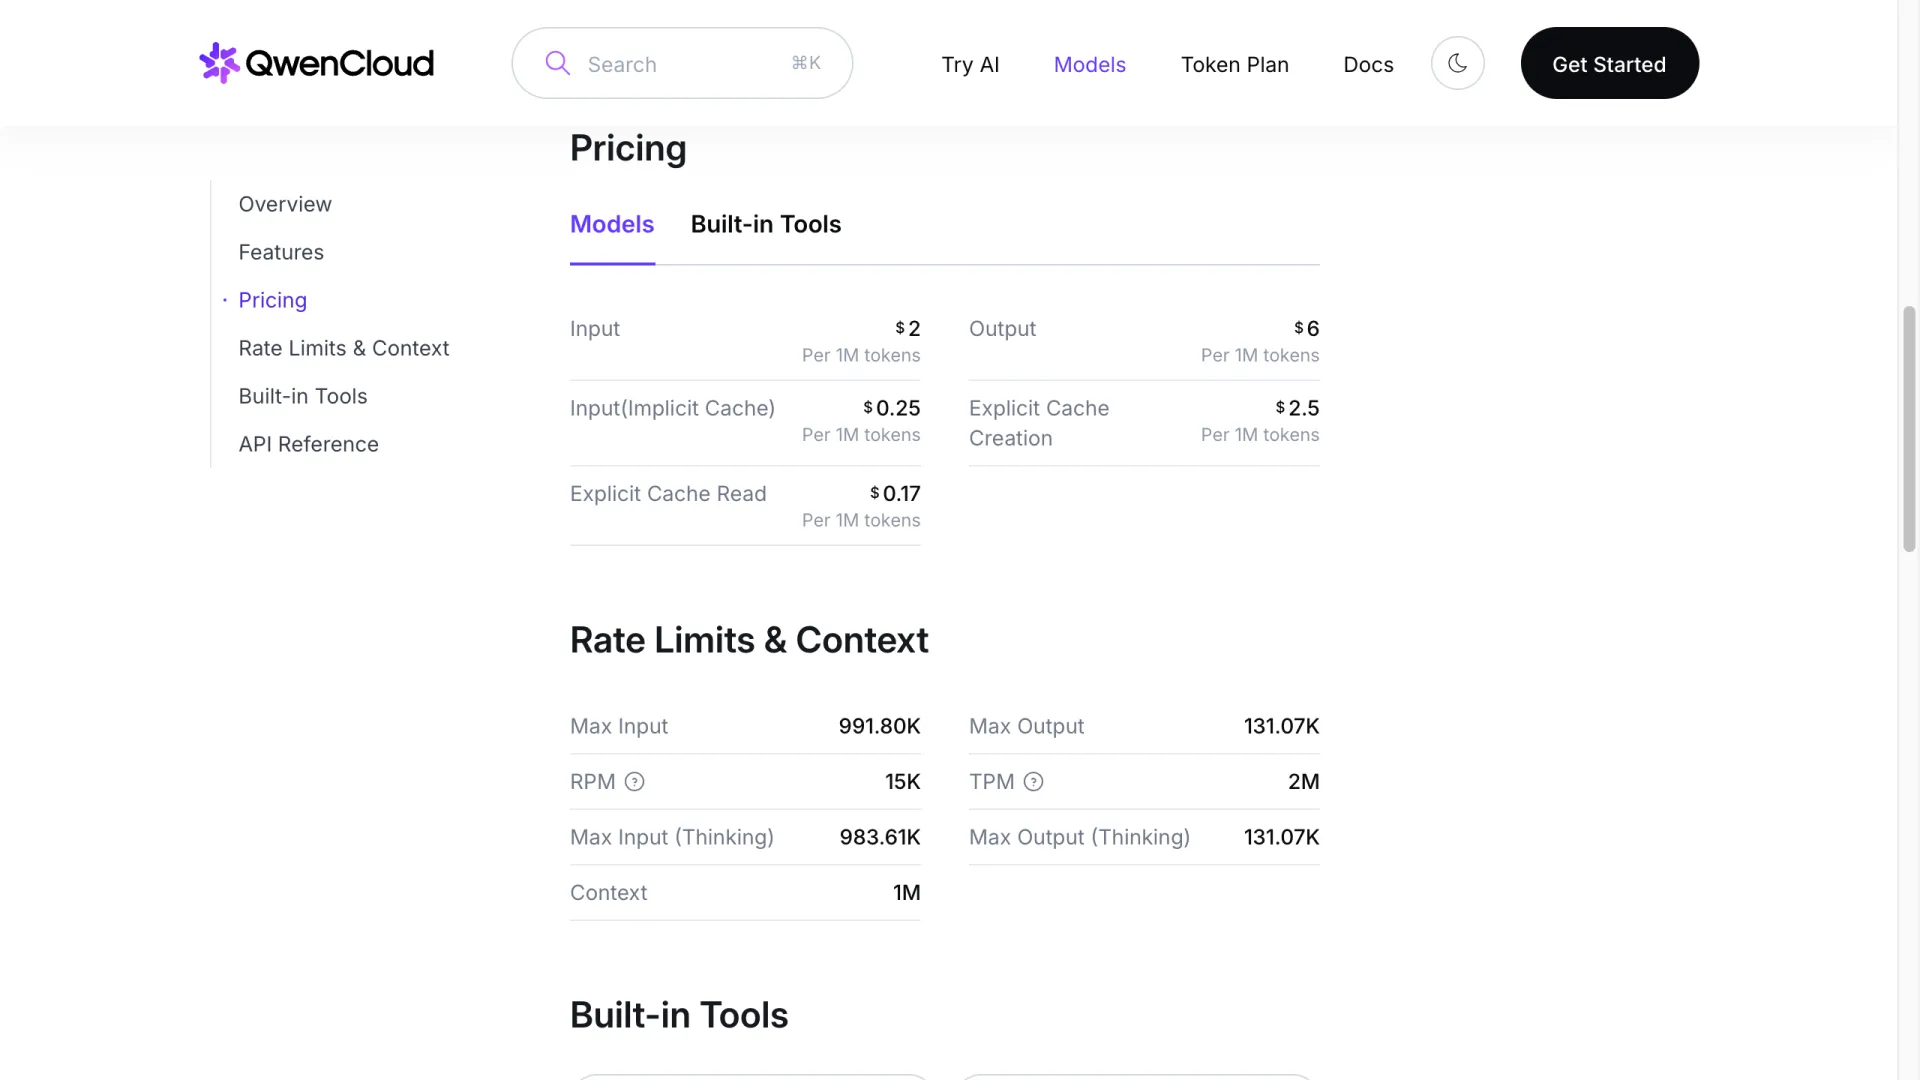
Örtük önbellek için kod yazmanız gerekmiyor. Tekrarlanan önekler otomatik olarak $0.25 üzerinden ücretlendiriliyor; bu, standart girdi fiyatının sekizde biri. Açık önbellek ise bilinçli bir tercih gerektiriyor: Yazma maliyeti $2.50, okuma maliyeti $0.17. Bu yapı, aynı önek ikinci kez okunduğunda önbelleksiz girdiden daha ucuz hale geliyor; fakat $0.25'lik örtük önbellek katmanını ancak aynı önek yaklaşık otuz kez okunduğunda geçiyor. Çoğu uygulama için açık önbelleğe dokunmamak daha mantıklı.
Burada önemli bir sınırlama var: API açık, model ağırlıkları ise henüz değil. Alibaba'nın duyurusuna göre Qwen3.8-Max ağırlıkları gelecek hafta Hugging Face ve ModelScope'a gelecek. Bu, haftalardır süren tarihsiz "coming soon" ifadesinin ardından verilen ilk takvim taahhüdü. 3 Ağustos itibarıyla model sayfasının kenar çubuğunda hâlâ Open Source: No yazıyor.
$6'lık çıktı fiyatı neden gerçek maliyeti tam göstermiyor?
Alibaba'nın lansman dokümantasyonu, reasoning_effort için üç ayar sunuyor ve varsayılanın en derin seviye olan xhigh olduğunu belirtiyor. Bunun altında, "doğruluk ve hızı dengeler" diye tanımlanan medium ile "hız ve maliyet için optimize edilmiştir" denilen low yer alıyor. Ayrıca preserve_thinking tüm senaryolarda varsayılan olarak açık. Düşünme tokenları çıktı tokenı olarak ücretlendirildiği için, daha tek bir prompt yazmadan bu iki varsayılan harcamayı $6'lık tarifeye yönlendiriyor.
Başlangıç yapılandırmasında efektif maliyeti belirleyen iki ayar da aleyhinize çalışıyor; ikisi de tek bir istek parametresiyle değiştirilebiliyor. medium veya low seviyesine inmek, gerekmeyen derin düşünme için milyon başına $6 ödemekle bu bedeli yalnızca görevin hak ettiği durumlarda ödemek arasındaki farkı yaratıyor.
Erken erişim kullananlardan biri, bu düşünme modunun sağladığı faydayı bir r/LocalLLaMA başlığında oldukça açık ifade etti:
Qwen 3.8 max first impressions - model is moderate and it is awful on thinking
Bunu bir benchmark sonucu olarak değil, varsayılan ayarı standartlaştırmadan önce kendi iş yükünüzü her efor seviyesinde test etmeniz gerektiğine işaret eden bir uyarı olarak görmek gerekir.
Uzun bağlam için ek ücret yok: farkın önem kazandığı yer
Qwen3.8-Max model sayfasında yalnızca tek bir girdi ve tek bir çıktı fiyatı var; bağlam uzunluğuna göre ayrı satırlar bulunmuyor. Buna karşılık Gemini 3.1 Pro ve GPT-5.6 Sol, belirli bir bağlam eşiğinin üzerinde daha pahalı bir fiyat bandına geçiyor:
| Model | Girdi (kısa bağlam) | Çıktı (kısa bağlam) | Girdi (uzun bağlam) | Çıktı (uzun bağlam) |
|---|---|---|---|---|
| Qwen3.8-Max | $2.00 | $6.00 | $2.00 (1M'e kadar) | $6.00 (1M'e kadar) |
| Gemini 3.1 Pro | $2.00 (≤200K) | $12.00 | $4.00 (>200K) | $18.00 |
| GPT-5.6 Sol | $5.00 | $30.00 | $10.00 | $45.00 |
Gemini 3.1 Pro, 200K tokena kadar girdi tarafında Qwen3.8-Max ile tam olarak aynı fiyatta; bu eşiğin sonrasında fiyatı ikiye katlanıyor. GPT-5.6 Sol ise uzun bağlam bandına geçildiğinde, zaten yeniden yapılandırılmış fiyat listesinin üzerinde, girdi maliyetini ikiye; çıktı maliyetini de yüzde 50 artırıyor.
Dolayısıyla bağlam uzadıkça fiyat farkı sabit kalmıyor, açılıyor. 400K tokenlık bir promptun girdi maliyeti Qwen3.8-Max'te $0.80, Gemini 3.1 Pro'da $1.60, GPT-5.6 Sol'da ise $4.00. Doküman işleme hatları, uzun ajan oturumları ve tüm repository üzerinde yapılan çalışmalar bu farkın biriktiği alanlar. Kısa sohbet turlarındaysa etkisi neredeyse hissedilmiyor.
Alibaba'nın kıyasladığı modellere göre maliyet avantajı
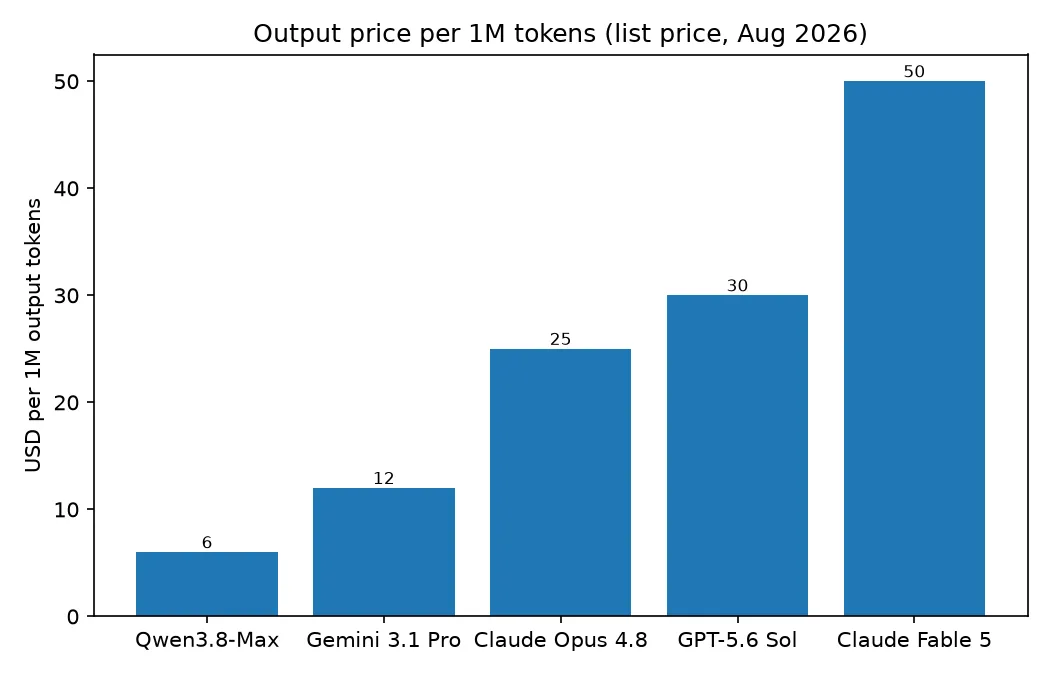
$6'lık çıktı fiyatı, Claude Opus 4.8'in $25'inin dörtte birinden düşük, GPT-5.6 Sol'un $30'ının ise beşte biri. $50'lık Claude Fable 5 tarifesi bunun sekiz katından da fazla. Bu farkın tercih etmeye değip değmeyeceği yetenek düzeyine bağlı; Alibaba da bunu savunmak için 28 satırlık bir benchmark tablosu yayımladı:
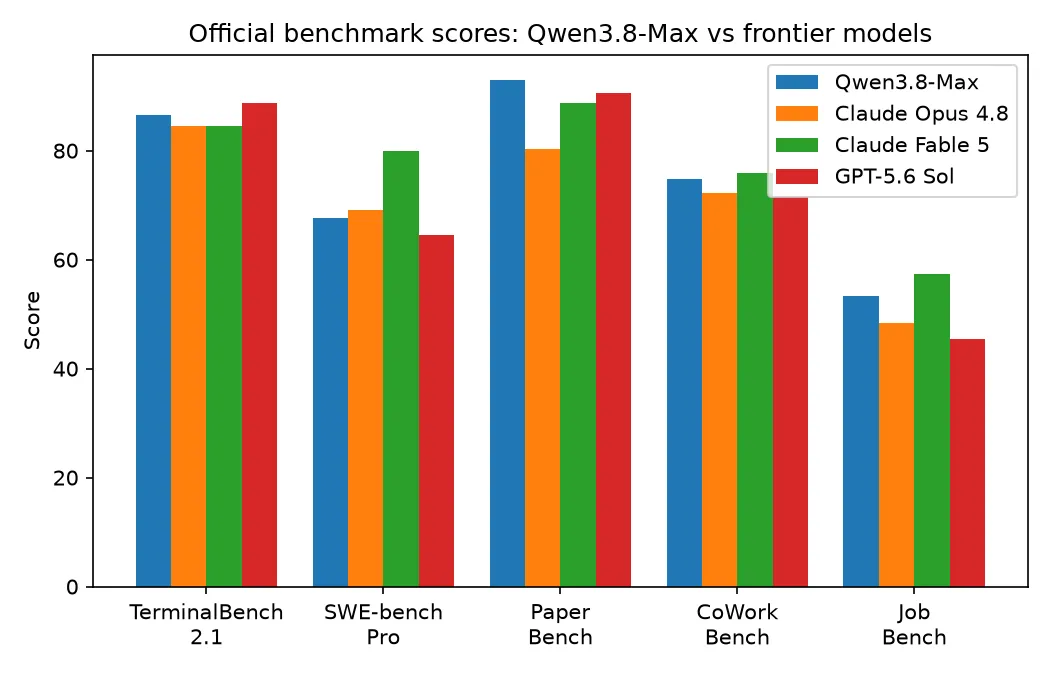
Model, PaperBench'te 93.0 puanla lider; GPT-5.6 Sol 90.5, Fable 5 ise 88.8 puanda kalıyor. JobBench'te 53.4 puanla Opus 4.8'in 48.4'ünü geçiyor; Terminal Bench 2.1'de de 86.6 ile iki Claude modelinin önüne geçiyor. Buna karşılık SWE-bench Pro'da belirgin biçimde geride: Fable 5'in 80.0 puanı, Qwen3.8-Max'in 67.7'sinden on iki puandan fazla yüksek. Bu rakamların tamamı aynı sayfada üretici tarafından yürütülmüş ve yayımlanmış sonuçlar.
Bu tablo kararı net biçimde ayırıyor. Çıktı ağırlıklı ajan işlerinde — uzun araç çağırma döngüleri, doküman üretimi ve PaperBench'in ölçtüğü araştırma yeniden üretim senaryoları — çıktıdaki 4 ila 8 kat indirim, çözümü çalıştırmanın birim ekonomisini baştan değiştirebilir. SWE-bench Pro'nun yokladığı türden repository ölçeğindeki yazılım mühendisliğinde ise bu indirim, gerçek bir yetenek kaybı karşılığında geliyor; bu yüzden Fable 5 fiyatını ödemek hâlâ anlamlı olabilir.
Bunu kendi iş yükünüzde denemek kolay. Alibaba'nın lansman yazısı, OpenAI uyumlu chat-completions ve responses çağrılarını, ayrıca Anthropic uyumlu bir arayüzü belgeliyor. Bunlar, Claude Opus 4.8 ve GPT-5.6 Sol'un kabul ettiği aynı iki istek yapısı.
Kodunuzda bugün değiştirmeniz gerekenler
Model kimliği qwen3.8-max. 3 Ağustos itibarıyla Alibaba model kataloğunda yer alan tek 3.8 girdisi bu; önizleme kimliği olan qwen3.8-max-preview kaldırılmış durumda. Bu nedenle, genel kullanıma geçişten sonra önizleme indiriminin devam ettiğini varsaymadan önce relay sağlayıcınızı kontrol edin.
Her iki arayüz de üç bölgesel temel URL üzerinden sunuluyor: Pekin, Singapur ve ABD Virginia. İlk karşılaşacağınız sınırlar şöyle:
| Limit | Değer |
|---|---|
| Bağlam penceresi | 1M |
| Maksimum girdi | 991.80K |
| Maksimum girdi (thinking) | 983.61K |
| Maksimum çıktı | 131.07K |
| Dakika başına istek | 15K |
| Dakika başına token | 2M |
İki girdi tavanı arasındaki yaklaşık 8K tokenlık farka dikkat edin: Thinking'i açmak yalnızca çıktı tokenı tüketmiyor, girdi için kullanılabilir alanı da azaltıyor. Gelecek hafta ağırlıklar gerçekten yayımlanırsa, self-hosting maliyetini $2/$6 tarifesiyle karşılaştırmaya başlarken temel referans 95B aktif parametre sayısı olacak.
Sık sorulan sorular
Qwen API ücretsiz mi?
Hayır. Qwen3.8-Max, milyon token başına $2 girdi ve $6 çıktı üzerinden ücretlendiriliyor. Alibaba'nın API platformunda satılan Token Plan aboneliği, token bazlı API faturalandırmasından ayrı, kredi temelli bir ürün.
Qwen Max ne kadar?
Güncel nesilde fiyat, milyon girdi tokenı başına $2 ve milyon çıktı tokenı başına $6; örtük önek önbellekleme ise $0.25. Alibaba Cloud dokümantasyonundaki eski qwen-max kayıtları önceki nesillere ait ve farklı fiyatlar taşıyor.
Qwen3.8-Max, 1M bağlam penceresi için ek ücret alıyor mu?
Hayır. Girdi ve çıktı, 5K tokenda da 900K tokenda da aynı fiyatla ücretlendiriliyor. Bu, GPT-5.6 Sol ve Gemini 3.1 Pro'ya göre en net yapısal fark.
Qwen3.8-Max, Qwen3.7-Max'ten daha mı ucuz?
Resmi sayfalardan bu sorunun yanıtı çıkarılamıyor. Qwen3.7-Max model sayfası, token başı fiyatları göstermek yerine %50 indirim ibaresinin arkasında -- olarak sunuyor; dolayısıyla karşılaştırılabilecek yayımlanmış bir rakam yok.
İlgili okumalar
- Claude Fable 5 fiyatlandırması: Bu karşılaştırmadaki $10/$50 katmanı
- Claude Fable 5 token maliyetlerini düşürme: Farklı bir sağlayıcıda aynı efor ve önbellekleme ayarları