 AIREITER
Qwen-UI-Agent, açıklanan karşılaştırmalarda özellikle mobil kullanımda dikkat çekici sonuçlar veriyor: gerçek cihazlarda çalışan MobileWorld-Real testinde %92,2, AndroidDaily'de ise %97,5. Ancak bu rakamların arkasındaki 27B model için doğrulanmış herkese açık ağırlıklar ya da API bulunmuyor. Şimdilik teknik raporu okuyabilir, demoları izleyebilir ve yalnızca daha küçük MAI-UI öncüllerini indirebilirsiniz. Bu rehber, liderlik tablosundaki iddialarla gerçek erişim durumu arasındaki farkı netleştiriyor; tüm resmi skorları ve bugün elinize geçebilecek kaynakları bir araya getiriyor.
Qwen-UI-Agent'in eksiksiz benchmark tablosu
Alibaba'nın Tongyi-MAI ekibi tarafından 30 Temmuz 2026 tarihinde teknik rapor olarak yayımlanan Qwen-UI-Agent (arXiv 2607.28227), mobil, bilgisayar kullanımı, web ve DeepSearch ortamlarını tek bir temel GUI ajanında buluşturuyor. GUI işlemleri, CLI komutları ve toplu eylem dizilerini kapsayan birleşik bir aksiyon alanına sahip. Resmi sonuç sayfasındaki verilere göre model, gösterilen tüm mobil ve grounding benchmarklarında ilk sırada; OSWorld-Verified'da ikinci, uzun ufuklu OSWorld-v2 testinde ise üçüncü. Raporda 27B, 35B-A3B ve 4B sürümleri değerlendirilse de aşağıdaki skorlar amiral gemisi 27B modele ait.
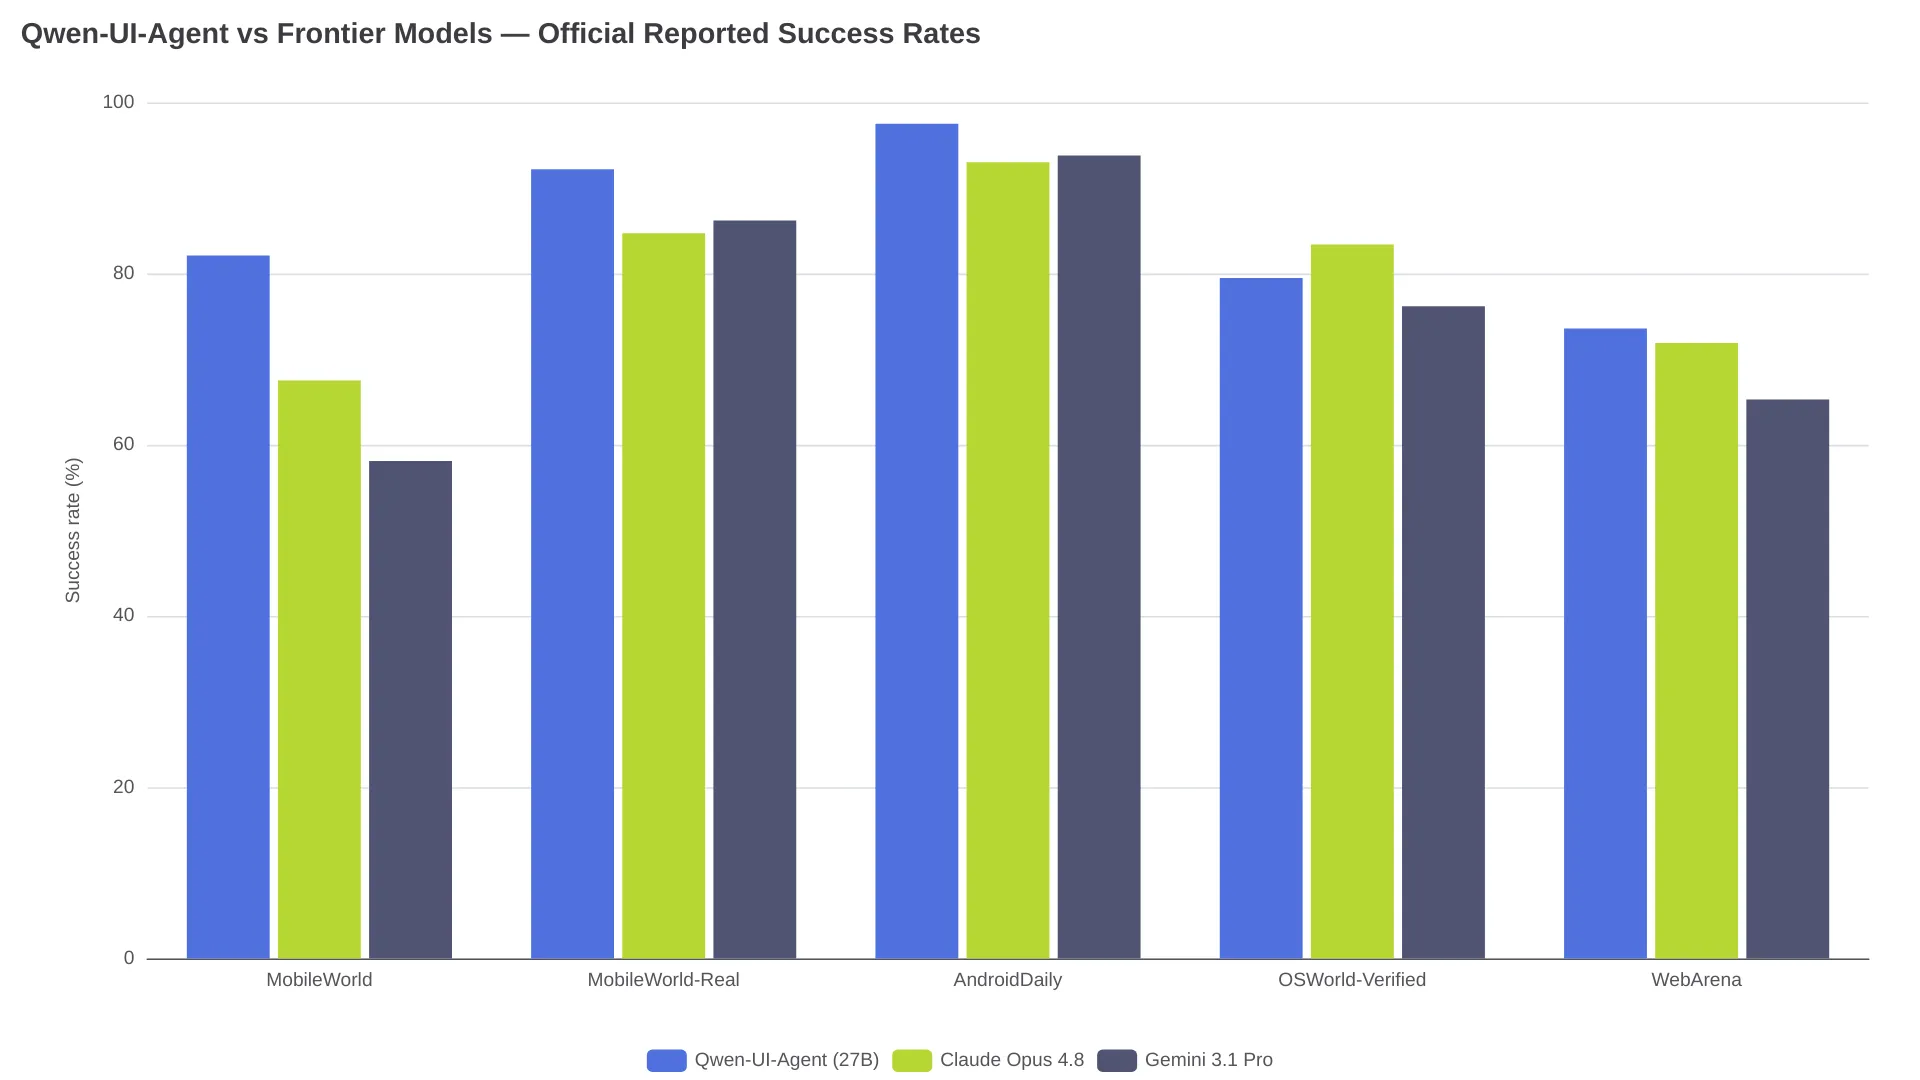
Mobilde açık ara liderlik iddiası
Raporun en güçlü iddiası mobil tarafta ve farklar küçük değil. MobileWorld'ün yalnızca GUI içeren bölümünde Qwen-UI-Agent %82,1'e ulaşıyor. Bu skor, en yakın genel amaçlı model olan Seed 2.1 Pro'nun (%73,2) 8,9 puan; en güçlü uzmanlaşmış GUI ajanı GUI-Owl-1.5-32B-Instruct'un (%43,9) ise 38,2 puan önünde.
| Model | MobileWorld (yalnızca GUI) | MobileWorld-Real | AndroidDaily |
|---|---|---|---|
| Qwen-UI-Agent (Alibaba) | 82.1 | 92.2 | 97.5 |
| Seed 2.1 Pro (ByteDance) | 73.2 | 88.7 | 95.2 |
| Claude Opus 4.8 (Anthropic) | 67.5 | 84.7 | 93.0 |
| Gemini 3.1 Pro (Google) | 58.1 | 86.2 | 93.8 |
| Qwen 3.7 Plus (Alibaba) | 62.3 | 72.7 | 79.8 |
Resmi tablolarda mobil satırlar için GPT-5.6 Sol (70.1 / 85.4 / 92.6), masaüstü satırları içinse GPT-5.5 kullanılıyor. Tek bir "GPT" skorunu aktarmadan önce bu ayrımı bilmek önemli.
Öne çıkarılan benchmark MobileWorld-Real, yazarların kendi geliştirdiği bir test. Yedi günlük kullanım alanında 104 gerçek Android uygulamasını kapsayan 409 uçtan uca görevden oluşuyor. Testler gerçek hesaplarla, canlı cihazlarda ve gerçek dünyadaki kesintiler eşliğinde yürütülüyor; değerlendirmeyi ise beş VLM'nin çoğunluk oyu yapan jürisi gerçekleştiriyor.
Masaüstünde güçlü ama zirvede değil
Masaüstü sonuçları, rapordaki "rekabetçi" ifadesinin neden temkinli kullanıldığını gösteriyor. Qwen-UI-Agent, OSWorld-Verified'da %79,5 ile ikinci sırada ve Claude Opus 4.8'in 3,9 puan gerisinde. Uzun ufuklu OSWorld-v2'deki %40,0 değeri ise kısmi ilerleme skoru; ikili tamamlama oranı %13,9. Claude Opus 4.8 (%54,8) ve GPT-5.5 (%49,5) bu ölçütte belirgin biçimde önde.
| Model | OSWorld-Verified | OSWorld-v2 (kısmi) | OSWorld-v2 (ikili) |
|---|---|---|---|
| Claude Opus 4.8 | 83.4 | 54.8 | raporlanmadı |
| Qwen-UI-Agent | 79.5 | 40.0 | 13.9 |
| Seed 2.1 Pro | 78.8 | raporlanmadı | raporlanmadı |
| GPT-5.5 | 78.7 | 49.5 | 13.0 |
| MiniMax M3 | raporlanmadı | 22.3 | raporlanmadı |
Bununla birlikte verimlilik tarafında somut bir avantaj var. Toplu eylemler sayesinde görev başına ortalama adım sayısı 135,8'e iniyor; bu değer MiniMax M3 için 326,7, Qwen 3.7 Plus için 173,5. Model ayrıca kısmi ilerleme ölçütünde tüm açık ağırlıklı modelleri 17 puandan fazla farkla geçiyor. OSWorld-v2'de ajan işlemlerinin %50'sinden fazlasını CLI komutları oluşturuyor; hibrit GUI+CLI tasarımı burada ölçülebilir katkı sağlıyor.
Tarayıcı ve DeepSearch sonuçları
WebArena'da Qwen-UI-Agent %73,6 ile ilk sırada; Claude Opus 4.8 (%71,9), GPT-5.5 (%69,5) ve Gemini 3.1 Pro'yu (%65,3) geride bırakıyor. Araştırma odaklı benchmarklarda BrowseComp skoru, Qwen3.5-27B temel modelinin %61,0 değerine karşı %64,1; BrowseComp-ZH'de ise %62,1'e karşı %75,0. Yani DeepSearch eğitiminin katkısı yalnızca ekranda doğru noktaya tıklamakla sınırlı değil.
GUI grounding'de tam üstünlük
Görsel bir komuttan doğru piksele tıklama becerisi olarak özetlenebilecek grounding alanında sonuçlar net: resmi sonuç sayfasına göre Qwen-UI-Agent, gösterilen tüm grounding benchmarklarında ilk sırada yer alıyor.
| Benchmark | Qwen-UI-Agent | En iyi rakip |
|---|---|---|
| ScreenSpot-Pro (yakınlaştırmasız) | 76.6 | 72.9 (GUI-Owl-1.5) |
| ScreenSpot-Pro (yakınlaştırmalı) | 81.5 | 80.7 (Seed 2.1 Pro) |
| SS-V2 | 97.5 | 96.6 (Seed 2.1 Pro / Qwen 3.7 Plus) |
| MM-GUI-L2 | 92.6 | 91.3 (MAI-UI) |
| OSW-G-R | 78.5 | 78.2 (Qwen 3.7 Plus) |
| UI-Vision | 70.0 | 68.0 (Qwen 3.7 Plus) |
Genel amaçlı becerilerden verilen ödün küçük
GUI odaklı modeller, çoğu zaman genel dil modeli yeteneklerinden kaybediyor. Qwen-UI-Agent'te bu kayıp neredeyse yok: MMLU-Pro'da Qwen3.5-27B'nin %86,0 değerine karşı %86,5, IFEval'de ise %90,4'e karşı %90,2 alıyor. Uzmanlaşmış GUI modelleriyle arasındaki fark ise çok daha keskin.
| Benchmark | Qwen-UI-Agent | Qwen3.5-27B | UI-Venus 30B-A3B | GUI-Owl 32B | OpenCUA-72B |
|---|---|---|---|---|---|
| Tau2-Bench | 89.9 | 89.2 | 22.7 | 6.1 | 14.4 |
| Terminal-Bench 2.0 | 50.1 | 41.1 | 3.2 | 0.0 | 9.0 |
| BFCL-v4 | 74.2 | 71.3 | 19.8 | 32.7 | 28.3 |
| BrowseComp | 64.1 | 61.0 | raporlanmadı | raporlanmadı | raporlanmadı |
| QwenClawBench | 44.2 | 48.5 | 6.4 | 5.1 | 11.4 |
Kendi temel modeline karşı görünen tek kayıp QwenClawBench'te: %44,2'ye karşı %48,5. Ayrıca resmi sayfa, bu daha geniş yetenek benchmarklarındaki skorların yazarların kendi değerlendirme ortamında yeniden üretildiğini belirtiyor.
Qwen-UI-Agent nasıl eğitildi?
Teknik rapora göre Qwen-UI-Agent'in eğitim verisi, 150'den fazla uygulamayı kapsayan 100'den fazla fiziksel telefondan oluşan gerçek cihaz filosundan geliyor. Ajan odaklı bir veri döngüsü, görevleri kendi kurup teşhis ederek bu havuzu besliyor. Denetimli ince ayarın ardından, 10.000'den fazla eşzamanlı ortamda yürütülen ve 100 turu aşan rotalar üzerinde çok aşamalı RL uygulanıyor.
Bu skor tablosuna ne kadar güvenilmeli?
Resmi sayfada yer alan ve her alıntılanan skorla birlikte anılması gereken üç önemli çekince bulunuyor. İlk olarak MobileWorld-Real, doğrudan yazarların geliştirdiği bir benchmark. İkinci olarak hançer işareti taşıyan temel model skorları, yazarlar tarafından kendi ortamlarında yeniden üretilmiş; test altyapısı, jüri, simülatör ve görev alt kümeleri diğer sağlayıcıların resmi değerlendirmelerinden farklı olabilir. Üçüncüsü, OSWorld-v2'deki %40,0 değeri başarı oranı değil, kısmi ilerleme skoru. (Kaynak: resmi sonuç sayfası notları ve teknik rapor.)
"Alibaba'nın yeni GUI ajanı telefonda kazanıyor, masaüstünde ise takılıyor." - X'te @Daily_AI_Brief; paylaşım ayrıca "Alibaba'nın tüm temel modelleri kendi ortamında puanladığını" belirtiyor.
X üzerindeki bağımsız değerlendirmeler de benzer bir sonuca vardı. @itarutomy tarafından hazırlanan Japonca inceleme, gerçek cihazlardaki mobil liderliğe dikkat çekerken masaüstü skorlarının ikinci sırada kaldığını vurguladı. Tongyi Lab'den Pengxiang Li'nin (@oliverlee1999) resmi duyuru dizisi ise sürümün birincil kaynağı. Kısacası MobileWorld-Real'i bağımsız yeniden üretim bekleyen güçlü bir iddia olarak görmek; OSWorld-Verified'ı ise daha taşınabilir karşılaştırma kabul etmek gerekiyor. Bu benchmark, yazarların ortaya çıkardığı bir çalışma değil.
Qwen-UI-Agent'e bugün nasıl erişilir?
Qwen-UI-Agent şu anda bir araştırma sürümü niteliğinde: makale, proje sayfası ve kod depoları var, ancak modelin kendisine ait doğrulanmış bir herkese açık checkpoint yok. Herkese açık her bileşenin sundukları şöyle.
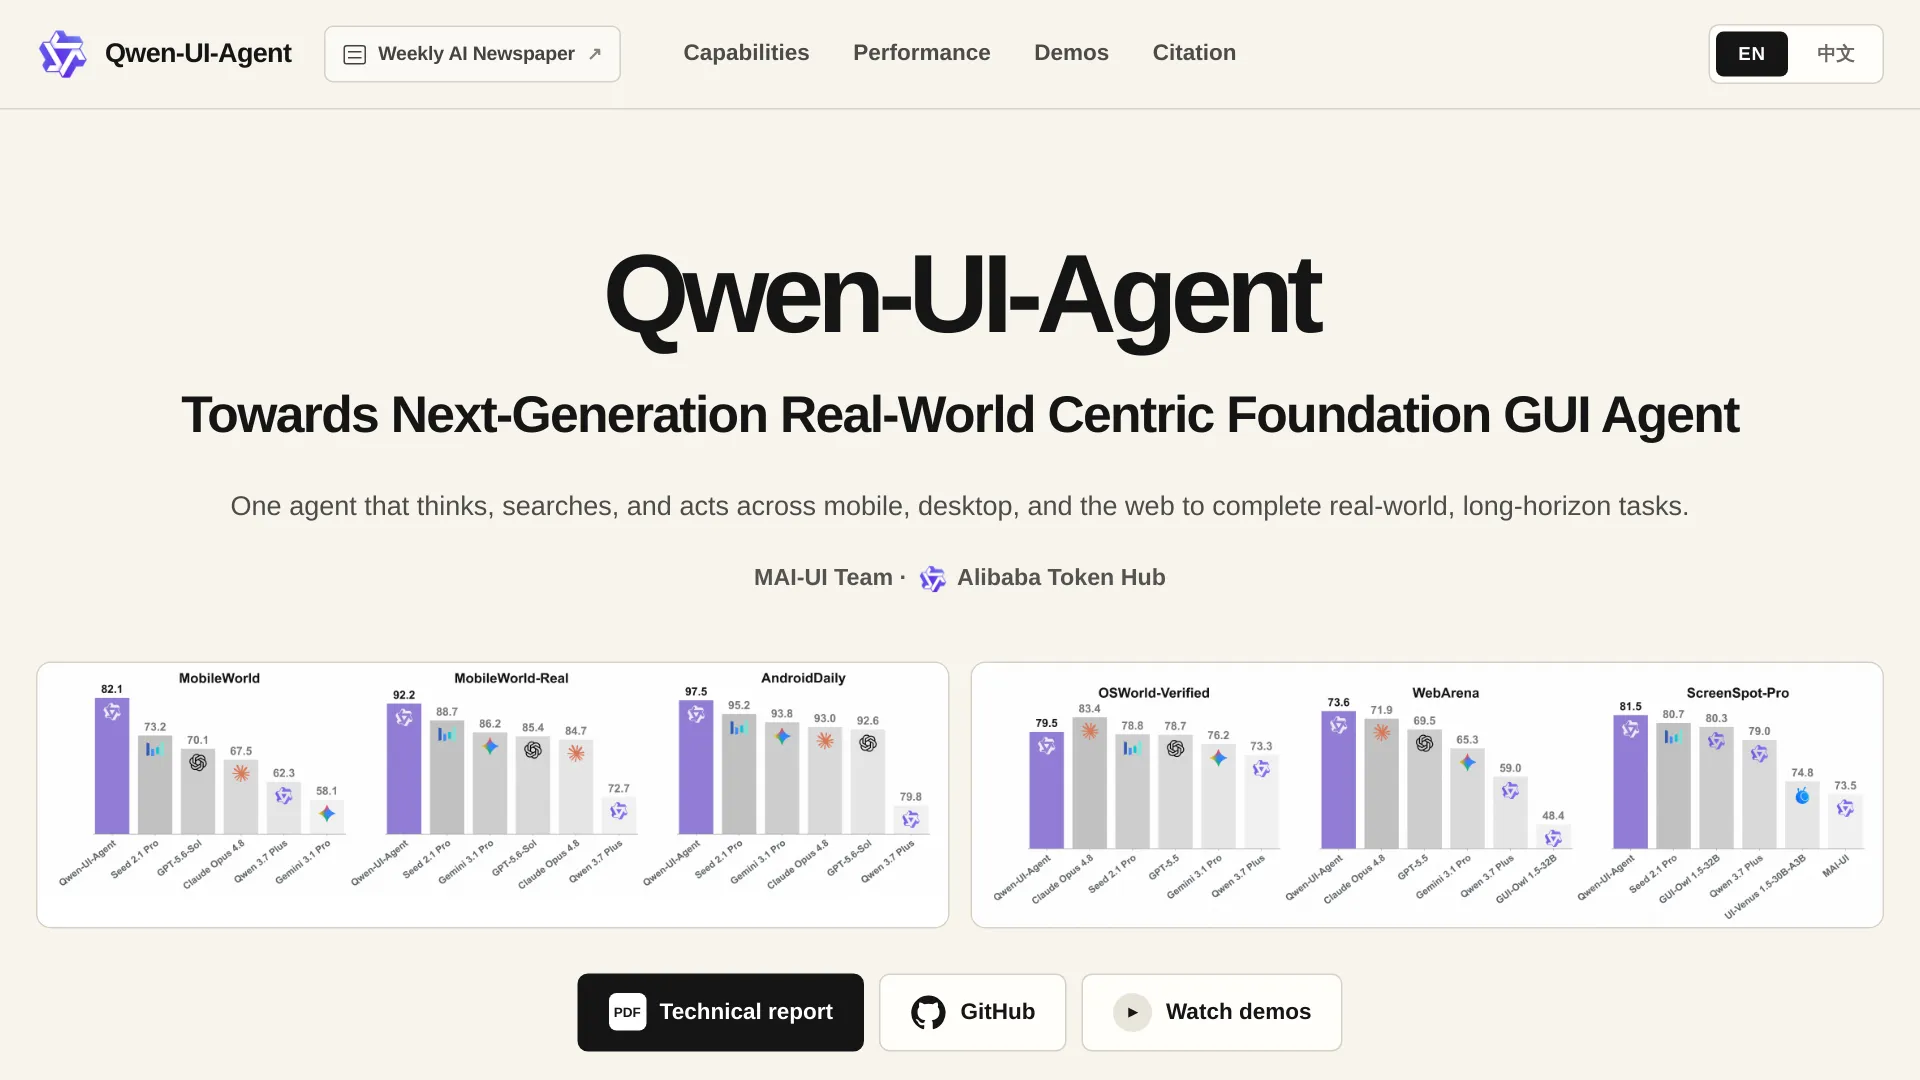
Herkese açık kaynakların denetimi
| Kaynak | Bağlantı | İçeriği |
|---|---|---|
| Teknik rapor | arxiv.org/abs/2607.28227 | 30 Temmuz 2026'da gönderilen tam makale; PDF, HTML ve TeX kaynakları |
| Proje sayfası | tongyi-mai.github.io/Qwen-UI-Agent | Yetenek demoları, eksiksiz benchmark grafikleri, atıf bilgileri |
| MAI-UI deposu | github.com/Tongyi-MAI/MAI-UI | Qwen-UI-Agent için yeniden adlandırılmış Apache-2.0 deposu; Aralık 2025'te yayımlanan MAI-UI-8B ve MAI-UI-2B Hugging Face checkpointlerine bağlantılar içeriyor |
| Qwen-UI-Agent deposu | github.com/Tongyi-MAI/Qwen-UI-Agent | Yalnızca web sitesi kaynak kodu; depo, model, eğitim kodu veya ajan uygulaması içermediğini açıkça belirtiyor |
MAI-UI deposu, bu serinin resmi devam merkezi konumunda. Qwen-UI-Agent'i 30 Temmuz 2026'da duyurdu ve bugün bu soyda indirilebilen tek checkpointlere bağlantı veriyor.
Ağırlıkların mevcut durumu
İndirilebilen tek checkpointler, MAI-UI deposunun Hugging Face referanslarında bağlantısı bulunan Aralık 2025 tarihli öncüller MAI-UI-8B ve MAI-UI-2B. Qwen-UI-Agent 27B, 35B-A3B veya 4B için doğrulanmış herkese açık bir checkpoint bulunmuyor. Buradaki erişim durumu, Ağustos 2026'nın sonlarında resmi depolar ve proje sayfası üzerinden kontrol edildi; hiçbirinde bir sürüm ortaya çıkmadı. MAI-UI checkpoint bağlantılarını veya web sitesi kaynak deposunu Qwen-UI-Agent model ağırlıkları olarak değerlendirmeyin.
Henüz API de yok, yerel kurulum da
Resmi kanallarda herkese açık bir Qwen-UI-Agent API uç noktası, barındırılan ürün ya da vLLM/Ollama paketi görünmüyor. Bugün pratik seçenekler sınırlı: üretime almanız gereken masaüstü iş akışları için açıklanan OSWorld sonuçları Claude Opus 4.8'i işaret ediyor; açık ağırlıklı GUI denemeleri için ise kendi altyapınızla MAI-UI 2B/8B kullanmak mümkün. Ancak bunun Qwen-UI-Agent değil, MAI-UI olduğunu unutmamak gerek. Sürüm duyuruları için resmi Tongyi-MAI depolarını ve Qwen kanallarını takip edin. API erişimi bulunan genel amaçlı Qwen serisi için AIReiter Qwen model kataloğu, güncel uç noktaları ve fiyatları takip ediyor.
Qwen-UI-Agent, Alibaba'nın GUI ajan ailesinde nerede?
Qwen-UI-Agent, Alibaba'nın GUI ajan serisinin üçüncü nesli. UI-TARS, 2025'te Qwen tabanlı GUI yaklaşımının öncülüğünü yaptı. MAI-UI (arXiv 2512.22047, Aralık 2025), gerçek dünya odaklı veri döngüsünü tanıttı ve 2B/8B ağırlıklarını açık kaynak olarak yayımladı. Qwen-UI-Agent ise bu yaklaşımı hibrit GUI+CLI yürütmeyle 27B ölçeğine taşıyor. Yukarıdaki tablolarda Claude Opus 4.8'in her iki OSWorld metriğinde de lider olduğu görülüyor.
Qwen-UI-Agent hakkında sık sorulan sorular
Qwen-UI-Agent açık kaynak mı?
Kod depoları Apache-2.0 lisanslı, rapor da herkese açık; ancak modelin kendisi için açık ağırlık durumu doğrulanmış değil. Yalnızca öncül MAI-UI-8B ve MAI-UI-2B checkpointleri indirilebiliyor (Hugging Face, Aralık 2025). Bu yazının hazırlandığı tarihte 27B, 35B-A3B veya 4B Qwen-UI-Agent checkpointi için doğrulanmış herkese açık bir sürüm yoktu.
Qwen-UI-Agent bugün yerelde çalıştırılabilir mi?
Hayır. Doğrulanmış bir yerel kurulum bulunmuyor: checkpoint, GGUF veya Ollama paketi ya da vLLM tarifi yok. Yerel denemeler, kendi altyapınızla MAI-UI 2B/8B kullanımıyla sınırlı.
Qwen-UI-Agent API'si var mı?
Herkese açık bir uç nokta veya barındırılan ürün duyurulmadı. Sürüm duyuruları için resmi Tongyi-MAI GitHub depolarını ve Qwen ekibinin kanallarını takip edin.
Bilgisayar kullanımı açısından Qwen-UI-Agent, Claude Opus 4.8 ile nasıl karşılaştırılıyor?
Claude Opus 4.8, OSWorld-Verified'da 83.4'e karşı 79.5; OSWorld-v2 kısmi ilerleme ölçütünde ise 54.8'e karşı 40.0 ile önde. Buna karşılık Qwen-UI-Agent, WebArena'da 73.6'ya karşı 71.9 ile ve gösterilen tüm mobil benchmarklarda lider. Uzun ufuklu masaüstü işleri şu anda Claude lehine; Qwen-UI-Agent'in açıklanan verilerde en güçlü olduğu alan ise mobil odaklı kullanım.
MobileWorld-Real nedir?
Qwen-UI-Agent yazarlarının geliştirdiği gerçek cihazlı bir Android benchmarkı. Yedi günlük kullanım alanında 104 canlı uygulamayı kapsayan 409 görev içeriyor ve beş VLM'nin çoğunluk oyu yapan jürisiyle puanlanıyor. Sonuçları yazarların kendi beyanı niteliğinde; bağımsız yeniden üretim bekliyor.
Bu değerlendirmeyi neler değiştirebilir?
Üç gelişme, mevcut tabloyu önemli ölçüde değiştirebilir:
| Sinyal | Neden önemli? |
|---|---|
| Tongyi-MAI'nin Hugging Face varlığı altında bir Qwen-UI-Agent checkpointi | Araştırma sürümünü geliştirilebilir bir seçeneğe dönüştürür ve üçüncü taraf benchmarklarını tetikler |
| Alibaba'nın test altyapısı dışında bir OSWorld-Verified yeniden üretimi | %79,5'lik sonucun yazarların ortamı dışında da geçerli olup olmadığını netleştirir |
| Herhangi bir ürün yüzeyi: API, Qwen uygulaması entegrasyonu veya önizleme | Karşılaştırmayı makale tablolarından üretim ortamındaki ödünleşimlere taşır |
O zamana kadar temel belirsizlik devam ediyor: şimdiye dek yayımlanan karşılaştırmalardaki mobil kullanım liderliği, aynı ekibin oluşturduğu benchmark üzerindeki öz raporlanmış sonuçlara dayanıyor.
İlgili okumalar: Alibaba'nın daha yeni genel amaçlı amiral gemisi ve açık ağırlık durumu Qwen3.8-Max open weights yazısında, uç nokta maliyetleri ise Qwen3.8-Max API pricing guide içinde ele alınıyor.