 AIREITER
Üç hafta boyunca "çok yakında" denmesinin ardından Qwen3.8-2.4T-A95B ağırlıkları 12 Ağustos 2026'da ModelScope üzerinde yayınlandı. Manşetlik rakam 2,4 trilyon toplam parametre; ancak her token için yalnızca 95 milyar parametre etkinleşiyor. Asıl mesele şu: 4 bit kuantizasyonda bile model yaklaşık 1,2 TB VRAM kaplıyor. Dolayısıyla veri merkezi dışındaki kullanıcıların bunu yerel olarak çalıştırması neredeyse mümkün değil. Bu yazıda yayınla birlikte nelerin geldiğine, kullanım maliyetlerine ve hangi durumlarda API'nin tek mantıklı seçenek olduğuna bakıyoruz.
Qwen3.8-2.4T-A95B Ağırlıkları İndirilebilir Durumda
Ağırlıklar artık erişime açık. Alibaba'nın Qwen ekibi, Qwen3.8-2.4T-A95B kontrol noktasını 12 Ağustos'un ilerleyen saatlerinde ModelScope topluluk hesabı üzerinden yayınladı. Böylece bu model, açık ağırlıklarla sunulan ilk Qwen Max sınıfı model oldu. Önceki üç Qwen Max modeli olan Qwen3.5-Max, Qwen3.6-Max ve Qwen3.7-Max yalnızca API üzerinden kullanılabiliyordu.
İsimlendirme tarafında önemli bir ayrım var. "Qwen3.8" adı iki farklı ürünü ifade ediyor:
| Ad | Nedir? | Nereden edinilir? |
|---|---|---|
| Qwen3.8-2.4T-A95B | Açık ağırlıklı temel model | ModelScope (indirilebilir kontrol noktası) |
| Qwen3.8-Max | Ek üretim yetenekleri sunan bulut sürümü | Alibaba Token Plan, Qoder, QoderWork |
Qwen3.8-Max, açık ağırlıklı A95B modeli temel alınarak geliştirildi; ancak eğitim sonrası ek iyileştirmeler içeriyor. Alibaba bu sistemi gerçek ortam ölçeklendirmesi, birleşik ödül sinyalleri ve çevrim içi veri dengelemesini kapsayan üç aşamalı bir yapı olarak tanımlıyor. İndirilebilen ağırlıklar temel modeli içeriyor; tam Max üretim yığını bu pakete dahil değil.
Ağırlıkların hâlâ "vaat edilmiş ancak yayımlanmamış" olduğunu söyleyen rehberler artık güncel değil. Yayın, Alibaba'nın öngördüğü 10 Ağustos haftası içinde gerçekleşti.
Kesinleşen Teknik Özellikler: 95B Aktif Parametre ve 256K Yerel Bağlam
19 Temmuz'daki ön gösterimden sonra haftalar boyunca en çok merak edilen bilgi, modelin her token için kaç parametre çalıştırdığıydı. Birçok üçüncü taraf rehberinde bu bilgi açıkça "yayınlanmadı" şeklinde yer alıyordu. Artık rakam kesin: 2,4 trilyon toplam parametrenin token başına 95 milyarı etkin.
| Teknik özellik | Kesinleşen değer |
|---|---|
| Toplam parametre | 2.4T |
| Token başına aktif parametre | 95B |
| Mimari | MoE (Qwen3.5'in hibrit tasarımının devamı) |
| MoE katmanı başına uzman sayısı | 512 |
| Token başına yönlendirilen uzman | 10 |
| Token başına paylaşılan uzman | 1 |
| Yerel bağlam penceresi | 262.144 token (256K) |
| Genişletilebilir bağlam | 1.010.000 token (1.01M) |
| Eğitim yöntemi | Multi-Token Prediction (MTP) |
| İlk açık ağırlıklı Qwen-Max sürümü | Evet (12 Ağustos 2026) |
Burada iki ayrıntı öne çıkıyor. İlk olarak yerel bağlam penceresi, yaygın varsayımın aksine 1 milyon değil 256K token. 1.01M rakamı, Alibaba'nın kalite ödünlerini henüz belgelemediği genişletilebilir moda ait. İkinci olarak MoE yönlendirmesi son derece seyrek: 512 uzmandan token başına yalnızca 11'i çalışıyor; bunların 10'u yönlendirilen, 1'i paylaşılan uzman. 95B aktif parametrenin 2.4T toplam parametreye oranıyla ortaya çıkan yaklaşık %4'lük etkinleşme, toplam model boyutu 2.4T olmasına rağmen girişte milyon token başına $2 fiyatını ekonomik olarak mümkün kılıyor.
MTP (Multi-Token Prediction) eğitimi, uyumlu çıkarım motorlarının tek bir ileri geçişte birden fazla token tahmin edebilmesi anlamına geliyor. Bu da aktarım hızını artırabilir. Alibaba henüz hangi motorların bunu desteklediğini açıklamadı.
Kendi Sunucunda Çalıştırma Gerçeği: 2.4T Parametrenin Maliyeti
Teknik özellikler etkileyici görünüyor; ta ki modeli yüklemeyi deneyene kadar. Hesap oldukça net.
4 bit kuantizasyonda 2,4 trilyon parametre, KV önbelleği, aktivasyon belleği ve çalışma zamanı yükü hesaba katılmadan yaklaşık 1,2 TB depolama alanı tüketiyor. NVIDIA H200 GPU'su 141 GB belleğe sahip. Sekiz H200 toplamda 1.128 GB sunuyor; bu kapasite, ağırlıkları tutup aynı anda anlamlı bir bağlam penceresi çalıştırmak için yeterli değil.
| Dağıtım senaryosu | Gerekli VRAM (tahmini) | Donanım | Pratik mi? |
|---|---|---|---|
| Tam hassasiyet (16 bit) | ~4.8 TB | 34+ H200 GPU | Yalnızca veri merkezi |
| 4 bit kuantizasyon | ~1.2 TB | 9+ H200 GPU | Yalnızca veri merkezi |
| 1.5 bit kuantizasyon | ~450 GB | 4+ H200 GPU | Sınırda; kalite kaybı belirsiz |
| Qwen3.8-27B (alternatif) | 4 bitte ~27 GB | 1 tüketici GPU'su | Evet |
95B aktif parametre, token başına çıkarım hızına yardımcı oluyor; çünkü model her ileri geçişte uzmanların yalnızca bir bölümünü kullanıyor. Ancak aktif parametre sayısı, 512 uzman ağının tamamını bellekte tutmak için gereken kapasiteyi azaltmıyor. GEO Toolbox'ın ifadesiyle: "Seyrek etkinleşme, modeli büyük ölçekte çalıştırmayı ucuzlatır; sahip olmayı değil."
Yerel ya da tek sunuculu dağıtım için Qwen3.8-27B sürümü gerçekçi seçenek. Qwen3.8 eğitim soyunu paylaşan bu model, 4 bit kuantizasyonda tek bir tüketici GPU'suna sığıyor. 2.4T model ise araştırma ve veri merkezi kullanımına yönelik.
API Ne Zaman Daha Mantıklı?
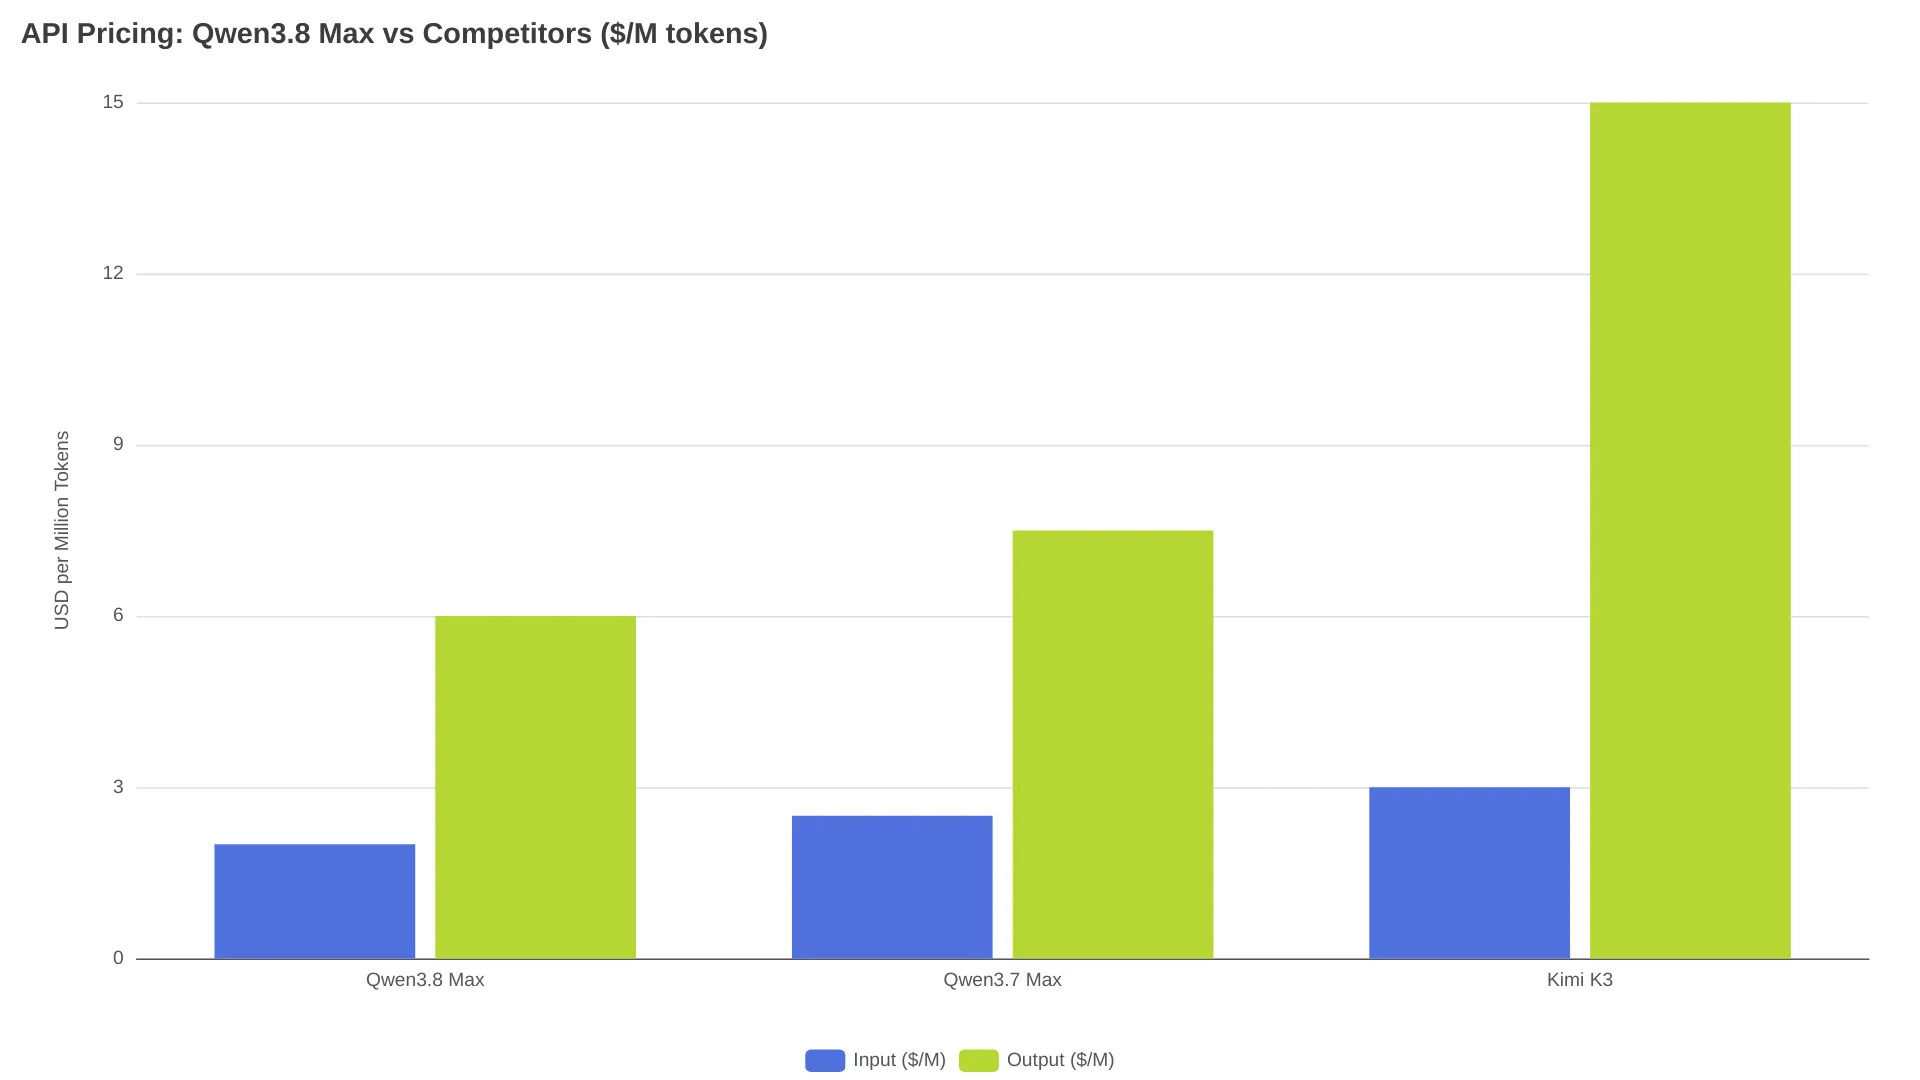
2.4T'lik bir MoE modelini kendi sunucunda çalıştırmak neredeyse hiçbir ekip için gerçekçi olmadığına göre, pratik erişim yolu API. Alibaba Model Studio, Qwen3.8 Max için milyon giriş token'ı başına $2 ve milyon çıkış token'ı başına $6 ücret belirliyor. Bu fiyatlar hem önceki modelinden hem de Çin'deki en yakın rakibinden daha düşük.
| Model | Giriş ($/M) | Çıkış ($/M) | Bağlam |
|---|---|---|---|
| Qwen3.8 Max | $2.00 | $6.00 | 256K yerel (1.01M genişletilebilir) |
| Qwen3.7 Max | $2.50 | $7.50 | 1M |
| Kimi K3 | $3.00 | $15.00 | 1M |
Token başına API ücretlerine ek olarak Alibaba üç abonelik paketi sunuyor:
- Lite: ayda $6 (~10.000 kredi)
- Standard: ayda $18 (~40.000 kredi)
- Pro: ayda $68 (~160.000 kredi)
Token Plan uç noktası hem OpenAI uyumlu hem de Anthropic uyumlu API formatlarını destekliyor. Bu nedenle Claude Code, Cursor ve OpenCode gibi araçlar istemci tarafında değişiklik gerektirmeden çalışıyor. Alibaba'nın kodlama ürünü Qoder, yoğun olmayan saatlerde (14:00-00:00 UTC) standart fiyatın 0.01x'ine kadar promosyonlu kredi oranları sunuyor; ancak bunlar kalıcı fiyatlar değil, lansman indirimleri.
Abonelik modelinin dikkat edilmesi gereken bir tarafı var. Qwen3.8 Max'in akıl yürütme modu oldukça uzun çıktılar üretiyor ve toplulukta kotanın hızla tükendiğine dair benzer raporlar bulunuyor:
"Qwen gerçekten ÇOK fazla düşünüyor." - u/darko, r/Qwen_AI
Aynı Reddit başlığında bir Lite abonesi, yaklaşık 50 milyon token kullanarak haftalık hakkını iki günden kısa sürede tükettiğini söyledi. Pro planındaki başka bir kullanıcı ise %94 önbellek isabet oranıyla yedi paralel ajan üzerinden tek günde 500 milyon token harcadığını aktardı. reasoning_effort parametresi (low, medium veya xhigh olarak ayarlanabiliyor), modelin ne kadar akıl yürütme çıktısı üreteceğini ve dolayısıyla kredilerin ne kadar hızlı tükeneceğini doğrudan belirliyor. Bir kullanıcının testinde değeri low olarak ayarlamak, istek başına düşünme süresini yaklaşık 10 saniyeye indirdi.
Ayrıntılı maliyet dökümü için Qwen3.8 Max API fiyatlandırma rehberimize göz atabilirsiniz.
Benchmark Sonuçları: Qwen3.8 Max Nerede Önde, Nerede Geride?
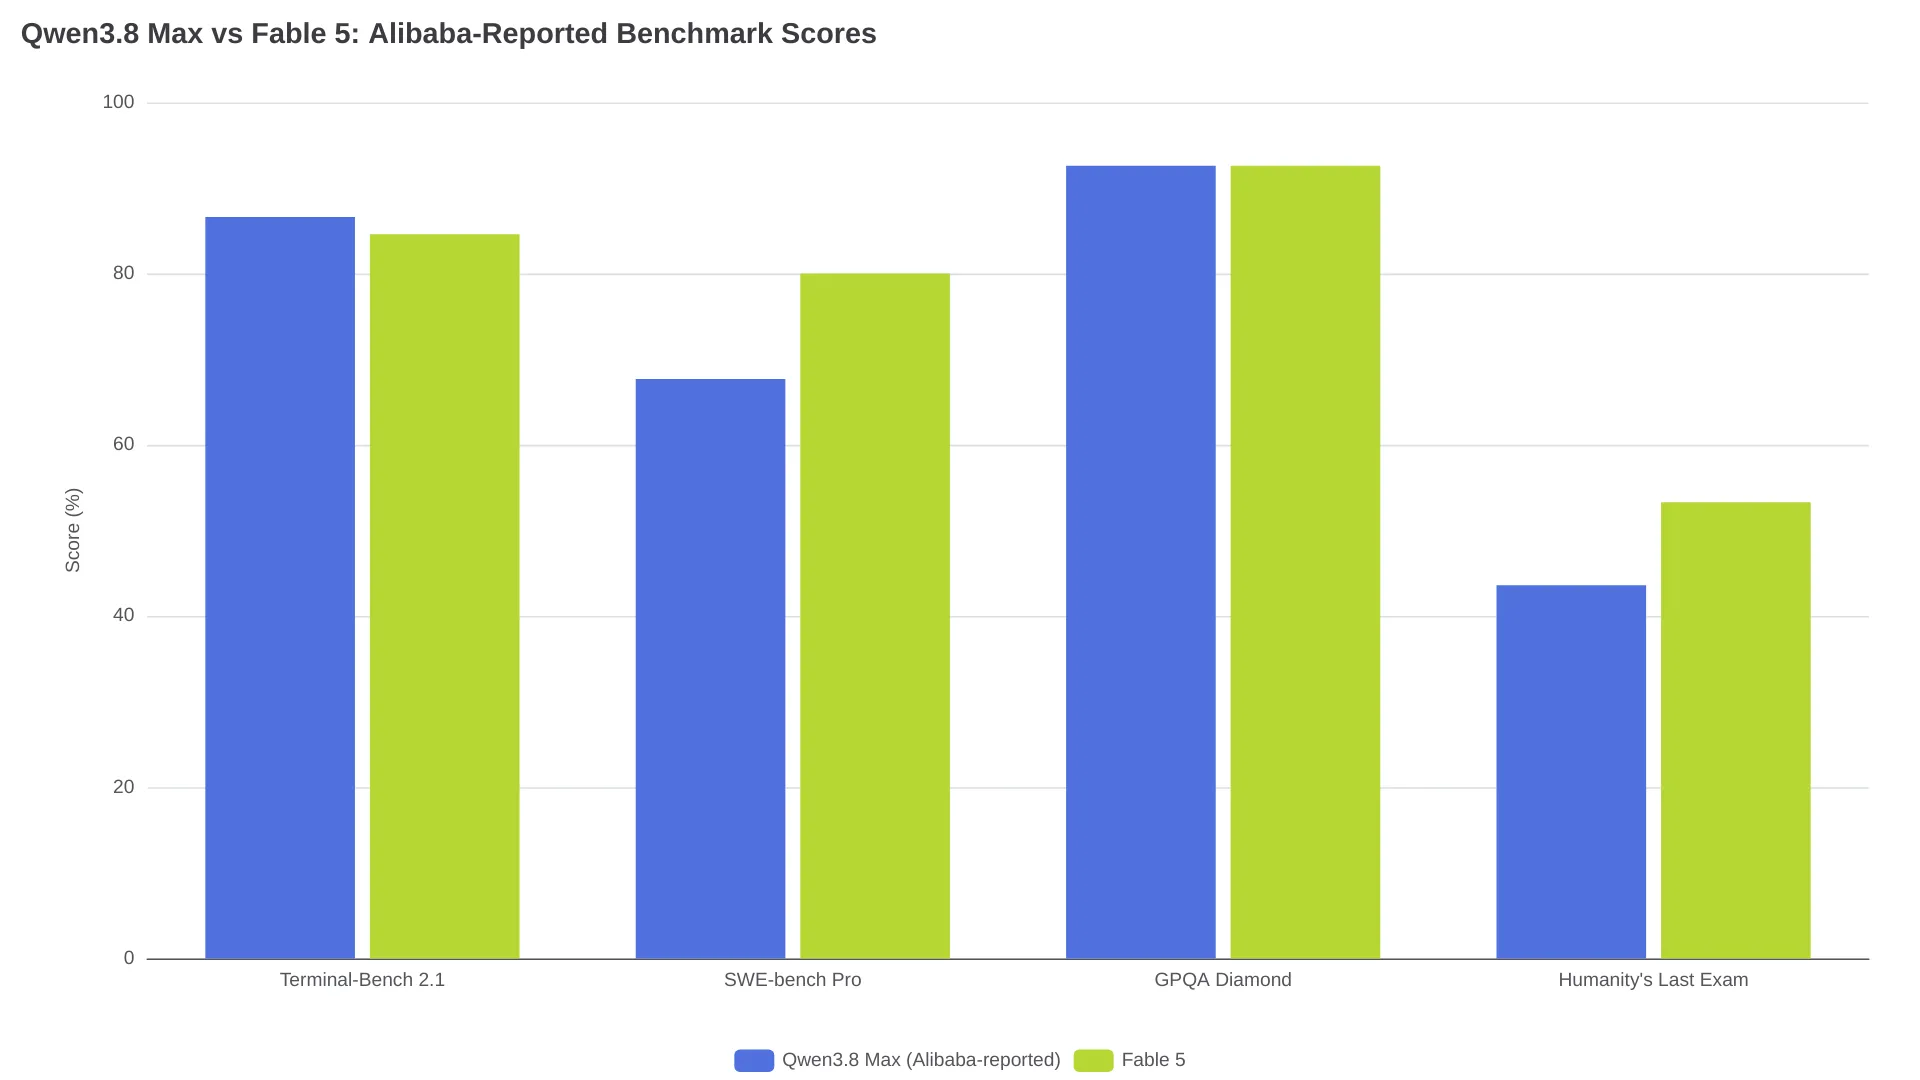
Alibaba, Qwen3.8 Max'i Fable 5 ve GPT-5.6 Sol ile karşılaştıran benchmark sonuçlarını yayımladı. Tablo tek yönlü değil. Üreticinin açıkladığı skorlarla bağımsız ölçümler arasındaki fark da göz ardı edilemeyecek kadar büyük.
| Benchmark | Qwen3.8 Max (Alibaba) | Fable 5 | GPT-5.6 Sol |
|---|---|---|---|
| Terminal-Bench 2.1 | 86.6 | 84.6 | Qwen'den yüksek (kesin skor yayımlanmadı) |
| SWE-bench Pro | 67.7 | 80.0 | 64.6 |
| GPQA Diamond | 92.6 | 92.6 | Qwen'den yüksek |
| Humanity's Last Exam | 43.6 | 53.3 | Yayımlanmadı |
Bağımsız ölçümlerde ise manzara değişiyor. Artificial Analysis, Qwen3.8 Max'i Terminal-Bench 2.1'de %81,3 olarak ölçtü. Bu, Alibaba'nın açıkladığı %86,6'lık skorun 5,3 puan altında. Bağımsız sonuç baz alındığında Qwen genel sıralamada yaklaşık onuncu sırada; Fable 5 (%84,6) ve Kimi K3'ün (%85,0) gerisinde.
Qwen3.8 Max'in gerçekten öne geçtiği alanlar da var. SWE-bench Pro'daki %67,7'lik skor, GPT-5.6 Sol'un %64,6'sını geride bırakıyor. Çok modlu testlerde de sonuçlar güçlü: MathVision'da 95,2'ye karşı Fable 5'in 92,7'si, LogicVista'da ise 91,9'a karşı 85,7. Model ayrıca DeepSWE 1.1'de Qwen3.7 Max'e kıyasla belirgin ilerleme kaydetti (21,6 -> 56,6). Bu da yazılım mühendisliği ajan görevlerinde gerçek kazanımlara işaret ediyor.
Topluluk yorumları da bu ikili tabloyu yansıtıyor. Fazla düşünmekten şikâyet eden aynı Reddit başlığında şu yorum da yer aldı:
"Ama çıktı gerçekten tanrısal seviyedeydi." - u/TangerineLogical9779, r/Qwen_AI
Hıza ilişkin kullanıcı raporları da oldukça değişken: yük ve günün saatine bağlı olarak saniyede 8 ila 60 token arasında sonuçlar bildiriliyor. Kimi K3 ile ayrıntılı kafa kafaya karşılaştırma için Qwen3.8 Max ve Kimi K3 karşılaştırmamıza bakabilirsiniz.
Sıkça Sorulan Sorular
Qwen3.8-Max ağırlıkları indirilebiliyor mu?
Evet. Alibaba, Qwen3.8-2.4T-A95B kontrol noktasını 12 Ağustos 2026'da ModelScope üzerinde yayımladı. Bu, açık ağırlıklarla sunulan ilk Qwen-Max sınıfı model. Bulutta çalışan Qwen3.8-Max ise bu temel modelin üzerine ek üretim yetenekleri ekliyor.
Açık ağırlıklar hangi lisansı kullanıyor?
Yazının hazırlandığı sırada kesin lisans doğrulanmış değil. Geçmiş örnekler Apache 2.0 ihtimaline işaret ediyor; Qwen3.6 bu lisansla yayımlanmıştı. Ancak Qwen3.7 Max kapalı kaldı. Ticari bir ürün geliştirmeden önce ModelScope deposundaki gerçek lisans dosyasını mutlaka okuyun.
Qwen3.8-2.4T-A95B ile Qwen3.8-Max arasındaki fark ne?
Qwen3.8-2.4T-A95B açık ağırlıklı temel model: 2.4T parametre, 95B aktif parametre, MoE mimarisi ve 256K yerel bağlam. Qwen3.8-Max ise bu model üzerine kurulan ve birleşik ödül sistemleriyle çevrim içi veri dengelemesi dahil üretim ortamına yönelik eğitim sonrası iyileştirmelerle güçlendirilen Alibaba bulut sürümü. Açık ağırlıklar temel modeli, API ise geliştirilmiş sürümü sunuyor.
Qwen3.8-Max'i yerel olarak çalıştırabilir miyim?
Pratik açıdan hayır. 4 bit kuantizasyonda model yaklaşık 1,2 TB VRAM gerektiriyor. Yalnızca ağırlıkları yüklemek için dokuz veya daha fazla H200 GPU gerekiyor; bağlam önbelleği için ayrıca alan kalmıyor. 1,5 bit kuantizasyonda bile yüzlerce gigabayt bellek gerekli. Qwen3.8-27B sürümü, tek bir tüketici GPU'suna sığabildiği için yerel kullanımda gerçekçi alternatif.
Qwen3.8 Max API'si ne kadar tutuyor?
Model Studio API, milyon giriş token'ı başına $2 ve milyon çıkış token'ı başına $6 ücret alıyor. Abonelik paketleri ayda $6'dan (Lite) başlıyor ve $68'a (Pro) kadar çıkıyor. Qoder yoğun olmayan saatlerde %98'e varan promosyonlu kredi indirimi sunuyor; ancak bunlar lansman fiyatları ve değişebilir.