 AIREITER
17GB'lık bir indirme, yerelde rahat çalışan bir ajan anlamına gelmiyor. Qwen3.8-27B, Apache-2.0 lisanslı ve güçlü bir açık ağırlıklı model; ancak varsayılan ekstra yüksek akıl yürütme modu, quantization seçimi, bağlam bütçesi ve sunum altyapısı donanımınızla uyuşmadığında basit bir işi bile uzun bir bekleyişe çevirebilir.
Qwen3.8-27B'yi yerelde çalıştırmak mantıklı mı?
Yaklaşık 24GB GPU veya birleşik belleğe sahip, verisini yerelde tutmak isteyen ve hızlı bir barındırılan API'ye kıyasla daha yavaş etkileşimli yanıtları kabul edebilen geliştiriciler için Qwen3.8-27B yerelde çalıştırmaya değer. Tercih sebebi tek bir benchmark sonucu değil: Görsel ve video girdilerini destekleyen, 262.144 token yerel bağlam penceresi sunan, akıl yürütmesi ayarlanabilen ve dağıtılabilir boyutta bir Apache-2.0 yoğun model olması. Qwen'in resmî model kartı, modelin 14 Ağustos 2026'da yayımlandığını belirtiyor.
Yine de onu her API modelinin otomatik alternatifi gibi görmeyin. Resmî sonuçlar üretici tarafından bildiriliyor, agresif quant seçenekleri hem kaliteyi hem hızı değiştiriyor ve varsayılan xhigh akıl yürütme ayarı birçok yerel etkileşimli iş için iyi bir başlangıç tercihi değil.
Önce benchmark değil, bellek bütçesi
Qwen3.8-27B yoğun bir model; yani üretilen her token modelin tamamını etkinleştiriyor. Bu nedenle yalnızca ağırlık dosyasının boyutuna bakmak yanıltıcı: bellek bant genişliği, KV cache, quantization ve istenen bağlam uzunluğu belirleyici hale geliyor. Qwen'in kartında 262K yerel bağlam belgeleniyor; ancak kullanılabilir bellek ve hız için gerçek bir yerel oturum bunun çok altında yapılandırılabilir. Qwen'in sunum örnekleri 262.144 token üst sınırını gösteriyor; bu, her tüketici sistemi için makul varsayılan ayar olduğu anlamına gelmiyor.
| Kullanılabilir bellek | Pratik başlangıç noktası | Beklenti | Öneri |
|---|---|---|---|
| 12GB | Agresif Q3 sınıfı quant ve CPU/RAM offload | Kısa bağlam ve ciddi gecikme tavizleri | Yerel deneme asıl amaç değilse daha küçük bir model kullanın |
| 16GB | Agresif Q3 veya dikkatle seçilmiş Q4 tarzı quant | Kısa ve gözetimli işler için kullanılabilir; bağlam ve hız sınırlı | Bir ajan iş akışına bağlanmadan önce test edin |
| 24GB | Q4 sınıfı quant | Kodlama, araç kullanımı ve mütevazı bağlam için pratik giriş noktası | Çoğu yerel Qwen3.8-27B kullanıcısı için en uygun seviye |
| 32GB+ | Daha yüksek kaliteli quant veya daha geniş bağlam payı | KV cache ve uzun oturumlarda daha az taviz | Sürekli ajan çalışmaları için bu seviyeyi tercih edin |
Bunlar üreticinin resmî minimum gereksinimleri değil, kullanım önerileri. Bağımsız kullanıcılar 12GB RTX 3060'ın yerel bir sürümü çalıştırıp araç çağrılarını yönetebildiğini bildirirken, bazıları bu VRAM seviyesinde yoğun bir ajanın zayıf performans verdiği uyarısında bulunuyor. Görüş ayrılığı tam da bu yüzden önemli: “Yüklenebiliyor” ile “iyi çalışıyor” aynı şey değil. Gerçek kullanıcı tartışmasına r/LLM üzerinden ulaşabilirsiniz.
24GB ekran kartı, rahat bir 4-bit iş akışı için taban noktasıdır; uzun bağlam kullanımını garanti etmez. Dağıtım odaklı bir değerlendirme, 4-bit toplam bellek ihtiyacını 17-19GB olarak hesaplıyor; ancak uzun ajan oturumlarında KV cache'in hızla büyüdüğü uyarısını da yapıyor. Neoteric'in yerel dağıtım analizi, resmî bir donanım şartnamesi değil, planlama için yararlı bir kaynak.
Varsayılan ayarlar neden modeli kullanılamaz hissettirebilir?
Qwen3.8-27B, düşünme modunu varsayılan olarak etkinleştiriyor. Resmî kartta xhigh, medium ve low dahil reasoning_effort değerleri ile düşünmesiz istekler için enable_thinking=False seçeneği bulunuyor; preserve_thinking de varsayılan olarak açık. Qwen'in iyi uygulamalar bölümü, düşük akıl yürütme seviyesinin her zaman toplam görev süresini kısaltmadığını belirtiyor. Buna rağmen yüksek seviye, basit işler için maliyetli bir varsayılan ayar.
Simon Willison'ın yerel testi bu farkı somutlaştırıyor. LM Studio'da Q4_K_M sürümünü çalıştıran Willison, varsayılan ayarda ilk SVG görevinin 22.276 akıl yürütme tokenı kullandığını ve 21 dakika sürdüğünü bildiriyor; akıl yürütme kapatıldığında ise farklı bir sonuç 137 saniyede alınmış. Ölçtüğü kurulum evrensel bir benchmark değil, fakat yapılandırma riskini net biçimde gösteriyor. Testin ve kayıtların tamamını okuyun.
“Yoğun quantization nedeniyle 3.6 35b ile yaklaşık aynı seviyede ama daha yavaş olmasını bekliyordum; sonra her alanda onu ezip geçti.” u/AltruisticList6000, r/LocalLLaMA, 16GB RTX 4060 Ti üzerinde yaptığı Q3 denemesini aktarıyor.
Bu olumlu sonuç tavizleri ortadan kaldırmıyor. Başka bir gerçek kullanıcı raporu, 32K bağlamın sınırlı kaldığını ve bir ajan oturumunun güvenilmez hale geldiğini anlatıyor; bir başka kullanıcı ise yerel programlama işleri için açık ve atomik talimatlar öneriyor. İş akışı tartışması burada.
Qwen3.8-27B resmî olarak neler sunuyor?
Qwen3.8-27B bir MoE modeli değil; yoğun, yerel bir vision-language modeli. Resmî kart; metin, görsel ve video girdisini, 64 katmanı, 5.120 gizli boyutu, 262.144 token yerel bağlamı ve Apache-2.0 lisansını sıralıyor. Ayrıca YaRN tabanlı olarak 1M token'a kadar genişletmeyi belgeliyor; statik YaRN'ın kısa metin performansını olumsuz etkileyebileceği de açıkça belirtiliyor. Üçüncü taraf yayın özetleri yerine resmî teknik özellikler ve bağlam rehberi esas alınmalı.
Resmî depo; Transformers, vLLM, SGLang, TokenSpeed ve llama.cpp, Ollama, LM Studio gibi quantize yerel çalışma yollarını listeliyor. Model hibrit bir Gated DeltaNet ve Gated Attention mimarisi kullandığı için çalıştırıcı desteği önemli; model arızası teşhisine geçmeden önce çalıştırıcınızı güncelleyin. Qwen'in hızlı başlangıç deposunda OpenAI uyumlu sunum örnekleri de yer alıyor.
Yayımlanan benchmark'lar ne söylüyor, ne söylemiyor?
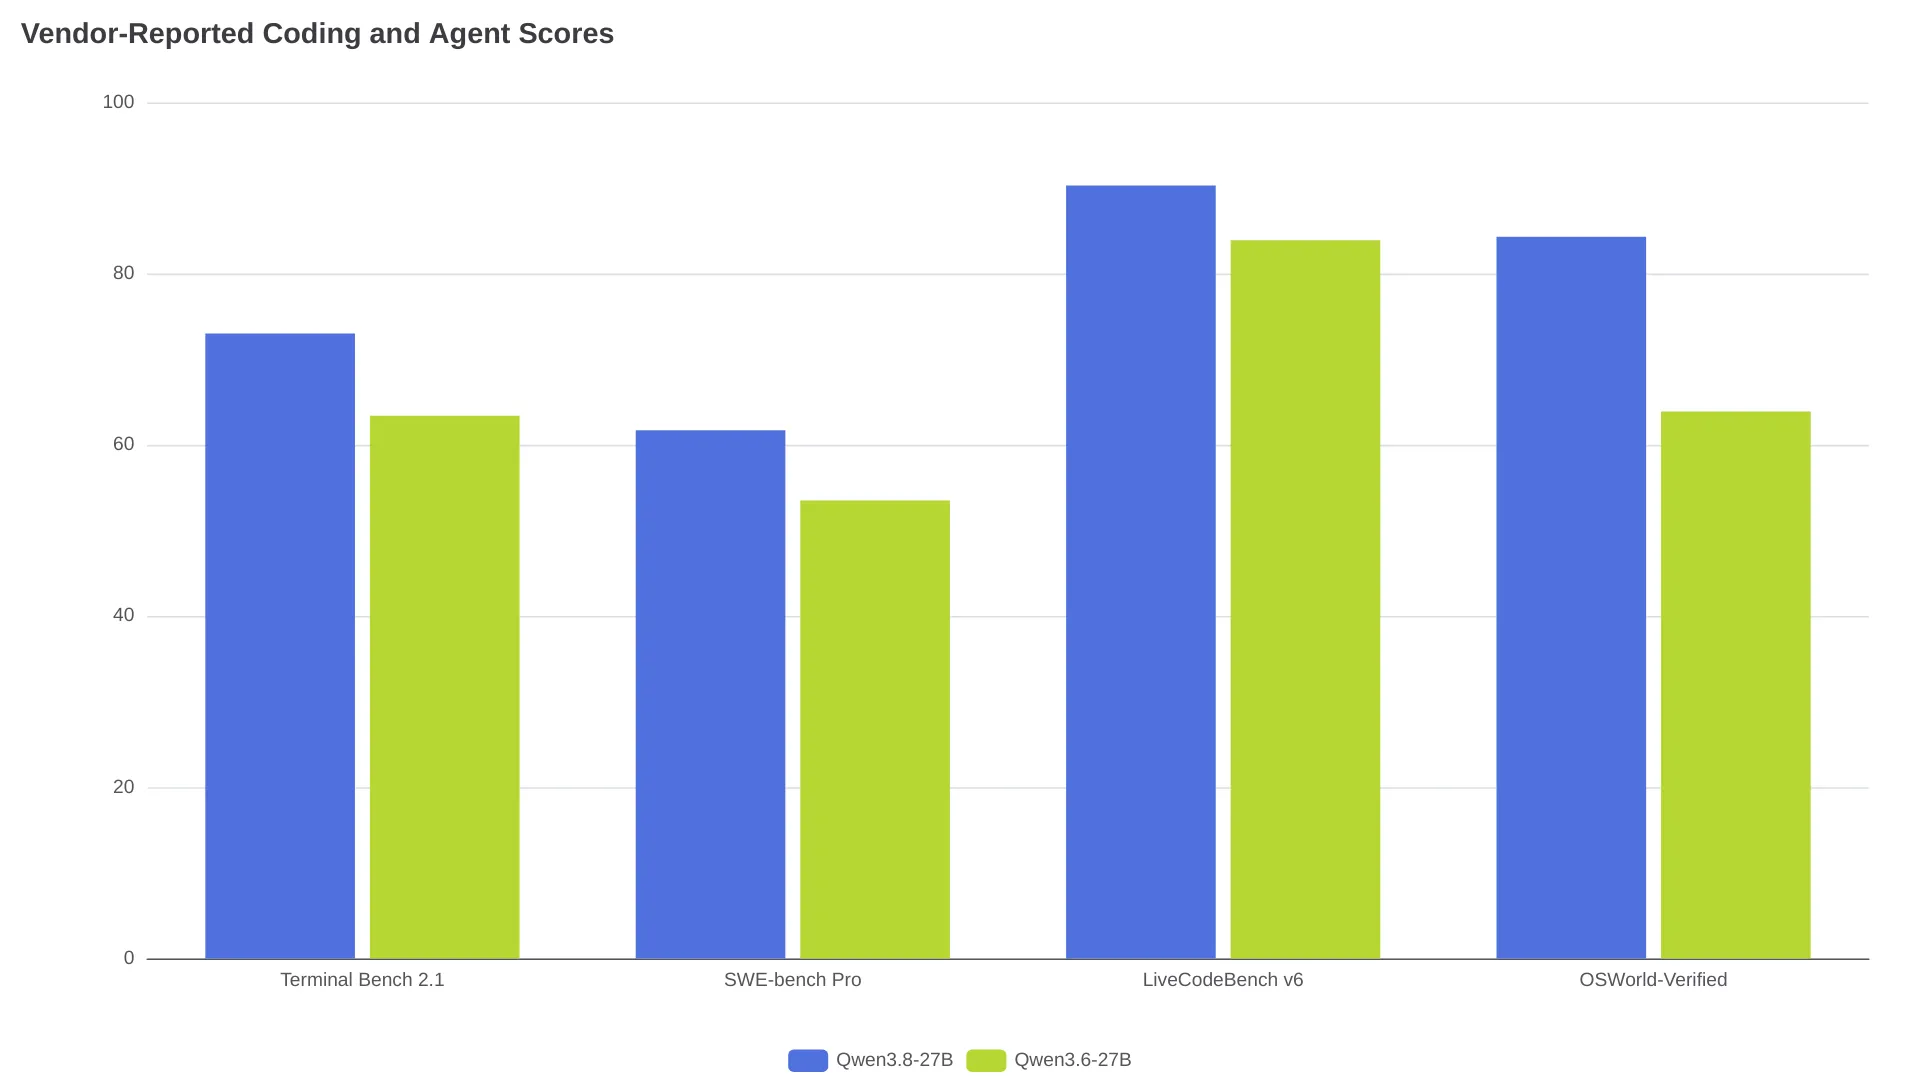
Qwen, kodlama ve bilgisayar kullanımı değerlendirmelerinde Qwen3.6-27B'ye göre anlamlı artışlar bildiriyor. Grafik, resmî model kartındaki üretici tarafından raporlanmış dört skoru gösteriyor; bunlar bağımsız olarak yeniden üretilmiş sonuçlar değil.
| Resmî benchmark | Qwen3.8-27B | Qwen3.6-27B | Nasıl okunmalı? |
|---|---|---|---|
| Terminal Bench 2.1 | 73.0 | 63.4 | Ajan tabanlı terminal kodlama göstergesi |
| SWE-bench Pro | 61.7 | 53.5 | Depo sorunlarını çözme göstergesi |
| LiveCodeBench v6 | 90.3 | 83.9 | Kodlama değerlendirmesi göstergesi |
| OSWorld-Verified | 84.3 | 63.9 | Bilgisayar kullanımı göstergesi |
Model kartı, tam karşılaştırmayı ve metodolojiyi yayımlıyor. Qwen, SWE-bench Pro ve DeepSWE 1.1 için temperature=1.0, top_p=0.95 ve 256K bağlamla Claude Code harness kullandığını; QwenSWEBench gibi kurum içi benchmark'lara da yer verdiğini söylüyor. Model karşılaştırmadan önce metodolojiyi inceleyin. Bu rakamlar “Qwen3.6-27B'ye göre resmî sonuçlarda kayda değer bir yükseltme” sonucunu destekliyor; “uç seviye bir API'ın kanıtlanmış evrensel alternatifi” sonucunu değil.
İlk yerel kurulum için mantıklı yaklaşım
İlk yerel dağıtımda en yüksek akıl yürütme düzeyi yerine öngörülebilir davranışı hedefleyin. Güncel bir çalıştırıcı kullanın, 24GB sınıfı donanımda Q4 sınıfı bir quant ile başlayın, bağlam sınırını bilinçli biçimde mütevazı tutun ve uzun otonom döngülere izin vermeden önce kısa ajan görevleri çalıştırın.
- vLLM veya SGLang gibi desteklenen bir motorla OpenAI uyumlu sunucu başlatın. Qwen,
Qwen/Qwen3.8-27B,--reasoning-parser qwen3ve--tool-call-parser qwen3_coderkullanan örnekler yayımlıyor. Resmî komutlar depoda yer alıyor. - Rutin sınıflandırma, veri çıkarma veya hızlı kod düzenlemelerinde
enable_thinking=Falsekullanın. Qwen, düşünmesiz kullanım içintemperature=0.7,top_p=0.80vepresence_penalty=1.5örnekleme değerlerini öneriyor. Resmî API örneğine bakın. - Yoğun akıl yürütme gerektiren hata ayıklamada doğrudan
xhighseçmek yerine öncelowveyamediumdeneyin; ardından gerçek bir görevde toplam tamamlanma süresini ve araç çağrısı kalitesini karşılaştırın. - Her görev birbirinden bağımsızsa korunmuş düşünmeyi kapatın. Bunu yalnızca çok turlu akıl yürütme bağlamının ek KV cache yüküne değdiği durumlarda koruyun.
- Gözetimsiz kullanımdan önce araç çağrılarını, çıktı şeması uyumluluğunu ve bağlam devretme senaryosunu test edin. Tek istemde iyi kod yazan bir model, uzun süre çalışan bir ajan döngüsünde yine de başarısız olabilir.
Qwen3.8-27B'nin yanlış seçim olduğu durumlar
12GB veya daha az bellek kesin sınırsa, yanıt gecikmesi yerel kontrolden önemliyse ya da bir ajanın katı biçim uyumuyla gözetimsiz çalışması gerekiyorsa Qwen3.8-27B ilk tercih olmamalı. Kısıtlı sistemlerde çalışabilir; ancak bu, güvenilir etkileşimli üretim hızına veya depo çalışmaları için yeterli bağlama sahip olduğu anlamına gelmez.
Bağımsız testlerde uzun çıktılar, yüksek uç gecikme ve katı talimatlara kusursuz uymama eğilimi de görülüyor. Yapılandırılmış bir değerlendirme, kendi iş istasyonu düzeninde 49 testte 4 zaman aşımı ve 143.32 saniyelik P95 yanıt süresi kaydetti. Bu değerler taşınabilir performans garantileri değil; ancak yerel 27B modeli incelemesiz bir otomasyon bileşeni saymamak için yararlı bir uyarı. CrucibleMark'ın test raporu, yapılandırmayı ve sınırlamaları açıklıyor.
Qwen3.8-27B sık sorulan sorular
Qwen3.8-27B resmen yayımlandı mı?
Evet. Qwen'in resmî deposu, Qwen3.8-27B'nin Hugging Face Hub ve ModelScope yayın tarihini 14 Ağustos 2026 olarak listeliyor. Birincil kaynak Qwen'in yayın zaman çizelgesi.
Qwen3.8-27B 16GB GPU'da çalışır mı?
Yoğun biçimde quantize edilmiş, kısa bağlamlı bir kurulum çalışabilir; ancak bu kısıtlı bir dağıtımdır. Gerçek kullanıcı raporları, 16GB RTX 4060 Ti üzerinde umut verici Q3 sonuçlarından düşük VRAM'de yoğun ajan kullanımının büyük hız ve kalite tavizleri getirdiği uyarılarına kadar uzanıyor. LocalLLaMA tartışması.
Qwen3.8-27B'nin 1M token bağlam penceresi var mı?
Modelin yerel bağlam penceresi 262.144 token. Model kartı, YaRN/RoPE ölçekleme ile 1M bağlamı açıklıyor ve statik YaRN'ın kısa metin performansını düşürebileceği uyarısını yapıyor. Resmî bağlam dokümantasyonu.
Qwen3.8-27B'de düşünme nasıl kapatılır?
Qwen'in model kartındaki örnekte gösterildiği gibi API isteğinde enable_thinking=False ayarlayın. Akıl yürütme gerektiren görevlerde xhigh seçeneğinin uygun olduğunu varsaymak yerine low veya medium ile başlayın. Resmî düşünmesiz kullanım örneği.
Qwen3.6-27B kullanıcıları yükseltme yapmalı mı?
Mevcut donanım aynı dağıtım sınıfını zaten çalıştırıyorsa ve iş yükü kodlama, bilgisayar kullanımı veya multimodal iyileştirmelerden fayda görecekse yükseltin. Mevcut kurulum kararlıysa ve yeni çalıştırıcı, quant veya akıl yürütme davranışı gerçek iş akışında henüz doğrulanmadıysa Qwen3.6-27B ile devam edin.
Değiştiremeyeceğiniz kısıta göre karar verin
| Kısıt | En iyi sonraki adım |
|---|---|
| Yerel veri işleme ve 24GB kullanılabilir bellek | Qwen3.8-27B'yi Q4 ile çalıştırın; düşük seviyede veya kapalı düşünme ile başlayın |
| Yalnızca 12GB ile 16GB arası bellek | Gözetimli kısa işler için Q3 tarzı bir sürümü test edin veya daha küçük bir model seçin |
| Uzun depo ajanı oturumları | 32GB+ pay ayırın ve benimsemeden önce KV cache davranışını doğrulayın |
| Hızlı etkileşimli yanıtlar | Barındırılan bir API veya daha küçük bir yerel model kullanın |
| Katı, gözetimsiz biçimlendirme veya yayınlama | Doğrulama katmanını ve insan incelemesini koruyun; yalnızca model uyumuna güvenmeyin |
Qwen3.8-27B, yerelde dağıtılabilen 27B bir modelin girişebileceği işlerin sınırını ileri taşıyor. Ancak sistem tarafındaki işleri ortadan kaldırmıyor: Donanımınıza uygun quant'ı seçin, akıl yürütmeyi bilinçli yönetin ve modeli indirme boyutuna göre değil, temsilî bir iş akışındaki performansına göre değerlendirin.