 AIREITER
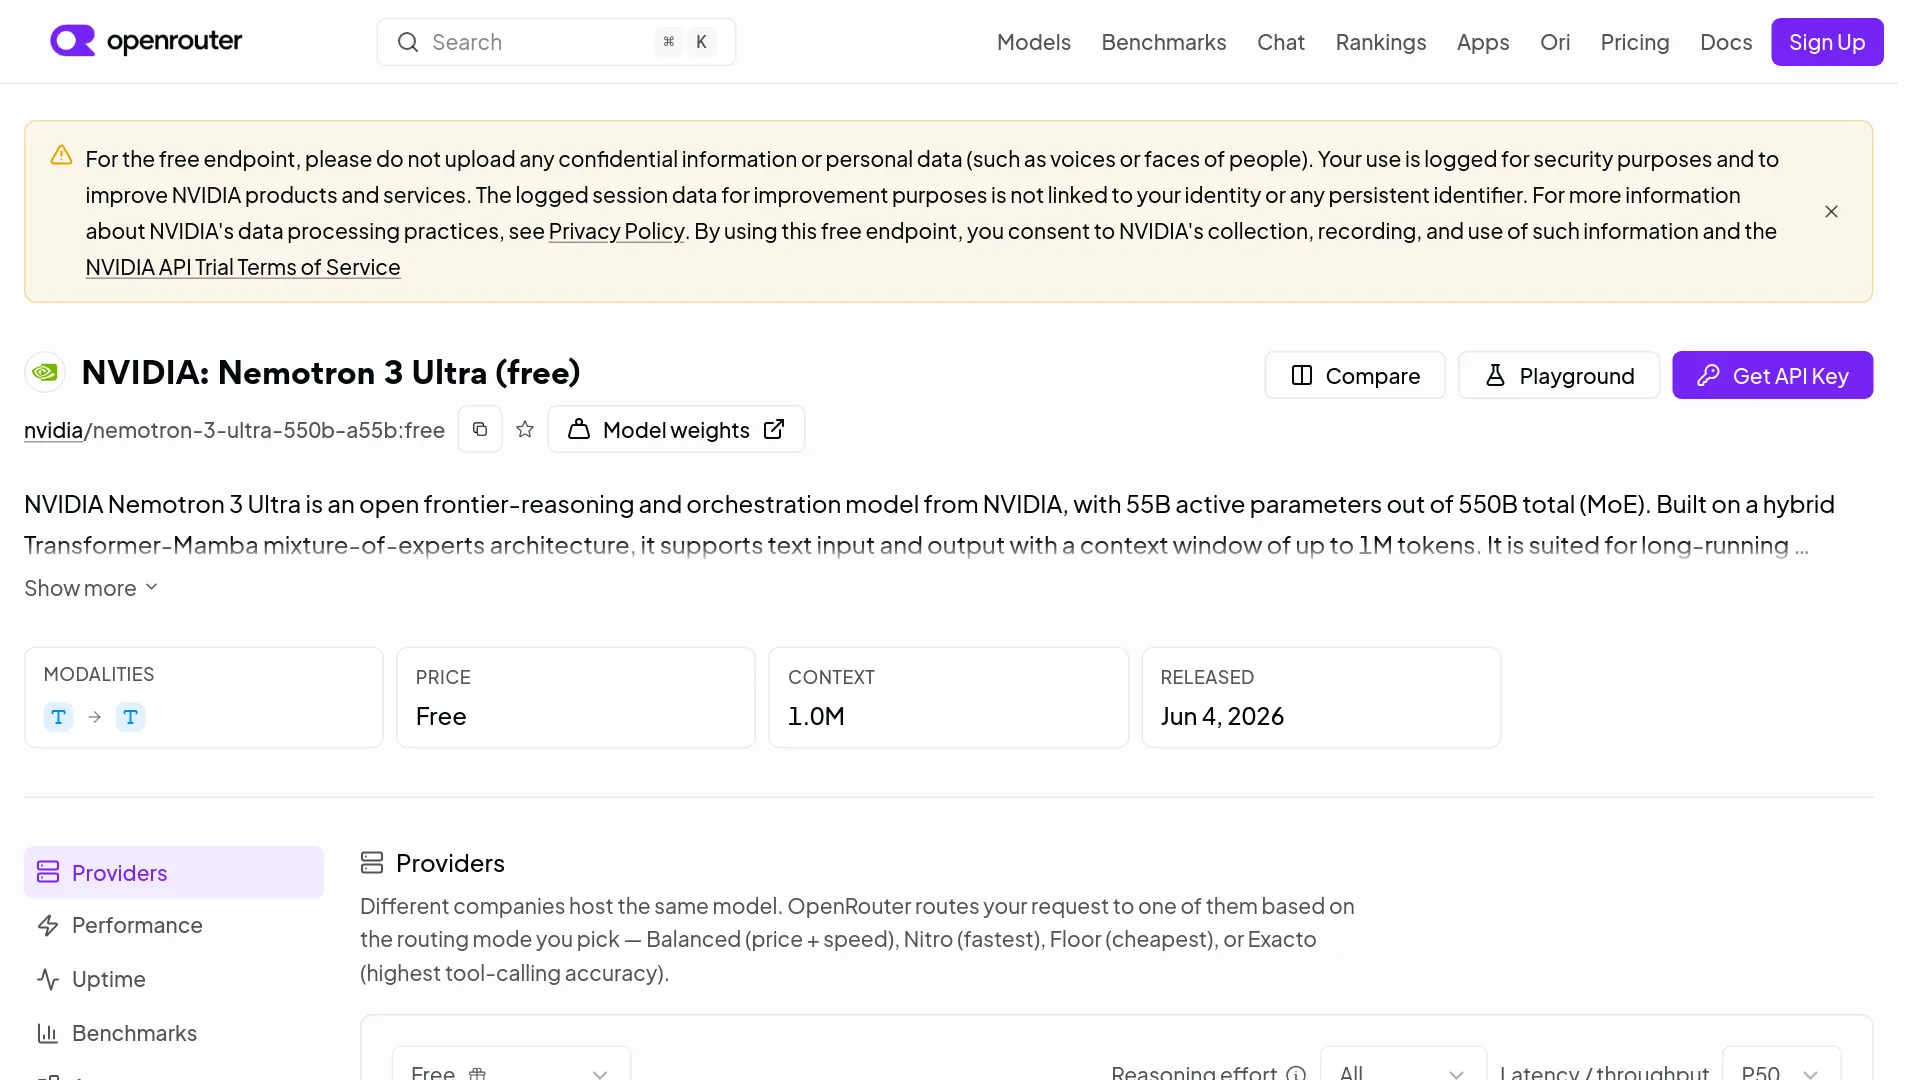
Bir milyon token'lık bağlam ve 0 dolarlık uç nokta, Nemotron 3 Ultra API'yi ilk tercih gibi gösteriyor. Ancak tablo o kadar basit değil: ücretsiz erişim değerlendirme için kullanışlı, üretim ortamında ise sağlayıcı güvenilirliği, veri işleme politikaları ve ücretli bir yedek rota belirleyici.
Nemotron 3 Ultra API kullanmaya değer mi?
Nemotron 3 Ultra API; uzun süren metin ajanları, büyük doküman analizi ve çok geniş bağlamdan faydalanan kodlama iş akışları için denemeye değer. Buna karşılık düşük gecikmeli rutin sohbetler, günlükleri tutulan ücretsiz bir uç noktaya gönderilecek gizli istemler veya yedekleme planı olmayan üretim servisleri için iyi bir varsayılan değil.
NVIDIA, Nemotron 3 Ultra'yı 4 Haziran 2026'da yayımladı. Resmî model kartında NVFP4 kontrol noktası, OpenMDW 1.1 kapsamında ticari ve ticari olmayan kullanıma lisanslı, 1.0 GA sürümü olarak tanımlanıyor.
| Karar için önemli bilgi | Doğrulanmış değer | Neden önemli? |
|---|---|---|
| Model boyutu | Toplam 550B, aktif 55B | Seyrek hesaplama, tüm ağırlıkları küçük hâle getirmez |
| Maksimum bağlam | 1 milyon tokene kadar | Sağlayıcıya göre rota limitleri daha düşük olabilir |
| Modalite | Metin girişi ve çıkışı | Görüntü veya video anlayışı yok |
| Resmî NVFP4 SWE-Bench Verified | 69.7 | Kodlama ajanı değerlendirmesi için anlamlı bir gösterge |
| Resmî NVFP4 RULER 1M | 94.0 | Uzun bağlam kullanım senaryosunu destekliyor |
| OpenRouter ücretsiz fiyatı | $0 giriş, $0 çıkış | Denemeler için uygun, SLA yerine geçmez |
| OpenRouter ücretsiz erişilebilirlik anlık görüntüsü | Üç günde %84.07 başarılı | Erişilebilir olması her zaman kullanılabilir olduğu anlamına gelmedi |
| Resmî kendi sunucunda çalıştırma minimumu | 4x B200 sınıfı veya 8x H100 | Sıradan bir iş istasyonu dağıtımı değil |
Yukarıdaki benchmark değerleri NVIDIA'nın model kartından alınmıştır ve birinci taraf sonuçları olarak değerlendirilmelidir. OpenRouter'ın erişilebilirlik verisi dinamik bir sağlayıcı ölçümüdür; kalıcı bir garanti değildir.
Ücretsiz Nemotron 3 Ultra API'yi beş dakikada çağırın
Ücretsiz erişimin en hızlı yolu, OpenAI uyumlu chat-completions uç noktasını ve nvidia/nemotron-3-ultra-550b-a55b:free model kimliğini kullanmak. Önce bir OpenRouter anahtarı oluşturun, bunu ortam değişkeninde saklayın ve uzun bağlamlı bir işe geçmeden önce küçük bir test isteği gönderin.
- OpenRouter'da bir API anahtarı oluşturun.
- Anahtarı
OPENROUTER_API_KEYolarak dışa aktarın. - Ücretsiz model kimliğiyle
/api/v1/chat/completionsuç noktasını çağırın. - Değerlendirme sırasında HTTP durumunu, gecikmeyi ve boş yanıtları kaydedin.
- İş akışını üretimde kullanmadan önce ücretli bir rota veya başka bir model ekleyin.
curl https://openrouter.ai/api/v1/chat/completions \
  -H "Authorization: Bearer $OPENROUTER_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nvidia/nemotron-3-ultra-550b-a55b:free",
    "messages": [
      {
        "role": "user",
        "content": "Return three risks in this migration plan as a numbered list."
      }
    ],
    "max_tokens": 500
  }'
Aynı rotayı OpenAI Python istemcisiyle de kullanabilirsiniz; bunun için yalnızca base_url ve model değerlerini değiştirmeniz yeterli:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["OPENROUTER_API_KEY"],
    base_url="https://openrouter.ai/api/v1",
)

response = client.chat.completions.create(
    model="nvidia/nemotron-3-ultra-550b-a55b:free",
    messages=[
        {
            "role": "user",
            "content": "Inspect this plan and list the three highest-impact risks.",
        }
    ],
    max_tokens=500,
)

print(response.choices[0].message.content)
Ücretsiz rota gerçekte neyi garanti ediyor?
Ücretsiz Nemotron 3 Ultra rotası ne sınırsız kapasiteyi ne de üretim düzeyinde erişilebilirliği garanti ediyor. OpenRouter listesi, ücretsiz uç noktaların hız sınırına tabi olduğunu belirtiyor ancak model sayfasında kesin bir kota yayımlamıyor. 19 Eylül tarihli anlık görüntüde erişilebilirlik %100 görünse de üç günlük başarılı kullanılabilirlik oranı yalnızca %84.07'ydi; hatalar ve boş yanıtlar başarısızlık olarak sayılmıştı.
OpenRouter aynı anlık görüntüde 1 milyon token bağlam, 65.536 token maksimum tamamlama, araç çağırma, 2.28 saniye medyan gecikme ve saniyede 29 token medyan üretim hızı gösteriyordu.
Üstelik sağlayıcıya özgü bir özellik sınırı da var: Ücretsiz OpenRouter listesi tools ve tool_choice destekliyordu ancak response_format zorlaması sunmuyordu. Segmind'in ücretli rotası JSON Schema çıktısını milyon giriş token'ı başına $0.625 ve milyon çıkış token'ı başına $2.75 olarak belgeliyor. Katı JSON'a dayanan kodlarda, desteği temel modelden varsaymak yerine seçtiğiniz sağlayıcıyı test etmelisiniz.
Gizli veya kişisel verileri ücretsiz OpenRouter rotasına göndermeyin. Listede kullanım verilerinin güvenlik amacıyla kaydedildiği ve NVIDIA ürün ve hizmetlerini geliştirmek için kullanılabileceği belirtiliyor. 429, zaman aşımı veya boş yanıt durumunda sınırlı üstel geri çekilme uygulayın ve ardından ücretli bir rotaya geçin; bir ajan eylemini sonsuza kadar yeniden denemeyin.
550B-A55B pratikte neyi değiştiriyor?
550B-A55B etiketi, Nemotron 3 Ultra'nın toplam 550 milyar parametre barındırdığı ve her token için yaklaşık 55 milyar parametreyi etkinleştirdiği anlamına geliyor. NVIDIA bu yapıda LatentMoE yönlendirmesini, Mamba-2'yi, seçili dikkat katmanlarını ve Multi-Token Prediction'ı bir araya getiriyor. Seyrek etkinleştirme token başına hesaplama yükünü azaltıyor; ancak tüm ağırlıkların yine de saklanması, dağıtılması veya başka bir yere aktarılması gerekiyor. A55B, bunu 55B'lik bir dağıtım hâline getirmiyor.
NVIDIA'nın araştırma duyurusu 1 milyon tokene kadar bağlam bildiriyor ve 8.000 token giriş ile 64.000 token çıkıştan oluşan alışılmadık bir iş yükünde üretim hızını karşılaştırıyor. NVIDIA; GLM-5.1-754B-A40B'ye kıyasla 5.9 kat, Kimi-K2.6-1T-A32B'ye kıyasla 4.8 kat ve Qwen-3.5-397B-17B'ye kıyasla 1.6 kat daha yüksek üretim hızı iddia ediyor. Sayfada mutlak üretim hızı ve donanım ayrıntıları yer almadığı için bu katsayılar doğrudan API gecikmesi beklentisine çevrilmemeli.
Resmî BF16/NVFP4 tablosu, dağıtım kararları açısından daha kullanışlı:
| Benchmark | BF16 | NVFP4 | Pratik yorum |
|---|---|---|---|
| SWE-Bench Verified | 71.9 | 69.7 | Nicemleme bu kodlama testinde 2.2 puan kaybettiriyor |
| Terminal Bench 2.1 | 56.4 | 53.9 | Ajan tabanlı terminal işlerinde de düşüş var |
| TauBench V3 ortalaması | 70.9 | 70.3 | Araç kullanımı ortalaması büyük ölçüde korunuyor |
| GPQA, araçsız | 87.0 | 87.9 | NVFP4 her alanda daha zayıf değil |
| RULER 1M | 94.7 | 94.0 | Uzun bağlamdan bilgi çekme performansı yakın kalıyor |
| OmniScience halüsinasyonsuzluk | 78.7 | 75.5 | Olgusal doğruluk kontrolleri hâlâ önemli |
Değişim göreve bağlı: NVFP4, halüsinasyonsuzluk puanında 3.2 puan düşerken GPQA'da 0.9 puan kazanıyor.
Parametre sayısına değil, göreve göre seçim yapın
Nemotron 3 Ultra'yı DeepSeek V4, GLM 5.2 ve Qwen 3.8 Max ile karşılaştırırken model boyutuna değil, üretimde kullanacağınız iş yüküne bakın. Bu rehber için aynı test altyapısında toplanmış sonuçlar evrensel bir kazananı desteklemiyor. Savunulabilir yaklaşım, sınırları doğrulanmış bir test planı hazırlamak.
| Görev | Şununla başlayın | Seçimden önceki kanıt ve test |
|---|---|---|
| Milyon token'lık arama veya doküman sentezi | Nemotron 3 Ultra | Resmî NVFP4 RULER 1M skoru 94.0; gerçek istem uzunluğunuzda arama doğruluğunu ve ön işleme gecikmesini test edin |
| Uzun süren kodlama ajanı | Nemotron 3 Ultra veya DeepSeek V4 | Nemotron, SWE-Bench Verified'da 69.7 ve Terminal Bench 2.1'de 53.9 alıyor; tek bir test altyapısında depo görevi başarısını ve araç çağrılarının geçerliliğini karşılaştırın |
| Yapılandırılmış çıktı otomasyonu | GLM 5.2, Qwen 3.8 Max veya şema desteği sunan bir Nemotron sağlayıcısı | OpenRouter ücretsiz rotası response_format uygulamıyor; tam olarak kullanacağınız rotada şemaya uyumu ve yeniden deneme oranını ölçün |
| Yüksek hacimli kısa istekler | DeepSeek V4, GLM 5.2 veya Qwen 3.8 Max | Başarılı görev başına maliyeti ve p95 gecikmeyi karşılaştırın; Ultra'nın ölçeği otomatik olarak avantaj sağlamaz |
| NVIDIA donanımıyla açık ağırlıklı dağıtım | Nemotron 3 Ultra | Hedef görevde BF16 ve NVFP4'ü karşılaştırın, ardından sürdürülebilir kullanım oranını hesaplayın |
DeepSeek V4 ve GLM 5.2'nin AIReiter üzerinde özel API yüzeyleri bulunuyor; Qwen 3.8 Max ise barındırılan bir sohbet modeli olarak sunuluyor: DeepSeek V4 Pro API rehberi, GLM 5.2 API incelemesi ve Qwen 3.8 Max API fiyatları. Bunlar değerlendirme alternatifleri; herhangi bir modelin her görevde kazandığı iddiası değil.
Nemotron 3 Ultra'yı yerel olarak çalıştırabilir misiniz?
Nemotron 3 Ultra kendi sunucunuzda çalıştırılabilir; ancak “yerel” burada dizüstü bilgisayar değil, veri merkezi donanımı veya DGX Station anlamına geliyor. NVIDIA, standart dağıtım yolu için minimum yapılandırma olarak 4x GB200, 4x B200, 4x GB300, 4x B300 veya 8x H100 listeliyor.
NVIDIA'nın model kartındaki resmî vLLM örnekleri 4 yönlü tensör ve uzman paralelliği, FP8 KV önbelleği, parçalı ön işleme ve MTP spekülatif kod çözme kullanıyor. Standart örnek varsayılan olarak 262.144 token'a ayarlanmış; 1.048.576 token'ı etkinleştirmek için açık bir geçersiz kılma gerekiyor. Yani başlıkta belirtilen bağlam uzunluğu, varsayılan sunum yapılandırması değil.
NVIDIA ayrıca özel bir tek DGX Station dağıtımı da belgeliyor. Bu yöntem, NVFP4 kontrol noktasını tek bir entegre GB300 GPU üzerinde çalıştırıyor; eşgüdümlü CPU belleğinin 150 GiB'ye kadar kullanılmasını ve uzman ağırlıklarının dışarı aktarılmasını sağlıyor. Bu tarif için vLLM 0.22.0, Blackwell'e özel NVFP4 arka ucu ve DGX Station bellek mimarisi gerekiyor; sıradan tek GPU'lu bir bilgisayara genellenemez.
| Dağıtım | Ne zaman seçilmeli? | Temel kısıt |
|---|---|---|
| OpenRouter ücretsiz API | İstemleri ve araç davranışını değerlendirmek için | Hız limitleri, günlük kaydı ve değişken erişilebilirlik |
| Ücretli barındırılan API | Kullanım donanımı haklı çıkaracak seviyeye gelmeden ürünü yayına almak için | Sağlayıcı fiyatı, hassasiyet, bağlam ve özellik farklılıkları |
| 4x B200 sınıfı / 8x H100 kendi sunucunda | Sürekli hacim, veri kontrolü veya model özelleştirmesi önemliyse | Sermaye maliyeti ve dağıtık çıkarım operasyonları |
| Dışarı aktarmalı tek GB300 DGX Station | Tam olarak bu eşgüdümlü bellek sistemine sahipseniz | Dışarı aktarma gecikmesi ve donanıma özgü gereksinimler |
Nemotron 3 Ultra API SSS
Nemotron 3 Ultra API ücretsiz mi?
Evet. OpenRouter, nvidia/nemotron-3-ultra-550b-a55b:free için giriş ve çıkış token'larında $0 fiyat gösteriyor; ancak uç nokta hız limitine tabi ve kullanım kayıt altına alınıyor.
Nemotron 3 Ultra gerçekten bir milyon token destekliyor mu?
NVIDIA maksimum değeri 1 milyon token olarak belirtiyor; ancak sağlayıcı rotaları daha düşük varsayılanlar sunabilir. NVIDIA'nın vLLM örneği, operatör 1.048.576 token'ı etkinleştirmediği sürece varsayılan olarak 262.144 token kullanıyor.
API araçları ve yapılandırılmış JSON'u destekliyor mu?
Model araçları destekliyor; ancak zorunlu kılma sağlayıcıya bağlı. OpenRouter ücretsiz rotasında response_format zorlaması yokken Segmind katı JSON Schema desteğini belgeliyor.
Nemotron 3 Ultra'yı ticari amaçla kullanabilir miyim?
NVIDIA, OpenMDW 1.1 lisansının ticari ve ticari olmayan kullanıma izin verdiğini belirtiyor. Yeniden dağıtım ve dağıtım yükümlülükleri için resmî model kartında bağlantısı verilen lisans koşullarını inceleyin.
Akıl yürütmeyi kapatabilir miyim?
NVIDIA'nın API dokümantasyonu enable_thinking=True/False seçeneğini sunuyor. Barındırılan sağlayıcılar bu kontrolü farklı şekilde eşleyebilir; bu nedenle seçtiğiniz rotada kabul edilen parametreyi ve token hesaplamasını doğrulayın.
550B A55B, yoğun 55B modelle aynı şey mi?
Hayır. Token başına yaklaşık 55B parametre etkin olsa da toplam 550B parametrenin tamamı yine saklanmalı, dağıtılmalı veya dışarı aktarılmalı.
Benchmark kupası değil, dağıtım kararı
En iyi ilk adım, hassas olmayan istemlerle ve küçük bir değerlendirme setiyle ücretsiz Nemotron 3 Ultra API'yi denemek. Hatalar, şema zorlaması veya öngörülebilir kapasite önem kazandığında ücretli uç noktaya geçin. Kendi sunucunuzda çalıştırmayı ise ancak ölçülmüş kullanım oranı, gizlilik veya özelleştirme ihtiyacı en az dört güncel yüksek bellekli GPU'yu ya da belgelenmiş DGX Station yolunu haklı çıkarıyorsa düşünün.
| Test sonrası sonucunuz | Sonraki adım |
|---|---|
| Kalite iyi ancak ücretsiz çağrılar başarısız oluyor veya kuyruğa giriyor | Ücretli bir Nemotron rotası ve yeniden deneme politikası ekleyin |
| Uzun bağlamlı arama belirleyici avantaj | Gerçek dokümanınızdaki en büyük örneği test edin ve ön işleme süresini ölçün |
| JSON hataları baskın | Şema zorlaması sunan bir sağlayıcı kullanın veya GLM/Qwen rotalarını karşılaştırın |
| Kısa görevlerde maliyet veya gecikme belirleyici | Daha küçük bir modeli tercih edin, Ultra'yı üst seviyeye aktarılacak işler için saklayın |
| Veriler ağınızın dışına çıkamaz | Karar vermeden önce resmî çok GPU'lu dağıtımın bütçesini çıkarın |