 AIREITER
Her iş için en güçlü muhakeme modelini çalıştırmak, agent sistemlerinde gereksiz pahalı olabilir. NVIDIA Nemotron 3.5 Lightning tam bu noktaya oynuyor: Toplamda 30B parametreye sahip bir mixture-of-experts modeli, ancak her token için yalnızca 3B parametre etkinleşiyor. NVIDIA, modelin token üretiminde 4 kata kadar hızlandığını söylüyor. Buna karşılık kendi testlerinde Qwen 3.6 35B-A3B'nin gerisinde kaldığı alanlar da var: 12 karşılaştırmanın 11'inde Qwen önde. Lightning'in hedefi en yüksek muhakeme skoru değil; agent hattındaki tekrar eden yürütme adımlarını daha hızlı ve düşük maliyetle üstlenmek. Tam hassasiyetli BF16 ağırlıkları için 80 GB GPU gerekiyor; NVIDIA üretim kullanımında NVFP4 checkpoint'ini öneriyor.
Nemotron 3.5 Lightning'i diğer 30B modellerden ayıran ne?
Nemotron 3.5 Lightning, Mamba-2 durum-uzayı katmanlarını, MoE yönlendirmesini ve seçili attention katmanlarını bir araya getiren hibrit bir mimari kullanıyor. NVIDIA bu kombinasyonu nemotron_h olarak etiketliyor. Mamba-2 katmanları, uzun bağlamlarda attention'ın bellek ve hesaplama yükünü azaltıyor. Böylece Lightning, saf attention tabanlı bir modelin karşılaşacağı karesel maliyete girmeden 1M token bağlam penceresini destekleyebiliyor. Ancak model kartına göre tek bir H100 80GB üzerinde pratik sınır 256K.
| Teknik özellik | Değer |
|---|---|
| Toplam parametre | 30B |
| Token başına etkin parametre | 3B |
| Mimari | Mamba-2 + MoE + Attention hibriti |
| Bağlam uzunluğu | 1M tokene kadar (tek H100'de 256K) |
| Hassasiyet seçenekleri | BF16, NVFP4 |
| Lisans | OpenMDW v1.1 (ticari kullanıma uygun) |
| Diller | İngilizce, İspanyolca, Fransızca, Almanca, İtalyanca, Japonca + kodlama |
| Ön eğitim külliyatı | 20T+ token |
| Muhakeme modu | Sohbet şablonunda enable_thinking ile açılıp kapatılabilir |
| Önerilen örnekleme | Temperature 1.0, top-p 0.95 |
NVIDIA, Lightning'i Nemotron 3 ailesinin en küçük üyesi olarak konumlandırıyor ve özellikle agent harness davranışları için eğittiğini belirtiyor. Buna araç çağrıları, çıktı doğrulama, sonuç biçimlendirme ve alt agent'lara görev devri dahil. Karmaşık planlamayı Nemotron 3 Ultra gibi üst seviye bir muhakeme modeli üstlenirken, Lightning pahalı modelin token bütçesini tüketebilecek rutin yürütme adımlarını ele alıyor.
Benchmark sonuçları: Lightning nerede güçlü, nerede geride?
HuggingFace model kartında, Lightning; Qwen 3.6 35B-A3B, Gemma 4 26B-A4B, Nemotron 3 Nano/Super ve GPT-OSS 20B ile 14 benchmark satırında karşılaştırılıyor. Karar vermek açısından en anlamlı 10 satır aşağıda yer alıyor:
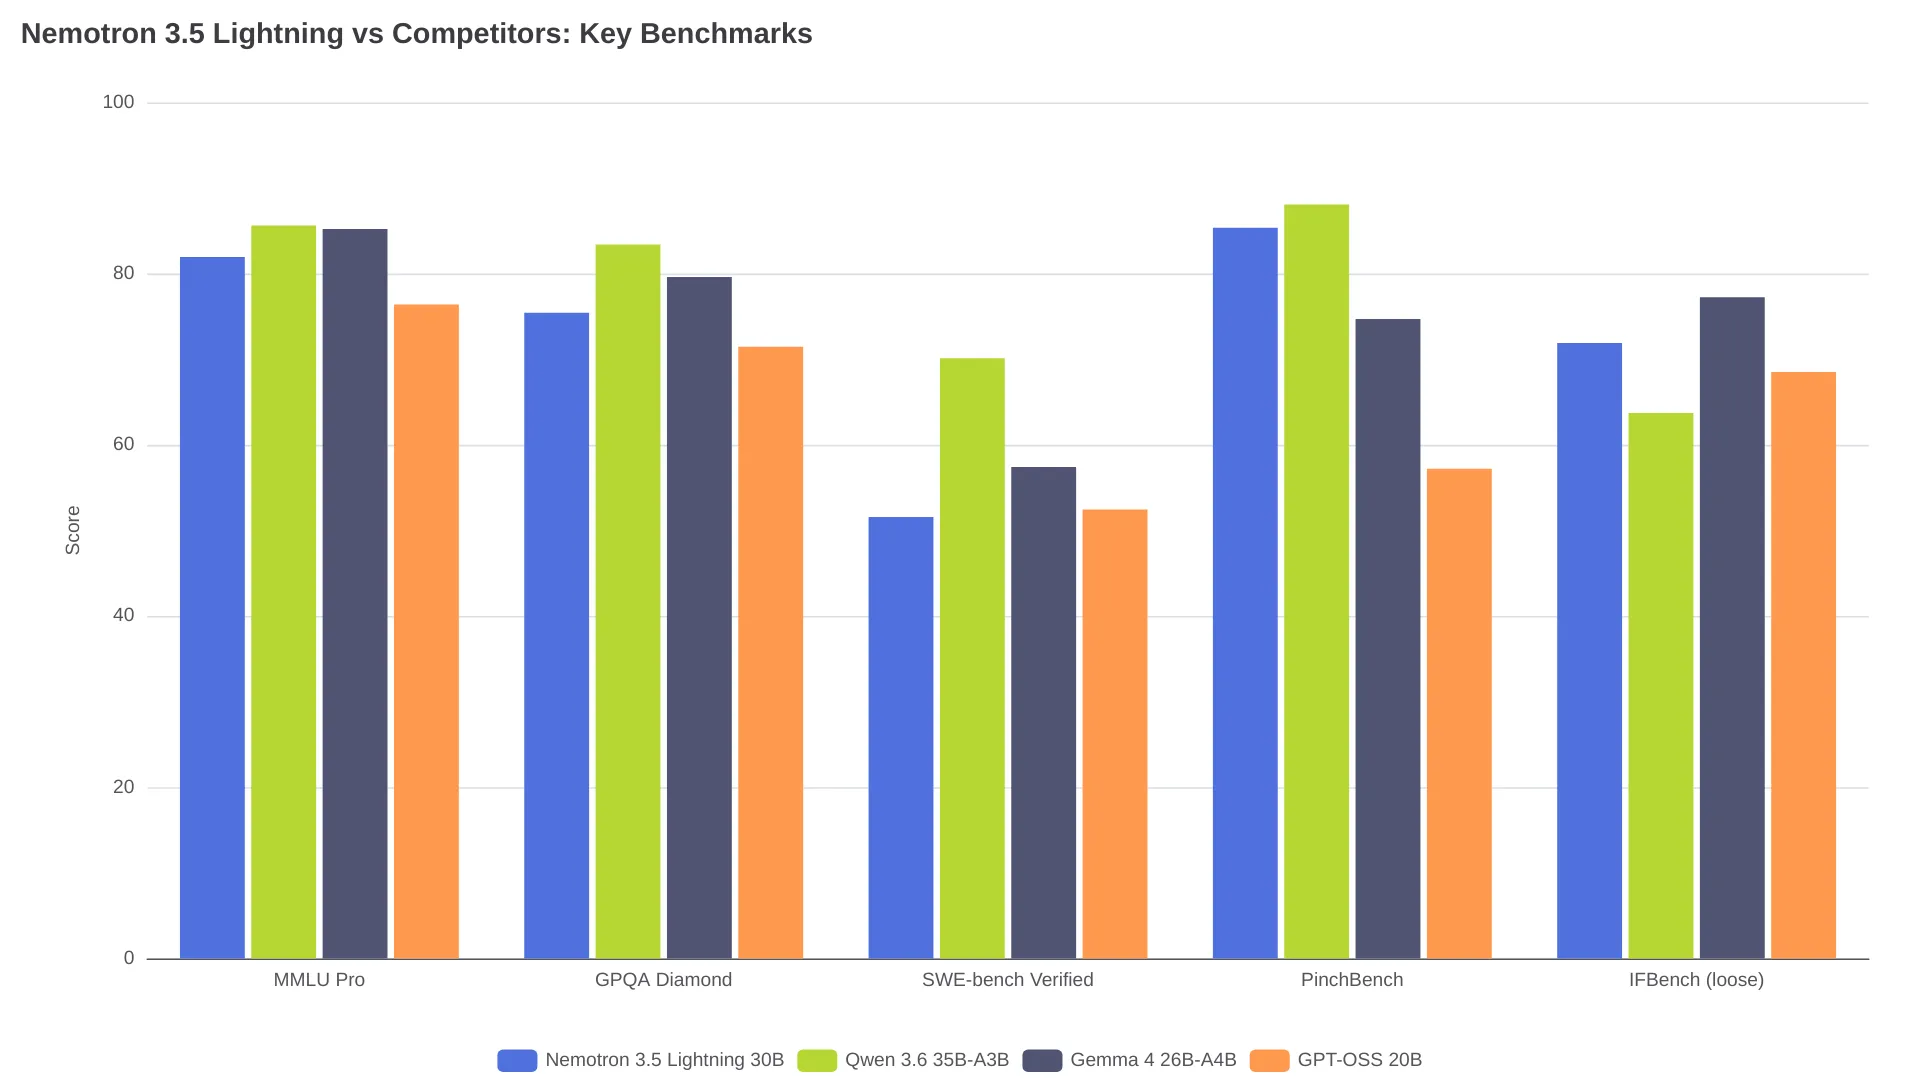
| Benchmark | Nemotron 3.5 Lightning | Qwen 3.6 35B-A3B | Gemma 4 26B-A4B | GPT-OSS 20B |
|---|---|---|---|---|
| MMLU Pro | 81.94 | 85.63 | 85.20 | 76.40 |
| GPQA Diamond (araçsız) | 75.44 | 83.40 | 79.61 | 71.46 |
| SWE-bench Verified | 51.56 | 70.12 | 57.40 | 52.44 |
| SWE-bench Multilingual | 39.33 | 63.40 | 43.40 | 41.93 |
| Terminal-Bench 2.1 | 24.58 | 44.38 | 37.22 | 15.17 |
| PinchBench | 85.37 | 88.07 | 74.70 | 57.20 |
| BrowseComp | 36.97 | 48.74 | 26.30 | - |
| IFBench (esnek) | 71.88 | 63.71 | 77.25 | 68.50 |
| AA-LCR | 52.00 | 61.06 | 57.56 | 32.88 |
| SciCode | 32.60 | 35.33 | 40.28 | 38.63 |
Lightning, karşılaştırılabilir 12 satırın 11'inde Qwen 3.6 35B-A3B'nin gerisinde. Tek istisna, 71.88 puanla Qwen'in 63.71'ini geçtiği IFBench yani esnek modda talimat takibi. Aradaki 8 puanlık fark, modelin agent yürütme odağıyla tutarlı: Araç çağrısı biçimlendirme ve çıktı doğrulama söz konusu olduğunda, ham muhakeme gücünden çok talimata bağlılık önem kazanıyor.
Lightning'i ayrıştıran esas nokta hız. NVIDIA'nın PinchBench değerlendirmesinde, 10.000 agent görevi H100 GPU-saat cinsinden ölçülüyor. Lightning, işi %86 doğrulukla yaklaşık 16.5 GPU-saatte tamamlıyor. Qwen 3.6 35B, %87 doğrulukla 23.5-24 GPU-saat; Gemma 4 26B ise %73 doğrulukla 25-26 GPU-saat harcıyor:
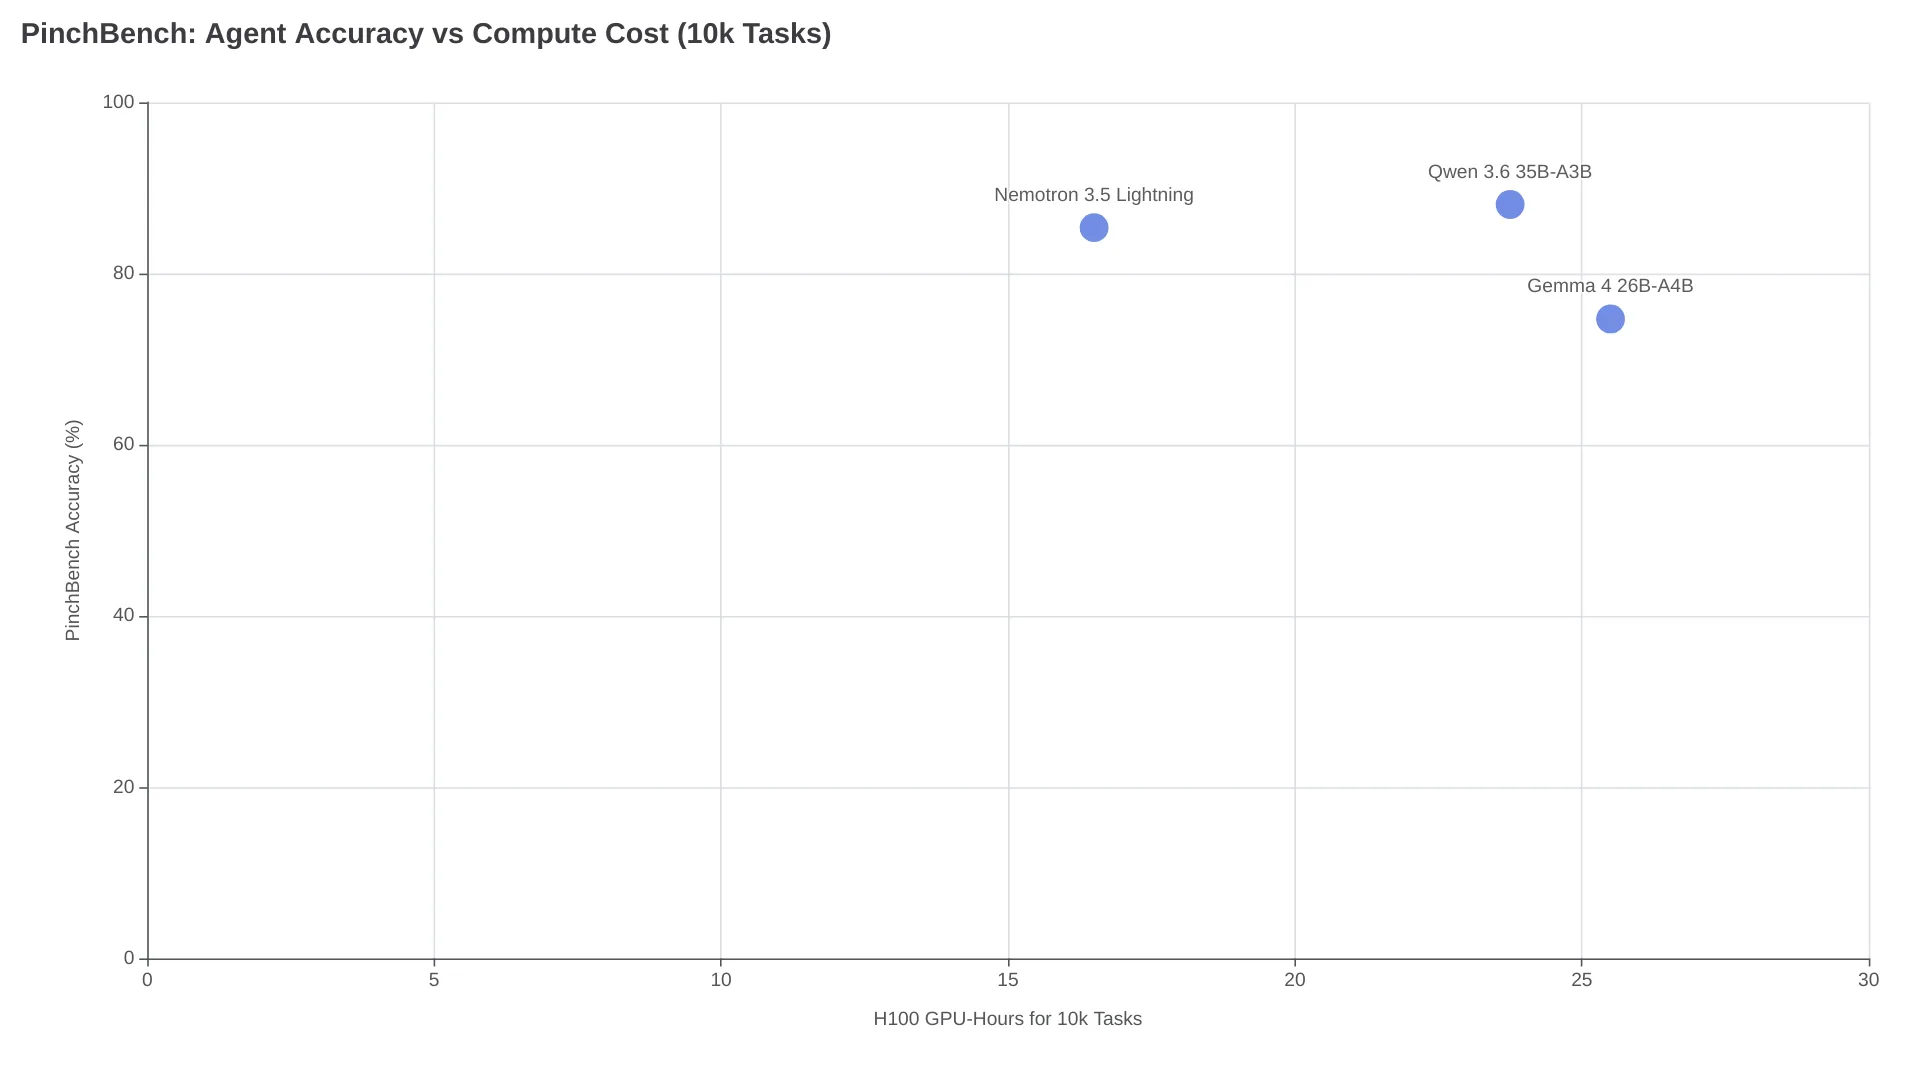
Bu, neredeyse aynı doğruluk için yaklaşık %30 daha az hesaplama anlamına geliyor. 10.000 agent adımı çalıştırıyor ve GPU-saat başına ücret ödüyorsanız, fark kayda değer. NVIDIA ayrıca Lightning'in Artificial Analysis liderlik tablosunda yaklaşık 670 çıktı tokeni/saniye ve ~23-24 Intelligence Index puanı aldığını bildiriyor. Bu sonuç, modeli toplam parametresi 40B'nin altındaki açık ağırlıklı modeller arasında Pareto sınırına taşıyor.
r/LocalLLaMA topluluğundaki testler de benzer hız sonuçları verdi. Bir DGX Spark kullanıcısı, NVFP4 checkpoint ile yalnızca hedef üretimde 78.5 token/saniye, speculative decoding ile ise 90.7 token/saniye bildirdi. Ana tartışma başlığındaki başka bir kullanıcı, Lightning kalitesini "Gemma 4 26B ile 31B arasında, ancak 26B'ye çok daha yakın" diye tanımladı. Kullanıcıya göre model Gemma 31B'den yaklaşık 2 kat hızlı çalışıyor, fakat pratikte hız avantajını dengeleyen çok sayıda thinking token üretiyor. İlk GGUF Q4 dönüşümlerinde 25 GB dosya boyutları ve kullanılmayan tensor uyarıları görüldü. Bu da hibrit Mamba-2 mimarisinin henüz tüm GGUF tabanlı araçlarda tam desteklenmediğine işaret ediyor.
Donanım gereksinimleri ve yerelde çalıştırma seçenekleri
Tam hassasiyetli referans ağırlıkları içeren BF16 checkpoint, tek GPU kurulumunda 1x H100 80GB veya 1x A100 80GB gerektiriyor. Shard'lara bölünmüş safetensors dosyasının boyutu 65.8 GB. NVIDIA, üretim çıkarımı için açık biçimde ayrı NVFP4 sürümünü tavsiye ediyor.
| Checkpoint | Dosya boyutu (yaklaşık) | Minimum GPU | En uygun kullanım |
|---|---|---|---|
| BF16 | 65.8 GB | 1x H100/A100 80GB | Fine-tuning, araştırma, quantize sürüm oluşturma |
| NVFP4 | ~16 GB | RTX 5090, DGX Spark, Jetson (Blackwell/Hopper/Ampere) | Üretim çıkarımı, agent dağıtımı |
| GGUF Q4 | ~25 GB | 16 GB+ VRAM (topluluk yapımı) | llama.cpp, Ollama, LM Studio |
NVIDIA, Day-0 desteği için dört yerel sunum projesiyle birlikte çalıştı: vLLM, SGLang, Ollama ve llama.cpp. Ayrıca LM Studio ve Unsloth da anılıyor. Model üç speculative decoding stratejisini destekliyor:
- DSpark - DGX Spark ve düşük eşzamanlılıklı veri merkezi çıkarımı için öneriliyor
- DFlash - iş yüküne bağlı olarak tercih edilebilecek alternatif draft model
- MTP (Multi-Token Prediction) - modelin içinde yer alıyor; orta ve yüksek eşzamanlılık için en uygun seçenek
Yerel donanım olmadan barındırılan erişim isteyenler için Lightning, NIM mikroservisi olarak build.nvidia.com üzerinden ve OpenRouter'da sunuluyor. NVFP4 checkpoint; GeForce RTX 5090, DGX Spark, OEM GB10 sistemleri ve NVIDIA Jetson üzerinde çalışıyor.
Agent yönlendirme modeli: Lightning'in asıl değer ürettiği yer
NVIDIA'nın açık kaynak yönlendirme kütüphanesi NeMo Switchyard, her agent iş akışı adımını doğruluk, hız ve maliyete göre en uygun modele yönlendiriyor. Planlama aşaması üst seviye bir muhakeme modeline giderken, yürütme Lightning'e bırakılıyor. NVIDIA'nın dahili benchmark'ı, Switchyard'ın "frontier-level" görev tamamlama başarısını korurken maliyeti yalnızca Opus 4.8 kullanımının yaklaşık üçte birine indirdiğini öne sürüyor. Lightning'e yönlendirilen yürütme görevleri arasında git pull, araç çıktılarını doğrulama, sonuçları biçimlendirme ve rutin API çağrıları bulunuyor.
Bunun gerçek kullanım örnekleri de var. CodeRabbit, Reddit'te paylaştığı gerçek dünya örneğinde, hedefli SFT ve RLVR (doğrulanabilir ödüllerle pekiştirmeli öğrenme) kullanarak Nemotron 3.5 Lightning'i kod inceleme yönlendirmesi için sonradan eğittiğini açıkladı. Model, sabitlenmiş 1.000 görevlik değerlendirmede temel modellerini $100'ün altında bir eğitim maliyetiyle geçti. NVIDIA bu iş akışını NeMo Automodel ve NeMo Megatron Bridge (LoRA/SFT), NeMo RL ve NeMo Gym (pekiştirmeli öğrenme) ile destekliyor. Ayrıca Nemotron-RL Agentic Terminal Pivot adlı açık bir veri seti de sunuyor.
Agent hattı kuran ekipler için asıl soru şu: Agent adımlarınızın büyük bölümünü 3B etkin parametre maliyetiyle Lightning'e yaptıracak şekilde fine-tune edip, gerçekten gerekli az sayıdaki adımda üst seviye bir model kullanabilir misiniz?
Nemotron 3.5 Lightning'i kullanmalı mısınız?
| Kullanım senaryosu | Öneri | Neden |
|---|---|---|
| Yüksek hacimli agent yönlendirme (araç çağrıları, doğrulama, biçimlendirme) | Lightning NVFP4 | 3B etkin parametre, 4 kat token hızı, benzer doğrulukta ~%30 daha az hesaplama |
| Genel amaçlı kodlama asistanlığı | Qwen 3.6 35B-A3B | SWE-bench Verified'da 70.12'ye karşı 51.56; 19 puan fark |
| Karmaşık muhakeme / planlama | Nemotron 3 Ultra veya üst seviye model | Lightning açıkça planlama modeli olarak tasarlanmadı |
| Tüketici donanımında tek GPU ile yerel sohbet | RTX 5090 üzerinde Lightning NVFP4 | Çalışıyor, ancak GGUF dönüşümleri hâlâ sorunlu; vLLM/SGLang daha güvenilir |
| Dar kapsamlı bir agent görevi için fine-tuning | Lightning BF16 | 3B etkin parametre = daha düşük fine-tuning maliyeti; OpenMDW v1.1 ticari kullanıma izin veriyor |
| Ölçekli talimat takibi | Lightning | IFBench'te Qwen'in 63.71'ine karşı 71.88; 8 puan önde |
Lightning, yüksek hacimli yürütme işlerinde tepe doğruluktan ödün vererek hız kazanıyor. Oturum başına yüzlerce agent adımı söz konusu olduğunda %30'luk hesaplama tasarrufu birikerek anlamlı hale geliyor. Buna karşın model 11 Ağustos 2026'da çıktı ve ekosistemin olgunlaşması hâlâ sürüyor. Mamba-2 hibrit mimarisi, GGUF tabanlı araçların modeli henüz tam desteklemiyor olabileceği anlamına geliyor. NVIDIA donanımında vLLM veya SGLang kullanıyorsanız, bugün için en güvenli dağıtım yolu NVFP4 checkpoint. Apple Silicon'da ya da yalnızca GGUF kullanan kurulumlarda ise topluluğun dönüşümleri kararlı hale getirmesini beklemek daha mantıklı.
Sık sorulan sorular
Nemotron 3.5 Lightning tüketici donanımında çalışır mı?
NVIDIA, tüketici donanımı için yalnızca NVFP4 checkpoint'ini destekliyor. BF16 ağırlıkları 80GB GPU, yani H100 veya A100 gerektiriyor. NVFP4; GeForce RTX 5090, DGX Spark ve NVIDIA Jetson üzerinde çalışıyor. llama.cpp ve Ollama için 16 GB+ VRAM sistemlere yönelik topluluk yapımı GGUF Q4 dönüşümleri mevcut; ancak ilk sürümlerde Mamba-2 hibrit mimarisiyle ilişkili kullanılmayan tensor sorunları bildirildi.
Nemotron 3.5 Lightning, Qwen 3.6 35B ile karşılaştırıldığında nasıl?
Qwen 3.6 35B-A3B, yayımlanan 12 benchmark'ın 11'inde Lightning'i geçiyor; en büyük farklar SWE-bench Verified ve Terminal-Bench'te görülüyor. Lightning ise IFBench talimat takibinde kazanıyor ve agent iş yüklerinde benzer doğrulukta yaklaşık %30 daha hızlı görev tamamlıyor. Genel amaçlı kullanım için Qwen daha güçlü model; agent yürütme içinse Lightning daha hızlı seçenek.
Nemotron 3.5 Lightning kodlama için iyi mi?
Ham kodlama benchmark'ları açısından hayır: SWE-bench Verified'da Qwen 3.6'nın 70.12 puanına karşı 51.56 alıyor. Ancak CodeRabbit, Lightning'i $100'ün altında bir maliyetle kod inceleme yönlendirmesi için başarıyla fine-tune etti ve temel modelini geçti. Model özelleştirme için tasarlandı: Kod tabanınızın kurallarıyla fine-tune edildiğinde, rutin kod görevlerini 3B etkin parametre maliyetiyle yürütebilir.
Nemotron 3.5 Lightning hangi lisansla sunuluyor?
Model, NVIDIA'nın "mümkün olduğunca izin verici" olarak tanımladığı OpenMDW v1.1 (Open Model Data Weight) lisansıyla yayımlanıyor. Lisans; ağırlıklar, eğitim verisi ve tarifler dahil olmak üzere ticari kullanıma izin veriyor. Lisansın tüm şartları HuggingFace model kartında yer alıyor.