 AIREITER
DeepSeek, V4 Pro'nun genel kullanıma sunulan sürümünü 13 Ağustos 2026'da resmen yayımladı. Yayınla birlikte ayrıntılı benchmark sonuçları, MIT lisanslı açık model ağırlıkları ve üç farklı düşünme eforu seviyesi paylaşıldı. API kullananlar için asıl önemli değişiklik ise şu: Resmî fiyatlandırma sayfası, 16 Ağustos 2026, 16:00 UTC itibarıyla yoğun ve yoğun olmayan saatlere göre ücretlendirmeye geçileceğini doğruluyor. V4 Pro'da milyon çıkış tokenı ücreti mevcut $0.87 seviyesinden yoğun olmayan saatlerde $1.98'e, yoğun saatlerde ise $3.96'ya çıkacak.
DeepSeek-V4-Pro-0813 ile gelenler: benchmark'lar ve açık ağırlıklar
deepseek-v4-pro API takma adının arkasındaki model artık DeepSeek-V4-Pro-0813. Model; DeepSeek uygulaması, web arayüzü ve API üzerinden kullanılabiliyor. DeepSeek, 13 Ağustos'taki duyurusunda, yeni sürümün 24 Nisan tarihli önizleme derlemesine göre “önemli ölçüde geliştirilmiş Agent yetenekleri” sunduğunu belirtti.
Mimari ve teknik özellikler:
| Öğe | DeepSeek-V4-Pro-0813 |
|---|---|
| Açıklanan model boyutu | 1.7T parametre (model kartı; önizleme sürümü 1.6T idi) |
| Bağlam uzunluğu | 1 milyon token |
| Maksimum çıkış | 384K token |
| Düşünme modları | Düşünmesiz ve düşünmeli modlar (varsayılan: düşünmeli) |
| Akıl yürütme efor seviyeleri | low, high, max |
| Yeni decoding modülü | DSpark speculative decoding (7 spekülatif token) |
| API uyumluluğu | OpenAI ChatCompletions, Responses API, Anthropic API, Codex |
| Eşzamanlılık sınırı | 500 |
| Lisans | MIT |
Model kartında, agent senaryoları için temperature = 1.0 ve top_p = 0.95 öneriliyor. high ve max efor seviyelerinde maksimum çıkış uzunluğu 384K token.
GA sürümünün resmî benchmark sonuçları
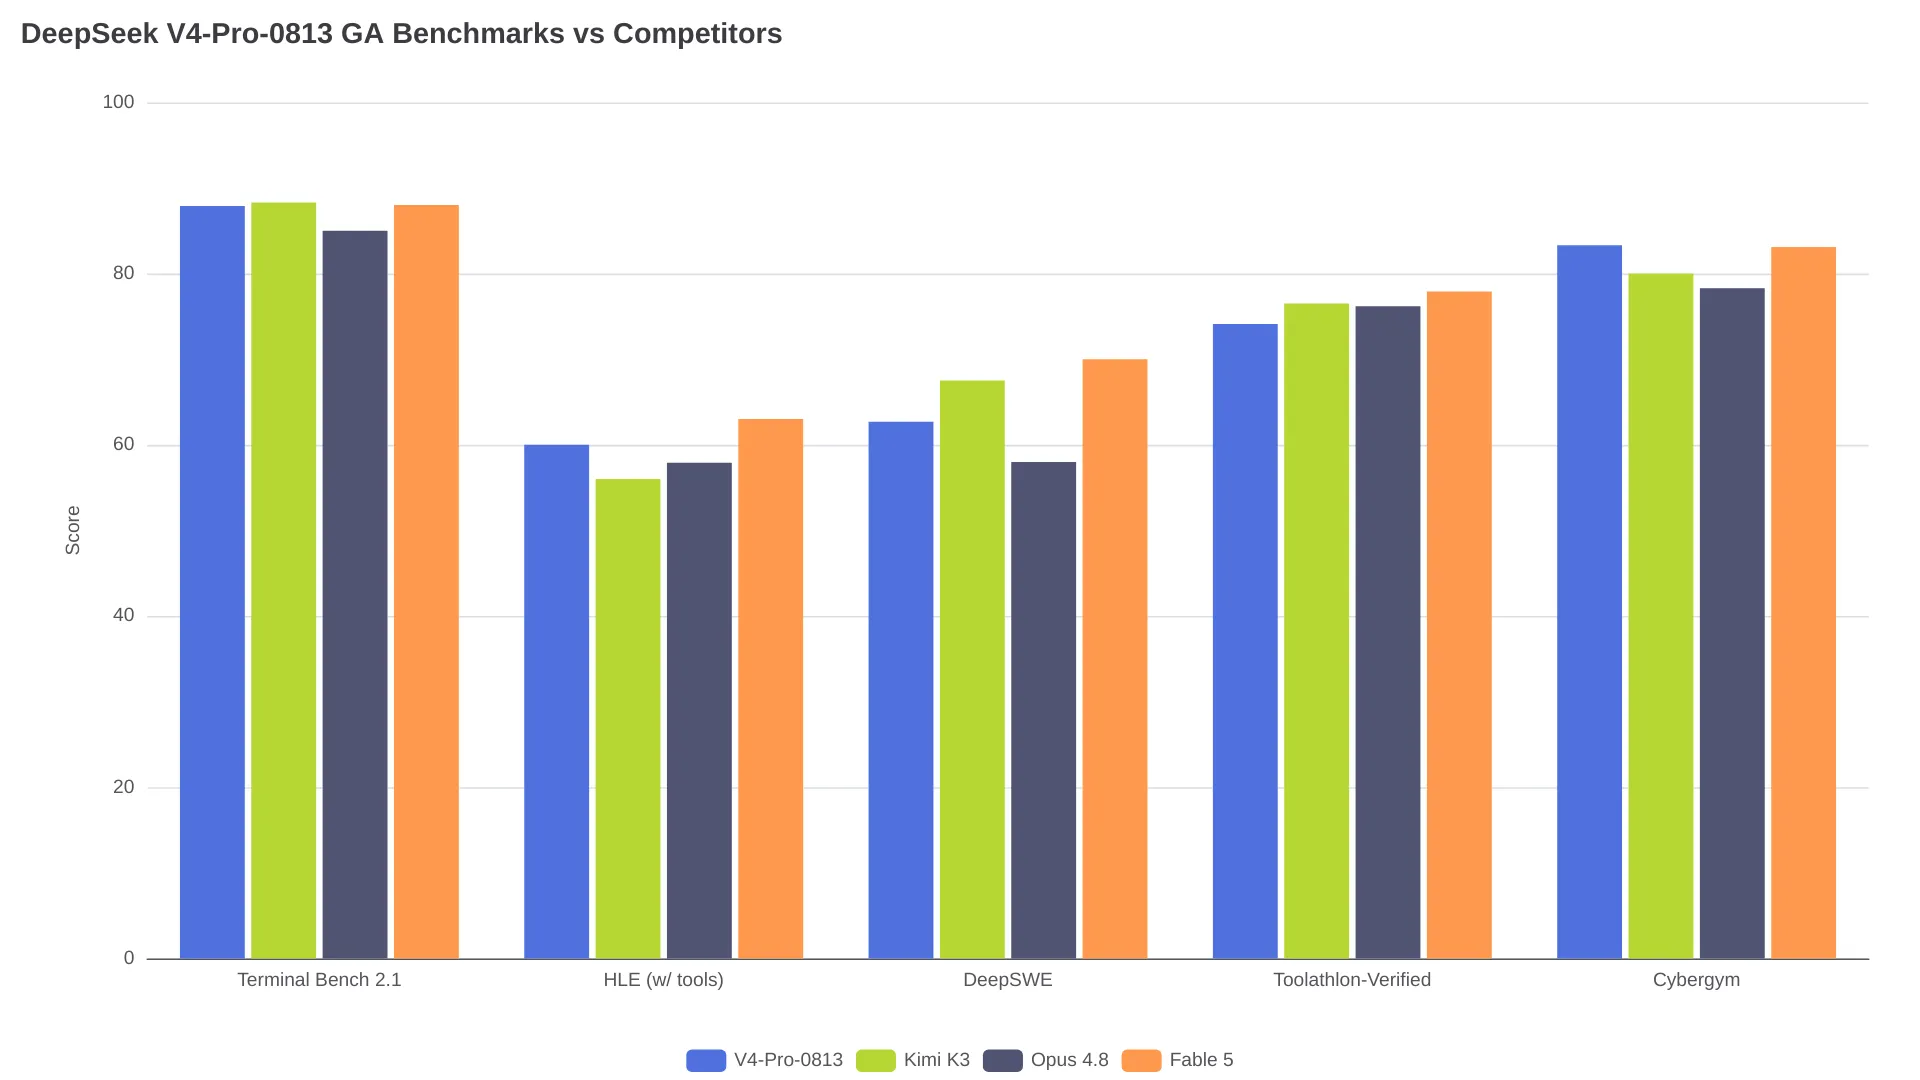
DeepSeek, model kartında on benchmark karşılaştırması yayımladı. Kod agent görevlerinde DeepSeek Harness'in minimal modu, max akıl yürütme eforuyla kullanıldı. Son iki satırdaki DSBench verileri DeepSeek'in kurum içi test kümelerine ait. Aşağıdaki puanların tamamı model kartından alınmıştır.
| Benchmark | Pro-0813 | Flash-0731 | Pro Preview | Kimi K3 | Opus 4.8 | Fable 5 |
|---|---|---|---|---|---|---|
| HLE (araçsız / araçlı) | 42.7 / 60.0 | 37.8 / 51.5 | 37.7 / 48.2 | 43.5 / 56.0 | 49.8 / 57.9 | 53.3 / 63.0 |
| Terminal Bench 2.1 | 87.9 | 82.7 | 72.1 | 88.3 | 85.0 | 88.0 |
| DeepSWE | 62.7 | 54.4 | 12.8 | 67.5 | 58.0 | 70.0 |
| Toolathlon-Verified | 74.1 | 70.3 | 55.9 | 76.5 | 76.2 | 77.9 |
| Cybergym | 83.3 | 76.7 | 52.7 | 80.0 | 78.3 | 83.1 |
| NL2Repo | 61.5 | 54.2 | 38.5 | — | 69.7 | — |
| Agents' Last Exam | 25.7 | 25.2 | 16.5 | 27.6 | 25.7 | — |
| AutomationBench (Public) | 31.8 | 25.1 | 12.8 | 30.8 | 27.2 | 29.1 |
| DSBench-FullStack (internal) | 71.1 | 68.7 | 41.8 | 73.7 | 71.6 | 77.2 |
| DSBench-Hard (internal) | 67.2 | 59.6 | 31.1 | 63.0 | 71.7 | 68.3 |
GA sürümünün önizlemeye göre sıçraması oldukça büyük: DeepSWE puanı 12.8'den 62.7'ye, AutomationBench ise 12.8'den 31.8'e yükselmiş. Rakiplerle karşılaştırıldığında Pro-0813, araç kullanılan HLE testinde 60.0 puanla Kimi K3'ün 56.0 ve Opus 4.8'in 57.9 puanının önünde. Buna karşılık DeepSWE, Terminal Bench ve Toolathlon-Verified testlerinde Kimi K3 ile Fable 5'in gerisinde kalıyor. İki DSBench satırının sağlayıcının kurum içi testlerine dayandığını, dolayısıyla bağımsız biçimde sürdürülen benchmark'larla aynı ağırlıkta değerlendirilmemesi gerektiğini unutmayın.
Açık model ağırlıkları
0813 ağırlıkları Hugging Face'te yayında ve MIT lisansıyla sunuluyor. Dağıtım için vLLM ve SGLang seçenekleri mevcut. Model kartında DSpark speculative decoding, FP8 KV cache ve tek bir 4x GB300 node kullanan bir vLLM sunum örneği de yer alıyor.
“Mevcut en güçlü kapalı kaynak modellerle genel olarak rekabetçi.” — DeepSeek V4-Pro model kartı, Hugging Face
16 Ağustos öncesi ve sonrası: API fiyatları ne olacak?
Fiyatlandırma sayfasında hem mevcut sabit ücretler hem de 16 Ağustos 2026, 16:00 UTC'de devreye girecek yoğun/yoğun olmayan saat tarifesi bulunuyor. Yoğun saatler 01:00–04:00 UTC ile 06:00–10:00 UTC arası; Pekin saatine göre 09:00–12:00 ve 14:00–18:00. Bunun dışındaki tüm saatler yoğun olmayan dönem sayılıyor. Yoğun olmayan saat tarifesi, yoğun saat ücretinin tam yarısı.
DeepSeek V4 Pro (DeepSeek-V4-Pro-0813)
| Ücretlendirme kalemi | Mevcut sabit ücret | Yoğun olmayan saat (16 Ağustos) | Yoğun saat (16 Ağustos) | Yoğun saatte değişim |
|---|---|---|---|---|
| Girdi, cache hit | $0.003625/M | $0.022/M | $0.044/M | +1,114% |
| Girdi, cache miss | $0.435/M | $0.66/M | $1.32/M | +203% |
| Çıkış | $0.87/M | $1.98/M | $3.96/M | +355% |
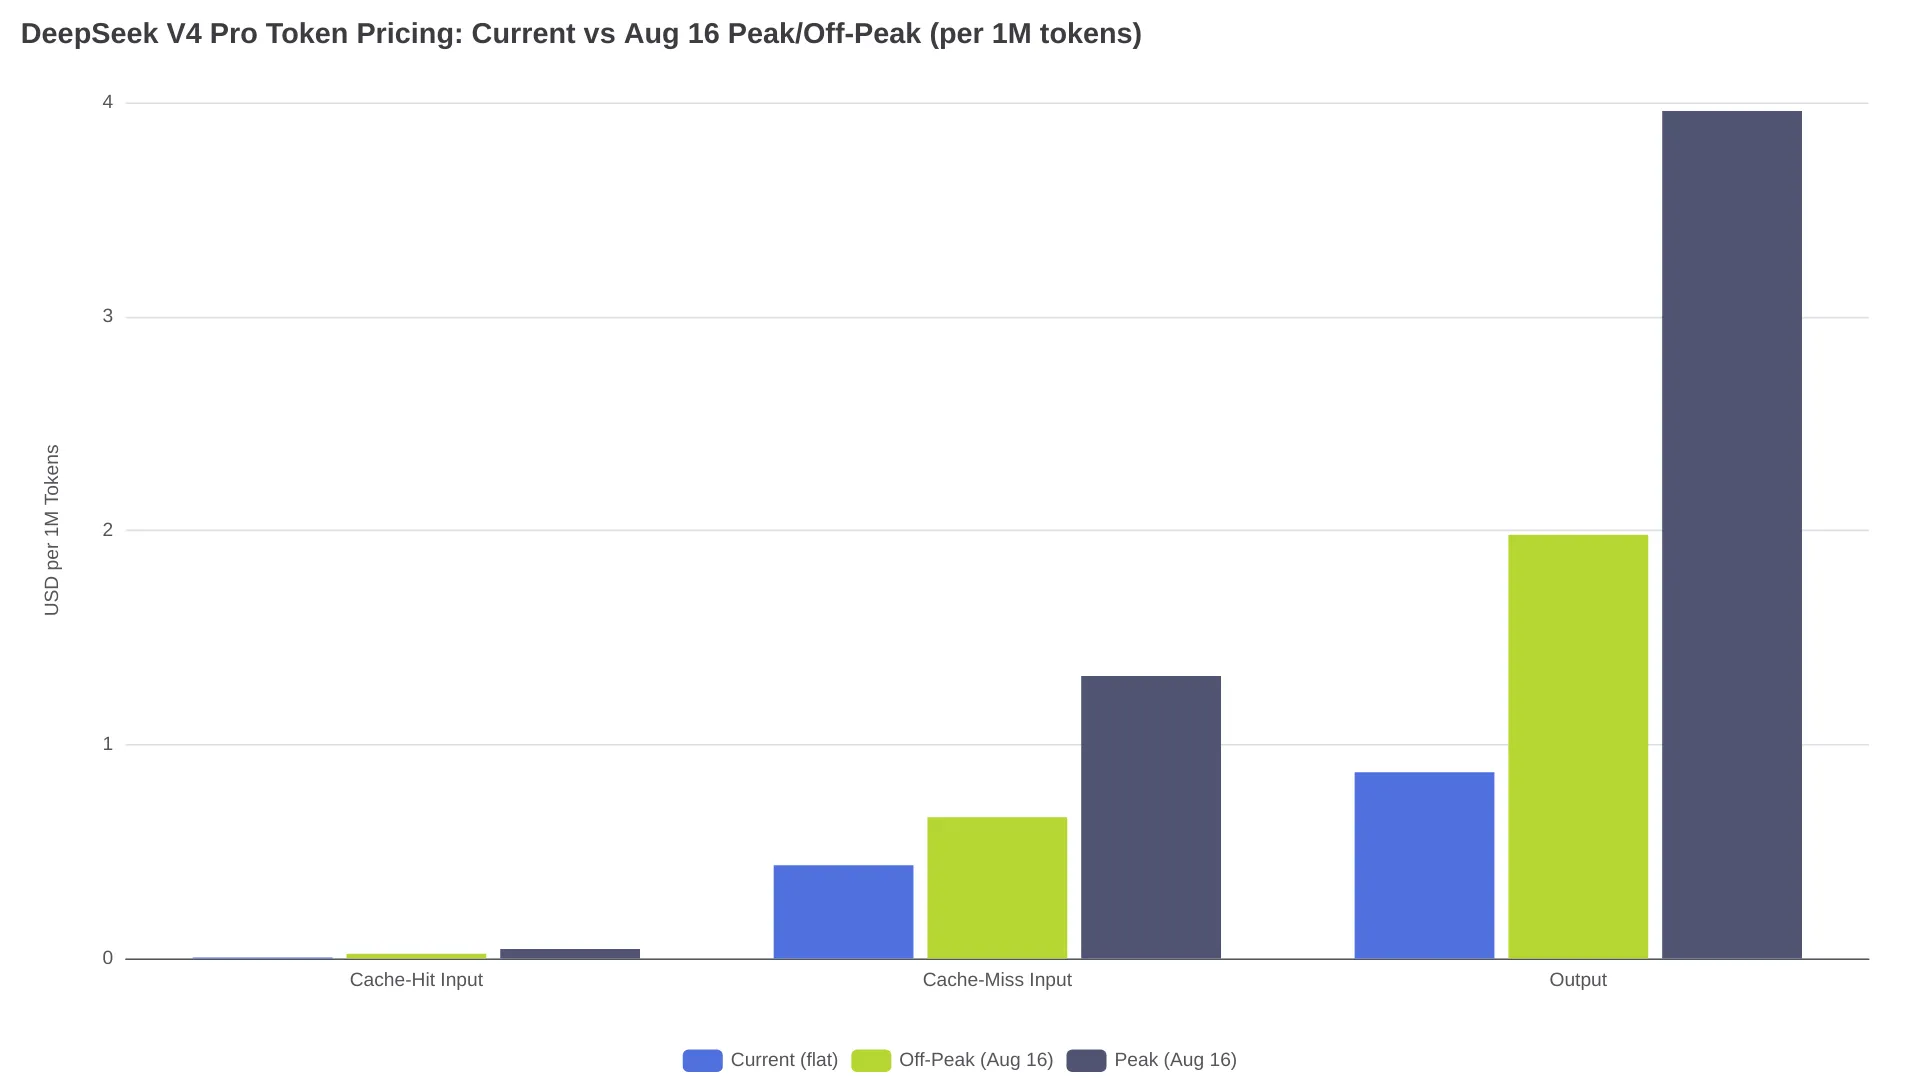
Yoğun saatlerde çıkış tokenı maliyeti 4.6 katına çıkıyor. Üretimde agent iş akışları için daha sarsıcı değişim ise cache hit tarafında: Önceki $0.003625/M fiyatı, cache miss ücretinden yaklaşık 120 kat daha düşüktü. 16 Ağustos'tan sonra bu oran her iki tarifede de 30x'e inecek: yoğun olmayan saatlerde 0.022'ye karşı 0.66, yoğun saatlerde 0.044'e karşı 1.32. Mutlak cache hit maliyeti ise 6 ila 12 kat artıyor.
DeepSeek V4 Flash (DeepSeek-V4-Flash-0731)
| Ücretlendirme kalemi | Mevcut sabit ücret | Yoğun olmayan saat (16 Ağustos) | Yoğun saat (16 Ağustos) | Yoğun saatte değişim |
|---|---|---|---|---|
| Girdi, cache hit | $0.0028/M | $0.007/M | $0.014/M | +400% |
| Girdi, cache miss | $0.14/M | $0.22/M | $0.44/M | +214% |
| Çıkış | $0.28/M | $0.66/M | $1.32/M | +371% |
Eşzamanlılık sınırı 2,500 eşzamanlı istek; yani Pro için ayrılan kapasitenin beş katı.
Yoğun saatler farklı saat dilimlerinde ne zamana denk geliyor?
| Saat dilimi | 1. yoğun pencere | 2. yoğun pencere |
|---|---|---|
| Pekin (UTC+8) | 09:00–12:00 | 14:00–18:00 |
| Londra (UTC+1) | 02:00–05:00 | 07:00–11:00 |
| New York (UTC-4) | 21:00–00:00 (önceki gün) | 02:00–06:00 |
| San Francisco (UTC-7) | 18:00–21:00 | 23:00–03:00 |
ABD merkezli ekipler için yoğun kullanım pencereleri büyük ölçüde akşam ve gece saatlerine denk geliyor. Çin veya Doğu Asya'daki ekiplerde ise yoğun saatler standart çalışma saatleriyle çakışıyor.
Günde 10.000 çağrıda Pro maliyeti
Her çağrıda 50K tokenlık cache'lenmiş bir ön ek gönderen ve 2K tokenlık yanıt alan, üretimde çalışan bir agent düşünelim.
| Maliyet kalemi | Mevcut sabit ücret | Yoğun olmayan saat | Yoğun saat |
|---|---|---|---|
| Cache hit girdi (500M token) | $1.81 | $11.00 | $22.00 |
| Çıkış (20M token) | $17.40 | $39.60 | $79.20 |
| Günlük toplam | $19.21 | $50.60 | $101.20 |
| 30 günlük toplam | $576 | $1,518 | $3,036 |
Gerçek iş yüklerinde yoğun ve yoğun olmayan saat çağrıları birlikte bulunacağından maliyet bu iki sınır arasında kalır. Aynı iş yükü Flash'ta mevcut sabit ücretlerle günlük $7.00, yoğun olmayan saatlerde yaklaşık $16.70 ve yoğun saatlerde $33.40 tutuyor. Flash'ın yoğun saat maliyeti ($33.40/gün), Pro'nun mevcut sabit ücretini ($19.21/gün) aşıyor; ancak Flash'ın yoğun olmayan saat maliyeti ($16.70/gün) bunun altında kalıyor.
Geçiş rehberi: Model kimlikleri, düşünme kontrolü ve sürüm sabitleme
Kaldırılan endpoint'ler ve yeni model kimlikleri
24 Nisan tarihli önizleme duyurusunda, deepseek-chat ve deepseek-reasoner endpoint'lerinin “24 Temmuz 2026, 15:59 (UTC Time) sonrasında tamamen kullanımdan kaldırılacağı ve erişilemeyeceği” belirtilmişti. Kodunuzda bu dizeler geçiyorsa güncellemeniz gerekiyor.
| Eski endpoint | Yönlendirildiği model | Yerine kullanılacak model |
|---|---|---|
deepseek-chat | V4 Flash, düşünmesiz mod | deepseek-v4-flash |
deepseek-reasoner | V4 Flash, düşünmeli mod | deepseek-v4-flash (düşünmeli) veya deepseek-v4-pro |
Birçok ekip, deepseek-reasoner'ın Pro seviyesinde akıl yürütme sunduğunu varsaymıştı. Oysa bu endpoint, düşünmeli moddaki Flash'a yönlendiriliyordu. deepseek-v4-pro'a geçmek, hem farklı bir çıktı kalitesi hem de daha yüksek bir fatura anlamına gelir.
// Before (retired — fails)
{"model": "deepseek-reasoner", "messages": [...]}

// After
{"model": "deepseek-v4-pro", "messages": [...]}
Base URL değişmiyor: https://api.deepseek.com. İstek yapısında başka bir değişiklik yok.
Akıl yürütme efor seviyeleri
V4-Pro-0813, üç akıl yürütme efor seviyesi getiriyor: basit işler için low, günlük agent görevleri için high ve karmaşık problemler için max. Düşünme modu varsayılan olarak açık; düşünme tokenları da çıkış ücretlendirmesine dahil ediliyor. Örneğin, 200 tokenlık bir yanıt üretmeden önce 3.000 düşünme tokenı kullanan bir istem, yoğun saat fiyatıyla 3.200 çıkış tokenı üzerinden ücretlendirilir: çağrı başına $0.0127. Yalnızca yanıt için bu tutar $0.0008 olurdu. DeepSeek, uzun düşünmenin değer katmadan maliyet yarattığı basit görevlerde low seviyesini öneriyor.
Sürüm sabitleme
deepseek-v4-pro takma adı güncel derlemeye işaret eder ve DeepSeek ileride yeni sürümler yayımladığında değişebilir. Üretimde tekrarlanabilir davranış istiyorsanız, sağlayıcınızın tarih içeren model kimliklerini destekleyip desteklemediğini kontrol edin. Bazı üçüncü taraf gateway'ler sabitlenmiş rotalar sunar; üretimde kullanmadan önce her rotanın hangi derlemeyi sunduğunu sağlayıcı dokümantasyonundan doğrulayın.
API protokol uyumluluğu
Her iki model de OpenAI ChatCompletions ve Anthropic API formatlarını destekliyor. Anthropic endpoint'i https://api.deepseek.com/anthropic. Responses API ve Codex uyumluluğu, GA derlemesiyle gelen yenilikler arasında. Geçişten sonra hata alırsanız iki protokol yolunu da test edin.
Fiyat artışından sonra Pro mu Flash mı?
V4-Pro-0813, yayımlanan on metriğin tamamında V4-Flash-0731'i geçiyor. Ancak farkın büyüklüğü, görevin karmaşıklığına göre değişiyor:
| Benchmark | Pro 0813 | Flash 0731 | Fark |
|---|---|---|---|
| Terminal Bench 2.1 | 87.9 | 82.7 | 5.2 puan |
| DeepSWE | 62.7 | 54.4 | 8.3 puan |
| AutomationBench | 31.8 | 25.1 | 6.7 puan |
| Cybergym | 83.3 | 76.7 | 6.6 puan |
Şu durumlarda V4 Pro'yu tercih edin:
- Agent döngünüz, büyük ve sabit bir ön eki tekrar tekrar gönderiyorsa. Daha yüksek taban fiyata rağmen cache hit tasarrufu devam eder
- Karmaşık akıl yürütme, çok adımlı araç kullanımı veya büyük ölçekli kod üretimi için Pro'nun daha yüksek parametre sayısına ihtiyacınız varsa
- İş yükünüz 500 eşzamanlı istek sınırını tolere edebiliyorsa
Şu durumlarda V4 Flash'ı tercih edin:
- Görevleriniz basitse, yüksek hacimliyse veya gecikmeye duyarlıysa
- Fan-out iş yükleri için 2,500 eşzamanlı istek sınırına ihtiyacınız varsa
- Kalite farkı, 3 kat yüksek çıkış fiyatını haklı çıkarmıyorsa
Modelleri daha ayrıntılı karşılaştırmak için DeepSeek V4 Flash vs Pro karşılaştırmamıza bakabilirsiniz. API anahtarı yönetmeden modeli denemek isteyenler için V4 Pro sohbet sayfası ve V4 Flash sohbet sayfası anında erişim sunuyor.
Sık sorulan sorular
V4-Pro-0813 ağırlıkları self-hosting için kullanılabilir mi?
Evet. Ağırlıklar MIT lisansıyla Hugging Face'te bulunuyor ve vLLM ile SGLang dağıtım yolları sunuluyor. Dağıtım ayrıntıları için yukarıdaki Açık model ağırlıkları bölümüne bakın.
GA sürümüyle birlikte V4 Flash'tan V4 Pro'ya geçmeli miyim?
Maliyete duyarlı iş yüklerinin çoğunda Flash hâlâ daha iyi fiyat/performans seçeneği. Benchmark'larda Pro'nun gerisinde kalıyor; fark Agents' Last Exam'de 0.5 puandan, araçlı HLE'de 8.5 puana kadar değişiyor. Buna karşın çıkış tokenı fiyatı 3 kat daha düşük. Karmaşık çok adımlı akıl yürütme veya büyük ölçekli kod üretimi için modelin tam parametre kapasitesine ihtiyacınız varsa Pro'ya geçin.
Fiyat artışının etkisini nasıl azaltabilirim?
Üç temel kaldıraç var: Batch işleri ve ertelenebilir agent görevlerini yoğun saatlerin dışına planlayın (01:00–04:00 ve 06:00–10:00 UTC); istem ön eklerini sabit tutarak cache hit oranını yükseltin; basit işleri Flash'a yönlendirin veya Pro'da low akıl yürütme eforunu kullanın.
Yoğun/yoğun olmayan saat fiyatlandırması DeepSeek uygulaması ve web sitesi için de geçerli mi?
Resmî fiyatlandırma sayfası yalnızca API token ücretlendirmesini belgeliyor. Listelenen takvim doğrudan API çağrıları için geçerli; gateway sağlayıcıları bu ücretleri yansıtabilir, üzerine marj ekleyebilir veya ayrı tarifeler kullanabilir. Güncel ayrıntılar için fiyatlandırma sayfasını kontrol edin.