Qwen4 Max API artık yalnızca Token Plan önizlemesi değil; kullandığın kadar öde modeliyle kullanıma açık. Fiyatlandırma, 1M token başına 1,50 ABD doları giriş ve 4,50 ABD doları çıkış şeklinde. Bağlam penceresi ise 1M token. Şimdiden qwen4-max ile geliştirmeye başlayabilirsin; çünkü qwen4-max-preview 25 Kasım 2026'da kullanımdan kaldırılacak.
Qwen4-Max API kısa özet: 16 Kasım 2026'dan beri yayında
Alibaba, Qwen4-Max'i 16 Kasım 2026'da Alibaba Cloud Model Studio üzerinde qwen4-max adıyla genel kullanıma açtı. Bundan önce model, 11 Kasım'da başlayan ve yalnızca Token Plan üzerinden sunulan bir önizleme dönemindeydi. @Alibaba_Qwen duyurusuna göre model; yeni bir MoE mimarisi, yerleşik görüntü desteği ve 1M token bağlam penceresi sunuyor. API de QwenCloud üzerinde aktif durumda. Uluslararası erişimde QwenCloud belgeleri Model Studio ile aynı bilgileri veriyor; bölgen için Model Studio uç noktasını kullanman gerekiyor (QwenCloud belgeleri).
| Öğe | Qwen4-Max (qwen4-max) |
|---|---|
| Durum | 16 Kasım 2026'dan beri GA; qwen4-max-preview önizlemesi 11–25 Kasım 2026 arasında çalışıyor, ardından kaldırılacak |
| Giriş / çıkış | 1M token başına 1,50 / 4,50 ABD doları (Singapur uluslararası bölgesi) |
| Önbellek okuma | 1M token başına 0,075 ABD doları |
| Diğer bölgeler | ABD (Virginia), Frankfurt, Tokyo ve Hong Kong'da 1M token başına 1,413 / 4,24 ABD doları |
| Bağlam | 1M token; listelenen maksimum giriş 991K token |
| Maksimum çıktı | Düşünme kapalıyken 131.072 token; düşünme ve yanıt birlikteyken 262.144 token |
| Giriş türleri | Metin, görsel ve video |
| API yapısı | OpenAI uyumlu ve Anthropic uyumlu; araç çağırma, yapılandırılmış JSON çıktısı, web araması, önbellekleme, toplu işlemler ve ince ayar |
| Bölgeler | Singapur, ABD (Virginia), Frankfurt, Tokyo, Hong Kong ve Pekin; toplu işler yalnızca Pekin'de |
| Deneme | Yeni Singapur hesaplarına 90 gün boyunca 1M ücretsiz token |
Yukarıdaki fiyat ve limitler, 16 Kasım 2026'da Alibaba Cloud Model Studio belgelerinde yer alan bilgilerden alınmıştır (fiyatlandırma ve QwenCloud belgeleri). Örneğin Singapur'da 100K giriş + 10K çıkış yaklaşık 0,15 + 0,045 = 0,195 ABD dolarına mal olur.
Qwen3.8-Max'e kıyasla gerçekten ne değişti?
Qwen'in Artificial Analysis verilerine dayandırdığı duyuruya göre Qwen4-Max, Intelligence Index'te 43 puan alıyor. Bu skor Qwen3.8-Max (xhigh)'ten 9 puan yüksek, Kimi K3.1 Pro'dan ise 3 puan düşük. Görev başına ortalama maliyet 3,27 ABD doları; bu da Qwen3.8-Max'in yaklaşık üçte biri. Ayrıca çıktı token sayısı %39 daha düşük.
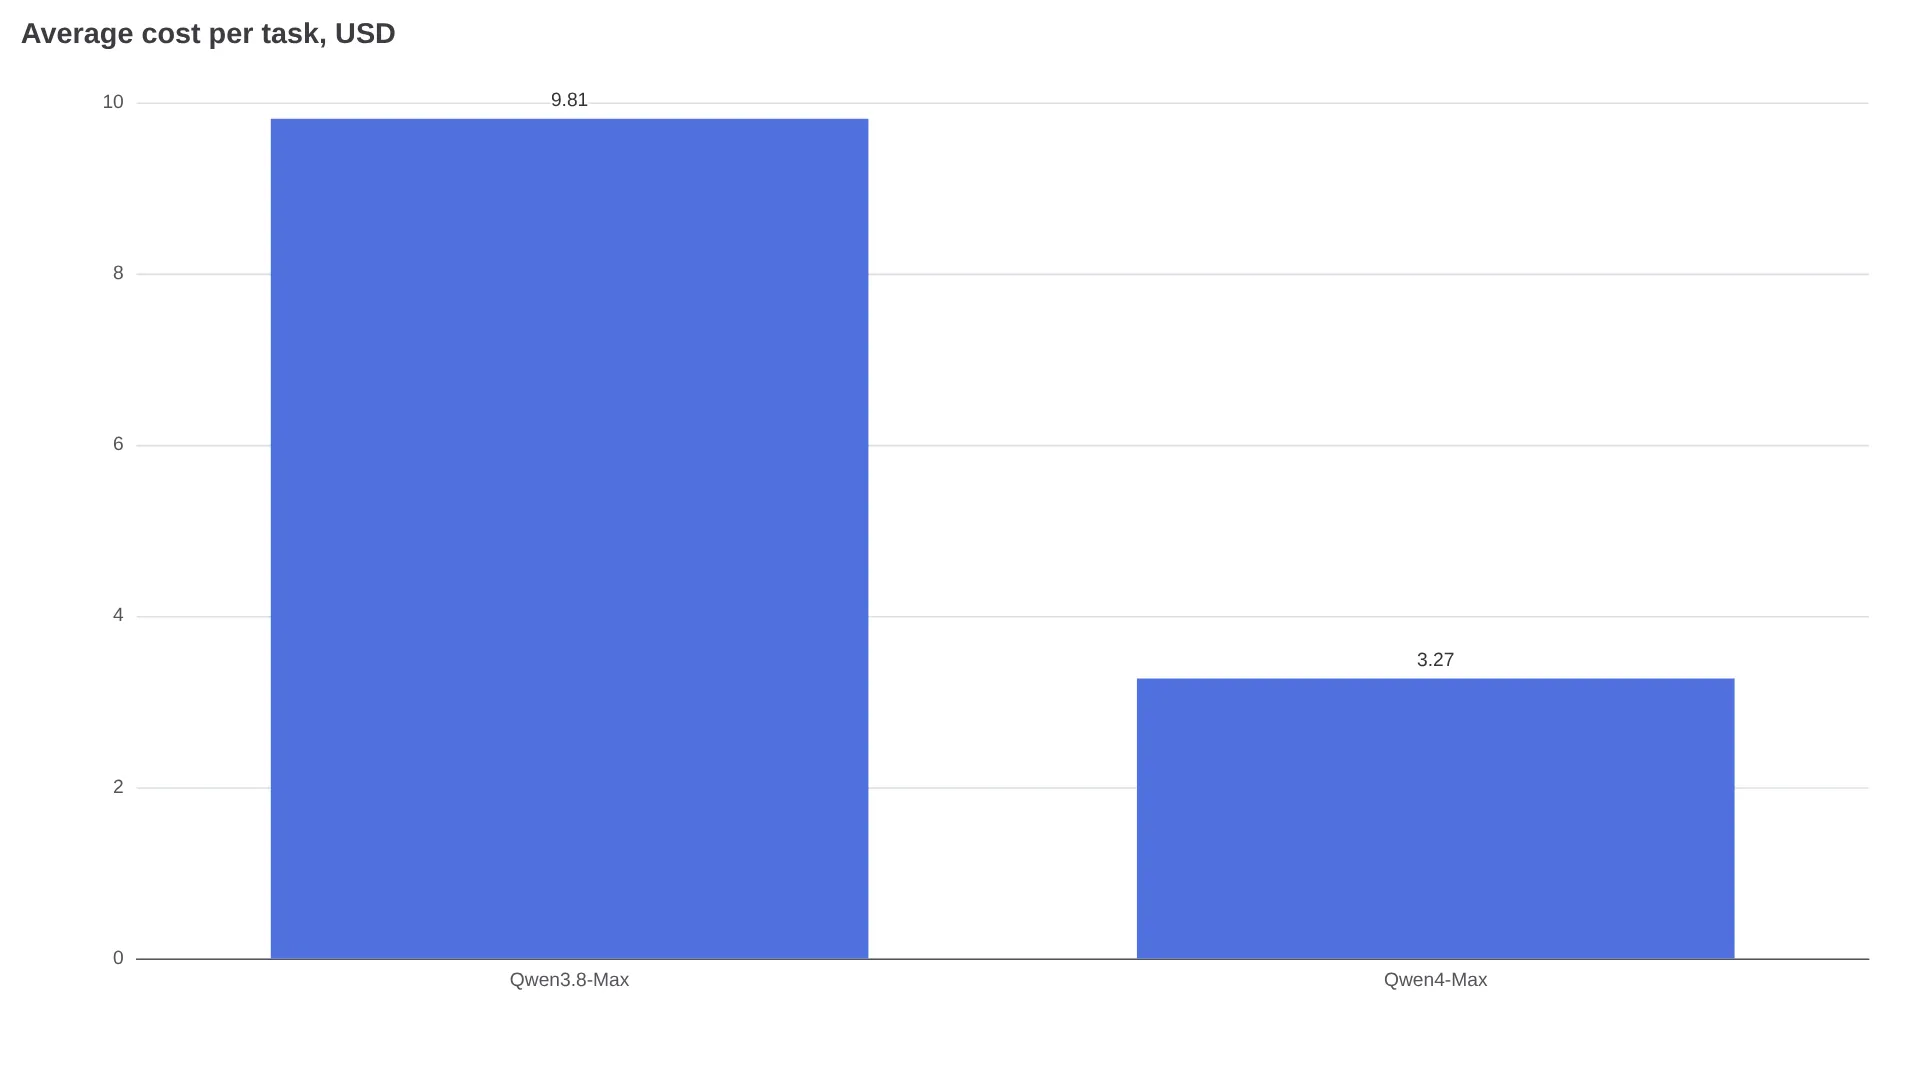
Tasarruf iki noktadan geliyor: Yukarıdaki tabloda yer alan token fiyatı ve görev başına daha az token kullanımı. Qwen'in kendi değerlendirmesinde bazı senaryolarda token kullanımı yaklaşık %50 azalıyor. Önbelleğin yeniden kullanıldığı 1M tokenlık işlemler bu avantajı daha da büyütüyor; örtük önbellek okumalarının fiyatı 1M token başına 0,075 ABD doları ve bu rakamın Qwen3.8-Max önbelleğine göre %70 daha düşük olduğu belirtiliyor.
Qwen4-Max'in temelinde yerleşik görüntü destekli bir MoE mimarisi bulunuyor: toplam 2,4 trilyon parametre, aktif olarak kullanılan 71 milyar parametre ve 328 milyar N-gram embedding. Qwen'in blog yazısı Artificial Analysis skorlarına atıf yapsa da AI First Look ve AICoder, 16 Kasım itibarıyla ayrıntılı benchmark tablolarının ve herkese açık AA liderlik tablosu kayıtlarının henüz yayınlanmadığını belirtiyor.
Önceki model hakkında: Qwen3.8-Max API fiyatlandırması ve Qwen3.8-Max ile Kimi K3 karşılaştırması.
Faturanı doğrudan etkileyen özellik ve limitler
1M tokenlık başlıktan daha önemli üç sınır var.
Bağlam penceresi ile kullanılabilir giriş aynı şey değil. Pencere 1M token olsa da QwenCloud maksimum girişi 991K token olarak listeliyor. Bu nedenle bir güvenlik payı bırakmalı ve özellikle bilgi getirme ağırlıklı işlerde orta bağlam konumundaki içeriklerin hatırlanmasını test etmelisin.
Çıktı ve düşünme aynı bütçeyi paylaşır. Düşünme kapalıyken maksimum çıktı 131.072 token. Düşünme açık olduğunda ise düşünme ve yanıt toplamı 262.144 tokenlık bütçeye sığmak zorunda; yani yoğun akıl yürütme, yanıt için ayrılan alanı azaltır. XenoSpectrum'un önizleme özellikleri derlemesine göre önizleme sürümünde bu ortak limit 393.216 tokendı. Bu nedenle önizleme limitlerini üretim koduna sabitleme.
Düşünme varsayılanları değişti. Düşünme özelliği varsayılan olarak açık geliyor. GA sürümünün varsayılan seviyesi high; ayrıca low ve xhigh seçenekleri de mevcut. AI First Look özellik tablosuna göre önizleme sürümünde varsayılan seviye xhigh idi. Gecikme yüksek gelirse ilk olarak reasoning_effort değerini low seviyesine indir.
Çok modlu giriş; metin, görsel ve videoyu kapsıyor. XenoSpectrum'un önizleme özellikleri derlemesine göre önizlemede video gönderimi için limitler 2 saat, 2 GB ve istek başına 64 videoydu. Bunlar gönderim limitleri; modelin içeriği eksiksiz anlayacağını garanti etmiyor. Uzun videolardaki hatırlama performansını kendi dosyalarınla test et.
Maliyeti kontrol altında tutmak için yapılandırılmış JSON çıktısı isteyebilir, gereksiz uzatmaları sınırlayabilir ve uzun bağlamı önbellek okumalarıyla yeniden kullanabilirsin (Singapur'da 1M token başına 0,075 ABD doları). AICoder'ın lansman notlarında, desteklenen yerlerde beş dakikalık açık önbellek oluşturma için 1M token başına 1,875 ABD doları da listeleniyor.
OpenAI SDK ile qwen4-max çağırma
Model Studio; Alibaba Cloud model belgelerine göre OpenAI Chat Completions, Responses ve Anthropic Messages API biçimlerini destekliyor. Kullandığın kadar öde arka uçları için qwen4-max modelini kullanmalısın; qwen4-max-preview ise yalnızca Token Plan kapsamında.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("QWEN_API_KEY"),
    # Singapore/international endpoint:
    base_url="https://dashscope-intl.aliyuncs.com/compatible-mode/v1",
    # China/Beijing endpoint: https://dashscope.aliyuncs.com/compatible-mode/v1
)

resp = client.chat.completions.create(
    model="qwen4-max",
    messages=[
        {"role": "user", "content": "Summarize this release in 3 bullets."}
    ],
    extra_body={"reasoning_effort": "high"},
)
print(resp.choices[0].message.content)
API anahtarını ve uç noktayı aynı Model Studio bölgesiyle eşleştir. Desteklenen yerlerde response_format={"type": "json_object"} veya JSON Schema isteyebilir, büyük yapılandırılmış çıktıları da doğrulayabilirsin.
Kullandığın kadar öde mi, Token Plan mı, sohbet uygulamaları mı?
| Seçenek | En uygun kullanım | Temel kısıt |
|---|---|---|
Model Studio kullandığın kadar öde (qwen4-max) | Uygulamalar, arka uçlar ve toplu işler | Token başına ücretlendirme; bölge uç noktasını ve API anahtarını kontrol et |
Token Plan (qwen4-max-preview) | Claude Code, Cline, Cursor ve OpenCode üzerinde etkileşimli kodlama | Yalnızca etkileşimli kullanım; üretim otomasyonu, toplu betikler veya arka uca gömme yasak; yalnızca Singapur bölgesi; 25 Kasım 2026 24:00 UTC+8'de sona eriyor |
| Qwen Chat, QwenWork, QwenStudio, Qoder | İstemleri denemek, belge işleri ve anahtar bağlamadan ajan tabanlı IDE kullanmak | Kullanılabilirlik ve kredi oranları uygulama içinde gösterilir; bunlar bir API sözleşmesi değildir |
Token Plan, etkileşimli geliştirme için aylık bir kredi havuzu sunuyor. Apidog'un Token Plan dökümüne göre bireysel paketler; etkinlik fiyatı 3, liste fiyatı 8 ABD doları ve 20.000 kredi sunan Lite'tan, etkinlik fiyatı 43, liste fiyatı 51 ABD doları ve 200.000 kredi sunan Pro'ya kadar uzanıyor. Bu paketlerde anahtarlar sb-sp- ile başlıyor. Anahtarı paylaşmak, arka planda işler çalıştırmak veya anahtarı yayınlanan bir arka uca gömmek kullanım şartlarını ihlal ediyor. İstem düzeyinde denemeler için Apidog ve XenoSpectrum; Qwen Chat, QwenWork, QwenStudio ve Qoder'ı değerlendirme seçenekleri olarak listeliyor. Kullanılabilirlik uygulama içinde gösteriliyor ve hesaba göre değişebiliyor.
25 Kasım 2026'dan önce geçiş yap:
- Model dizesini
qwen4-max-previewyerineqwen4-maxolarak değiştir. - Token Plan taban URL'si ve anahtarı yerine Model Studio kullandığın kadar öde anahtarına ve bölgesel uç noktaya geç.
- Düşünme varsayılanlarını yeniden test et (
xhighyerinehigh). - Çıktı bütçelerini yeniden ölç (önizlemede 393K ortak limit, GA sürümünde 131K/262K limitleri).
İlk kullanıcıların deneyimi: yeni projelerde hızlı, ajan kullanımında dalgalı
AI First Look tarafından derlenen küçük örneklemli testlerde, tek istemle çalışan projeler raporlanıyor. Bunlardan birinde 20 gizli testin 20'si yaklaşık 2,5 dakikada tamamlanmış; Qwen3.8-Max aynı iş için 17 dakika sürmüş. Ancak aynı derlemede, Qwen4-Max'in bir oyun testini daha hızlı bitirmesine rağmen genel değerlendirmede ikinci sırada kaldığı da belirtiliyor.
Herhangi bir kod üretmeye çalışırken sürekli bu hatalarla karşılaşıyorum.
— @bijanbowen, gönderi (16 Kasım 2026 tarihli gerçek kullanıcı ilk izlenimi; tekrarlanan kod üretimi hatalarının ekran görüntüsü)
Çince yayımlanan erken dönem kullanıcı derlemelerinden biri (@weconomypistis), fiyatı ve görev başına maliyeti en büyük avantaj olarak değerlendiriyor. Ancak terminal ve ajan işlemlerinde Qwen4-Max'in Kimi'nin gerisinde kaldığını, yanıtların da daha yavaş olduğunu belirtiyor.
Sık sorulan sorular
Qwen4-Max açık ağırlıklı bir model mi?
Hayır. AI First Look takip sayfasına göre 16 Kasım itibarıyla Qwen4-Max yalnızca barındırılan bir model olarak sunuluyor ve ağırlıkları açıklanmış değil. Qwen4-Max duyurusunda daha küçük Qwen4 modellerinin ileride açık ağırlıklarla yayımlanacağı belirtiliyor; ancak tarih, boyutlar veya lisans hakkında henüz bilgi verilmedi.