 AIREITER
GLM-5.2'ye giden tüm yollar OpenAI biçiminde istek kabul ediyor; ancak arka plandaki davranışlar neredeyse hiçbirinde aynı değil. 16 Haziran'daki lansmanından bu yana GLM-5.2 API, maliyet hassasiyeti olan kodlama ve ajan iş yükleri için dikkate değer bir seçenek. Fakat tool call anlamları, retry fırtınaları ve cache muhasebesi için koruma katmanını sizin yazmanız gerekiyor. Milyon token başına $1.40/$4.40 liste fiyatı gerçek; tamamlanmış bir işin size gerçek maliyeti ise bambaşka bir rakam olabilir. Bu incelemenin odağında da bu fark var.
OpenAI uyumluluğu nerede başlıyor, nerede bitiyor?
Resmî GLM-5.2 dokümantasyonu, https://api.z.ai/api/paas/v4/ base URL'si ve glm-5.2 model kimliğiyle OpenAI Python SDK'sını destekliyor. Temel bir chat entegrasyonunu gerçekten üç satırda dönüştürebilirsiniz. Ancak uyumluluk istek şemasıyla sınırlı: yanıt semantiği, OpenAI'nin opsiyonel kontrol alanları ve daha yeni Responses API yüzeyi buna dahil değil.
| Dokümante edilen sözleşme | Değer |
|---|---|
| Modalite | Metin girişi, metin çıkışı (vision yok) |
| Context penceresi | 1M token |
| Azami çıktı | 128K token |
| Dokümante edilen özellikler | Thinking mode, streaming, function call, context caching, structured output, MCP |
| Ölçümlü endpoint | https://api.z.ai/api/paas/v4/ |
| Coding Plan endpoint'i | https://api.z.ai/api/coding/paas/v4 |
| Anthropic uyumlu endpoint | https://api.z.ai/api/anthropic |
| Resmî SDK'lar | zai-sdk (Python), Java, OpenAI SDK |
İlk sert sınır şu: Z.ai'de Responses API hiç yok. u/quinncom bunu şöyle özetliyor: "Codex yalnızca Z.ai'de bulunmayan Responses API biçimini destekliyor." Bu yüzden bazı kullanıcılar araya çeviri katmanı olarak ZenMux koyuyor. İkinci sınır Claude Code tarafında: Anthropic uyumlu endpoint üzerinden çalışıyor, ancak @armor_rust tarafından paylaşılan yapılandırma notları iki tuzağa dikkat çekiyor. API_KEY yerine AUTH_TOKEN kullanın; ilki, bir kez reddedildiğinde kalıcı olarak reddedebilen bir güven onayı tetikliyor. Ayrıca abonelik ve kullandıkça öde base URL'leri farklı. Ayrıntılı kurulum için Claude Code rehberimize bakabilirsiniz.
Bir geliştiricinin özeti yerinde: "API uyumluluğu istek şemasında bitiyor; tool calling için hâlâ sağlayıcıya özel değerlendirmeler gerekli" — @sebuzdugan.
Tool calling kısa testleri geçiyor, uzun döngülerde dağılıyor
Kısa ve kontrollü tool döngülerinde GLM-5.2 API, dokümantasyonun vaat ettiği sonucu veriyor. Uzun süren ajan döngülerinde ise yoğun kullanıcılar, kendi limitleriniz devreye girene kadar dönen bozuk çağrı dizileri bildiriyor. Bu iki gözlem birbiriyle çelişmiyor; risk, kurduğunuz döngünün türüne bağlı.
Z.ai dokümanlarında yer alan ve GLM52.ai'nin 27 istekli Docker paketiyle test edilen sözleşme şöyle: en fazla 128 function tanımı, ^[a-zA-Z0-9_-]+$ ile eşleşen ve 64 karakteri geçmeyen adlar, JSON Schema parametreleri, uygulamanızın doğrulaması gereken JSON string olarak dönen argümanlar ve yalnızca tool_choice: "auto" için dokümante edilmiş destek. Bu paket Coding Plan rotasında 27/27 istek başarı elde etti: 4/4 araç ve argüman tam eşleşmesi, 3/3 doğru araç kullanmama yanıtı, iki üst düzey çağrıda 4/4 iki sipariş sonucu ve 5.3 saniye medyan gecikme.
Asıl tuzak, OpenAI kullanıcılarının var saydığı kontrol alanlarında ortaya çıkıyor. GLM52.ai çelişkili testler gönderdiğinde endpoint HTTP 200 döndürdü, fakat talimatları yok saydı:
| Gönderilen OpenAI tarzı kontrol | Gözlenen davranış |
|---|---|
tool_choice: "required" + "hiçbir araç kullanma" | Durdu, sıfır çağrı |
| Zorunlu function nesnesi + "bu aracı asla kullanma" | Durdu, sıfır çağrı |
parallel_tool_calls: false + iki siparişli prompt | Buna rağmen iki çağrı döndürdü |
strict: true | Bir kez kabul edildi; şema zorlamasına dair kanıt yok |
HTTP isteğinin kabul edilmesi, davranış sözleşmesinin sağlandığı anlamına gelmiyor. Özellikle uzun döngülerde bu ayrım belirginleşiyor.
Model üzerinden yaklaşık dört milyar token geçiren bir geliştirici durumu net anlatıyor: "GLM 5.2 ile 4 milyar token sonrasındaki en büyük sorun vision eksikliği, bazı tool call karışıklıkları ve tool call corruption death; model sadece spirale giriyor" — @RasputinKaiser. Ayrıca modelin ilk çağrının argümanları içine ikinci bir tool call kodladığına dair yanıtsız tek bir rapor var. Tekil bir vaka olsa da istemci tarafındaki döngü savunmasının hedeflediği hata sınıfı tam olarak bu.
Pratikte işe yarayan savunma, orkestrasyonu modele bırakmamak. Bir geliştirici NVIDIA NIM üzerinde tool_call: false ile çalıştırıyor ve tüm döngüyü ajan framework'üne veriyor. Sınırlandırılmış referans döngüsü model adımlarını dörtle, tur başına çağrı sayısını da dörtle sınırlıyor; her argüman JSON'unu çalıştırmadan önce doğruluyor.
Streaming ve gecikme: Reklamlarda görmeyeceğiniz rakamlar
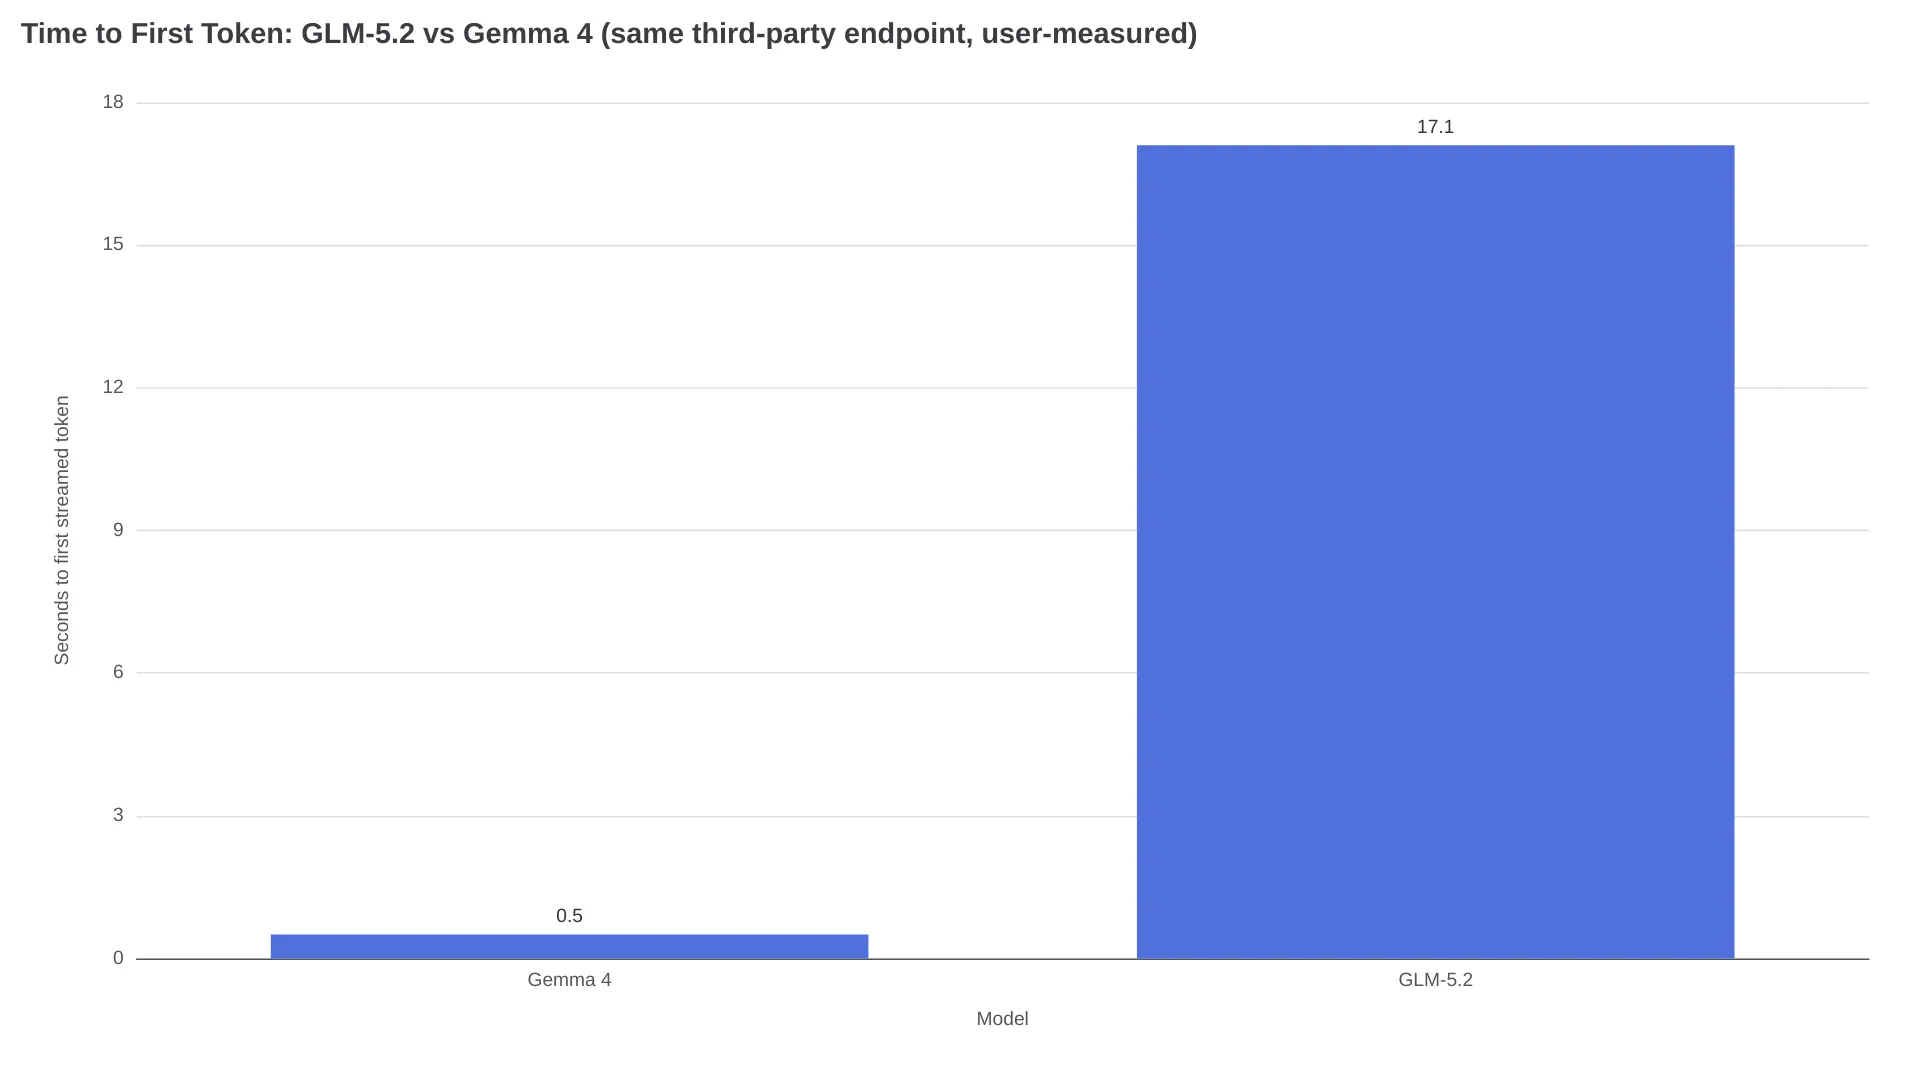
Ölçülen değerler içinde API'nin en zayıf noktası ilk token gecikmesi. Sarvam üzerindeki yan yana endpoint testinde GLM-5.2, Gemma 4'ün 260 token/s değerine karşı 148 token/s streaming hızına ulaştı. İlk token süresi ise 0.5 saniyeye karşı 17.1 saniyeydi; yani Gemma 4, @noctus91'in ifadesiyle "33 kat daha erken üretmeye başlıyor."
İlan edilen throughput değerlerinde de benzer bir tablo var:
"Bu GLM 5.2 sağlayıcılarının hepsi 200+ tok/s reklamı yapıyor. Denediğinizdeyse 50 tok/s alıyorsunuz" — @tomgreenwald; bunu "sağlayıcılar için benchmaxxing" olarak nitelendiriyor.
Abonelik rotalarında bildirilen iki ek sorun biçimi daha var: oturum ortasında kesilen stream'ler — "streaming bir anda... durdu"; bunun ardından bir GLM Pro Coding Plan kullanıcısı tamamen vazgeçti. Diğeri ise ölçekle gelen yavaşlama: "300k+ context'e ulaştığınızda model yavaşlıyor" (@mosh_Ontong). Karşılaştırma için, DataLLM Lab kendi gateway'inde çalıştırdığı dokuz görevli benchmark'ta tamamlanan görev başına ortalama 12.3 saniye ölçtü. Gecikme hikâyenizin büyük bölümünü modelden çok endpoint belirliyor.
Rate limit ve 429'lar: Retry normal çalışma biçimi
Z.ai, model dokümantasyonunda bir rate-limit tablosu yayımlamıyor; geliştiriciler limitlerini 429'lar üzerinden deneyerek öğreniyor. Coding Plan rotalarında topluluk görüşü, retry'ın istisna yolu değil normal çalışma düzeni olduğu yönünde. Bu başlıklar yaygınlık oranı vermiyor, hata türlerini gösteriyor; yine de raporlar tutarlı biçimde kümeleniyor.
r/ZaiGLM'deki rate-limit başlığından örnekler:
- "Şu anda coding max plan'de neredeyse her ikinci istekte 429/529 alıyorum. Concurrency yok..." — u/A-B-user
- "Evet, neredeyse her istek yeniden deneniyor ama sonuçlar çok iyi" — u/hyeluoh
- "glm52 için tek concurrency kullanırsam sorunsuz çalışıyor; çok yavaş ama hata vermiyor" — u/evia89
Hatalar istemciye de bağlı görünüyor: Aynı API anahtarı ZCode'da çalışırken OpenClaw'da 429 üretebiliyor. Başka bir kullanıcı bunu "fazla meşgul" mesajı diye açıklıyor. Abonelik katmanları sorunu büyütüyor: Çinli kullanıcılar Coding Plan'ın 5.2 iş yüklerini otomatik olarak GLM-5.3'e geçirdiğini — daha hızlı kota tüketiyor — ve üçüncü taraf Coding Plan satıcılarının birkaç çağrı ardından rate limit uyguladığını bildiriyor.
Dayanıklı mühendislik yanıtı şu: jitter'lı exponential backoff, yazma işlemi yapan her şeyde idempotency key, istek yerine görev başına retry bütçesi ve otomatik etkinleştirilebilen concurrency=1 düşürülmüş çalışma modu. OpenRouter 429 çözüm rehberimizdeki retry kalıpları burada da değişmeden geçerli.
Z.ai'nin yanıtlamadığı cache faturalandırması sorusu
Context caching dokümante edilmiş durumda. 13 Temmuz'da sağlayıcı sayfalarını kontrol ettiğimizde, cached input milyon token başına yaklaşık $0.26, yeni input ise $1.40 olarak listeleniyordu. Ancak incelediğimiz topluluk başlıklarında en yüksek etkileşimi alan API şikâyeti hâlâ çözümsüz: Bazı rotalarda tekrar edilen context, cached token yerine yeni input gibi faturalandırılıyor. Uzun system prompt'u her seferinde yeniden gönderen ajan döngülerinde bu durum maliyeti katlıyor.
"Cached token'lar GLM 5.2'de düzgün çalışmıyor. Tekrarlanan context, cached token yerine normal input olarak sayılıyor." — @Da7_Tech, bunu "ciddi bir faturalandırma/cache muhasebesi sorunu" olarak tanımlıyor.
Aynı başlıkta, Claude Opus 4.8'in 1.5M token'ın altında tamamladığı görev, GLM-5.2'de 53M token sonrasında hâlâ bitmemiş; beş saatlik kota %100'e ulaşmıştı. Uygulamanın kendi sayacı ise yaklaşık 1.67M gösteriyordu.
İki ay sonra aynı geliştiricinin özeti değişmemişti: "Birçok kullanıcı cache hit'lerin kullanımdan düşüyor gibi göründüğünden şikâyetçi. Başınıza gelirse planın değeri çöker." Bu başlıklarda ağustos sonlarına kadar resmî bir yanıt görünmedi.
Bu sorunun düzeltildiği doğrulanana kadar cached-input fiyatını yalnızca doğrulamanız gereken en iyi senaryo kabul edin: Her yanıttaki usage nesnesinden cached_tokens değerini kaydedin ve haftalık olarak faturalarınızla karşılaştırın.
Reasoning effort: Tek ayar, üç farklı ad
Resmî arayüzde thinking.type için enabled/disabled seçeneği ile high ve max değerlerini alan reasoning_effort bulunuyor. Dokümanların kendi örneklerinde reasoning_effort: "max" kullanılıyor. Z.ai'nin lansman rehberine göre max yeteneği öne çıkarıyor, high ise performansla token verimliliği arasında denge kuruyor; kod için önerilen ayar max.
Entegrasyon açısından iki sonuç var. İlk olarak kodlama rotaları varsayılan olarak max kullanıyor: r/ZaiGLM'de belirtildiği gibi, "Varsayılan max; azaltmak istemediğiniz sürece ayarlamanız gerekmiyor." Reasoning token'ları output fiyatından ölçülüyor; dolayısıyla varsayılan ayar harcamayı görünmeden büyütüyor. Coding Plan tarafında plan muhasebesini belgeleyen kullanıcılar, max-effort çağrıların Pekin saatine göre hafta içi 14:00–18:00 aralığında 3x kota tükettiğini bildiriyor. Bu çarpan, beş saatlik pencere ve haftalık kredilere ekleniyor.
İkinci sorun ise ayarın çoğu zaman backend'e ulaşmaması. OpenCode kullanıcıları özel sağlayıcılarda "şu anda reasoning effort ayarını değiştirmeye izin vermediğini" söylüyor. Bazı istemciler aynı ayarı xhigh adıyla sunuyor; üstelik bunu hiç iletmiyor olabilirler (r/opencodeCLI). Verbosity de aynı ayara bağlı; günlük karşılaştırmalar yapan bir geliştirici rakip bir modelin "Opus-4.8 veya GLM-5.2 kadar verbose olmadığını" not etmiş.
Aynı model adı, farklı dağıtımlar: endpoint sapması
glm-5.2, pratikte belirgin farklılıkları olan dağıtımlara işaret edebilen tek bir model adı. Ağustos başında endpoint doğruluğu sonuçları dolaşıma girdiğinde Z.ai'nin lideri topluluktan "ek referans noktası olarak resmî GLM-5.2 API'sini test etmelerini" istedi ve "100%'ün üstünde skor alabilir" dedi — @ZixuanLi_. Sözünü ettiği referans noktası, raporun ölçtüğü üçüncü taraf endpoint'leri değil resmî API idi.
Bu sapma pratikte şöyle görünüyor: reasoning'i stream ortasında kesebilecek kadar düşük output-token limitleri, lansman döneminde yüksek olup sonradan düşen throughput — yukarıdaki "benchmaxxing" örüntüsü — ve host'a göre değişen context sınırları. Together AI, GLM-5.2'yi 256K ile sunuyor; resmî API ise dokümanlara göre 1M, temmuz karşılaştırmamızdaki agregatörler de tam pencereyi taşıyor.
Fiyat farkı davranış farkından bile geniş: Z.ai'nin $1.40/$4.40 liste fiyatına karşılık, temmuz sağlayıcı karşılaştırmamızda OpenRouter $0.42/$1.32 listeliyordu. Cached-input fiyatları da $0.14 (Fireworks) ile $0.26 arasında değişiyordu. Endpoint'i iş yükünüze göre seçin, ardından testi o endpoint üzerinde yeniden yapın; bir rotadaki davranış başarısı diğerine taşınamaz.
Yayına çıkmadan önce: 30 dakikalık ön kontrol
Yukarıdaki tüm hata biçimlerini, üretim iş yüküne bağlanmadan önce yarım saat içinde tespit edebilirsiniz. Bunları kullanacağınız endpoint, model string'i ve SDK kombinasyonunda çalıştırın:
- Tool sözleşmesini çelişkili isteklerle sınayın.
tool_choice: "required"ile araç kullanılmamasını isteyen bir talimat, ayrıca iki siparişli bir prompt ileparallel_tool_calls: falsegönderin. Her ikisinin de yok sayılmasını bekleyin; orkestrasyonunuz bunlardan birine dayanıyorsa burada durun. - Retry yük testi yapın. Hedef concurrency değerinizde 50 istek çalıştırın; 429/529 oranını ve retry başarı oranını kaydedin. Retry'lar isteklerin yaklaşık üçte birini aşıyorsa — muhafazakâr bir operasyon eşiği — concurrency'yi 1'e indirin ve yeniden ölçün.
- Cache muhasebesini kontrol edin. Aynı 10K token'lık prefix'i beş kez yeniden gönderin; usage yanıtlarındaki
cached_tokensdeğerlerini toplayın ve dashboard'un input olarak faturalandırdığı değerle karşılaştırın. Buradaki uyumsuzluk maliyet modelinizi geçersiz kılar. - Gerçek context boyutunda gecikme testi yapın. 1K token'lık smoke test yerine temsilî context boyutlarında ilk token süresini ve stream ortasındaki duraksamaları ölçün; aksi hâlde >300K yavaşlaması görünmez.
- Rotayı doğru seçin. Coding Plan etkileşimli kodlama araçları için tasarlanmış; plan muhasebesi açıklamalarına göre web sitelerine, botlara veya SaaS trafiğine hizmet verme lisansı yok. Bu nedenle ürün backend'leri ölçümlü API'yi kullanmalı.
Çözülmeyen ödünleşim şu: GLM-5.2 piyasadaki en ucuz yetenekli kodlama token'larından bazılarını sunuyor. Bunun bedeli ise frontier API'lerin token başı maliyete gömdüğü wrapper mühendisliğini sizin üstlenmeniz.
GLM-5.2 API incelemesi: Sık sorulan sorular
GLM-5.2 ile OpenAI SDK kullanabilir miyim?
Evet, chat completions için kullanabilirsiniz. base_url değerini https://api.z.ai/api/paas/v4/, model değerini de glm-5.2 olarak ayarlayın. Responses API bulunmadığından OpenAI'nin yeni yüzeyi ve Codex için bir çeviri katmanı gerekir.
GLM-5.2 API streaming, function calling ve structured output destekliyor mu?
Üçü de context caching ve MCP ile birlikte dokümante edilmiş özellikler. Uyarı davranış tarafında: streaming kararlılığı endpoint'e göre değişiyor; OpenAI'nin auto dışındaki tool_choice, parallel_tool_calls ve strict gibi tool kontrol alanları ise dikkate alınmıyor.
Hangi model string'ini ve base URL'yi kullanmalıyım?
Resmî ölçümlü rota için https://api.z.ai/api/paas/v4/ üzerinde glm-5.2 kullanın. Coding Plan farklı bir base URL kullanır; OpenRouter ise modeli z-ai/glm-5.2 adıyla listeler.
GLM-5.2 neden yavaş veya alışılmadık derecede verbose?
Kodlama rotaları varsayılan olarak output token olarak ücretlenen max reasoning effort ile çalışıyor. Topluluk raporları, ilan edilen 200+ tok/s yerine sürdürülebilir hızın 50 tok/s civarında kaldığını gösteriyor. Gecikme ve verbosity, model sınırından önce genellikle yapılandırma ve endpoint kaynaklı sorunlar.
GLM Coding Plan ile uygulamamın API'sini çalıştırabilir miyim?
Hayır. Plan muhasebesi açıklamalarına göre abonelik, etkileşimli kodlama araçları için tasarlanmış ve web siteleri, botlar ya da SaaS ürünlerine hizmet vermeyi kapsamıyor. Pekin'deki yoğun saat kota çarpanları da onu sabit trafik için elverişsiz kılıyor.
1M context penceresi her sağlayıcıda var mı?
Hayır. Resmî API ve çoğu agregatör 1M sunuyor, ancak Together AI GLM-5.2'yi 256K ile sınırlıyor. Bu fark, repo ölçeğindeki iş akışlarının mimarisini değiştirecek kadar büyük.
İlgili İçerikler
- GLM-5.2 İncelemesi: Hype'tan İki Ay Sonra — model kalitesi, benchmark'lar ve kimlerin kullanması gerektiği
- GLM 5.2 API: En Ucuz Erişim, Fiyatlandırma ve Ücretsiz Anahtarlar — eksiksiz sağlayıcı fiyatlandırma matrisi
- GLM-5.2 ve GLM-5.3 — ağustostaki halef model hesabı değiştiriyor mu?