 AIREITER
5 августа 2026 года ByteDance представила SeedRealtime — нативную аудиовизуальную full-duplex LLM. Главное здесь не просто работа с голосом в реальном времени: таких решений уже немало. Отличие SeedRealtime в том, что звук и видео объединены в одной сквозной модели, а момент для реплики она определяет сама — без внешнего модуля, который решает, кто сейчас говорит. Для разработчиков есть и важное ограничение: на старте у модели нет публичного API и цен, а доступна она только внутри продуктов ByteDance.
Что представляет собой SeedRealtime
Модель создана командой Seed в ByteDance. В единой архитектуре она сочетает аудио, видео и текст: непрерывно воспринимает мультимодальный поток, понимает контекст, принимает решения и отвечает, не передавая данные между отдельными этапами обработки.
ByteDance описывает этот подход как способность одновременно «смотреть, слушать и говорить». Каждая реплика учитывает и услышанное, и увиденное в реальном времени. В линейке моделей Seed SeedRealtime соседствует с Seed2.1 — семейством LLM, на котором работает Doubao, — а также с Seedance для генерации видео, Seedream для генерации изображений, Seed Audio 1.0 для генерации аудио и робототехнической моделью Seed GR-RL.
В привычные категории SeedRealtime не укладывается. Это не TTS-модель, поскольку она не только генерирует речь, но и понимает её; не просто модель компьютерного зрения, поскольку визуальное восприятие подчинено диалогу; и не очередной голосовой бот с низкой задержкой.
Почему ключевое слово здесь — full-duplex
Full-duplex означает, что модель способна одновременно слушать и отвечать. Она постоянно отслеживает, кто говорит и когда уместно вступить в разговор, как это происходит в живом общении. По заявлению SeedRealtime, этого удалось добиться за счёт объединения звука, изображения, тайминга и выразительности в одной сквозной модели, а не подключения отдельных модулей.
Системы общения с ИИ в реальном времени долго опирались на два подхода. Каскадные системы последовательно соединяют ASR — распознавание речи, — LLM или VLM и TTS — синтез речи. Их проще отлаживать благодаря модульной структуре, но каждая передача между компонентами добавляет задержку и теряет часть информации. Интонация, наложение голосов, акцент и визуальный контекст нередко исчезают уже на этапе ASR. Сквозные голосовые модели убирают эти переходы и звучат естественнее, однако большинство из них всё ещё полагается на внешний детектор голосовой активности, VAD, чтобы понять, чья сейчас очередь говорить. В результате они фактически остаются half-duplex: один вопрос — один ответ.
В SeedRealtime восприятие, понимание, принятие решений и выражение ответа собраны в одной модели. Все эти процессы идут параллельно поверх непрерывных аудиовизуальных потоков, а внешний VAD для определения очередности реплик не нужен.
| Подход | Принцип работы | Дуплексность | Смена говорящего | Основной недостаток |
|---|---|---|---|---|
| Каскадный (ASR + LLM/VLM + TTS) | Последовательная цепочка модулей | Half-duplex | Фиксированное определение конца фразы | Задержки и потеря данных при каждой передаче |
| Сквозная модель + внешний VAD | Одна модель и внешний детектор очередности | Half-duplex | Внешний VAD | Всё ещё схема «один вопрос — один ответ» |
| SeedRealtime | Единая сквозная аудиовизуальная модель | Full-duplex, по заявлению ByteDance | Внутреннее мультимодальное решение | Новая модель; возможности описаны самим разработчиком |
Особая сложность связана с видео: в отличие от речи, в нём нет естественных пауз. Модели приходится постоянно решать, на каком объекте сосредоточиться, чей голос важен и стоит ли сейчас вмешиваться, не реагируя при этом на фоновый шум.
Три ключевые возможности SeedRealtime
ByteDance в анонсе SeedRealtime выделяет три направления: совместное понимание аудио и видео, проактивное взаимодействие и естественный тайминг разговора. Вместо бенчмарков компания показывает сценарии применения.
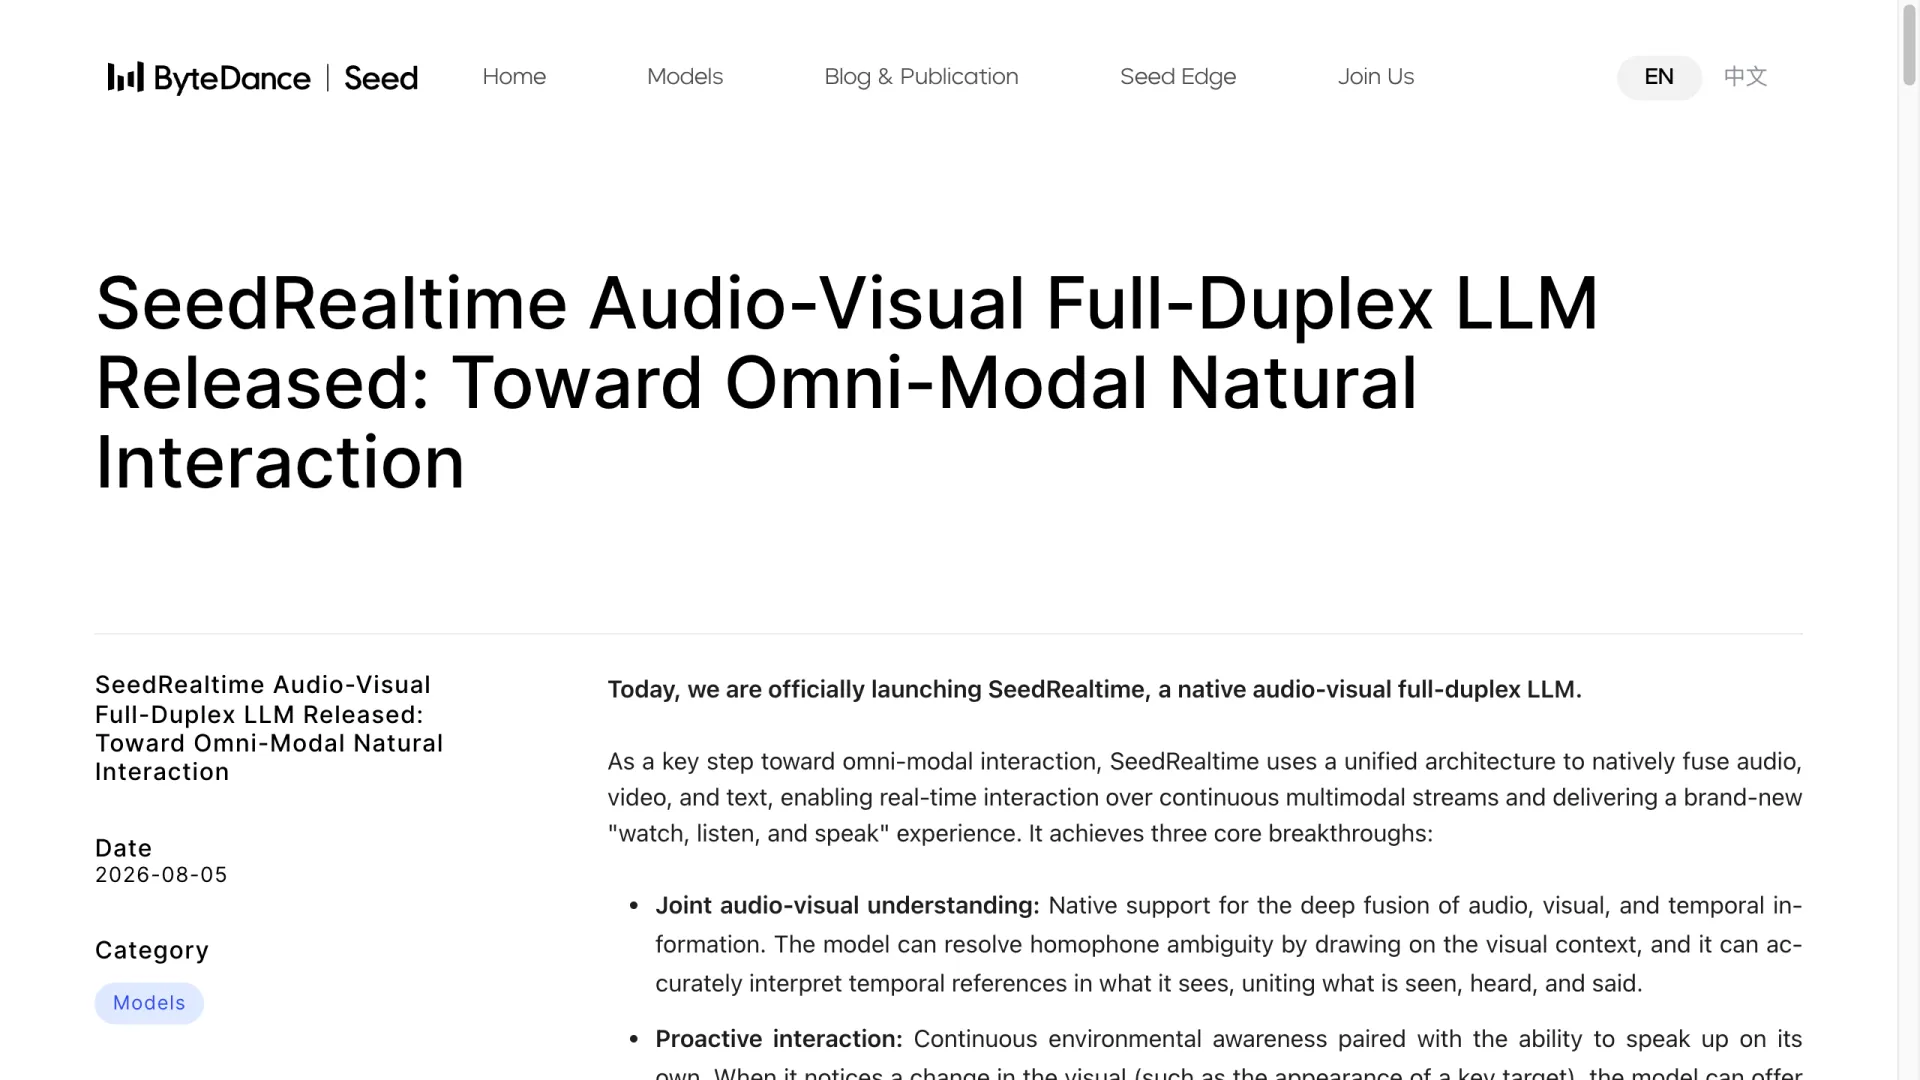
Понимание аудио и видео в одном контексте
Модель использует происходящее в кадре, чтобы снять неоднозначность в речи. Если пользователь спрашивает: «Как мне сделать это?», SeedRealtime анализирует экран, жесты, направление взгляда и предыдущие действия, чтобы понять, что именно имеется в виду.
В демо ByteDance пользователь по очереди знакомит модель с четырьмя друзьями за ужином. SeedRealtime сопоставляет имена с лицами, а затем связывает голос каждого человека с его личностью, пока компания планирует поездку с взаимоисключающими пожеланиями: один хочет на пляж, другой не переносит жару, третий страдает аллергией на морепродукты. В сычуаньском ресторане модель читает через камеру меню только на китайском, рекомендует блюда на английском и объясняет, почему в «свинине с рыбным ароматом» на самом деле нет рыбы.
Проактивные подсказки
Модель может заговорить сама, заметив изменение в сцене, а не ждать прямого вопроса. Например, посетитель музея просит: «Напомни мне, когда увидишь подставку с бронзовым тигром, пожирающим оленя». SeedRealtime следит за видеопотоком и, когда экспонат попадает в кадр, напоминает о нём и добавляет информацию о предмете.
Увидев, как человек засыпает цельные кофейные зёрна прямо в портафильтр, модель вмешивается и советует сначала смолоть их в мелкий порошок. После экстракции она предлагает сократить следующий пролив на две-три секунды, ориентируясь на цвет крема. Вызовы инструментов — например, поиск информации и бронирование — вплетены в такие ответы, а не вынесены в отдельный шаг.
Естественный ритм разговора
SeedRealtime сама определяет, когда говорить, делать паузу или молчать, опираясь на мультимодальный контекст, и не срабатывает на ложные сигналы. В переполненном пекинском аэропорту она игнорирует случайное упоминание спутником «рейса Старого Ли», но по запросу вспоминает информацию с табло вылетов, уже исчезнувшую с экрана, а затем выходит в интернет за данными о ленте выдачи багажа. Дома, когда один из родителей разговаривает по телефону на фоне, модель продолжает помогать ребёнку исправлять английское произношение.
Согласно сквозной оценке с участием людей, проведённой ByteDance, по сравнению с каскадными моделями SeedRealtime примерно вдвое сокращает проблемы с темпом аудиовизуального диалога: реже перебивает посреди фразы, медлит после пауз и реагирует на шум. Также выше доля реплик, которые проходят плавно и полностью. Это внутренняя оценка компании, а не независимый бенчмарк.
SeedRealtime на фоне GPT-4o Realtime, Gemini Live и каскадных систем
Практический вопрос — чем SeedRealtime отличается от систем реального времени, которые разработчики уже могут вызывать через API. Честный ответ таков: большинство существующих realtime API сосредоточено на аудио, тогда как ключевое заявление SeedRealtime — совместная обработка аудио и видео в full-duplex режиме.
Realtime API от OpenAI и пользовательская функция Gemini Live от Google с её разработческим Live API обеспечивают разговор в реальном времени с низкой задержкой. Однако в их основе лежит аудио — речь на входе и речь на выходе; работа со зрительным контекстом устроена отдельно, а смена реплик всё ещё зависит от определения конца высказывания или VAD. SeedRealtime позиционируется иначе: нативное объединение аудио и видео, внутреннее определение тайминга в full-duplex режиме, проактивные реплики и использование инструментов прямо в ходе диалога.
| Модель | Нативные модальности | Дуплексность | Смена говорящего | Проактивность / инструменты | Публичный API |
|---|---|---|---|---|---|
| SeedRealtime | Аудио + видео + текст, объединённые в одной модели | Full-duplex, по заявлению ByteDance | Внутреннее мультимодальное решение | Да, встроены в диалог | Нет, на старте |
| GPT-4o Realtime API | Аудио + текст | Реальное время, управление через VAD | Внешнее определение конца фразы | Через function tools | Да |
| Gemini Live / Live API | Аудио + текст, камера в пользовательском приложении | Реальное время, управление через VAD | Внешнее определение конца фразы | Ограниченно | Да, Live API для аудио |
| Каскадная система | Текст, аудио через ASR/TTS | Half-duplex | Фиксированная | Настраивается самостоятельно | Собственная сборка |
Преимущества SeedRealtime основаны на демо и оценках самой ByteDance: опубликованного прямого сравнения с GPT-4o realtime или Gemini Live пока нет. Поэтому таблицу выше стоит воспринимать как сравнение архитектурного позиционирования, а не как доказательство измеримого превосходства.
Можно ли уже использовать SeedRealtime в разработке?
На момент запуска 5 августа 2026 года SeedRealtime недоступна в виде API для разработчиков. ByteDance заявляет, что модель «полностью развёрнута», но речь идёт о внедрении во внутренние продукты компании, а не об открытом endpoint, доступном любому желающему.
На старте для SeedRealtime нет публичного API, страницы с тарифами и документации для разработчиков. Коммерческое API-направление ByteDance — Volcengine (火山引擎), где размещено семейство моделей Doubao: LLM Seed 2.1 Pro и Turbo, Seed-ASR, Seed-TTS и другие. В день запуска SeedRealtime в этом списке отсутствует, а сторонние сервисы-посредники не предлагают полноценной замены для работы с аудио и видео в реальном времени.
Для команд, которым endpoint реального времени нужен уже сейчас, реалистичные варианты по-прежнему ориентированы на аудио: Realtime API от OpenAI, Live API от Google или самостоятельно собранная каскадная система. За SeedRealtime стоит следить прежде всего как за архитектурным ориентиром. Дату появления realtime API в Volcengine или BytePlus ByteDance не называла.
FAQ
SeedRealtime доступна широкой публике?
С момента запуска 5 августа 2026 года модель развёрнута во внутренних продуктах ByteDance, но публичного приложения или endpoint под названием SeedRealtime, на который можно зарегистрироваться, нет.
Есть ли у SeedRealtime API?
На старте — нет. ByteDance не выпустила API-доступ, цены или документацию для разработчиков. Вероятным местом появления модели в будущем может стать семейство Doubao API на Volcengine, но SeedRealtime там пока не представлена.
Чем SeedRealtime отличается от GPT-4o realtime?
Realtime API для GPT-4o ориентирован на аудио: речь поступает на вход и синтезируется на выходе. SeedRealtime заявляет о совместной обработке аудио и видео в одной full-duplex модели, которая сама выбирает момент для реплики и может действовать проактивно. Независимого прямого сравнения пока нет.
SeedRealtime бесплатна?
На момент запуска нет отдельного продукта или API с указанной ценой, поэтому вопрос «бесплатная или платная» пока неприменим: это возможность, встроенная в продукты ByteDance.
Что означает full-duplex для ИИ-модели?
Это означает, что модель может одновременно слушать и отвечать, непрерывно отслеживая состояние разговора. Она сама решает, когда говорить или сделать паузу, вместо жёсткой схемы «один вопрос — один ответ».
Читайте также
- Стоимость OpenAI Realtime API — аудио-endpoint реального времени, который разработчики уже могут вызывать
- Qwen Audio 3 Realtime — ещё одна speech-модель реального времени для сравнения